Qwen-7B-hat Transformers 部署调用
环境准备
在autodl平台中租一个3090等24G显存的显卡机器,如下图所示镜像选择PyTorch-->2.0.0-->3.8(ubuntu20.04)-->11.8
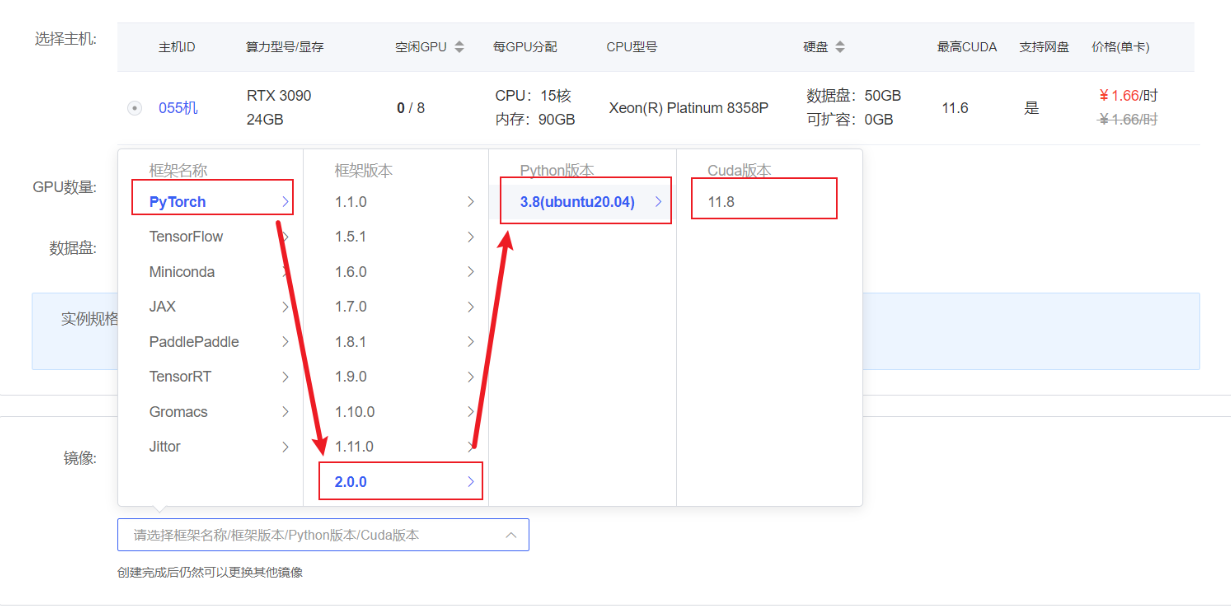
接下来打开刚刚租用服务器的JupyterLab,并且打开其中的终端开始环境配置、模型下载和运行demo。
pip换源和安装依赖包
# 升级pip
python -m pip install --upgrade pip
# 更换 pypi 源加速库的安装
pip config set global.index-url https://pypi.tuna.tsinghua.edu.cn/simple

pip install modelscope==1.9.5
pip install "transformers>=4.32.0" accelerate tiktoken einops scipy transformers_stream_generator==0.0.4 peft deepspeed模型下载
使用 modelscope 中的snapshot_download函数下载模型,第一个参数为模型名称,参数cache_dir为模型的下载路径。
在 /root/autodl-tmp 路径下新建 download.py 文件并在其中输入以下内容,粘贴代码后记得保存文件,如下图所示。并运行 python /root/autodl-tmp/download.py执行下载,模型大小为 15 GB,下载模型大概需要 10~20 分钟
import torch
from modelscope import snapshot_download, AutoModel, AutoTokenizer
from modelscope import GenerationConfig
model_dir = snapshot_download('qwen/Qwen-7B-Chat', cache_dir='/root/autodl-tmp', revision='v1.1.4')代码准备
在/root/autodl-tmp路径下新建trans.py文件并在其中输入以下内容
import torch
from transformers import AutoTokenizer, AutoModelForCausalLM, GenerationConfig

model_dir = '/root/autodl-tmp/qwen/Qwen-7B-Chat'
tokenizer = AutoTokenizer.from_pretrained(model_dir, trust_remote_code=True)
model = AutoModelForCausalLM.from_pretrained(model_dir, device_map="auto", trust_remote_code=True).eval()
# Specify hyperparameters for generation
model.generation_config = GenerationConfig.from_pretrained(model_dir, trust_remote_code=True) # 可指定不同的生成长度、top_p等相关超参

# 第一轮对话 1st dialogue turn
response, history = model.chat(tokenizer, "你好", history=None)
print(response)
# 你好!很高兴为你提供帮助。

# 第二轮对话 2nd dialogue turn
response, history = model.chat(tokenizer, "给我讲一个年轻人奋斗创业最终取得成功的故事。", history=history)
print(response)
# 这是一个关于一个年轻人奋斗创业最终取得成功的故事。
# 故事的主人公叫李明,他来自一个普通的家庭,父母都是普通的工人。从小,李明就立下了一个目标:要成为一名成功的企业家。
# 为了实现这个目标,李明勤奋学习,考上了大学。在大学期间,他积极参加各种创业比赛,获得了不少奖项。他还利用课余时间去实习,积累了宝贵的经验。
# 毕业后,李明决定开始自己的创业之路。他开始寻找投资机会,但多次都被拒绝了。然而,他并没有放弃。他继续努力,不断改进自己的创业计划,并寻找新的投资机会。
# 最终,李明成功地获得了一笔投资,开始了自己的创业之路。他成立了一家科技公司,专注于开发新型软件。在他的领导下,公司迅速发展起来,成为了一家成功的科技企业。
# 李明的成功并不是偶然的。他勤奋、坚韧、勇于冒险,不断学习和改进自己。他的成功也证明了,只要努力奋斗,任何人都有可能取得成功。

# 第三轮对话 3rd dialogue turn
response, history = model.chat(tokenizer, "给这个故事起一个标题", history=history)
print(response)
# 《奋斗创业:一个年轻人的成功之路》然后在终端运行以下命令:
cd /root/autodl-tmp
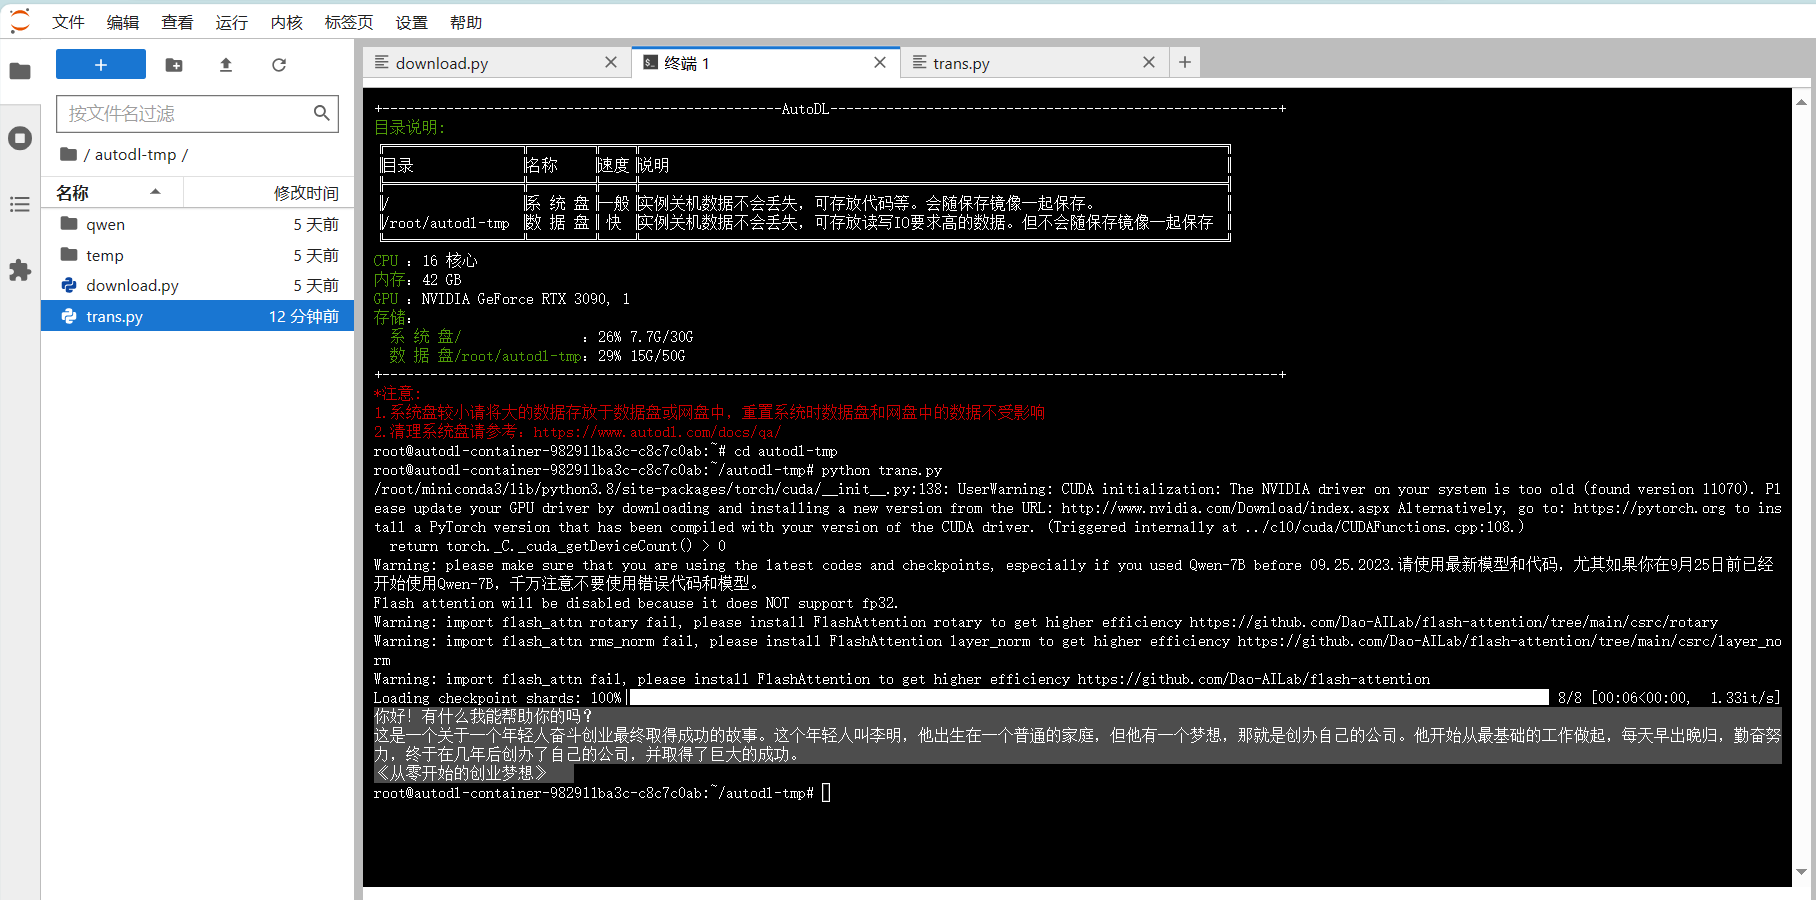
python trans.py加载完毕后,就可以看到模型生成的对话回答。(需要耐心等待一下哦!)
Qwen-7B-Chat FastApi 部署调用
环境准备
在autodl平台中租一个3090等24G显存的显卡机器,如下图所示镜像选择PyTorch-->2.0.0-->3.8(ubuntu20.04)-->11.8(11.3版本以上的都可以) 接下来打开刚刚租用服务器的JupyterLab, 图像 并且打开其中的终端开始环境配置、模型下载和运行演示。
pip换源和安装依赖包
# 升级pip
python -m pip install --upgrade pip
# 更换 pypi 源加速库的安装
pip config set global.index-url https://pypi.tuna.tsinghua.edu.cn/simple

pip install fastapi==0.104.1
pip install uvicorn==0.24.0.post1
pip install requests==2.25.1
pip install modelscope==1.9.5
pip install transformers==4.35.2
pip install streamlit==1.24.0
pip install sentencepiece==0.1.99
pip install accelerate==0.24.1
pip install transformers_stream_generator==0.0.4模型下载
使用 modelscope 中的snapshot_download函数下载模型,第一个参数为模型名称,参数cache_dir为模型的下载路径。
在 /root/autodl-tmp 路径下新建 download.py 文件并在其中输入以下内容,粘贴代码后记得保存文件,如下图所示。并运行 python /root/autodl-tmp/download.py 执行下载,模型大小为15 GB,下载模型大概需要10~20分钟
import torch
from modelscope import snapshot_download, AutoModel, AutoTokenizer
from modelscope import GenerationConfig
model_dir = snapshot_download('qwen/Qwen-7B-Chat', cache_dir='/root/autodl-tmp', revision='v1.1.4')代码准备
在/root/autodl-tmp路径下新建api.py文件并在其中输入以下内容,粘贴代码后记得保存文件。下面的代码有很详细的注释,大家如有不理解的地方,欢迎提出issue。
from fastapi import FastAPI, Request
from transformers import AutoTokenizer, AutoModelForCausalLM, GenerationConfig
import uvicorn
import json
import datetime
import torch

# 设置设备参数
DEVICE = "cuda"  # 使用CUDA
DEVICE_ID = "0"  # CUDA设备ID,如果未设置则为空
CUDA_DEVICE = f"{DEVICE}:{DEVICE_ID}" if DEVICE_ID else DEVICE  # 组合CUDA设备信息

# 清理GPU内存函数
def torch_gc():
    if torch.cuda.is_available():  # 检查是否可用CUDA
        with torch.cuda.device(CUDA_DEVICE):  # 指定CUDA设备
            torch.cuda.empty_cache()  # 清空CUDA缓存
            torch.cuda.ipc_collect()  # 收集CUDA内存碎片

# 创建FastAPI应用
app = FastAPI()

# 处理POST请求的端点
@app.post("/")
async def create_item(request: Request):
    global model, tokenizer  # 声明全局变量以便在函数内部使用模型和分词器
    json_post_raw = await request.json()  # 获取POST请求的JSON数据
    json_post = json.dumps(json_post_raw)  # 将JSON数据转换为字符串
    json_post_list = json.loads(json_post)  # 将字符串转换为Python对象
    prompt = json_post_list.get('prompt')  # 获取请求中的提示
    history = json_post_list.get('history')  # 获取请求中的历史记录
    max_length = json_post_list.get('max_length')  # 获取请求中的最大长度
    top_p = json_post_list.get('top_p')  # 获取请求中的top_p参数
    temperature = json_post_list.get('temperature')  # 获取请求中的温度参数
    # 调用模型进行对话生成
    response, history = model.chat(
        tokenizer,
        prompt,
        history=history,
        max_length=max_length if max_length else 2048,  # 如果未提供最大长度,默认使用2048
        top_p=top_p if top_p else 0.7,  # 如果未提供top_p参数,默认使用0.7
        temperature=temperature if temperature else 0.95  # 如果未提供温度参数,默认使用0.95
    )
    now = datetime.datetime.now()  # 获取当前时间
    time = now.strftime("%Y-%m-%d %H:%M:%S")  # 格式化时间为字符串
    # 构建响应JSON
    answer = {
        "response": response,
        "history": history,
        "status": 200,
        "time": time
    }
    # 构建日志信息
    log = "[" + time + "] " + '", prompt:"' + prompt + '", response:"' + repr(response) + '"'
    print(log)  # 打印日志
    torch_gc()  # 执行GPU内存清理
    return answer  # 返回响应

# 主函数入口
if __name__ == '__main__':
    # 加载预训练的分词器和模型
    tokenizer = AutoTokenizer.from_pretrained("/root/autodl-tmp/qwen/Qwen-7B-Chat", trust_remote_code=True)
    model = AutoModelForCausalLM.from_pretrained("/root/autodl-tmp/qwen/Qwen-7B-Chat", device_map="auto", trust_remote_code=True).eval()
    model.generation_config = GenerationConfig.from_pretrained("/root/autodl-tmp/qwen/Qwen-7B-Chat", trust_remote_code=True) # 可指定
    model.eval()  # 设置模型为评估模式
    # 启动FastAPI应用
    # 用6006端口可以将autodl的端口映射到本地,从而在本地使用api
uvicorn.run(app, host='0.0.0.0', port=6006, workers=1) # 在指定端口和主机上启动应用Api 部署
在终端输入以下命令启动api服务
cd /root/autodl-tmp
python api.py加载完毕后出现如下信息说明成功。
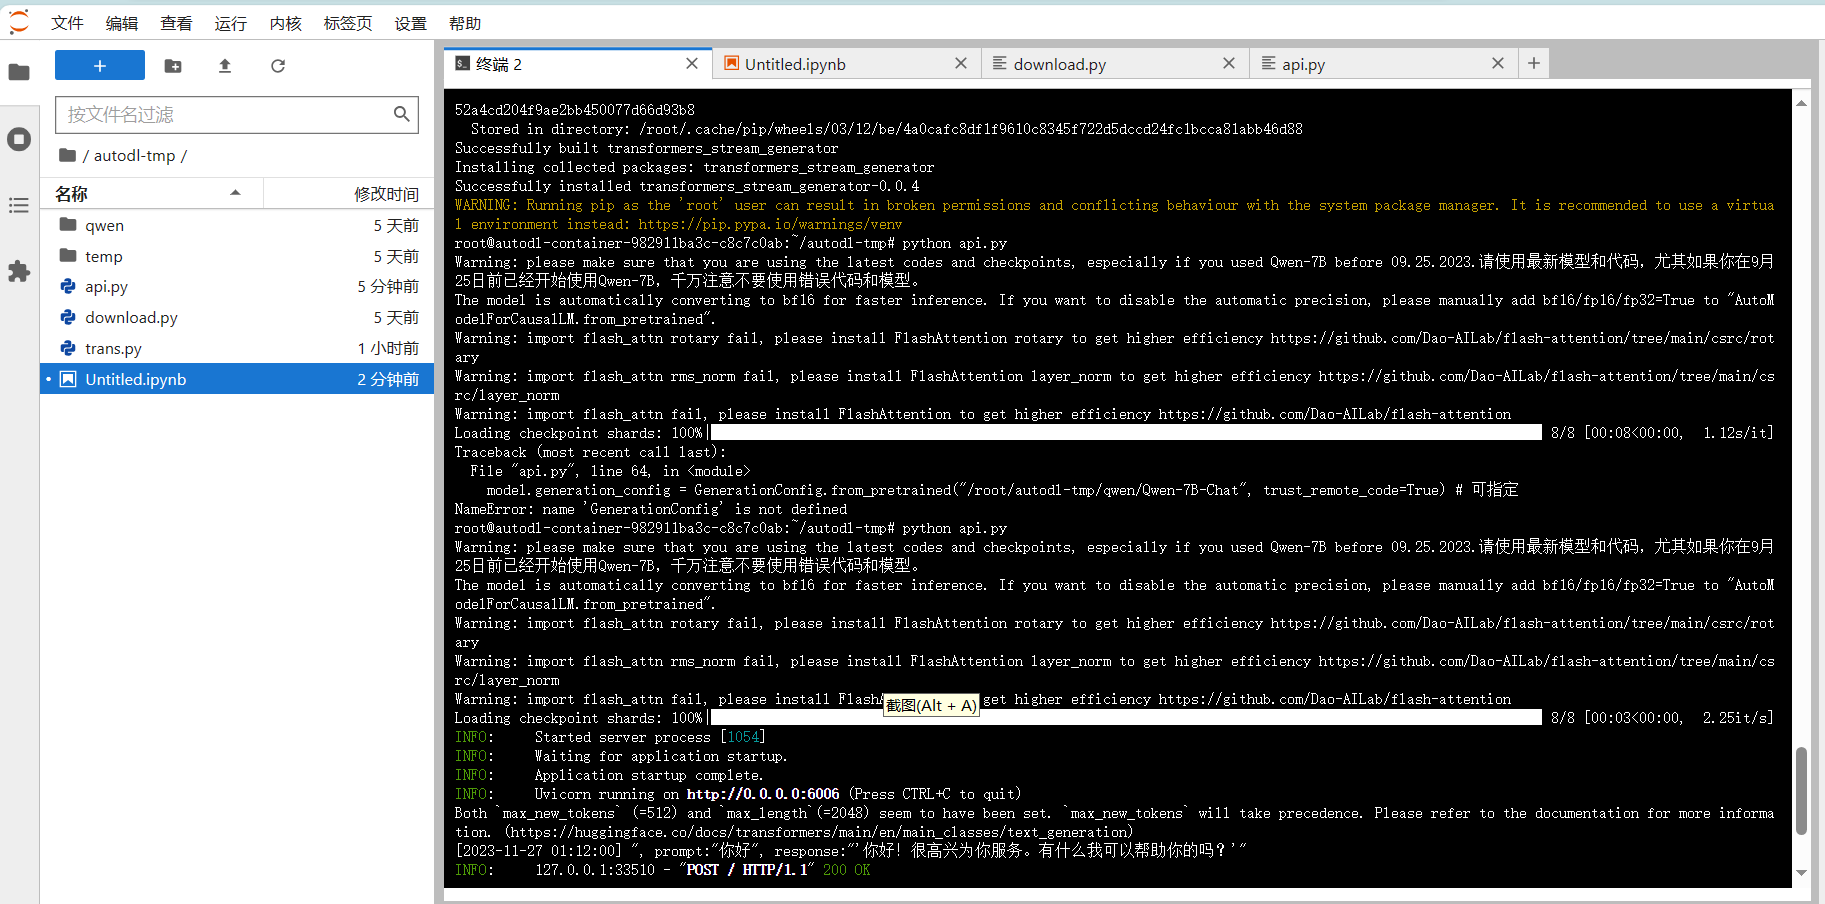
默认部署在 6006 端口,通过 POST 方法进行调用,可以使用curl调用,如下所示:
curl -X POST "http://127.0.0.1:6006" \
     -H 'Content-Type: application/json' \
-d '{"prompt": "你好", "history": []}'也可以使用python中的requests库进行调用,如下所示:
import requests
import json

def get_completion(prompt):
    headers = {'Content-Type': 'application/json'}
    data = {"prompt": prompt, "history": []}
    response = requests.post(url='http://127.0.0.1:6006', headers=headers, data=json.dumps(data))
    return response.json()['response']

if __name__ == '__main__':
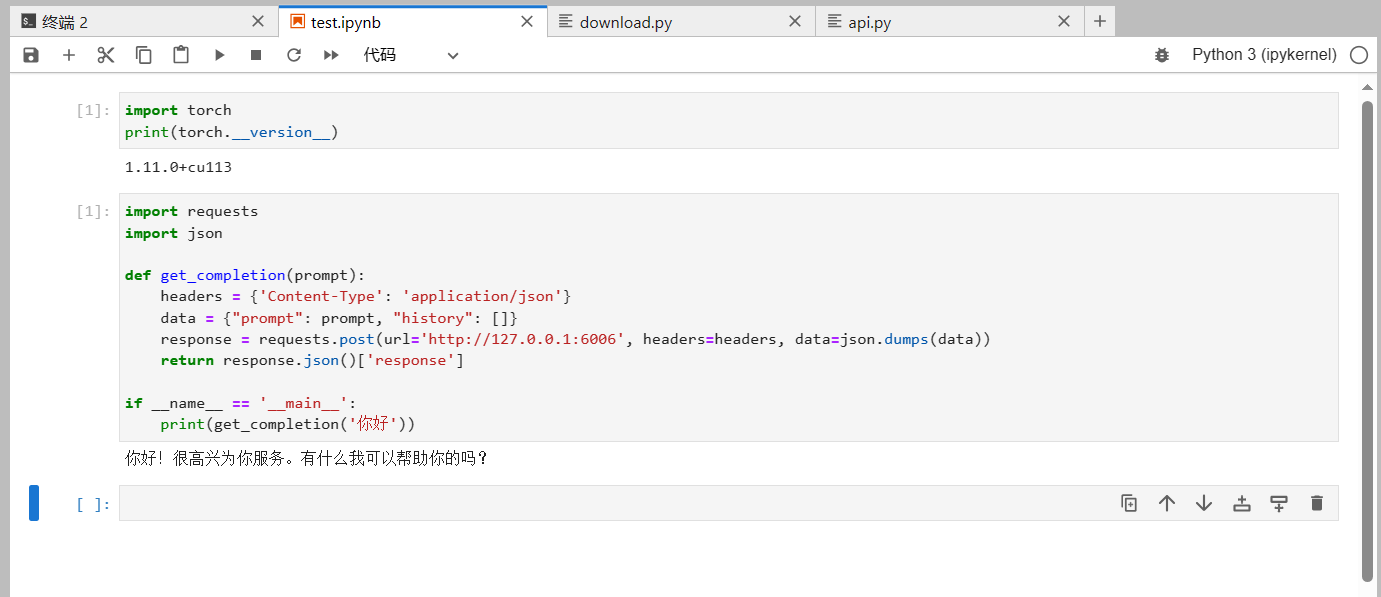
print(get_completion('你好'))得到的返回值如下所示:
{
  "response":"你好!很高兴为你服务。有什么我可以帮助你的吗?",
  "history":[["你好","你好!很高兴为你服务。有什么我可以帮助你的吗?"]],
  "status":200,
  "time":"2023-11-26 1:14:20"
}
Qwen-7B-Chat WebDemo
环境准备
在autodl平台中租一个3090等24G显存的显卡机器,如下图所示镜像选择PyTorch-->2.0.0-->3.8(ubuntu20.04)-->11.8
接下来打开刚刚租用服务器的JupyterLab,并且打开其中的终端开始环境配置、模型下载和运行demo。
pip换源和安装依赖包
# 升级pip
python -m pip install --upgrade pip
# 更换 pypi 源加速库的安装
pip config set global.index-url https://pypi.tuna.tsinghua.edu.cn/simple>

pip install modelscope==1.9.5
pip install "transformers>=4.32.0" accelerate tiktoken einops scipy transformers_stream_generator==0.0.4 peft deepspeed模型下载
使用 modelscope 中的snapshot_download函数下载模型,第一个参数为模型名称,参数cache_dir为模型的下载路径。
在 /root/autodl-tmp 路径下新建 download.py 文件并在其中输入以下内容,粘贴代码后记得保存文件,如下图所示。并运行 python /root/autodl-tmp/download.py执行下载,模型大小为 15 GB,下载模型大概需要 10~20 分钟
import torch
from modelscope import snapshot_download, AutoModel, AutoTokenizer
from modelscope import GenerationConfig
model_dir = snapshot_download('qwen/Qwen-7B-Chat', cache_dir='/root/autodl-tmp', revision='v1.1.4')代码准备
首先clone代码,打开autodl平台自带的学术镜像加速。学术镜像加速详细使用请看:https://www.autodl.com/docs/network_turbo/
source /etc/network_turbo然后切换路径, clone代码.
cd /root/autodl-tmp
git clone https://github.com/QwenLM/Qwen.git切换commit版本,与教程commit版本保持一致,可以让大家更好的复现。
cd Qwen
git checkout 981c89b2a95676a4f98e94218c192c095bed5364最后取消镜像加速,因为该加速可能对正常网络造成一定影响,避免对后续下载其他模型造成困扰。
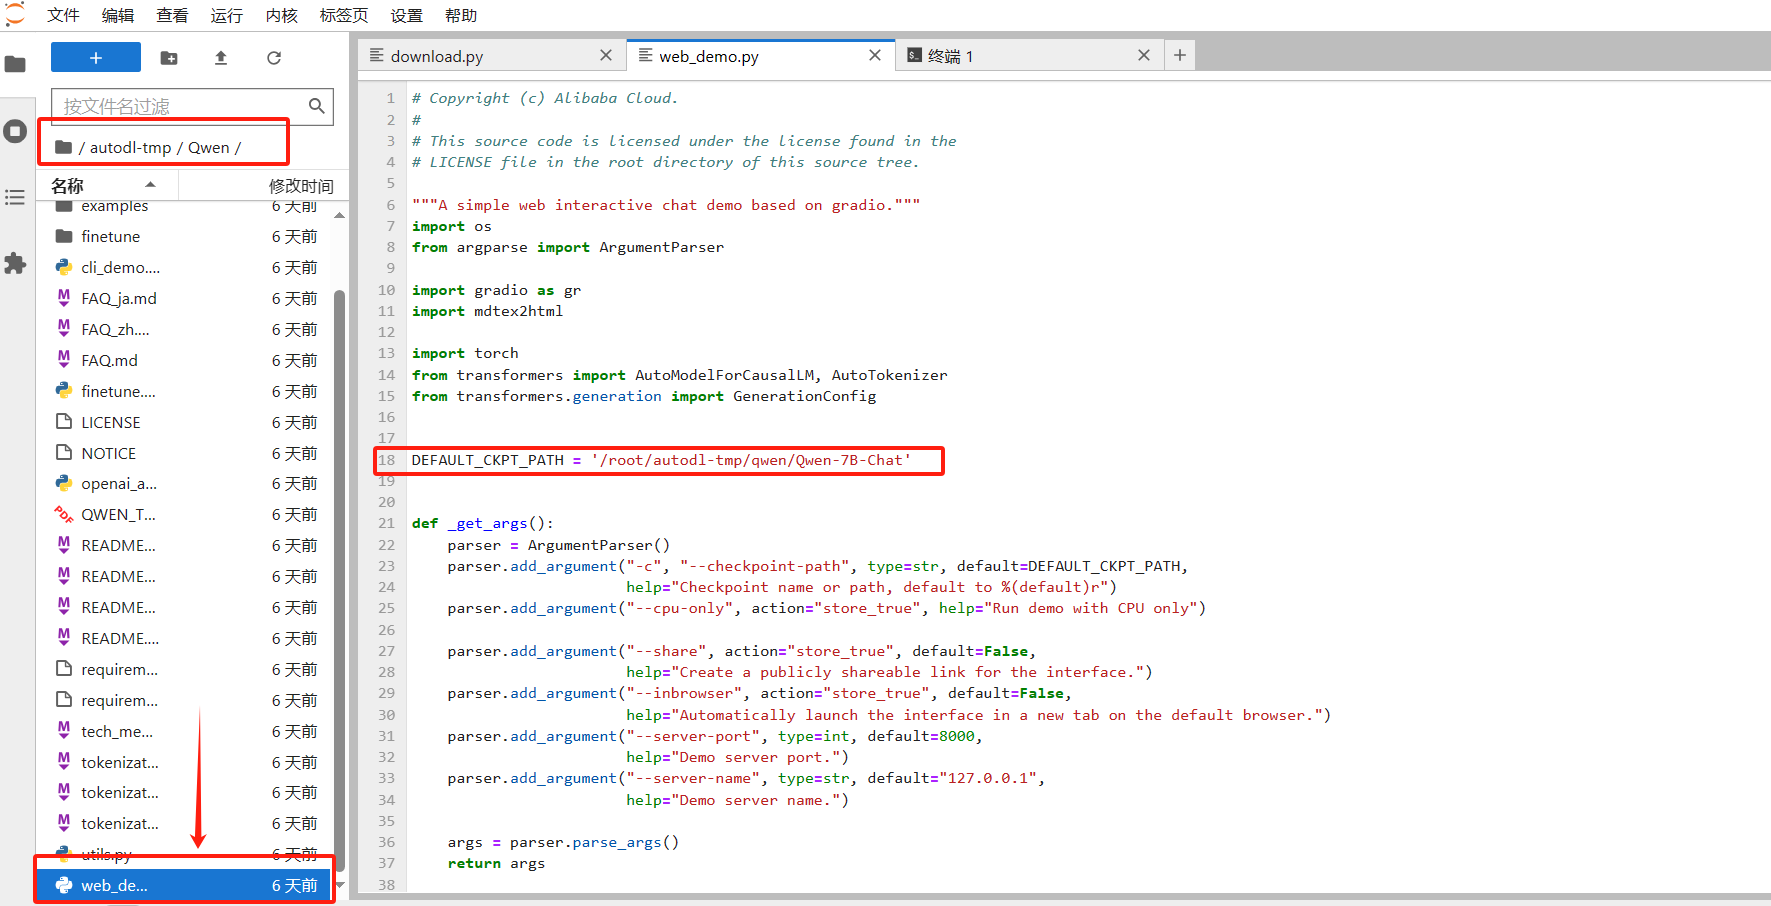
unset http_proxy && unset https_proxy修改代码路径,将 /root/autodl-tmp/Qwen/web_demo.py中 13 行的模型更换为本地的/root/autodl-tmp/qwen/Qwen-7B-Chat。
demo运行
执行下面的命令安装依赖包:
cd /root/autodl-tmp/Qwen
pip install -r requirements.txt
pip install -r requirements_web_demo.txt运行以下命令即可启动推理服务
cd /root/autodl-tmp/Qwen
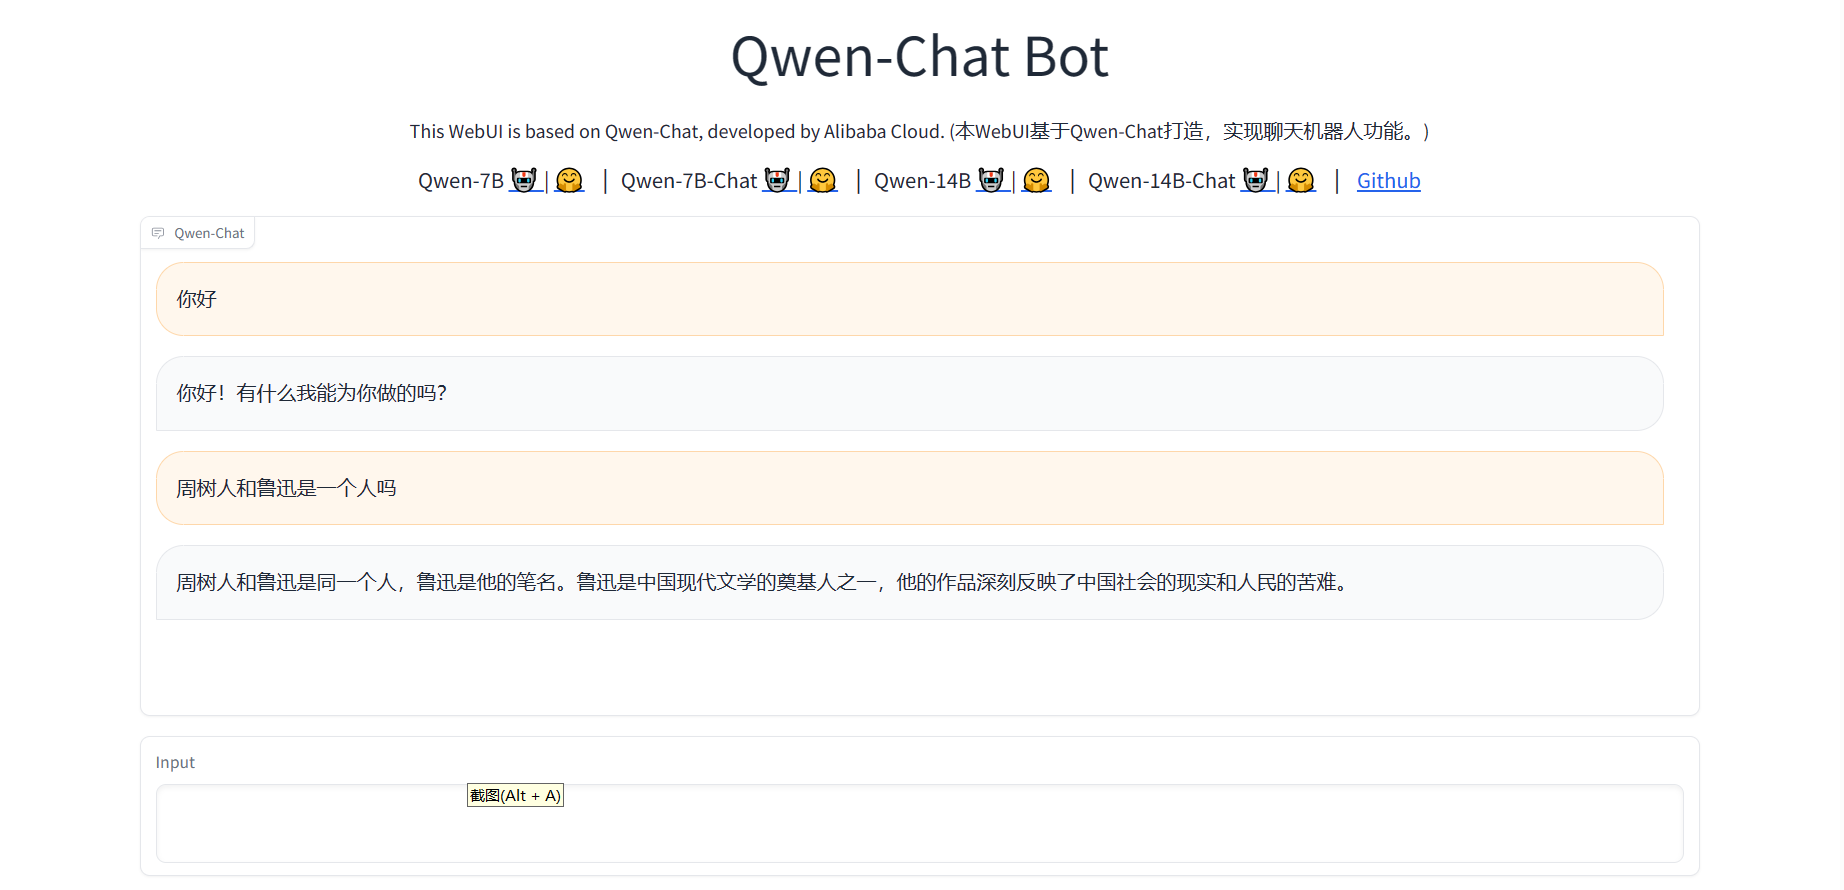
python web_demo.py --server-port 6006将 autodl 的端口映射到本地的 http://localhost:6006 即可看到demo界面。
注意:要在浏览器打开http://localhost:6006页面后,模型才会加载,如下图所示:
04-Qwen-7B-Chat Lora 微调
概述
本节我们简要介绍如何基于 transformers、peft 等框架,对 Qwen-7B-Chat 模型进行 Lora 微调。Lora 是一种高效微调方法,深入了解其原理可参见博客:知乎|深入浅出Lora。
本节所讲述的代码脚本在同级目录 04-Qwen-7B-Chat Lora 微调 下,运行该脚本来执行微调过程,但注意,本文代码未使用分布式框架,微调 Qwen-7B-Chat 模型至少需要 24G 及以上的显存,且需要修改脚本文件中的模型路径和数据集路径。
环境配置
在完成基本环境配置和本地模型部署的情况下,你还需要安装一些第三方库,可以使用以下命令:
pip install transformers==4.35.2
pip install peft==0.4.0
pip install datasets==2.10.1
pip install accelerate==0.20.3
pip install tiktoken
pip install transformers_stream_generator指令集构建
LLM 的微调一般指指令微调过程。所谓指令微调,是说我们使用的微调数据形如:
{
    "instrution":"回答以下用户问题,仅输出答案。",
    "input":"1+1等于几?",
    "output":"2"
}其中,instruction 是用户指令,告知模型其需要完成的任务;input 是用户输入,是完成用户指令所必须的输入内容;output 是模型应该给出的输出。
即我们的核心训练目标是让模型具有理解并遵循用户指令的能力。因此,在指令集构建时,我们应针对我们的目标任务,针对性构建任务指令集。例如,在本节我们使用由笔者合作开源的 Chat-甄嬛 项目作为示例,我们的目标是构建一个能够模拟甄嬛对话风格的个性化 LLM,因此我们构造的指令形如:##
{
    "instruction": "现在你要扮演皇帝身边的女人--甄嬛",
    "input":"你是谁?",
    "output":"家父是大理寺少卿甄远道。"
}我们所构造的全部指令数据集在根目录下。
数据格式化
Lora 训练的数据是需要经过格式化、编码之后再输入给模型进行训练的,如果是熟悉 Pytorch 模型训练流程的同学会知道,我们一般需要将输入文本编码为 input_ids,将输出文本编码为 labels,编码之后的结果都是多维的向量。我们首先定义一个预处理函数,这个函数用于对每一个样本,编码其输入、输出文本并返回一个编码后的字典:
def process_func(example):
    MAX_LENGTH = 384    # Llama分词器会将一个中文字切分为多个token,因此需要放开一些最大长度,保证数据的完整性
    input_ids, attention_mask, labels = [], [], []
    instruction = tokenizer("\n".join(["<|im_start|>system", "现在你要扮演皇帝身边的女人--甄嬛.<|im_end|>" + "\n<|im_start|>user\n" + example["instruction"] + example["input"] + "<|im_end|>\n"]).strip(), add_special_tokens=False)  # add_special_tokens 不在开头加 special_tokens
    response = tokenizer("<|im_start|>assistant\n" + example["output"] + "<|im_end|>\n", add_special_tokens=False)
    input_ids = instruction["input_ids"] + response["input_ids"] + [tokenizer.pad_token_id]
    attention_mask = instruction["attention_mask"] + response["attention_mask"] + [1]  # 因为eos token咱们也是要关注的所以 补充为1
    labels = [-100] * len(instruction["input_ids"]) + response["input_ids"] + [tokenizer.pad_token_id]  # Qwen的特殊构造就是这样的
    if len(input_ids) > MAX_LENGTH:  # 做一个截断
        input_ids = input_ids[:MAX_LENGTH]
        attention_mask = attention_mask[:MAX_LENGTH]
        labels = labels[:MAX_LENGTH]
    return {
        "input_ids": input_ids,
        "attention_mask": attention_mask,
        "labels": labels
}经过格式化的数据,也就是送入模型的每一条数据,都是一个字典,包含了 input_ids、attention_mask、labels 三个键值对,其中 input_ids 是输入文本的编码,attention_mask 是输入文本的 attention mask,labels 是输出文本的编码。decode之后应该是这样的:
<|im_start|>system
现在你要扮演皇帝身边的女人--甄嬛.<|im_end|>
<|im_start|>user
小姐,别的秀女都在求中选,唯有咱们小姐想被撂牌子,菩萨一定记得真真儿的——<|im_end|>
<|im_start|>assistant
嘘——都说许愿说破是不灵的。<|im_end|>
<|endoftext|>为什么会是这个形态呢?好问题!不同模型所对应的格式化输入都不一样,所以需要我们深度模型的训练源码来查看,因为按照原本模型指令微调的形式进行Lora微调效果应该是最好的,所以我们依然遵循原本模型的输入格式。OK,这里我给大家放一下源码的链接,各位如果感兴趣可以自行探索一下:
加载tokenizer和半精度模型
模型以半精度形式加载,如果你的显卡比较新的话,可以用torch.bfolat形式加载。对于自定义的模型一定要指定trust_remote_code参数为True。
tokenizer = AutoTokenizer.from_pretrained('/root/autodl-tmp/qwen/Qwen-7B-Chat', use_fast=False, trust_remote_code=True)
tokenizer.pad_token_id = tokenizer.eod_id # Qwen中eod_id和pad_token_id是一样的,但需要指定一下

# 模型以半精度形式加载,如果你的显卡比较新的话,可以用torch.bfolat形式加载
model = AutoModelForCausalLM.from_pretrained('/root/autodl-tmp/qwen/Qwen-7B-Chat', trust_remote_code=True, torch_dtype=torch.half, device_map="auto")定义LoraConfig
LoraConfig这个类中可以设置很多参数,但主要的参数没多少,简单讲一讲,感兴趣的同学可以直接看源码。
task_type:模型类型
target_modules:需要训练的模型层的名字,主要就是attention部分的层,不同的模型对应的层的名字不同,可以传入数组,也可以字符串,也可以正则表达式。
r:lora的秩,具体可以看Lora原理
lora_alpha:Lora alaph,具体作用参见 Lora 原理
Lora的缩放是啥嘞?当然不是r(秩),这个缩放就是lora_alpha/r, 在这个LoraConfig中缩放就是4倍。
config = LoraConfig(
    task_type=TaskType.CAUSAL_LM,
    target_modules=["c_attn", "c_proj", "w1", "w2"],
    inference_mode=False, # 训练模式
    r=8, # Lora 秩
    lora_alpha=32, # Lora alaph,具体作用参见 Lora 原理
    lora_dropout=0.1# Dropout 比例
)自定义 TrainingArguments 参数
TrainingArguments这个类的源码也介绍了每个参数的具体作用,当然大家可以来自行探索,这里就简单说几个常用的。
output_dir:模型的输出路径
per_device_train_batch_size:顾名思义 batch_size
gradient_accumulation_steps: 梯度累加,如果你的显存比较小,那可以把 batch_size 设置小一点,梯度累加增大一些。
logging_steps:多少步,输出一次log
num_train_epochs:顾名思义 epoch
gradient_checkpointing:梯度检查,这个一旦开启,模型就必须执行model.enable_input_require_grads(),这个原理大家可以自行探索,这里就不细说了。
args = TrainingArguments(
    output_dir="./output/Qwen",
    per_device_train_batch_size=8,
    gradient_accumulation_steps=2,
    logging_steps=10,
    num_train_epochs=3,
    gradient_checkpointing=True,
    save_steps=100,
    learning_rate=1e-4,
    save_on_each_node=True
)使用 Trainer 训练
把 model 放进去,把上面设置的参数放进去,数据集放进去,OK!开始训练!
trainer = Trainer(
    model=model,
    args=args,
    train_dataset=tokenized_id,
    data_collator=DataCollatorForSeq2Seq(tokenizer=tokenizer, padding=True),
)
trainer.train()模型推理
可以用这种比较经典的方式推理。
model.eval()
ipt = tokenizer("<|im_start|>system\n现在你要扮演皇帝身边的女人--甄嬛.<|im_end|>\n<|im_start|>user\n{}<|im_end|>\n".format("你是谁?", "").strip() + "\nAssistant: ", return_tensors="pt").to(model.device)
tokenizer.decode(model.generate(**ipt, max_length=512, do_sample=True, eos_token_id=tokenizer.eos_token_id, temperature=0.1)[0], skip_special_tokens=True)也可以使用Qwen自定的方式进行推理
response, history = model.chat(tokenizer, "你是谁", history=[], system="现在你要扮演皇帝身边的女人--甄嬛.")05-Qwen-7B-Chat Ptuning 微调
Ptuning原理
数据加载与模型配置与LoRa一致,在此具体讲一下Ptuning的细节: 基本原理为冻结主模型全部参数,在训练数据前加入一小段Prompt,之训练Prompt的嵌入层。在Ptuning中,只有soft prompt,是自动学习的,不用人工设置。
在Prompt-tuning的时候,前面只是增加了一个Prompt Embedding.
在Ptuning这里替换为了Prompt Encoder,新加了LSTM/MLP+Embedding.
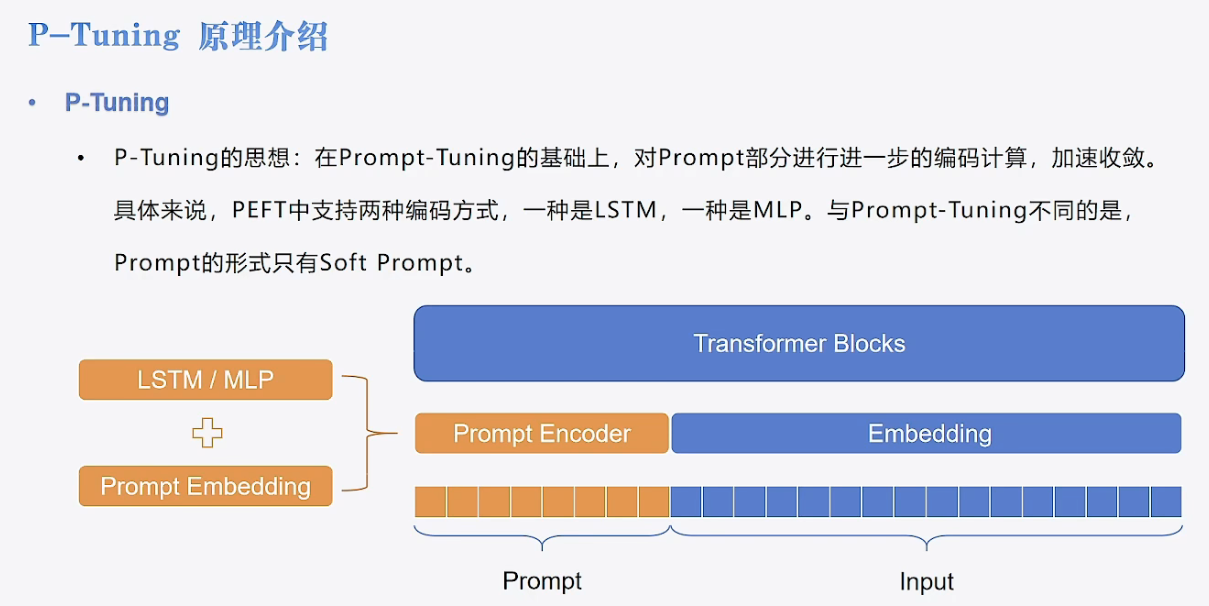
Ptuning PEFT模块
PromptEncoderReparameterizationType来决定到底是用LSTM还是MLP
可调的参数有:num_virtual_tokens、encoder_reparameterization_type、encoder_dropout、encoder_num_layers、encoder_hidden_size
注意,encoder_num_layers设置层数,但MLP设置层数固定为2,此参数只对LSTM时有效。
from peft import PromptEncoderConfig, TaskType, get_peft_model, PromptEncoderReparameterizationType

config = PromptEncoderConfig(task_type=TaskType.CAUSAL_LM, num_virtual_tokens=10,
                             encoder_reparameterization_type=PromptEncoderReparameterizationType.MLP,
                             encoder_dropout=0.1, encoder_num_layers=5, encoder_hidden_size=1024)
config
'''
PromptEncoderConfig(peft_type=<PeftType.P_TUNING: 'P_TUNING'>, auto_mapping=None, base_model_name_or_path=None, revision=None, task_type=<TaskType.CAUSAL_LM: 'CAUSAL_LM'>, inference_mode=False, num_virtual_tokens=10, token_dim=None, num_transformer_submodules=None, num_attention_heads=None, num_layers=None, encoder_reparameterization_type=<PromptEncoderReparameterizationType.MLP: 'MLP'>, encoder_hidden_size=1024, encoder_num_layers=5, encoder_dropout=0.1)
'''Qwen-7B-chat 全量微调
修改代码
首先我们要准训练模型的代码,这里我们使用的 modelscope 上的 Qwen-7B-chat 模型,大家自行下载即可。
OK,模型下载完毕之后,我们就要准备代码文件。其实全量微调和 Lora 微调的代码基本一样,都采用了 Trainer 类来进行训练。只不过在全量微调的时候没有加载 LoraConfig,那我就直接给出代码,如果对代有什么问题,大家可以先自行探索Qwen lora的代码解释,有什么不懂的地方可以提Issue。
需要把代码中的模型地址修改一下,改成自己的模型地址。
from datasets import Dataset
import pandas as pd
from transformers import AutoTokenizer, AutoModelForCausalLM, DataCollatorForSeq2Seq, TrainingArguments, HfArgumentParser, Trainer
import os
import torch
from dataclasses import dataclass, field
import deepspeed
deepspeed.ops.op_builder.CPUAdamBuilder().load()


@dataclass
class FinetuneArguments:
    # 微调参数
    # field:dataclass 函数,用于指定变量初始化
    model_path: str = field(default="../../model/qwen/Qwen-7B-Chat/")

# 用于处理数据集的函数
def process_func(example):
    MAX_LENGTH = 128    # Llama分词器会将一个中文字切分为多个token,因此需要放开一些最大长度,保证数据的完整性
    input_ids, attention_mask, labels = [], [], []
    instruction = tokenizer("\n".join(["<|im_start|>system", "现在你要扮演皇帝身边的女人--甄嬛.<|im_end|>" + "\n<|im_start|>user\n" + example["instruction"] + example["input"] + "<|im_end|>\n"]).strip(), add_special_tokens=False)  # add_special_tokens 不在开头加 special_tokens
    response = tokenizer("<|im_start|>assistant\n" + example["output"] + "<|im_end|>\n", add_special_tokens=False)
    input_ids = instruction["input_ids"] + response["input_ids"] + [tokenizer.pad_token_id]
    attention_mask = instruction["attention_mask"] + response["attention_mask"] + [1]  # 因为eos token咱们也是要关注的所以 补充为1
    labels = [-100] * len(instruction["input_ids"]) + response["input_ids"] + [tokenizer.pad_token_id]  # Qwen的特殊构造就是这样的
    if len(input_ids) > MAX_LENGTH:  # 做一个截断
        input_ids = input_ids[:MAX_LENGTH]
        attention_mask = attention_mask[:MAX_LENGTH]
        labels = labels[:MAX_LENGTH]
    return {
        "input_ids": input_ids,
        "attention_mask": attention_mask,
        "labels": labels
    }


if "__main__" == __name__:
    # 解析参数
    # Parse 命令行参数
    finetune_args, training_args = HfArgumentParser(
        (FinetuneArguments, TrainingArguments)
    ).parse_args_into_dataclasses()

    # 处理数据集
    # 将JSON文件转换为CSV文件
    df = pd.read_json('./data/huanhuan.json')
    ds = Dataset.from_pandas(df)
    # 加载tokenizer
    tokenizer = AutoTokenizer.from_pretrained(finetune_args.model_path, use_fast=False, trust_remote_code=True)
    tokenizer.pad_token_id = tokenizer.eod_id
    # 将数据集变化为token形式
    tokenized_id = ds.map(process_func, remove_columns=ds.column_names)

    # 创建模型并以半精度形式加载
    model = AutoModelForCausalLM.from_pretrained(finetune_args.model_path, trust_remote_code=True, torch_dtype=torch.half, device_map={"": int(os.environ.get("LOCAL_RANK") or 0)})

    # 使用trainer训练
    trainer = Trainer(
        model=model,
        args=training_args,
        train_dataset=tokenized_id,
        data_collator=DataCollatorForSeq2Seq(tokenizer=tokenizer, padding=True),
        )
    trainer.train() # 开始训练
    response, history = model.chat(tokenizer, "你是谁", history=[], system="现在你要扮演皇帝身边的女人--甄嬛.")
print(response)DeepSpeed 环境配置
DeepSpeed 是微软开源的一个深度学习训练框架,可以用于分布式训练,同时还可以加速训练,减少显存占用。这里我们使用的是 DeepSpeed 的半精度训练,可以减少显存占用,加快训练速度。
首先我们需要安装 DeepSpeed,DeepSpeed 的安装很简单,但如果没有按照如下步骤安装,可能会出现一些问题。
首先创建一个崭新的,干净的conda环境,注意一定要使用当前目录下提供的environment.yml文件来创建环境,否则可能会出现一些问题。接着激活环境,安装deepspeed,使用DS_BUILD_OPS=1来安装deepspeed,这样会避免后续的很多报错。
conda env create -n deepspeed -f environment.yml --force
conda activate deepspeed
DS_BUILD_OPS=1 pip install deepspeed然后就是安装transformers等其他依赖,注意不需要再安装torch了,在创建环境的时候torch已经安装了。
pip install modelscope==1.9.5
pip install transformers==4.35.2
pip install streamlit==1.24.0
pip install sentencepiece==0.1.99
pip install accelerate==0.24.1
pip install datasets sentencepiece
pip install tiktoken
pip install transformers_stream_generator注意:本环境是在aws服务器上安装并运行的,假如您在安装或者运行过程中遇到其他问题,欢迎提出issue,然后您解决之后,可以顺便提交PR,为项目添砖加瓦。
模型训练
首先创建deepspeed的config.json文件。我使用的是stage-2的配置。如果不懂也没关系,直接粘贴复制,创建为ds_config.json文件即可。
{
    "fp16": {
        "enabled": "auto",
        "loss_scale": 0,
        "loss_scale_window": 1000,
        "initial_scale_power": 16,
        "hysteresis": 2,
        "min_loss_scale": 1
    },
    "optimizer": {
        "type": "AdamW",
        "params": {
            "lr": "auto",
            "betas": "auto",
            "eps": "auto",
            "weight_decay": "auto"
        }
    },

    "scheduler": {
        "type": "WarmupDecayLR",
        "params": {
            "last_batch_iteration": -1,
            "total_num_steps": "auto",
            "warmup_min_lr": "auto",
            "warmup_max_lr": "auto",
            "warmup_num_steps": "auto"
        }
    },

    "zero_optimization": {
        "stage": 2,
        "offload_optimizer": {
            "device": "cpu",
            "pin_memory": true
        },
        "offload_param": {
            "device": "cpu",
            "pin_memory": true
        },
        "allgather_partitions": true,
        "allgather_bucket_size": 5e8,
        "overlap_comm": true,
        "reduce_scatter": true,
        "reduce_bucket_size": 5e8,
        "contiguous_gradients": true
    },
    "activation_checkpointing": {
        "partition_activations": false,
        "cpu_checkpointing": false,
        "contiguous_memory_optimization": false,
        "number_checkpoints": null,
        "synchronize_checkpoint_boundary": false,
        "profile": false
    },
    "gradient_accumulation_steps": "auto",
    "gradient_clipping": "auto",
    "steps_per_print": 2000,
    "train_batch_size": "auto",
    "min_lr": 5e-7,
    "train_micro_batch_size_per_gpu": "auto",
    "wall_clock_breakdown": false
}然后我们来创建运行所需的bash文,创建一个train.sh文件,内容如下:
num_gpus=4

deepspeed --num_gpus $num_gpus train.py \
    --deepspeed ./ds_config.json \
    --output_dir="./output/Qwen" \
    --per_device_train_batch_size=1 \
    --gradient_accumulation_steps=1 \
    --logging_steps=10 \
    --num_train_epochs=3 \
    --save_steps=100 \
    --learning_rate=1e-4 \
--save_on_each_node=True \接着在命令行输入:bash train.sh,开始训练。
注意:
因为本脚本使用了adam_cpu来加载优化器参数,所以全量微调所需的显存会比较小,但仍然需要使用至少4张24G显存的卡来训练。
如果第一步创建deepspeed环境时候,没有使用DS_BUILD_OPS=1,那么可能会出现一些问题,比如RuntimeError: Expected all tensors to be on the same device, but found at least two devices, cuda:0 and cpu!,这个时候需要重新创建环境,然后再次运行。
Qwen-7B-Chat 接入langchain搭建知识库助手
环境准备
在autodl平台中租一个3090等24G显存的显卡机器,如下图所示镜像选择PyTorch-->2.0.0-->3.8(ubuntu20.04)-->11.8
接下来打开刚刚租用服务器的JupyterLab,并且打开其中的终端开始环境配置、模型下载和运行demo。
pip换源和安装依赖包
# 升级pip
python -m pip install --upgrade pip
# 更换 pypi 源加速库的安装
pip config set global.index-url https://pypi.tuna.tsinghua.edu.cn/simple

pip install modelscope==1.9.5
pip install "transformers>=4.32.0" accelerate tiktoken einops scipy transformers_stream_generator==0.0.4 peft deepspeed
pip install -U huggingface_hub模型下载
在已完成Qwen-7B-chat部署的基础上,我们还需要还需要安装以下依赖包。 请在终端复制粘贴以下命令,并按回车运行:
pip install langchain==0.0.292
pip install gradio==4.4.0
pip install chromadb==0.4.15
pip install sentence-transformers==2.2.2
pip install unstructured==0.10.30
pip install markdown==3.3.7这里使用huggingface镜像下载到本地 /root/autodl-tmp/embedding_model,你也可以选择其它的方式下载
在 /root/autodl-tmp 路径下新建 download.py 文件并在其中输入以下内容,粘贴代码后记得保存文件,如下图所示。并运行 python /root/autodl-tmp/download.py执行下载。
import os
# 设置环境变量
os.environ['HF_ENDPOINT'] = 'https://hf-mirror.com'
# 下载模型
os.system('huggingface-cli download --resume-download sentence-transformers/paraphrase-multilingual-MiniLM-L12-v2 --local-dir /root/autodl-tmp/embedding_model')使用 modelscope 中的snapshot_download函数下载模型,第一个参数为模型名称,参数cache_dir为模型的下载路径。
在 /root/autodl-tmp 路径下新建 download.py 文件并在其中输入以下内容,粘贴代码后记得保存文件,如下图所示。并运行 python /root/autodl-tmp/download.py执行下载,模型大小为 15 GB,下载模型大概需要 10~20 分钟
~~~python import torch from modelscope import snapshot_download, AutoModel, AutoTokenizer import os model_dir = snapshot_download('qwen/Qwen-7B-Chat', cache_dir='/root/autodl-tmp', revision='master') ~~~
知识库建设
我们选用以下两个开源仓库作为知识库来源
首先我们需要将上述远程开源仓库 Clone 到本地,可以使用以下命令:
# 进入到数据库盘
cd /root/autodl-tmp
# 打开学术资源加速
source /etc/network_turbo
# clone 开源仓库
git clone https://github.com/QwenLM/Qwen.git
# 关闭学术资源加速
unset http_proxy && unset https_proxy接着,为语料处理方便,我们将选用上述仓库中所有的 markdown、txt 文件作为示例语料库。注意,也可以选用其中的代码文件加入到知识库中,但需要针对代码文件格式进行额外处理。
我们首先将上述仓库中所有满足条件的文件路径找出来,我们定义一个函数,该函数将递归指定文件夹路径,返回其中所有满足条件(即后缀名为 .md 或者 .txt 的文件)的文件路径:
import os
def get_files(dir_path):
    # args:dir_path,目标文件夹路径
    file_list = []
    for filepath, dirnames, filenames in os.walk(dir_path):
        # os.walk 函数将递归遍历指定文件夹
        for filename in filenames:
            # 通过后缀名判断文件类型是否满足要求
            if filename.endswith(".md"):
                # 如果满足要求,将其绝对路径加入到结果列表
                file_list.append(os.path.join(filepath, filename))
            elif filename.endswith(".txt"):
                file_list.append(os.path.join(filepath, filename))
return file_list得到所有目标文件路径之后,我们可以使用 LangChain 提供的 FileLoader 对象来加载目标文件,得到由目标文件解析出的纯文本内容。由于不同类型的文件需要对应不同的 FileLoader,我们判断目标文件类型,并针对性调用对应类型的 FileLoader,同时,调用 FileLoader 对象的 load 方法来得到加载之后的纯文本对象:
from tqdm import tqdm
from langchain.document_loaders import UnstructuredFileLoader
from langchain.document_loaders import UnstructuredMarkdownLoader

def get_text(dir_path):
    # args:dir_path,目标文件夹路径
    # 首先调用上文定义的函数得到目标文件路径列表
    file_lst = get_files(dir_path)
    # docs 存放加载之后的纯文本对象
    docs = []
    # 遍历所有目标文件
    for one_file in tqdm(file_lst):
    file_type = one_file.split('.')[-1]
        if file_type == 'md':
            loader = UnstructuredMarkdownLoader(one_file)
        elif file_type == 'txt':
            loader = UnstructuredFileLoader(one_file)
        else:
            # 如果是不符合条件的文件,直接跳过
            continue
        docs.extend(loader.load())
return docs使用上文函数,我们得到的 docs 为一个纯文本对象对应的列表。得到该列表之后,我们就可以将它引入到 LangChain 框架中构建向量数据库。由纯文本对象构建向量数据库,我们需要先对文本进行分块,接着对文本块进行向量化。
LangChain 提供了多种文本分块工具,此处我们使用字符串递归分割器,并选择分块大小为 500,块重叠长度为 150:
from langchain.text_splitter import RecursiveCharacterTextSplitter

text_splitter = RecursiveCharacterTextSplitter(
    chunk_size=500, chunk_overlap=150)
split_docs = text_splitter.split_documents(docs)LangChain 提供了直接引入 HuggingFace 开源社区中的模型进行向量化的接口:
from langchain.embeddings.huggingface import HuggingFaceEmbeddings

embeddings = HuggingFaceEmbeddings(model_name="/root/autodl-tmp/embedding_model")同时,我们选择 Chroma 作为向量数据库,基于上文分块后的文档以及加载的开源向量化模型,将语料加载到指定路径下的向量数据库:
from langchain.vectorstores import Chroma

# 定义持久化路径
persist_directory = 'data_base/vector_db/chroma'
# 加载数据库
vectordb = Chroma.from_documents(
    documents=split_docs,
    embedding=embeddings,
    persist_directory=persist_directory  # 允许我们将persist_directory目录保存到磁盘上
)
# 将加载的向量数据库持久化到磁盘上
vectordb.persist()将上述代码整合在一起为知识库搭建的脚本:
# 首先导入所需第三方库
from langchain.document_loaders import UnstructuredFileLoader
from langchain.document_loaders import UnstructuredMarkdownLoader
from langchain.text_splitter import RecursiveCharacterTextSplitter
from langchain.vectorstores import Chroma
from langchain.embeddings.huggingface import HuggingFaceEmbeddings
from tqdm import tqdm
import os

# 获取文件路径函数
def get_files(dir_path):
    # args:dir_path,目标文件夹路径
    file_list = []
    for filepath, dirnames, filenames in os.walk(dir_path):
        # os.walk 函数将递归遍历指定文件夹
        for filename in filenames:
            # 通过后缀名判断文件类型是否满足要求
            if filename.endswith(".md"):
                # 如果满足要求,将其绝对路径加入到结果列表
                file_list.append(os.path.join(filepath, filename))
            elif filename.endswith(".txt"):
                file_list.append(os.path.join(filepath, filename))
    return file_list

# 加载文件函数
def get_text(dir_path):
    # args:dir_path,目标文件夹路径
    # 首先调用上文定义的函数得到目标文件路径列表
    file_lst = get_files(dir_path)
    # docs 存放加载之后的纯文本对象
    docs = []
    # 遍历所有目标文件
    for one_file in tqdm(file_lst):
        file_type = one_file.split('.')[-1]
        if file_type == 'md':
            loader = UnstructuredMarkdownLoader(one_file)
        elif file_type == 'txt':
            loader = UnstructuredFileLoader(one_file)
        else:
            # 如果是不符合条件的文件,直接跳过
            continue
        docs.extend(loader.load())
    return docs

# 目标文件夹
tar_dir = [
    "/root/autodl-tmp/qwen",
    "/root/autodl-tmp/Qwen",
]

# 加载目标文件
docs = []
for dir_path in tar_dir:
    docs.extend(get_text(dir_path))

# 对文本进行分块
text_splitter = RecursiveCharacterTextSplitter(
    chunk_size=500, chunk_overlap=150)
split_docs = text_splitter.split_documents(docs)

# 加载开源词向量模型
embeddings = HuggingFaceEmbeddings(model_name="/root/autodl-tmp/embedding_model")

# 构建向量数据库
# 定义持久化路径
persist_directory = 'data_base/vector_db/chroma'
# 加载数据库
vectordb = Chroma.from_documents(
    documents=split_docs,
    embedding=embeddings,
    persist_directory=persist_directory  # 允许我们将persist_directory目录保存到磁盘上
)
# 将加载的向量数据库持久化到磁盘上
vectordb.persist()运行上述脚本,即可在本地构建已持久化的向量数据库,后续直接导入该数据库即可,无需重复构建。
QwenLM 接入LangChain
为便捷构建 LLM 应用,我们需要基于本地部署的 QwenLM,自定义一个 LLM 类,将 QwenLM 接入到 LangChain 框架中。完成自定义 LLM 类之后,可以以完全一致的方式调用 LangChain 的接口,而无需考虑底层模型调用的不一致。
基于本地部署的 QwenLM 自定义 LLM 类并不复杂,我们只需从 LangChain.llms.base.LLM 类继承一个子类,并重写构造函数与 _call 函数即可:
from langchain.llms.base import LLM
from typing import Any, List, Optional
from langchain.callbacks.manager import CallbackManagerForLLMRun
from transformers import AutoTokenizer, AutoModelForCausalLM, GenerationConfig


class QwenLM(LLM):
    # 基于本地 Qwen 自定义 LLM 类
    tokenizer : AutoTokenizer = None
    model: AutoModelForCausalLM = None

    def __init__(self, model_path :str):
        # model_path: Qwen 模型路径
        # 从本地初始化模型
        super().__init__()
        print("正在从本地加载模型...")
        model_dir = '/root/autodl-tmp/qwen/Qwen-7B-Chat'
        self.tokenizer = AutoTokenizer.from_pretrained(model_dir, trust_remote_code=True)
        self.model = AutoModelForCausalLM.from_pretrained(model_dir, device_map="auto", trust_remote_code=True).eval()
        # Specify hyperparameters for generation
        self.model.generation_config = GenerationConfig.from_pretrained(model_dir, trust_remote_code=True) # 可指定不同的生成长度、top_p等相关超参
        print("完成本地模型的加载")

    def _call(self, prompt : str, stop: Optional[List[str]] = None,
                run_manager: Optional[CallbackManagerForLLMRun] = None,
                **kwargs: Any):
        # 重写调用函数
        response, history = self.model.chat(self.tokenizer, prompt , history=[])
        return response

    @property
    def _llm_type(self) -> str:
return "QwenLM"在上述类定义中,我们分别重写了构造函数和 _call 函数:对于构造函数,我们在对象实例化的一开始加载本地部署的 Qwen 模型,从而避免每一次调用都需要重新加载模型带来的时间过长;_call 函数是 LLM 类的核心函数,LangChain 会调用该函数来调用 LLM,在该函数中,我们调用已实例化模型的 chat 方法,从而实现对模型的调用并返回调用结果。
在整体项目中,我们将上述代码封装为 LLM.py,后续将直接从该文件中引入自定义的 LLM 类。
构建检索问答链
LangChain 通过提供检索问答链对象来实现对于 RAG 全流程的封装。即我们可以调用一个 LangChain 提供的 RetrievalQA 对象,通过初始化时填入已构建的数据库和自定义 LLM 作为参数,来简便地完成检索增强问答的全流程,LangChain 会自动完成基于用户提问进行检索、获取相关文档、拼接为合适的 Prompt 并交给 LLM 问答的全部流程。
首先我们需要将上文构建的向量数据库导入进来,我们可以直接通过 Chroma 以及上文定义的词向量模型来加载已构建的数据库:
from langchain.vectorstores import Chroma
from langchain.embeddings.huggingface import HuggingFaceEmbeddings
import os

# 定义 Embeddings
embeddings = HuggingFaceEmbeddings(model_name="/root/autodl-tmp/embedding_model")

# 向量数据库持久化路径
persist_directory = 'data_base/vector_db/chroma'

# 加载数据库
vectordb = Chroma(
    persist_directory=persist_directory,
    embedding_function=embeddings
)上述代码得到的 vectordb 对象即为我们已构建的向量数据库对象,该对象可以针对用户的 query 进行语义向量检索,得到与用户提问相关的知识片段。
接着,我们实例化一个基于 QwenLM 自定义的 LLM 对象:
from LLM import QwenLM
llm = QwenLM(model_path = "/root/autodl-tmp/qwen")
llm.predict("你是谁")构建检索问答链,还需要构建一个 Prompt Template,该 Template 其实基于一个带变量的字符串,在检索之后,LangChain 会将检索到的相关文档片段填入到 Template 的变量中,从而实现带知识的 Prompt 构建。我们可以基于 LangChain 的 Template 基类来实例化这样一个 Template 对象:
from langchain.prompts import PromptTemplate

# 我们所构造的 Prompt 模板
template = """使用以下上下文来回答最后的问题。如果你不知道答案,就说你不知道,不要试图编造答案。尽量使答案简明扼要。总是在回答的最后说“谢谢你的提问!”。
{context}
问题: {question}
有用的回答:"""

# 调用 LangChain 的方法来实例化一个 Template 对象,该对象包含了 context 和 question 两个变量,在实际调用时,这两个变量会被检索到的文档片段和用户提问填充
QA_CHAIN_PROMPT = PromptTemplate(input_variables=["context","question"],template=template)最后,可以调用 LangChain 提供的检索问答链构造函数,基于我们的自定义 LLM、Prompt Template 和向量知识库来构建一个基于 Qwen 的检索问答链:
from langchain.chains import RetrievalQA

qa_chain = RetrievalQA.from_chain_type(llm,retriever=vectordb.as_retriever(),return_source_documents=True,chain_type_kwargs={"prompt":QA_CHAIN_PROMPT})得到的 qa_chain 对象即可以实现我们的核心功能,即基于 QwenLM 模型的专业知识库助手。我们可以对比该检索问答链和纯 LLM 的问答效果:
question = "什么是QwenLM"
result = qa_chain({"query": question})
print("检索问答链回答 question 的结果:")
print(result["result"])

# 仅 LLM 回答效果
result_2 = llm(question)
print("大模型回答 question 的结果:")
print(result_2)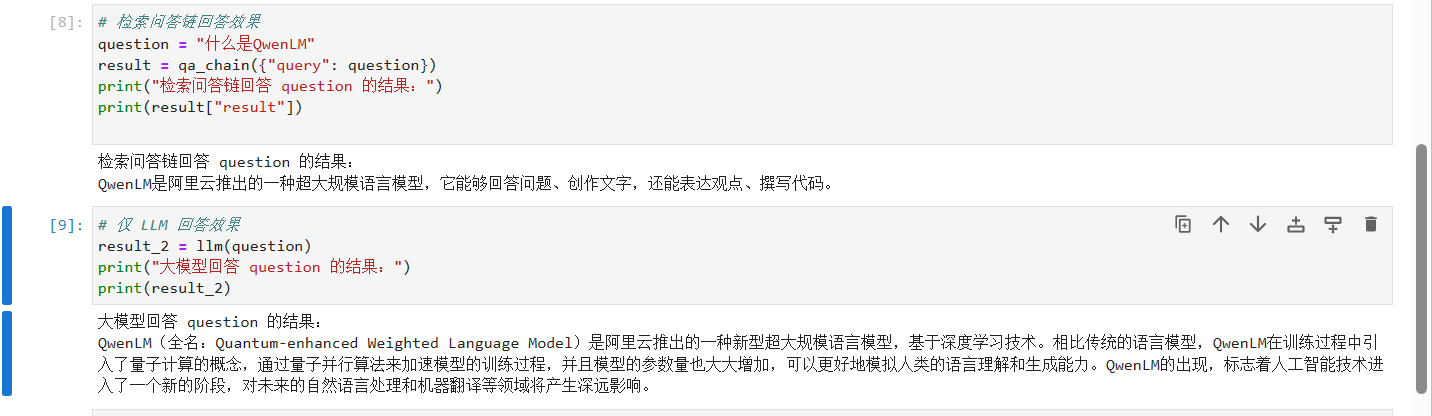
可以看到,使用检索问答链生成的答案更接近知识库里的内容。
部署WebDemo
在完成上述核心功能后,我们可以基于 Gradio 框架将其部署到 Web 网页,从而搭建一个小型 Demo,便于测试与使用。
我们首先将上文的代码内容封装为一个返回构建的检索问答链对象的函数,并在启动 Gradio 的第一时间调用该函数得到检索问答链对象,后续直接使用该对象进行问答对话,从而避免重复加载模型:
# 导入必要的库
import gradio as gr
from langchain.vectorstores import Chroma
from langchain.embeddings.huggingface import HuggingFaceEmbeddings
import os
from LLM import QwenLM
from langchain.prompts import PromptTemplate

def load_chain():
    # 加载问答链
    # 定义 Embeddings
    embeddings = HuggingFaceEmbeddings(model_name="/root/autodl-tmp/embedding_model")

    # 向量数据库持久化路径
    persist_directory = 'data_base/vector_db/chroma'

    # 加载数据库
    vectordb = Chroma(
        persist_directory=persist_directory,  # 允许我们将persist_directory目录保存到磁盘上
        embedding_function=embeddings
    )

    llm = QwenLM(model_path = "/root/autodl-tmp/qwen")

    template = """使用以下上下文来回答最后的问题。如果你不知道答案,就说你不知道,不要试图编造答
    案。尽量使答案简明扼要。总是在回答的最后说“谢谢你的提问!”。
    {context}
    问题: {question}
    有用的回答:"""

    QA_CHAIN_PROMPT = PromptTemplate(input_variables=["context","question"],
                                    template=template)

    # 运行 chain
    from langchain.chains import RetrievalQA

    qa_chain = RetrievalQA.from_chain_type(llm,
                                        retriever=vectordb.as_retriever(),
                                        return_source_documents=True,
                                        chain_type_kwargs={"prompt":QA_CHAIN_PROMPT})

return qa_chain接着我们定义一个类,该类负责加载并存储检索问答链,并响应 Web 界面里调用检索问答链进行回答的动作:
class Model_center():
    """
    存储问答 Chain 的对象
    """
    def __init__(self):
        self.chain = load_chain()

    def qa_chain_self_answer(self, question: str, chat_history: list = []):
        """
        调用不带历史记录的问答链进行回答
        """
        if question == None or len(question) < 1:
            return "", chat_history
        try:
            chat_history.append(
                (question, self.chain({"query": question})["result"]))
            return "", chat_history
        except Exception as e:
            return e, chat_history

    def clear_history(self):
self.chain.clear_history()然后我们只需按照 Gradio 的框架使用方法,实例化一个 Web 界面并将点击动作绑定到上述类的回答方法即可:
import gradio as gr
model_center = Model_center()

block = gr.Blocks()
with block as demo:
    with gr.Row(equal_height=True):
        with gr.Column(scale=15):
            gr.Markdown("""<h1><center>QwenLM</center></h1>
                <center>通义千问</center>
                """)
        # gr.Image(value=LOGO_PATH, scale=1, min_width=10,show_label=False, show_download_button=False)

    with gr.Row():
        with gr.Column(scale=4):
            chatbot = gr.Chatbot(height=450, show_copy_button=True)
            # 创建一个文本框组件,用于输入 prompt。
            msg = gr.Textbox(label="Prompt/问题")

            with gr.Row():
                # 创建提交按钮。
                db_wo_his_btn = gr.Button("Chat")
            with gr.Row():
                # 创建一个清除按钮,用于清除聊天机器人组件的内容。
                clear = gr.ClearButton(
                    components=[chatbot], value="Clear console")

        # 设置按钮的点击事件。当点击时,调用上面定义的 qa_chain_self_answer 函数,并传入用户的消息和聊天历史记录,然后更新文本框和聊天机器人组件。
        db_wo_his_btn.click(model_center.qa_chain_self_answer, inputs=[msg, chatbot], outputs=[msg, chatbot])

        # 点击后清空后端存储的聊天记录
        clear.click(model_center.clear_history)
    gr.Markdown("""提醒:<br>
    1. 初始化数据库时间可能较长,请耐心等待。
    2. 使用中如果出现异常,将会在文本输入框进行展示,请不要惊慌。 <br>
    """)
# threads to consume the request
gr.close_all()
# 启动新的 Gradio 应用,设置分享功能为 True,并使用环境变量 PORT1 指定服务器端口。
# demo.launch(share=True, server_port=int(os.environ['PORT1']))
# 直接启动
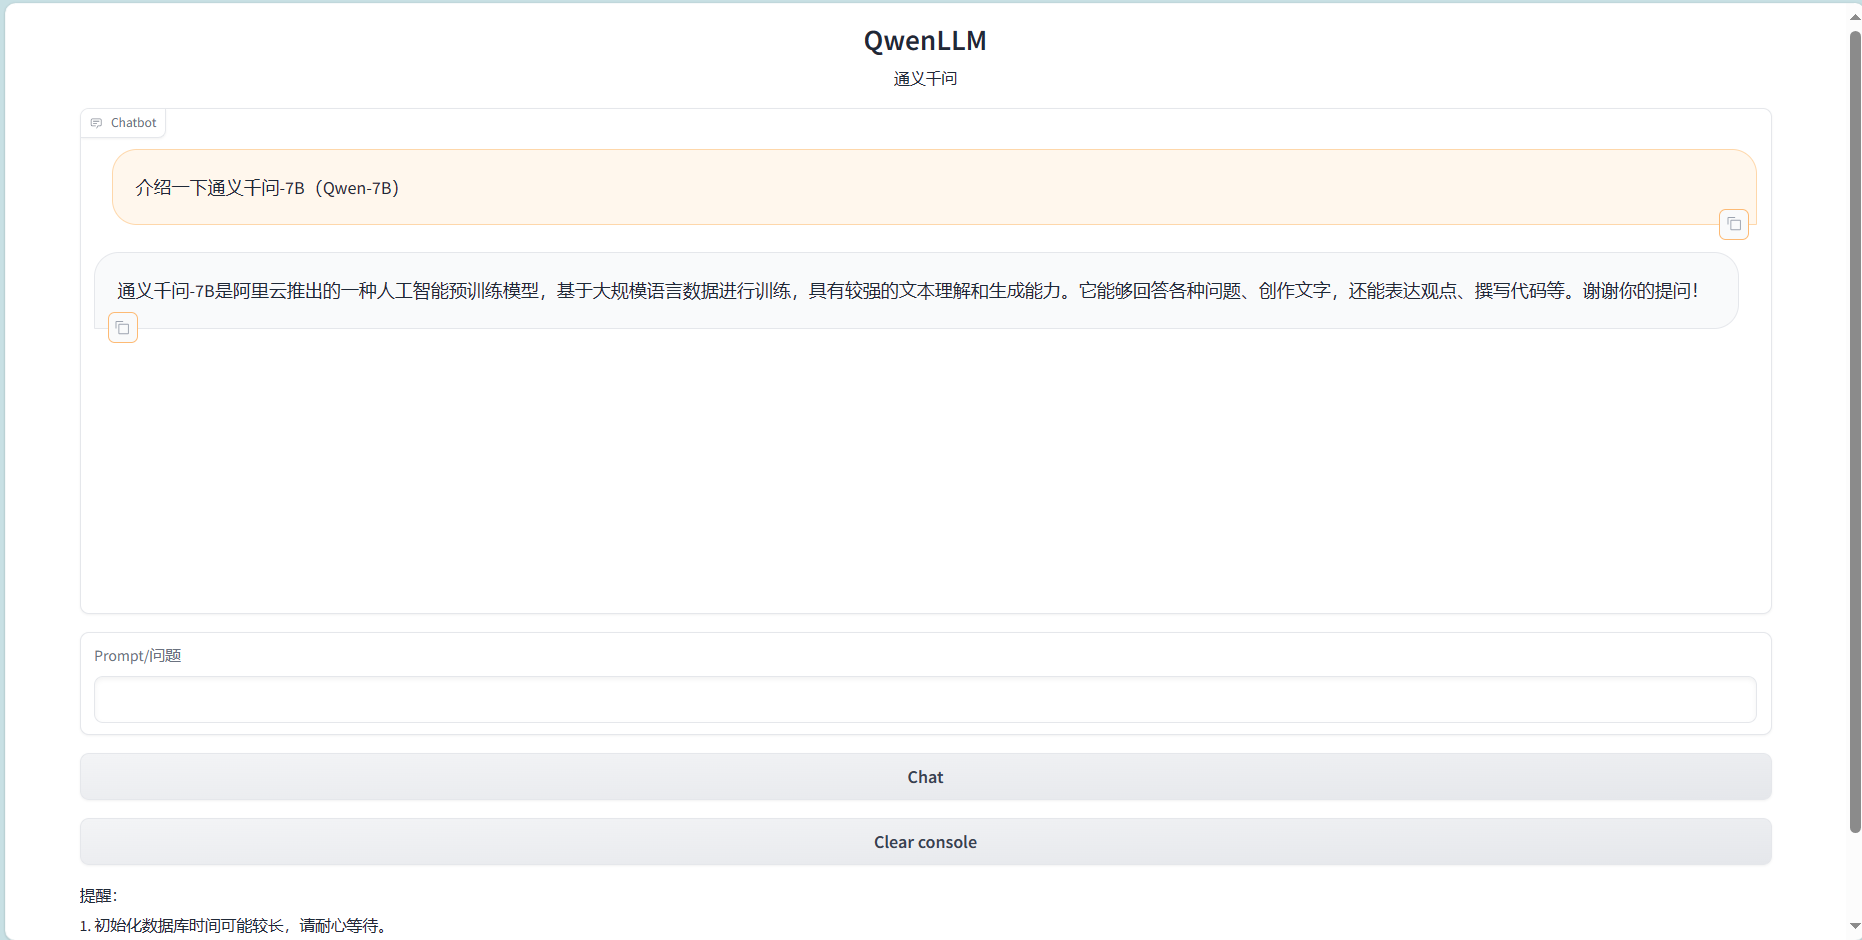
demo.launch()通过将上述代码封装为 run_gradio.py 脚本,直接通过在终端运行命令 python run_gradio.py ,即可在本地启动知识库助手的 Web Demo,默认会在 7860 端口运行,使用类似于部署的方式将服务器端口映射到本地端口即可访问:
08-Qwen-7B-Chat Lora 低精度微调
概述
本节我们简要介绍如何基于 transformers、peft 等框架,对 Qwen-7B-Chat 模型进行 Lora 的低精度微调。包括8bit与4bit QLoRA
环境配置
在完成基本环境配置和本地模型部署的情况下,你还需要安装一些第三方库,可以使用以下命令:
pip install transformers==4.35.2
pip install peft==0.4.0
pip install datasets==2.10.1
pip install accelerate==0.20.3
pip install tiktoken
pip install transformers_stream_generator
pip install bitsandbytes==0.41.1指令集构建
LLM 的微调一般指指令微调过程。所谓指令微调,是说我们使用的微调数据形如:
{
    "instrution":"回答以下用户问题,仅输出答案。",
    "input":"1+1等于几?",
    "output":"2"
}其中,instruction 是用户指令,告知模型其需要完成的任务;input 是用户输入,是完成用户指令所必须的输入内容;output 是模型应该给出的输出。
即我们的核心训练目标是让模型具有理解并遵循用户指令的能力。因此,在指令集构建时,我们应针对我们的目标任务,针对性构建任务指令集。例如,在本节我们使用由笔者合作开源的 Chat-甄嬛 项目作为示例,我们的目标是构建一个能够模拟甄嬛对话风格的个性化 LLM,因此我们构造的指令形如:##
{
    "instruction": "现在你要扮演皇帝身边的女人--甄嬛",
    "input":"你是谁?",
    "output":"家父是大理寺少卿甄远道。"
}我们所构造的全部指令数据集在根目录下。
数据格式化
Lora 训练的数据是需要经过格式化、编码之后再输入给模型进行训练的,如果是熟悉 Pytorch 模型训练流程的同学会知道,我们一般需要将输入文本编码为 input_ids,将输出文本编码为 labels,编码之后的结果都是多维的向量。我们首先定义一个预处理函数,这个函数用于对每一个样本,编码其输入、输出文本并返回一个编码后的字典:
def process_func(example):
    MAX_LENGTH = 384    # Llama分词器会将一个中文字切分为多个token,因此需要放开一些最大长度,保证数据的完整性
    input_ids, attention_mask, labels = [], [], []
    instruction = tokenizer("\n".join(["<|im_start|>system", "现在你要扮演皇帝身边的女人--甄嬛.<|im_end|>" + "\n<|im_start|>user\n" + example["instruction"] + example["input"] + "<|im_end|>\n"]).strip(), add_special_tokens=False)  # add_special_tokens 不在开头加 special_tokens
    response = tokenizer("<|im_start|>assistant\n" + example["output"] + "<|im_end|>\n", add_special_tokens=False)
    input_ids = instruction["input_ids"] + response["input_ids"] + [tokenizer.pad_token_id]
    attention_mask = instruction["attention_mask"] + response["attention_mask"] + [1]  # 因为eos token咱们也是要关注的所以 补充为1
    labels = [-100] * len(instruction["input_ids"]) + response["input_ids"] + [tokenizer.pad_token_id]  # Qwen的特殊构造就是这样的
    if len(input_ids) > MAX_LENGTH:  # 做一个截断
        input_ids = input_ids[:MAX_LENGTH]
        attention_mask = attention_mask[:MAX_LENGTH]
        labels = labels[:MAX_LENGTH]
    return {
        "input_ids": input_ids,
        "attention_mask": attention_mask,
        "labels": labels
}经过格式化的数据,也就是送入模型的每一条数据,都是一个字典,包含了 input_ids、attention_mask、labels 三个键值对,其中 input_ids 是输入文本的编码,attention_mask 是输入文本的 attention mask,labels 是输出文本的编码。decode之后应该是这样的:
<|im_start|>system
现在你要扮演皇帝身边的女人--甄嬛.<|im_end|>
<|im_start|>user
小姐,别的秀女都在求中选,唯有咱们小姐想被撂牌子,菩萨一定记得真真儿的——<|im_end|>
<|im_start|>assistant
嘘——都说许愿说破是不灵的。<|im_end|>
<|endoftext|>为什么会是这个形态呢?好问题!不同模型所对应的格式化输入都不一样,所以需要我们深度模型的训练源码来查看,因为按照原本模型指令微调的形式进行Lora微调效果应该是最好的,所以我们依然遵循原本模型的输入格式。OK,这里我给大家放一下源码的链接,各位如果感兴趣可以自行探索一下:
加载tokenizer和半精度模型
模型以半精度形式加载,如果你的显卡比较新的话,可以用torch.bfolat形式加载。对于自定义的模型一定要指定trust_remote_code参数为True。
tokenizer = AutoTokenizer.from_pretrained('/root/autodl-tmp/qwen/Qwen-7B-Chat', use_fast=False, trust_remote_code=True)
tokenizer.pad_token_id = tokenizer.eod_id # Qwen中eod_id和pad_token_id是一样的,但需要指定一下

# 模型以半精度形式加载,如果你的显卡比较新的话,可以用torch.bfolat形式加载
# 8bit:
model = AutoModelForCausalLM.from_pretrained('./qwen/Qwen-7B-Chat/', trust_remote_code=True, torch_dtype=torch.half, load_in_8bit=True, device_map="sequential")
# 4bit
model = AutoModelForCausalLM.from_pretrained('./qwen/Qwen-7B-Chat/',
                                                trust_remote_code=True,
                                                torch_dtype=torch.half,
                                                device_map="sequential",
                                                low_cpu_mem_usage=True,   # 是否使用cpu加速模型加载
                                                load_in_4bit=True,  # 是否在4位精度下加载模型。如果设置为True,则在4位精度下加载模型。
                                                bnb_4bit_compute_dtype=torch.half,  # 4位精度计算的数据类型。这里设置为torch.half,表示使用半精度浮点数。
                                                bnb_4bit_quant_type="nf4", # 4位精度量化的类型。这里设置为"nf4",表示使用nf4量化类型。
                                                bnb_4bit_use_double_quant=True  # 是否使用双精度量化。如果设置为True,则使用双精度量化。
)在这里我还想具体讲一下device_map参数的使用说明:
"auto"是自动查找最佳的分配策略。
"balanced"是在所有的GPU上平均切分。
"balanced_low_0" 会在除了第一个GPU上的其它GPU上平衡划分模型,并且在第一个GPU上占据较少资源。
"sequential"与上面的相反,对最后一个GPU占用较少资源。
可以用该命令查看模型各层分配情况:
model.hf_device_map检查是否定义成功:
for name, param in model.named_parameters():
print(name, param.shape, param.dtype)定义LoraConfig
LoraConfig这个类中可以设置很多参数,但主要的参数没多少,简单讲一讲,感兴趣的同学可以直接看源码。
task_type:模型类型
target_modules:需要训练的模型层的名字,主要就是attention部分的层,不同的模型对应的层的名字不同,可以传入数组,也可以字符串,也可以正则表达式。
r:lora的秩,具体可以看Lora原理
lora_alpha:Lora alaph,具体作用参见 Lora 原理
Lora的缩放是啥嘞?当然不是r(秩),这个缩放就是lora_alpha/r, 在这个LoraConfig中缩放就是4倍。
config = LoraConfig(
    task_type=TaskType.CAUSAL_LM,
    target_modules=["c_attn", "c_proj", "w1", "w2"],
    inference_mode=False, # 训练模式
    r=8, # Lora 秩
    lora_alpha=32, # Lora alaph,具体作用参见 Lora 原理
    lora_dropout=0.1# Dropout 比例
)自定义 TrainingArguments 参数
TrainingArguments这个类的源码也介绍了每个参数的具体作用,当然大家可以来自行探索,这里就简单说几个常用的。
output_dir:模型的输出路径
per_device_train_batch_size:顾名思义 batch_size
gradient_accumulation_steps: 梯度累加,如果你的显存比较小,那可以把 batch_size 设置小一点,梯度累加增大一些。
logging_steps:多少步,输出一次log
num_train_epochs:顾名思义 epoch
gradient_checkpointing:梯度检查,这个一旦开启,模型就必须执行model.enable_input_require_grads(),这个原理大家可以自行探索,这里就不细说了。
args = TrainingArguments(
    output_dir="./output/Qwen",
    per_device_train_batch_size=8,
    gradient_accumulation_steps=2,
    logging_steps=10,
    num_train_epochs=3,
    gradient_checkpointing=True,
    save_steps=100,
    learning_rate=1e-4,
    save_on_each_node=True
)使用 Trainer 训练
把 model 放进去,把上面设置的参数放进去,数据集放进去,OK!开始训练!
trainer = Trainer(
    model=model,
    args=args,
    train_dataset=tokenized_id,
    data_collator=DataCollatorForSeq2Seq(tokenizer=tokenizer, padding=True),
)
trainer.train()模型推理
可以用这种比较经典的方式推理。
model.eval()
ipt = tokenizer("<|im_start|>system\n现在你要扮演皇帝身边的女人--甄嬛.<|im_end|>\n<|im_start|>user\n{}<|im_end|>\n".format("你是谁?", "").strip() + "\nAssistant: ", return_tensors="pt").to(model.device)
tokenizer.decode(model.generate(**ipt, max_length=512, do_sample=True, eos_token_id=tokenizer.eos_token_id, temperature=0.1)[0], skip_special_tokens=True)也可以使用Qwen自定的方式进行推理
response, history = model.chat(tokenizer, "你是谁", history=[], system="现在你要扮演皇帝身边的女人--甄嬛.")09-Qwen-1_8B-chat CPU 部署
概述
Bigdl-llm 是一个在英特尔设备上运行 LLM(大语言模型)的加速库,通过 INT4/FP4/INT8/FP8 精度量化和架构针对性优化以实现大模型在 英特尔 CPU、GPU上的低资源占用与高速推理能力(适用于任何 PyTorch 模型)。
环境配置
在开始之前,我们需要准备好 bigdl-llm 以及之后部署的相关运行环境,我们推荐你在 python 3.9 的环境中进行之后的操作。
如果你发现下载速度过慢,可以尝试更换默认镜像源:pip config set global.index-url https://pypi.doubanio.com/simple
%pip install --pre --upgrade bigdl-llm[all]
%pip install gradio
%pip install hf-transfer
%pip install transformers_stream_generator einops
%pip install tiktoken模型下载
首先,我们通过 huggingface-cli 获取 qwen-1.8B 模型,耗时较长需要稍作等待;这里考虑到国内的下载限制增加了环境变量加速下载。
import os

# 设置环境变量
os.environ['HF_ENDPOINT'] = 'https://hf-mirror.com'
# 下载模型
os.system('huggingface-cli download --resume-download qwen/Qwen-1_8B-Chat --local-dir qwen18chat_src')保存量化模型
为了实现大语言模型的低资源消耗推理,我们首先需要把模型量化到 int4 精度,随后序列化保存在本地的相应文件夹方便重复加载推理;利用 save_low_bit api 我们可以很容易实现这一步。
from bigdl.llm.transformers import AutoModelForCausalLM
from transformers import  AutoTokenizer
import os
if __name__ == '__main__':
    model_path = os.path.join(os.getcwd(),"qwen18chat_src")
    model = AutoModelForCausalLM.from_pretrained(model_path, load_in_low_bit='sym_int4', trust_remote_code=True)
    tokenizer = AutoTokenizer.from_pretrained(model_path, trust_remote_code=True)
    model.save_low_bit('qwen18chat_int4')
tokenizer.save_pretrained('qwen18chat_int4')加载量化模型
保存 int4 模型文件后,我们便可以把他加载到内存进行进一步推理;如果你在本机上无法导出量化模型,也可以在更大内存的机器中保存模型再转移到小内存的端侧设备中运行,大部分常用家用PC即可满足 int4 模型实际运行的资源需求。
import torch
import time
from bigdl.llm.transformers import AutoModelForCausalLM
from transformers import AutoTokenizer

QWEN_PROMPT_FORMAT = "<human>{prompt} <bot>"
load_path = "qwen18chat_int4"
model = AutoModelForCausalLM.load_low_bit(load_path, trust_remote_code=True)
tokenizer = AutoTokenizer.from_pretrained(load_path, trust_remote_code=True)

input_str = "给我讲一个年轻人奋斗创业最终取得成功的故事"
with torch.inference_mode():
    prompt = QWEN_PROMPT_FORMAT.format(prompt=input_str)
    input_ids = tokenizer.encode(prompt, return_tensors="pt")
    st = time.time()
    output = model.generate(input_ids,
                            max_new_tokens=512)
    end = time.time()
    output_str = tokenizer.decode(output[0], skip_special_tokens=True)
    print(f'Inference time: {end-st} s')
    print('-'*20, 'Prompt', '-'*20)
    print(prompt)
    print('-'*20, 'Output', '-'*20)
print(output_str)gradio-demo 体验
为了得到更好的多轮对话体验,这里还提供了一个简单的 gradio demo界面方便调试使用,你可以修改内置 system 信息甚至微调模型让本地模型更接近你设想中的大模型需求。
import gradio as gr
import time
from bigdl.llm.transformers import AutoModelForCausalLM
from transformers import AutoTokenizer

QWEN_PROMPT_FORMAT = "<human>{prompt} <bot>"

load_path = "qwen18chat_int4"
model = AutoModelForCausalLM.load_low_bit(load_path, trust_remote_code=True)
tokenizer = AutoTokenizer.from_pretrained(load_path,trust_remote_code=True)

def add_text(history, text):
    _, history = model.chat(tokenizer, text, history=history)
    return history, gr.Textbox(value="", interactive=False)

def bot(history):
    response =  history[-1][1]
    history[-1][1] = ""
    for character in response:
        history[-1][1] += character
        time.sleep(0.05)
        yield history

with gr.Blocks() as demo:
    chatbot = gr.Chatbot(
        [],
        elem_id="chatbot",
        bubble_full_width=False,
    )

    with gr.Row():
        txt = gr.Textbox(
            scale=4,
            show_label=False,
            placeholder="Enter text and press enter",
            container=False,
        )

    txt_msg = txt.submit(add_text, [chatbot, txt], [chatbot, txt], queue=False).then(
        bot, chatbot, chatbot, api_name="bot_response"
    )
    txt_msg.then(lambda: gr.Textbox(interactive=True), None, [txt], queue=False)

demo.queue()
demo.launch()利用 Intel 的大语言模型推理框架,我们可以实现大模型在 Intel 端侧设备的高性能推理。 只需要 2G 内存占用就可以实现与本地大模型的流畅对话,一起来体验下吧。