MiniCPM-2B-chat FastApi 部署调用
MiniCPM-2B-chat 介绍
MiniCPM 是面壁智能与清华大学自然语言处理实验室共同开源的系列端侧大模型,主体语言模型 MiniCPM-2B 仅有 24亿(2.4B)的非词嵌入参数量。
经过 SFT 后,MiniCPM 在公开综合性评测集上,MiniCPM 与 Mistral-7B相近(中文、数学、代码能力更优),整体性能超越 Llama2-13B、MPT-30B、Falcon-40B 等模型。 经过 DPO 后,MiniCPM 在当前最接近用户体感的评测集 MTBench上,MiniCPM-2B 也超越了 Llama2-70B-Chat、Vicuna-33B、Mistral-7B-Instruct-v0.1、Zephyr-7B-alpha 等众多代表性开源大模型。 以 MiniCPM-2B 为基础构建端侧多模态大模型 MiniCPM-V,整体性能在同规模模型中实现最佳,超越基于 Phi-2 构建的现有多模态大模型,在部分评测集上达到与 9.6B Qwen-VL-Chat 相当甚至更好的性能。 经过 Int4 量化后,MiniCPM 可在手机上进行部署推理,流式输出速度略高于人类说话速度。MiniCPM-V 也直接跑通了多模态大模型在手机上的部署。 一张1080/2080可高效参数微调,一张3090/4090可全参数微调,一台机器可持续训练 MiniCPM,二次开发成本较低。
环境准备
在autodl平台中租一个单卡3090等24G显存的显卡机器,如下图所示镜像选择PyTorch-->2.1.0-->3.10(ubuntu22.04)-->12.1 接下来打开刚刚租用服务器的JupyterLab, 图像 并且打开其中的终端开始环境配置、模型下载和运行演示。
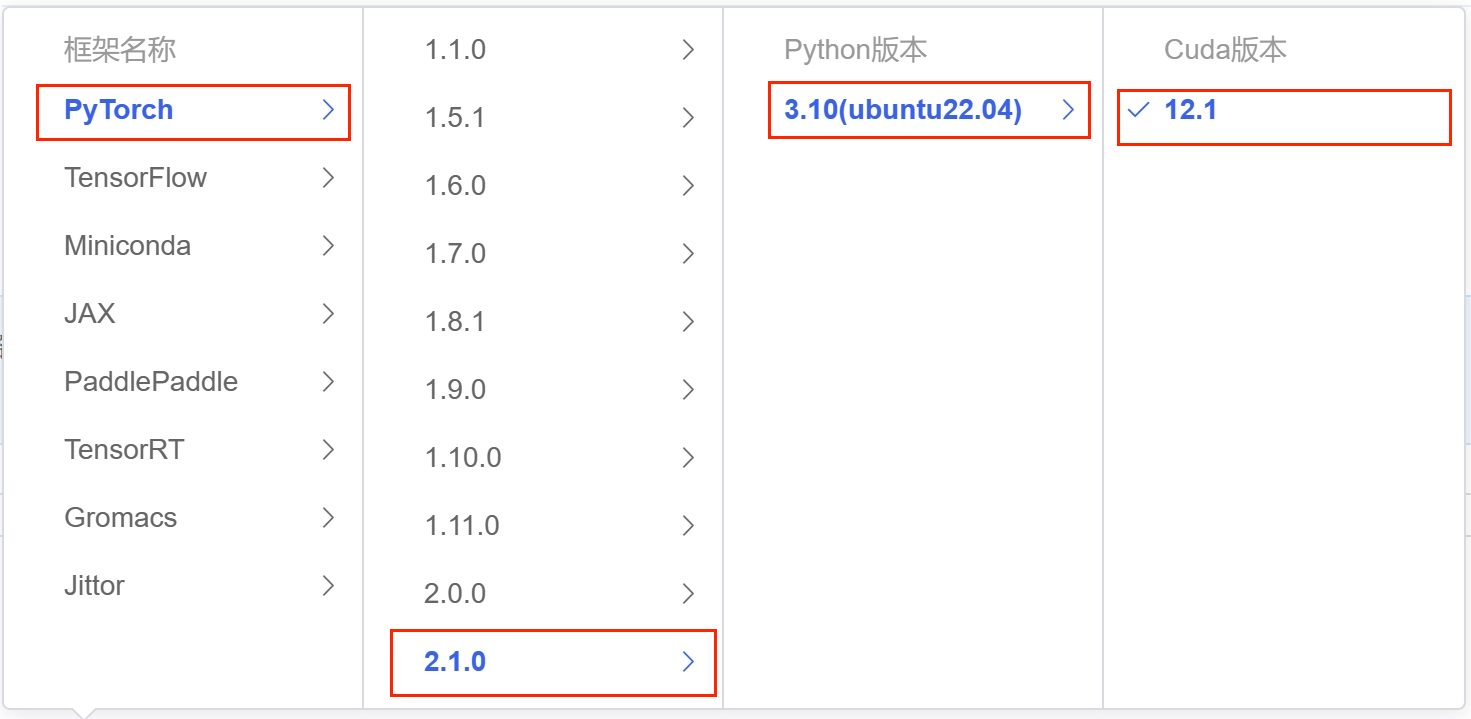
接下来打开刚刚租用服务器的JupyterLab,并且打开其中的终端开始环境配置、模型下载和运行demo。
pip换源和安装依赖包
# 升级pip
python -m pip install --upgrade pip
# 更换 pypi 源加速库的安装
pip config set global.index-url https://pypi.tuna.tsinghua.edu.cn/simple
pip install modelscope transformers sentencepiece accelerate fastapi uvicorn requests streamlit

MAX_JOBS=8 pip install flash-attn --no-build-isolation注意:flash-attn 安装会比较慢,大概需要十几分钟。
模型下载
使用 modelscope 中的snapshot_download函数下载模型,第一个参数为模型名称,参数cache_dir为模型的下载路径。
在 /root/autodl-tmp 路径下新建 download.py 文件并在其中输入以下内容,粘贴代码后记得保存文件,如下图所示。并运行 python /root/autodl-tmp/download.py执行下载,模型大小为 10 GB,下载模型大概需要 5~10 分钟
import torch
from modelscope import snapshot_download, AutoModel, AutoTokenizer
import os
model_dir = snapshot_download('OpenBMB/MiniCPM-2B-sft-fp32', cache_dir='/root/autodl-tmp', revision='master')代码准备
在/root/autodl-tmp路径下新建api.py文件并在其中输入以下内容,粘贴代码后记得保存文件。下面的代码有很详细的注释,大家如有不理解的地方,欢迎提出issue。
from fastapi import FastAPI, Request
from transformers import AutoTokenizer, AutoModelForCausalLM, GenerationConfig
import uvicorn
import json
import datetime
import torch

# 设置设备参数
DEVICE = "cuda"  # 使用CUDA
DEVICE_ID = "0"  # CUDA设备ID,如果未设置则为空
CUDA_DEVICE = f"{DEVICE}:{DEVICE_ID}" if DEVICE_ID else DEVICE  # 组合CUDA设备信息

# 清理GPU内存函数
def torch_gc():
    if torch.cuda.is_available():  # 检查是否可用CUDA
        with torch.cuda.device(CUDA_DEVICE):  # 指定CUDA设备
            torch.cuda.empty_cache()  # 清空CUDA缓存
            torch.cuda.ipc_collect()  # 收集CUDA内存碎片

# 创建FastAPI应用
app = FastAPI()

# 处理POST请求的端点
@app.post("/")
async def create_item(request: Request):
    global model, tokenizer  # 声明全局变量以便在函数内部使用模型和分词器
    json_post_raw = await request.json()  # 获取POST请求的JSON数据
    json_post = json.dumps(json_post_raw)  # 将JSON数据转换为字符串
    json_post_list = json.loads(json_post)  # 将字符串转换为Python对象
    prompt = json_post_list.get('prompt')  # 获取请求中的输入prompt

    # 构建输入,并设置生成参数,temperature、top_p值和repetition_penalty(重复惩罚因子)等,可执行修改
    responds, history = model.chat(tokenizer, prompt, temperature=0.5, top_p=0.8, repetition_penalty=1.02)
    now = datetime.datetime.now()  # 获取当前时间
    time = now.strftime("%Y-%m-%d %H:%M:%S")  # 格式化时间为字符串
    # 构建响应JSON
    answer = {
        "response": responds,
        "status": 200,
        "time": time
    }
    # 构建日志信息
    log = "[" + time + "] " + '", prompt:"' + prompt + '", response:"' + repr(responds) + '"'
    print(log)  # 打印日志
    torch_gc()  # 执行GPU内存清理
    return answer  # 返回响应

# 主函数入口
if __name__ == '__main__':
    torch.manual_seed(0)  # 设置随机种子以确保结果的可复现性
    # 定义模型路径
    path = '/root/autodl-tmp/OpenBMB/MiniCPM-2B-sft-fp32'
    # 从模型路径加载分词器,
    tokenizer = AutoTokenizer.from_pretrained(path)
    # 从模型路径加载模型,设置为使用bfloat16精度以优化性能,并将模型部署到支持CUDA的GPU上,trust_remote_code=True允许加载远程代码
    model = AutoModelForCausalLM.from_pretrained(path, torch_dtype=torch.bfloat16, device_map='cuda', trust_remote_code=True)

    model.eval()  # 设置模型为评估模式
    # 启动FastAPI应用
    # 用6006端口可以将autodl的端口映射到本地,从而在本地使用api
uvicorn.run(app, host='0.0.0.0', port=6006, workers=1) # 在指定端口和主机上启动应用Api 部署
在终端输入以下命令启动api服务
cd /root/autodl-tmp
python api.py加载完毕后出现如下信息说明成功。
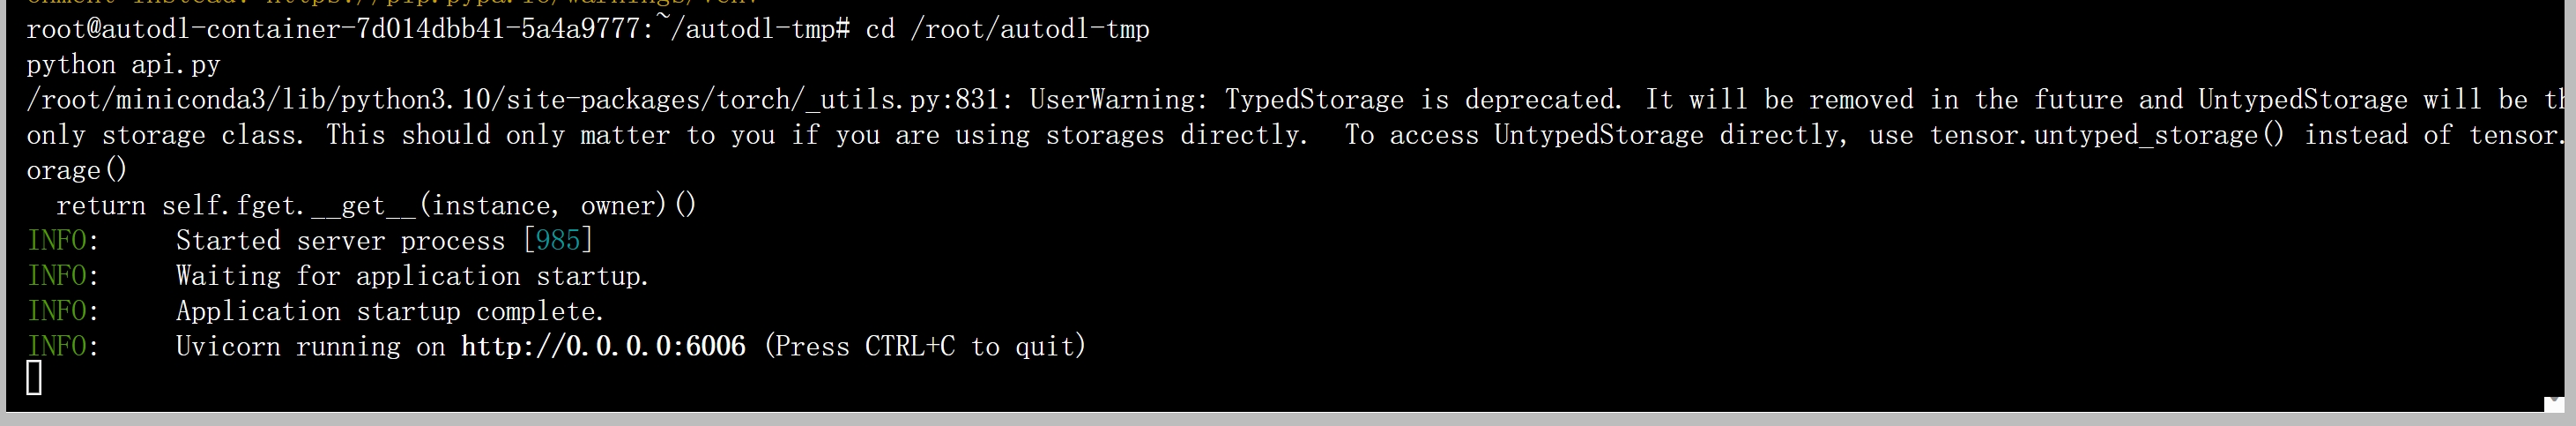
默认部署在 6006 端口,通过 POST 方法进行调用,可以使用curl调用,建议max_length为100,多了容易爆显存,少了容易回答输出不全,如下所示:
curl -X POST "http://127.0.0.1:6006" \
     -H 'Content-Type: application/json' \
     -d '{"prompt": "山东省最高的山是哪座山, 它比黄山高还是矮?差距多少?"}'
也可以使用python中的requests库进行调用,如下所示:
import requests
import json

def get_completion(prompt):
    headers = {'Content-Type': 'application/json'}
    data = {"prompt": prompt,"max_length":512}
    response = requests.post(url='http://127.0.0.1:6006', headers=headers, data=json.dumps(data))
    return response.json()['response']

if __name__ == '__main__':
print(get_completion("山东省最高的山是哪座山, 它比黄山高还是矮?差距多少?"))得到的返回值如下所示:
MiniCPM-2B-chat transformers 部署调用
MiniCPM-2B-chat 介绍
MiniCPM 是面壁智能与清华大学自然语言处理实验室共同开源的系列端侧大模型,主体语言模型 MiniCPM-2B 仅有 24亿(2.4B)的非词嵌入参数量。
经过 SFT 后,MiniCPM 在公开综合性评测集上,MiniCPM 与 Mistral-7B相近(中文、数学、代码能力更优),整体性能超越 Llama2-13B、MPT-30B、Falcon-40B 等模型。 经过 DPO 后,MiniCPM 在当前最接近用户体感的评测集 MTBench上,MiniCPM-2B 也超越了 Llama2-70B-Chat、Vicuna-33B、Mistral-7B-Instruct-v0.1、Zephyr-7B-alpha 等众多代表性开源大模型。 以 MiniCPM-2B 为基础构建端侧多模态大模型 MiniCPM-V,整体性能在同规模模型中实现最佳,超越基于 Phi-2 构建的现有多模态大模型,在部分评测集上达到与 9.6B Qwen-VL-Chat 相当甚至更好的性能。 经过 Int4 量化后,MiniCPM 可在手机上进行部署推理,流式输出速度略高于人类说话速度。MiniCPM-V 也直接跑通了多模态大模型在手机上的部署。 一张1080/2080可高效参数微调,一张3090/4090可全参数微调,一台机器可持续训练 MiniCPM,二次开发成本较低。
环境准备
在autodl平台中租一个单卡3090等24G显存的显卡机器,如下图所示镜像选择PyTorch-->2.1.0-->3.10(ubuntu22.04)-->12.1 接下来打开刚刚租用服务器的JupyterLab, 图像 并且打开其中的终端开始环境配置、模型下载和运行演示。
注意:这里要选择一个
cpu是intel的机器,amd的cpu有可能会导致deepspeed zero2 offload加载失败。
接下来打开刚刚租用服务器的JupyterLab,并且打开其中的终端开始环境配置、模型下载和运行demo。
pip换源和安装依赖包
# 升级pip
python -m pip install --upgrade pip
# 更换 pypi 源加速库的安装
pip config set global.index-url https://pypi.tuna.tsinghua.edu.cn/simple

pip install modelscope transformers sentencepiece accelerate langchain

MAX_JOBS=8 pip install flash-attn --no-build-isolation

pip install peft deepspeed注意:flash-attn 安装会比较慢,大概需要十几分钟。
模型下载
使用 modelscope 中的snapshot_download函数下载模型,第一个参数为模型名称,参数cache_dir为模型的下载路径。
在 /root/autodl-tmp 路径下新建 download.py 文件并在其中输入以下内容,粘贴代码后记得保存文件,如下图所示。并运行 python /root/autodl-tmp/download.py执行下载,模型大小为 10 GB,下载模型大概需要 5~10 分钟
import torch
from modelscope import snapshot_download, AutoModel, AutoTokenizer
import os
model_dir = snapshot_download('OpenBMB/MiniCPM-2B-sft-fp32', cache_dir='/root/autodl-tmp', revision='master')数据集构建
LLM 的微调一般指指令微调过程。所谓指令微调,是说我们使用的微调数据形如:
{
    "instrution":"回答以下用户问题,仅输出答案。",
    "input":"1+1等于几?",
    "output":"2"
}其中,instruction 是用户指令,告知模型其需要完成的任务;input 是用户输入,是完成用户指令所必须的输入内容;output 是模型应该给出的输出。
即我们的核心训练目标是让模型具有理解并遵循用户指令的能力。因此,在指令集构建时,我们应针对我们的目标任务,针对性构建任务指令集。例如,在本节我们使用由笔者合作开源的 Chat-甄嬛 项目作为示例,我们的目标是构建一个能够模拟甄嬛对话风格的个性化 LLM,因此我们构造的指令形如:
{
    "instruction": "现在你要扮演皇帝身边的女人--甄嬛",
    "input":"你是谁?",
    "output":"家父是大理寺少卿甄远道。"
}我们所构造的全部指令数据集在根目录的dataset下。
数据格式化
Lora 训练的数据是需要经过格式化、编码之后再输入给模型进行训练的,如果是熟悉 Pytorch 模型训练流程的同学会知道,我们一般需要将输入文本编码为 input_ids,将输出文本编码为 labels,编码之后的结果都是多维的向量。我们首先定义一个预处理函数,这个函数用于对每一个样本,编码其输入、输出文本并返回一个编码后的字典:
def process_func(example):
    MAX_LENGTH = 512    # Llama分词器会将一个中文字切分为多个token,因此需要放开一些最大长度,保证数据的完整性
    input_ids, attention_mask, labels = [], [], []
    instruction = tokenizer(f"<用户>{example['instruction']+example['input']}<AI>", add_special_tokens=False)  # add_special_tokens 不在开头加 special_tokens
    response = tokenizer(f"{example['output']}", add_special_tokens=False)
    input_ids = instruction["input_ids"] + response["input_ids"] + [tokenizer.pad_token_id]
    attention_mask = instruction["attention_mask"] + response["attention_mask"] + [1]  # 因为eos token咱们也是要关注的所以 补充为1
    labels = [-100] * len(instruction["input_ids"]) + response["input_ids"] + [tokenizer.pad_token_id]
    if len(input_ids) > MAX_LENGTH:  # 做一个截断
        input_ids = input_ids[:MAX_LENGTH]
        attention_mask = attention_mask[:MAX_LENGTH]
        labels = labels[:MAX_LENGTH]
    return {
        "input_ids": input_ids,
        "attention_mask": attention_mask,
        "labels": labels
}MiniCPM 所使用的 Prompt_Template为transformers默认的Prompt_Template,感兴趣的同学可以在transformers仓库查看源码构造哦~
加载模型
模型以半精度形式加载,如果你的显卡比较新的话,可以用torch.bfolat形式加载。对于自定义的模型一定要指定trust_remote_code参数为True。
tokenizer = AutoTokenizer.from_pretrained('./OpenBMB/miniCPM-bf32', use_fast=False, trust_remote_code=True)
tokenizer.padding_side = 'right'
tokenizer.pad_token_id = tokenizer.eos_token_id

model = AutoModelForCausalLM.from_pretrained('./OpenBMB/miniCPM-bf32', trust_remote_code=True, torch_dtype=torch.half, device_map="auto")定义LoraConfig
LoraConfig这个类中可以设置很多参数,但主要的参数没多少,简单讲一讲,感兴趣的同学可以直接看源码。
task_type:模型类型
target_modules:需要训练的模型层的名字,主要就是attention部分的层,不同的模型对应的层的名字不同,可以传入数组,也可以字符串,也可以正则表达式。
r:lora的秩,具体可以看Lora原理
lora_alpha:Lora alaph,具体作用参见 Lora 原理
config = LoraConfig(
    task_type=TaskType.CAUSAL_LM,
    target_modules=["q_proj", "k_proj", "v_proj", "o_proj"],
    inference_mode=False, # 训练模式
    r=8, # Lora 秩
    lora_alpha=32, # Lora alaph,具体作用参见 Lora 原理
    lora_dropout=0.1# Dropout 比例
)注意:如果要进行全量微调的话,可以在加载模型的时候选择不加载
LoraConfig。
自定义 TrainingArguments 参数
TrainingArguments这个类的源码也介绍了每个参数的具体作用,当然大家可以来自行探索,这里就简单说几个常用的。
output_dir:模型的输出路径
per_device_train_batch_size:顾名思义 batch_size
gradient_accumulation_steps: 梯度累加,如果你的显存比较小,那可以把 batch_size 设置小一点,梯度累加增大一些。
logging_steps:多少步,输出一次log
num_train_epochs:顾名思义 epoch
等等,还有很多参数可以调整,感兴趣的同学可以去看看transformers的源码哦,也欢迎各位同学来给本项目提交PR哦~
使用deepspeed训练
deepspeed 是一个分布式训练的工具,可以很方便的进行分布式训练,这里我们使用deepspeed进行训练。
如果你要进行lora训练,那请在train.py中将67行代码的注释取消掉,然后运行train.sh脚本即可。
lora 训练大概需要14G显存左右,因为没有开梯度检查所以显存占用会多一点。
# 创建模型并以半精度形式加载
model = AutoModelForCausalLM.from_pretrained(finetune_args.model_path, trust_remote_code=True, torch_dtype=torch.half, device_map={"": int(os.environ.get("LOCAL_RANK") or 0)})

model = get_peft_model(model, config)全量训练直接运行train.sh脚本即可。
全量训练,大概需要22G显存左右,因为开启了deepspeed zero2 的 cpu offload 功能,优化器参数会加载到cpu上进行计算,所以降低了显存。
MiniCPM-2B-chat WebDemo部署
MiniCPM-2B-chat 介绍
MiniCPM 是面壁智能与清华大学自然语言处理实验室共同开源的系列端侧大模型,主体语言模型 MiniCPM-2B 仅有 24亿(2.4B)的非词嵌入参数量。
经过 SFT 后,MiniCPM 在公开综合性评测集上,MiniCPM 与 Mistral-7B相近(中文、数学、代码能力更优),整体性能超越 Llama2-13B、MPT-30B、Falcon-40B 等模型。 经过 DPO 后,MiniCPM 在当前最接近用户体感的评测集 MTBench上,MiniCPM-2B 也超越了 Llama2-70B-Chat、Vicuna-33B、Mistral-7B-Instruct-v0.1、Zephyr-7B-alpha 等众多代表性开源大模型。 以 MiniCPM-2B 为基础构建端侧多模态大模型 MiniCPM-V,整体性能在同规模模型中实现最佳,超越基于 Phi-2 构建的现有多模态大模型,在部分评测集上达到与 9.6B Qwen-VL-Chat 相当甚至更好的性能。 经过 Int4 量化后,MiniCPM 可在手机上进行部署推理,流式输出速度略高于人类说话速度。MiniCPM-V 也直接跑通了多模态大模型在手机上的部署。 一张1080/2080可高效参数微调,一张3090/4090可全参数微调,一台机器可持续训练 MiniCPM,二次开发成本较低。
环境准备
在autodl平台中租一个单卡3090等24G显存的显卡机器,如下图所示镜像选择PyTorch-->2.1.0-->3.10(ubuntu22.04)-->12.1 接下来打开刚刚租用服务器的JupyterLab, 图像 并且打开其中的终端开始环境配置、模型下载和运行演示。
接下来打开刚刚租用服务器的JupyterLab,并且打开其中的终端开始环境配置、模型下载和运行demo。 首先clone代码,打开autodl平台自带的学术镜像加速。学术镜像加速详细使用请看:https://www.autodl.com/docs/network_turbo/
直接在终端执行以下代码即可完成学术镜像加速、代码clone及pip换源和安装依赖包
# 因为涉及到访问github因此最好打开autodl的学术镜像加速
source /etc/network_turbo
# 升级pip
python -m pip install --upgrade pip
# 更换 pypi 源加速库的安装
pip config set global.index-url https://pypi.tuna.tsinghua.edu.cn/simple
pip install modelscope transformers sentencepiece accelerate gradio

MAX_JOBS=8 pip install flash-attn --no-build-isolation

# clone项目代码
git clone https://github.com/OpenBMB/MiniCPM.git
# 切换到项目路径
cd MiniCPM注意:flash-attn 安装会比较慢,大概需要十几分钟。
模型下载
使用 modelscope 中的snapshot_download函数下载模型,第一个参数为模型名称,参数cache_dir为模型的下载路径。
在 /root/autodl-tmp 路径下新建 download.py 文件并在其中输入以下内容,粘贴代码后记得保存文件,如下图所示。并运行 python /root/autodl-tmp/download.py执行下载,模型大小为 10 GB,下载模型大概需要 5~10 分钟
import torch
from modelscope import snapshot_download, AutoModel, AutoTokenizer
import os
model_dir = snapshot_download('OpenBMB/MiniCPM-2B-sft-fp32', cache_dir='/root/autodl-tmp', revision='master')Web Demo运行
进入代码目录,运行demo启动脚本,在--model_name_or_path 参数后填写下载的模型目录
# 启动Demo,model_path参数填写刚刚下载的模型目录
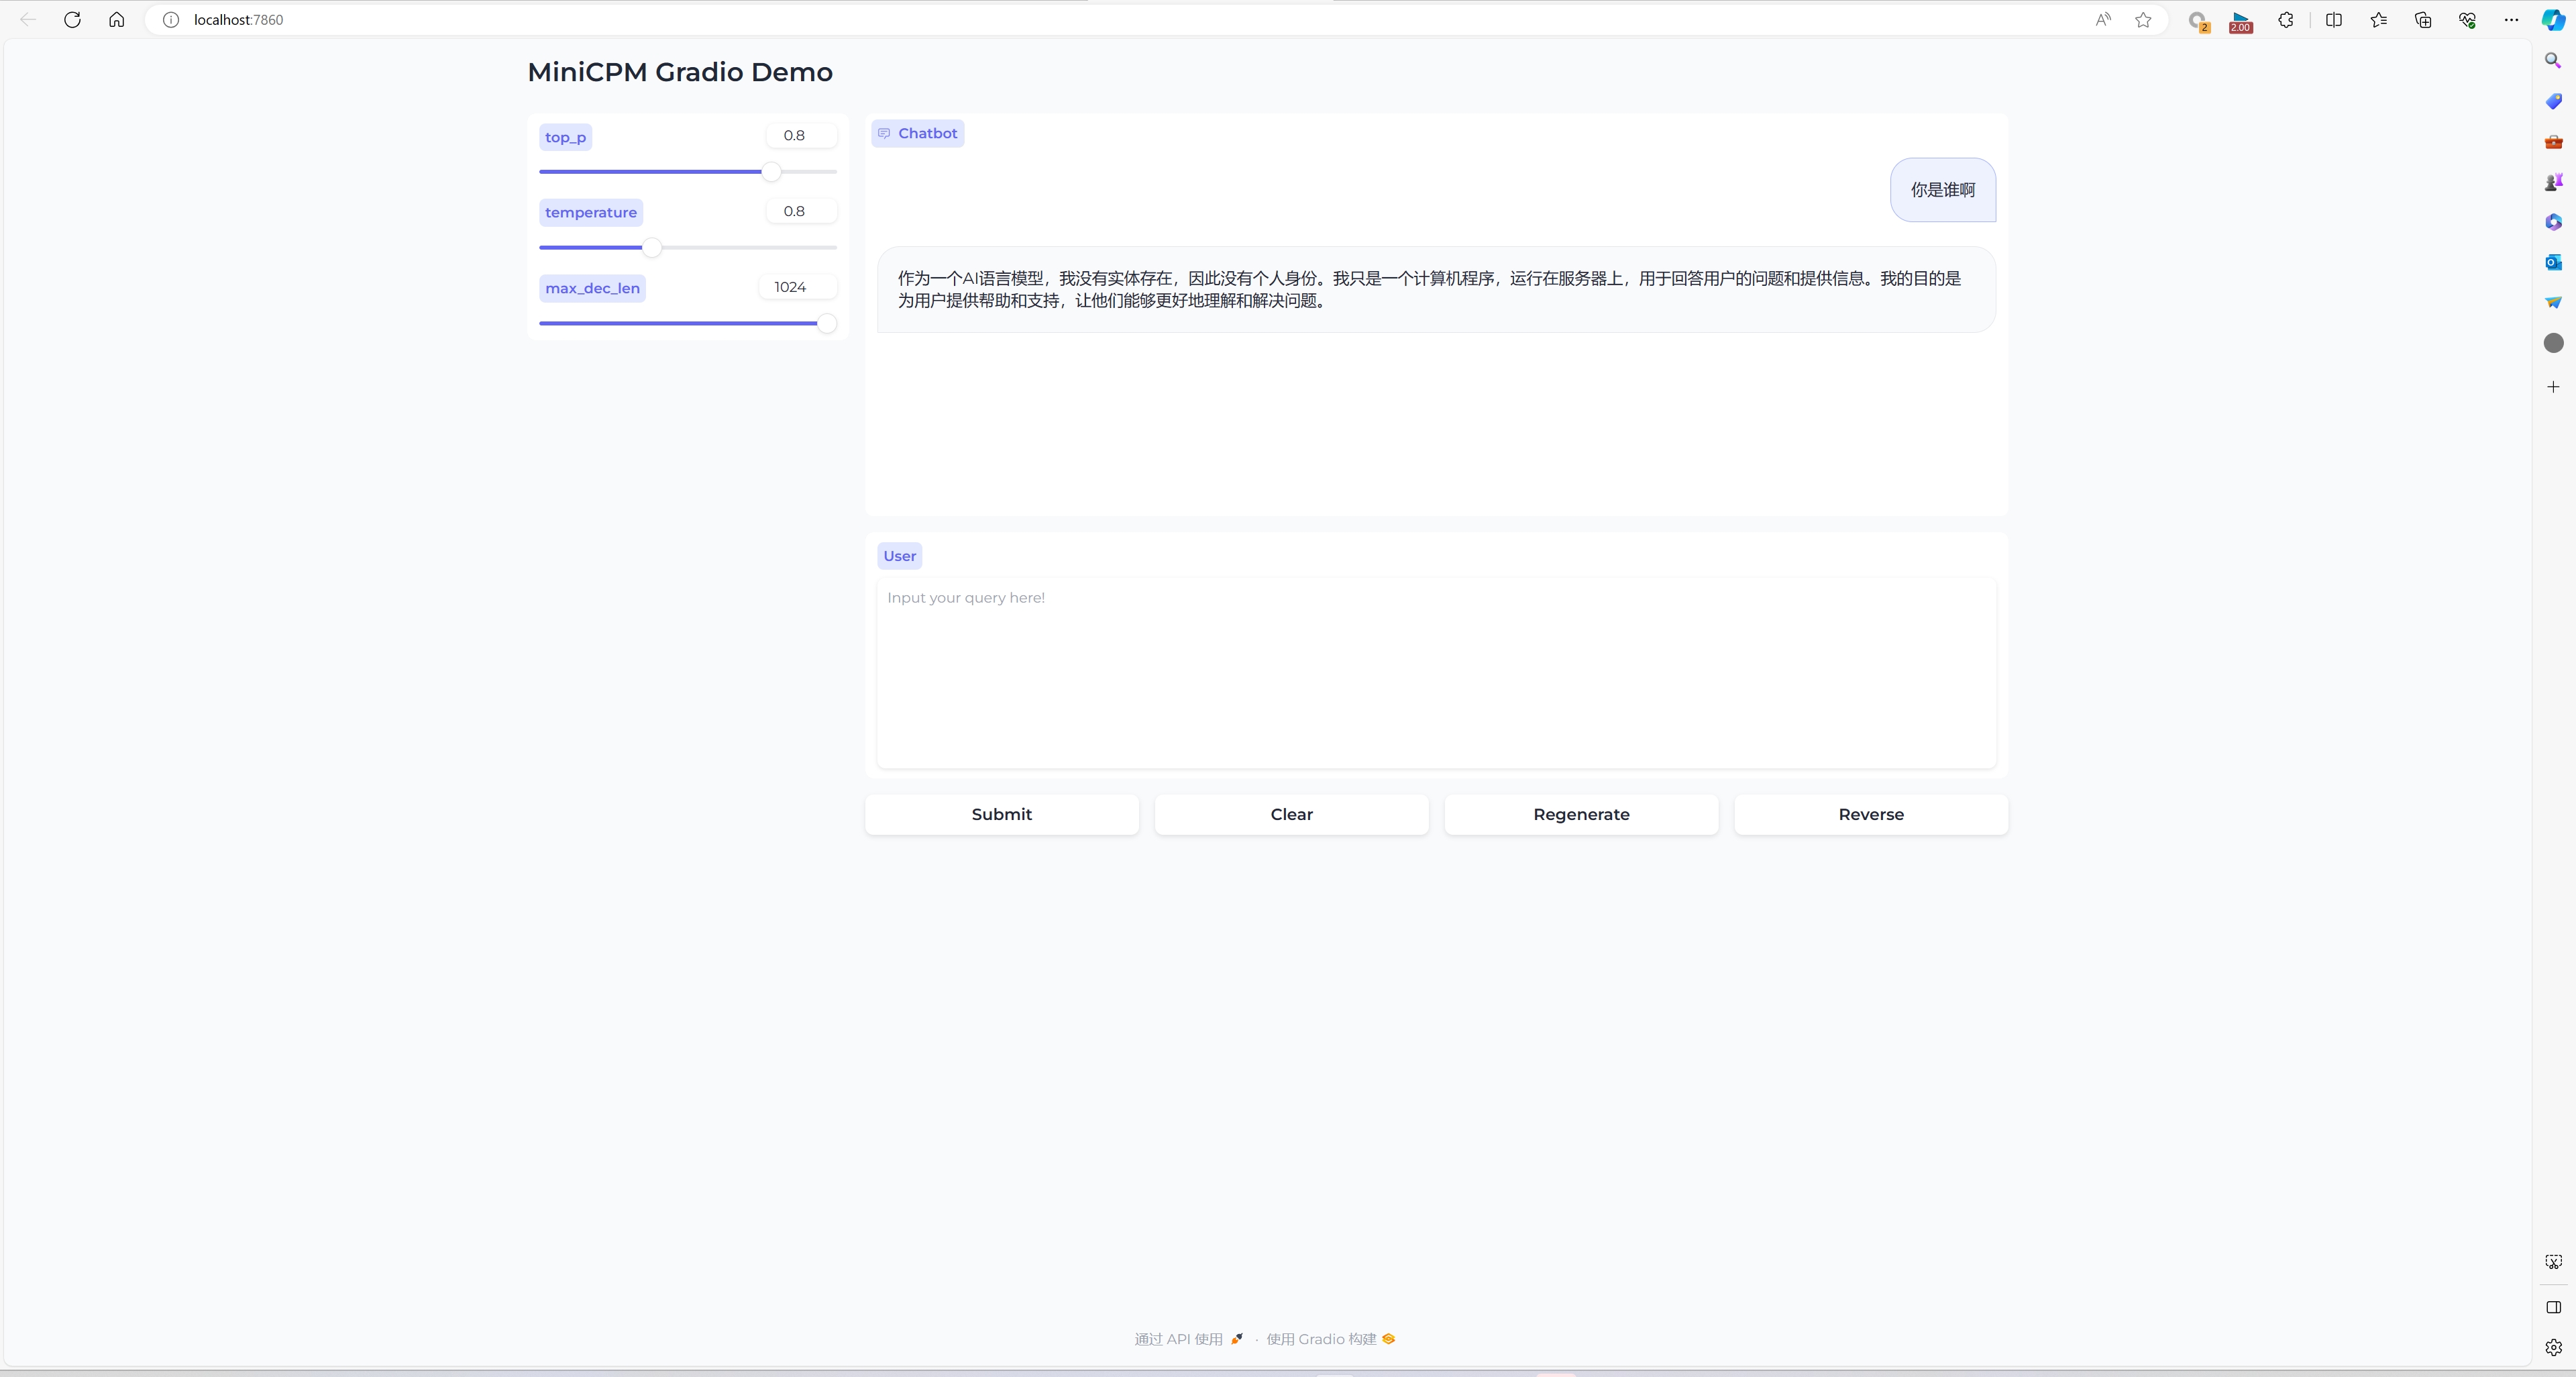
python demo/hf_based_demo.py --model_path "/root/autodl-tmp/OpenBMB/MiniCPM-2B-sft-fp32"启动成功后终端显示如下:

设置代理访问
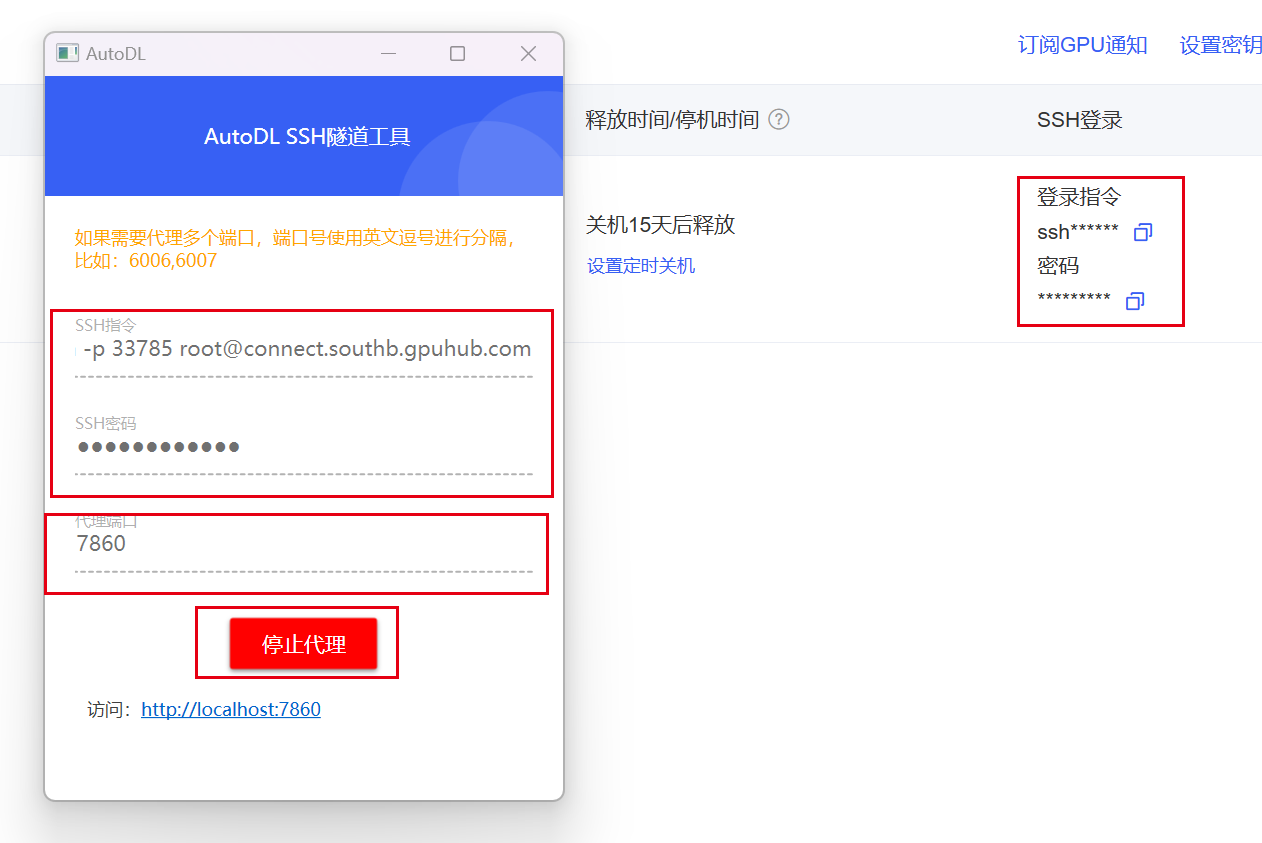
在Autodl容器实例页面找到自定义服务,下载对应的代理工具
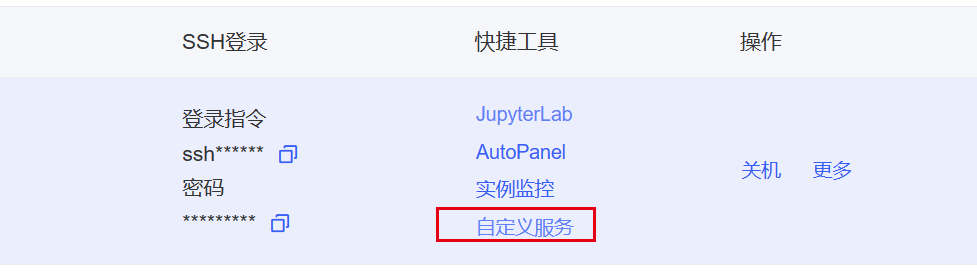
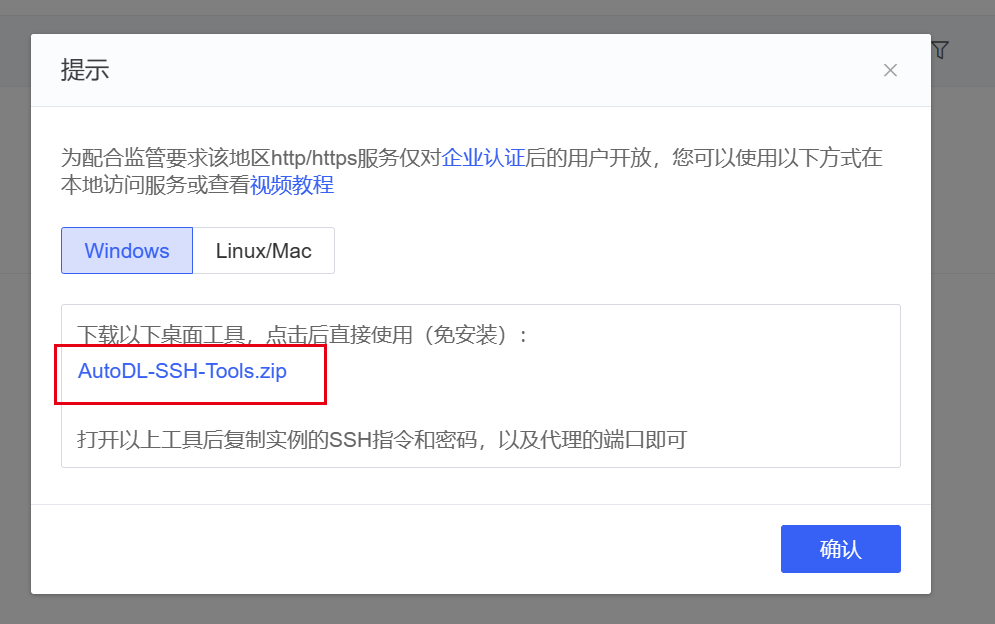
启动代理工具,拷贝对应的ssh指令及密码,设置代理端口为7860,点击开始代理
代理成功后点击下方链接即可访问web-demo
MiniCPM-2B-chat transformers 部署调用
MiniCPM-2B-chat 介绍
MiniCPM 是面壁智能与清华大学自然语言处理实验室共同开源的系列端侧大模型,主体语言模型 MiniCPM-2B 仅有 24亿(2.4B)的非词嵌入参数量。
经过 SFT 后,MiniCPM 在公开综合性评测集上,MiniCPM 与 Mistral-7B相近(中文、数学、代码能力更优),整体性能超越 Llama2-13B、MPT-30B、Falcon-40B 等模型。 经过 DPO 后,MiniCPM 在当前最接近用户体感的评测集 MTBench上,MiniCPM-2B 也超越了 Llama2-70B-Chat、Vicuna-33B、Mistral-7B-Instruct-v0.1、Zephyr-7B-alpha 等众多代表性开源大模型。 以 MiniCPM-2B 为基础构建端侧多模态大模型 MiniCPM-V,整体性能在同规模模型中实现最佳,超越基于 Phi-2 构建的现有多模态大模型,在部分评测集上达到与 9.6B Qwen-VL-Chat 相当甚至更好的性能。 经过 Int4 量化后,MiniCPM 可在手机上进行部署推理,流式输出速度略高于人类说话速度。MiniCPM-V 也直接跑通了多模态大模型在手机上的部署。 一张1080/2080可高效参数微调,一张3090/4090可全参数微调,一台机器可持续训练 MiniCPM,二次开发成本较低。
环境准备
在autodl平台中租一个单卡3090等24G显存的显卡机器,如下图所示镜像选择PyTorch-->2.1.0-->3.10(ubuntu22.04)-->12.1 接下来打开刚刚租用服务器的JupyterLab, 图像 并且打开其中的终端开始环境配置、模型下载和运行演示。
接下来打开刚刚租用服务器的JupyterLab,并且打开其中的终端开始环境配置、模型下载和运行demo。
pip换源和安装依赖包
# 升级pip
python -m pip install --upgrade pip
# 更换 pypi 源加速库的安装
pip config set global.index-url https://pypi.tuna.tsinghua.edu.cn/simple
pip install modelscope transformers sentencepiece accelerate langchain

MAX_JOBS=8 pip install flash-attn --no-build-isolation注意:flash-attn 安装会比较慢,大概需要十几分钟。
模型下载
使用 modelscope 中的snapshot_download函数下载模型,第一个参数为模型名称,参数cache_dir为模型的下载路径。
在 /root/autodl-tmp 路径下新建 download.py 文件并在其中输入以下内容,粘贴代码后记得保存文件,如下图所示。并运行 python /root/autodl-tmp/download.py执行下载,模型大小为 10 GB,下载模型大概需要 5~10 分钟
import torch
from modelscope import snapshot_download, AutoModel, AutoTokenizer
import os
model_dir = snapshot_download('OpenBMB/MiniCPM-2B-sft-fp32', cache_dir='/root/autodl-tmp', revision='master')代码准备
为便捷构建 LLM 应用,我们需要基于本地部署的 MiniCPM-2B-chat,自定义一个 LLM 类,将 MiniCPM-2B-chat 接入到 LangChain 框架中。完成自定义 LLM 类之后,可以以完全一致的方式调用 LangChain 的接口,而无需考虑底层模型调用的不一致。
基于本地部署的 MiniCPM-2B-chat 自定义 LLM 类并不复杂,我们只需从 LangChain.llms.base.LLM 类继承一个子类,并重写构造函数与 _call 函数即可:
from langchain.llms.base import LLM
from typing import Any, List, Optional
from langchain.callbacks.manager import CallbackManagerForLLMRun
from transformers import AutoTokenizer, AutoModelForCausalLM, GenerationConfig
import torch

class MiniCPM_LLM(LLM):
    # 基于本地 InternLM 自定义 LLM 类
    tokenizer : AutoTokenizer = None
    model: AutoModelForCausalLM = None

    def __init__(self, model_path :str):
        # model_path: InternLM 模型路径
        # 从本地初始化模型
        super().__init__()
        print("正在从本地加载模型...")
        self.tokenizer = AutoTokenizer.from_pretrained(model_path, trust_remote_code=True)
        self.model = AutoModelForCausalLM.from_pretrained(model_path, trust_remote_code=True,torch_dtype=torch.bfloat16,  device_map="auto")
        self.model = self.model.eval()
        print("完成本地模型的加载")

    def _call(self, prompt : str, stop: Optional[List[str]] = None,
                run_manager: Optional[CallbackManagerForLLMRun] = None,
                **kwargs: Any):
        # 通过模型获得输出
        responds, history = self.model.chat(self.tokenizer, prompt, temperature=0.5, top_p=0.8, repetition_penalty=1.02)
        return responds

    @property
    def _llm_type(self) -> str:
return "MiniCPM_LLM"调用
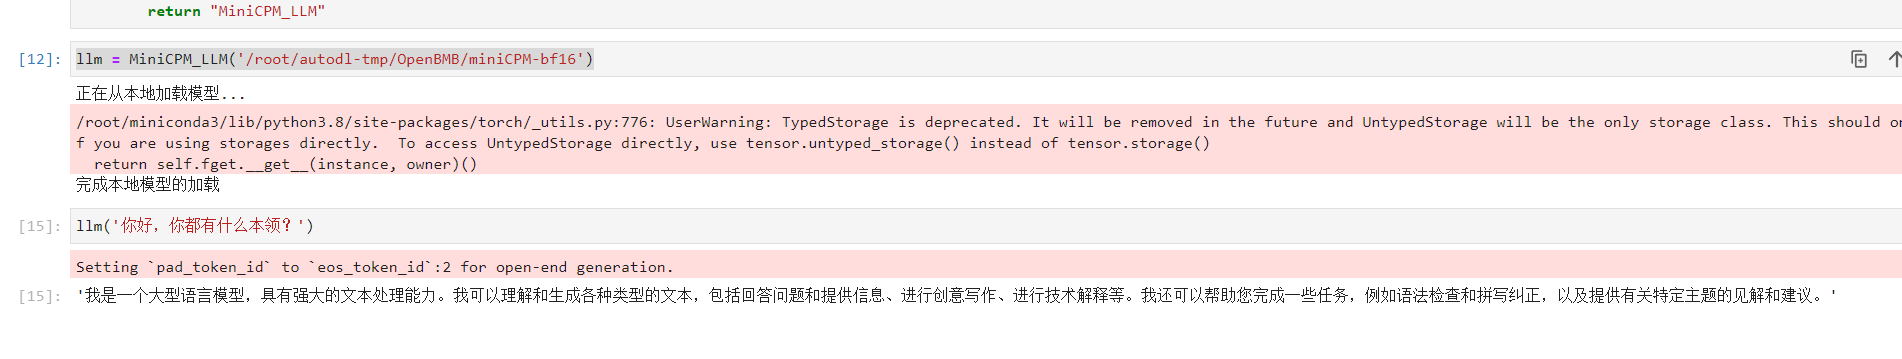
然后就可以像使用任何其他的langchain大模型功能一样使用了。
llm = MiniCPM_LLM('/root/autodl-tmp/OpenBMB/MiniCPM-2B-sft-fp32')

llm('你好')如下图所示:
MiniCPM-2B-chat transformers 部署调用
MiniCPM-2B-chat 介绍
MiniCPM 是面壁智能与清华大学自然语言处理实验室共同开源的系列端侧大模型,主体语言模型 MiniCPM-2B 仅有 24亿(2.4B)的非词嵌入参数量。
经过 SFT 后,MiniCPM 在公开综合性评测集上,MiniCPM 与 Mistral-7B相近(中文、数学、代码能力更优),整体性能超越 Llama2-13B、MPT-30B、Falcon-40B 等模型。 经过 DPO 后,MiniCPM 在当前最接近用户体感的评测集 MTBench上,MiniCPM-2B 也超越了 Llama2-70B-Chat、Vicuna-33B、Mistral-7B-Instruct-v0.1、Zephyr-7B-alpha 等众多代表性开源大模型。 以 MiniCPM-2B 为基础构建端侧多模态大模型 MiniCPM-V,整体性能在同规模模型中实现最佳,超越基于 Phi-2 构建的现有多模态大模型,在部分评测集上达到与 9.6B Qwen-VL-Chat 相当甚至更好的性能。 经过 Int4 量化后,MiniCPM 可在手机上进行部署推理,流式输出速度略高于人类说话速度。MiniCPM-V 也直接跑通了多模态大模型在手机上的部署。 一张1080/2080可高效参数微调,一张3090/4090可全参数微调,一台机器可持续训练 MiniCPM,二次开发成本较低。
环境准备
在autodl平台中租一个单卡3090等24G显存的显卡机器,如下图所示镜像选择PyTorch-->2.1.0-->3.10(ubuntu22.04)-->12.1 接下来打开刚刚租用服务器的JupyterLab, 图像 并且打开其中的终端开始环境配置、模型下载和运行演示。
接下来打开刚刚租用服务器的JupyterLab,并且打开其中的终端开始环境配置、模型下载和运行demo。
pip换源和安装依赖包
# 升级pip
python -m pip install --upgrade pip
# 更换 pypi 源加速库的安装
pip config set global.index-url https://pypi.tuna.tsinghua.edu.cn/simple
pip install modelscope transformers sentencepiece accelerate

MAX_JOBS=8 pip install flash-attn --no-build-isolation注意:flash-attn 安装会比较慢,大概需要十几分钟。
模型下载
使用 modelscope 中的snapshot_download函数下载模型,第一个参数为模型名称,参数cache_dir为模型的下载路径。
在 /root/autodl-tmp 路径下新建 download.py 文件并在其中输入以下内容,粘贴代码后记得保存文件,如下图所示。并运行 python /root/autodl-tmp/download.py执行下载,模型大小为 10 GB,下载模型大概需要 5~10 分钟
import torch
from modelscope import snapshot_download, AutoModel, AutoTokenizer
import os
model_dir = snapshot_download('OpenBMB/MiniCPM-2B-sft-fp32', cache_dir='/root/autodl-tmp', revision='master')代码准备
在/root/autodl-tmp路径下新建trains.py文件并在其中输入以下内容
from transformers import AutoModelForCausalLM, AutoTokenizer  # 从transformers库导入所需的类
import torch  # 导入torch库,用于深度学习相关操作

torch.manual_seed(0)  # 设置随机种子以确保结果的可复现性

# 定义模型路径
path = '/root/autodl-tmp/OpenBMB/MiniCPM-2B-sft-fp32'

# 从模型路径加载分词器,
tokenizer = AutoTokenizer.from_pretrained(path)

# 从模型路径加载模型,设置为使用bfloat16精度以优化性能,并将模型部署到支持CUDA的GPU上,trust_remote_code=True允许加载远程代码
model = AutoModelForCausalLM.from_pretrained(path, torch_dtype=torch.bfloat16, device_map='cuda', trust_remote_code=True)

# 使用模型进行聊天,提出问题并设置生成参数,如temperature、top_p值和repetition_penalty(重复惩罚因子)
responds, history = model.chat(tokenizer, "山东省最高的山是哪座山, 它比黄山高还是矮?差距多少?", temperature=0.5, top_p=0.8, repetition_penalty=1.02)

# 显示生成的回答
print(responds)部署
在终端输入以下命令运行trains.py,即实现MiniCPM-2B-chat的Transformers部署调用
cd /root/autodl-tmp
python trains.py观察命令行中,等待模型加载完成产生对话,如下图所示
