Llama3_1-8B-Instruct FastApi 部署调用
环境准备
本文基础环境如下:
----------------
ubuntu 22.04
python 3.12
cuda 12.1
pytorch 2.3.0
----------------本文默认学习者已安装好以上 Pytorch(cuda) 环境,如未安装请自行安装。
首先 pip 换源加速下载并安装依赖包
# 升级pip
python -m pip install --upgrade pip
# 更换 pypi 源加速库的安装
pip config set global.index-url https://pypi.tuna.tsinghua.edu.cn/simple

pip install fastapi==0.111.1
pip install uvicorn==0.30.3
pip install modelscope==1.16.1
pip install transformers==4.43.2
pip install accelerate==0.32.1考虑到部分同学配置环境可能会遇到一些问题,我们在AutoDL平台准备了LLaMA3-1的环境镜像,点击下方链接并直接创建Autodl示例即可。 https://www.codewithgpu.com/i/datawhalechina/self-llm/self-llm-llama3.1
模型下载
使用 modelscope 中的 snapshot_download 函数下载模型,第一个参数为模型名称,参数 cache_dir 为模型的下载路径。
新建 model_download.py 文件并在其中输入以下内容,粘贴代码后请及时保存文件,如下图所示。并运行 python model_download.py 执行下载,模型大小为 15GB,下载模型大概需要 5 分钟。
import torch
from modelscope import snapshot_download, AutoModel, AutoTokenizer
import os
model_dir = snapshot_download('LLM-Research/Meta-Llama-3.1-8B-Instruct', cache_dir='/root/autodl-tmp', revision='master')注意:记得修改
cache_dir为你的模型下载路径哦~
代码准备
新建 api.py 文件并在其中输入以下内容,粘贴代码后请及时保存文件。以下代码有很详细的注释,大家如有不理解的地方,欢迎提出 issue 。
from fastapi import FastAPI, Request
from transformers import AutoTokenizer, AutoModelForCausalLM
import uvicorn
import json
import datetime
import torch

# 设置设备参数
DEVICE = "cuda"  # 使用CUDA
DEVICE_ID = "0"  # CUDA设备ID,如果未设置则为空
CUDA_DEVICE = f"{DEVICE}:{DEVICE_ID}" if DEVICE_ID else DEVICE  # 组合CUDA设备信息

# 清理GPU内存函数
def torch_gc():
    if torch.cuda.is_available():  # 检查是否可用CUDA
        with torch.cuda.device(CUDA_DEVICE):  # 指定CUDA设备
            torch.cuda.empty_cache()  # 清空CUDA缓存
            torch.cuda.ipc_collect()  # 收集CUDA内存碎片

# 创建FastAPI应用
app = FastAPI()

# 处理POST请求的端点
@app.post("/")
async def create_item(request: Request):
    global model, tokenizer  # 声明全局变量以便在函数内部使用模型和分词器
    json_post_raw = await request.json()  # 获取POST请求的JSON数据
    json_post = json.dumps(json_post_raw)  # 将JSON数据转换为字符串
    json_post_list = json.loads(json_post)  # 将字符串转换为Python对象
    prompt = json_post_list.get('prompt')  # 获取请求中的提示

    messages = [
            {"role": "system", "content": "You are a helpful assistant."},
            {"role": "user", "content": prompt}
    ]

    # 调用模型进行对话生成
    input_ids = tokenizer.apply_chat_template(messages,tokenize=False,add_generation_prompt=True)
    model_inputs = tokenizer([input_ids], return_tensors="pt").to('cuda')
    generated_ids = model.generate(model_inputs.input_ids,max_new_tokens=512)
    generated_ids = [
        output_ids[len(input_ids):] for input_ids, output_ids in zip(model_inputs.input_ids, generated_ids)
    ]
    response = tokenizer.batch_decode(generated_ids, skip_special_tokens=True)[0]
    now = datetime.datetime.now()  # 获取当前时间
    time = now.strftime("%Y-%m-%d %H:%M:%S")  # 格式化时间为字符串
    # 构建响应JSON
    answer = {
        "response": response,
        "status": 200,
        "time": time
    }
    # 构建日志信息
    log = "[" + time + "] " + '", prompt:"' + prompt + '", response:"' + repr(response) + '"'
    print(log)  # 打印日志
    torch_gc()  # 执行GPU内存清理
    return answer  # 返回响应

# 主函数入口
if __name__ == '__main__':
    # 加载预训练的分词器和模型
    model_name_or_path = '/root/autodl-tmp/LLM-Research/Meta-Llama-3___1-8B-Instruct'
    tokenizer = AutoTokenizer.from_pretrained(model_name_or_path, use_fast=False)
    model = AutoModelForCausalLM.from_pretrained(model_name_or_path, device_map="auto", torch_dtype=torch.bfloat16)

    # 启动FastAPI应用
    # 用6006端口可以将autodl的端口映射到本地,从而在本地使用api
uvicorn.run(app, host='0.0.0.0', port=6006, workers=1) # 在指定端口和主机上启动应用注意:记得修改
model_name_or_path为你的模型下载路径哦~
Api 部署
在终端输入以下命令启动api服务:
python api.py加载完毕后出现如下信息说明成功。
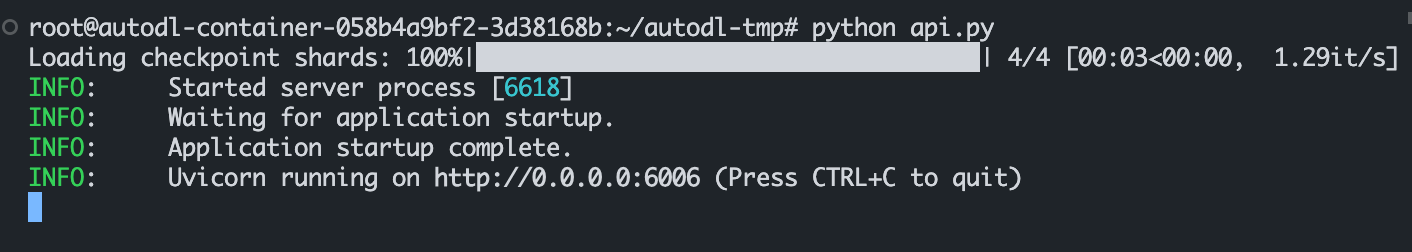
默认部署在 6006 端口,通过 POST 方法进行调用,可以使用 curl 调用,如下所示:
curl -X POST "http://127.0.0.1:6006" \
     -H 'Content-Type: application/json' \
     -d '{"prompt": "你好"}'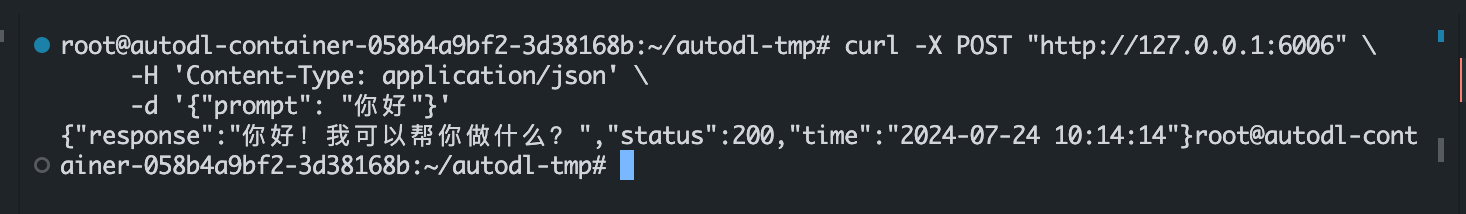
也可以使用 python 中的 requests 库进行调用,如下所示:
import requests
import json

def get_completion(prompt):
    headers = {'Content-Type': 'application/json'}
    data = {"prompt": prompt}
    response = requests.post(url='http://127.0.0.1:6006', headers=headers, data=json.dumps(data))
    return response.json()['response']

if __name__ == '__main__':
print(get_completion('你好'))得到的返回值如下所示:
{"response":"你好!很高兴能为你提供帮助。有什么问题我可以回答或者协助你完成吗?","status":200,"time":"2024-06-07 12:24:31"}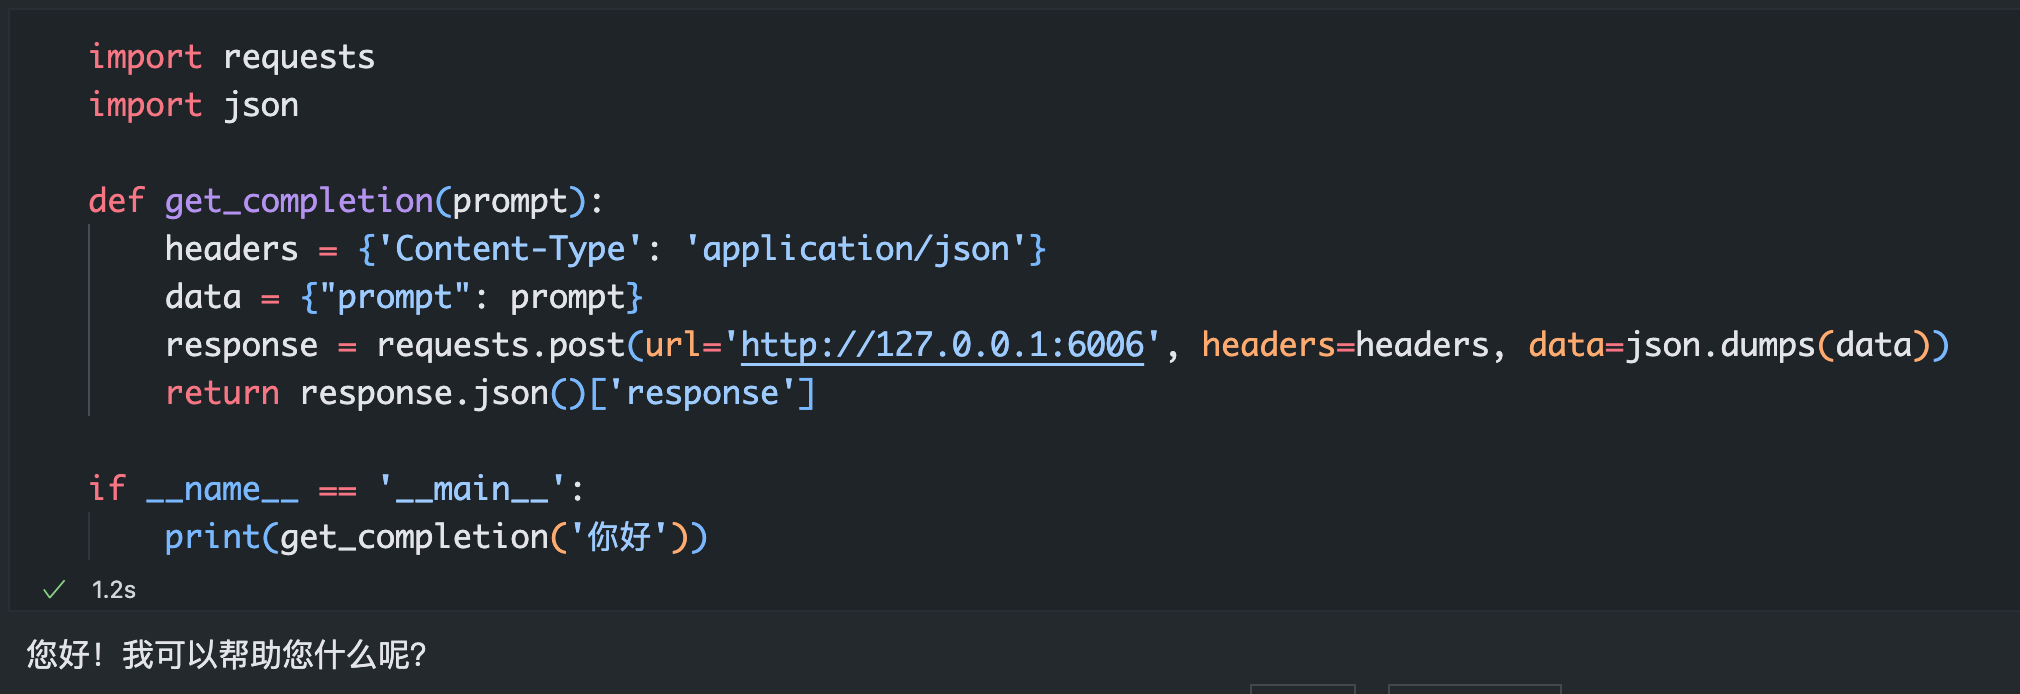
LLaMA3_1-8B-Instruct langchain 接入
环境准备
本文基础环境如下:
----------------
ubuntu 22.04
python 3.12
cuda 12.1
pytorch 2.3.0
----------------本文默认学习者已安装好以上 Pytorch(cuda) 环境,如未安装请自行安装。
pip 换源加速下载并安装依赖包
# 升级pip
python -m pip install --upgrade pip
# 更换 pypi 源加速库的安装
pip config set global.index-url https://pypi.tuna.tsinghua.edu.cn/simple

pip install modelscope==1.16.1
pip install langchain==0.2.3
pip install transformers==4.43.2
pip install accelerate==0.32.1考虑到部分同学配置环境可能会遇到一些问题,我们在AutoDL平台准备了LLaMA3-1的环境镜像,点击下方链接并直接创建Autodl示例即可。 https://www.codewithgpu.com/i/datawhalechina/self-llm/self-llm-llama3.1
模型下载
使用 modelscope 中的 snapshot_download 函数下载模型,第一个参数为模型名称,参数 cache_dir 为模型的下载路径。
在新建 model_download.py 文件并在其中输入以下内容,粘贴代码后记得保存文件,如下图所示。并运行 python model_download.py 执行下载,模型大小为 16 GB,下载模型大概需要 12 分钟。
import torch
from modelscope import snapshot_download, AutoModel, AutoTokenizer
import os

model_dir = snapshot_download('LLM-Research/Meta-Llama-3.1-8B-Instruct', cache_dir='/root/autodl-tmp', revision='master')注意:记得修改
cache_dir为你的模型下载路径哦~
代码准备
为便捷构建 LLM 应用,我们需要基于本地部署的 LLaMA3_1_LLM,自定义一个 LLM 类,将 LLaMA3.1 接入到 LangChain 框架中。完成自定义 LLM 类之后,可以以完全一致的方式调用 LangChain 的接口,而无需考虑底层模型调用的不一致。
基于本地部署的 LLaMA3.1 自定义 LLM 类并不复杂,我们只需从 LangChain.llms.base.LLM 类继承一个子类,并重写构造函数与 _call 函数即可:
在当前路径新建一个 LLM.py 文件,并输入以下内容,粘贴代码后记得保存文件。
from langchain.llms.base import LLM
from typing import Any, List, Optional
from langchain.callbacks.manager import CallbackManagerForLLMRun
from transformers import AutoTokenizer, AutoModelForCausalLM
import torch

class LLaMA3_1_LLM(LLM):
    # 基于本地 llama3.1 自定义 LLM 类
    tokenizer: AutoTokenizer = None
    model: AutoModelForCausalLM = None

    def __init__(self, mode_name_or_path :str):

        super().__init__()
        print("正在从本地加载模型...")
        self.tokenizer = AutoTokenizer.from_pretrained(mode_name_or_path, use_fast=False)
        self.model = AutoModelForCausalLM.from_pretrained(mode_name_or_path, torch_dtype=torch.bfloat16, device_map="auto")
        self.tokenizer.pad_token = self.tokenizer.eos_token
        print("完成本地模型的加载")


    def _call(self, prompt : str, stop: Optional[List[str]] = None,
                run_manager: Optional[CallbackManagerForLLMRun] = None,
                **kwargs: Any):
        messages = [
            {"role": "system", "content": "You are a helpful assistant."},
            {"role": "user", "content": prompt}
        ]

        input_ids = self.tokenizer.apply_chat_template(messages,tokenize=False,add_generation_prompt=True)
        model_inputs = self.tokenizer([input_ids], return_tensors="pt").to(self.model.device)
        generated_ids = self.model.generate(model_inputs.input_ids,max_new_tokens=512)
        generated_ids = [
            output_ids[len(input_ids):] for input_ids, output_ids in zip(model_inputs.input_ids, generated_ids)
        ]
        response = self.tokenizer.batch_decode(generated_ids, skip_special_tokens=True)[0]
        return response

    @property
    def _llm_type(self) -> str:
return "LLaMA3_1_LLM"在上述类定义中,我们分别重写了构造函数和 _call 函数:对于构造函数,我们在对象实例化的一开始加载本地部署的 LLaMA3.1 模型,从而避免每一次调用都需要重新加载模型带来的时间过长;_call 函数是 LLM 类的核心函数,LangChain 会调用该函数来调用 LLM,在该函数中,我们调用已实例化模型的 generate 方法,从而实现对模型的调用并返回调用结果。
在整体项目中,我们将上述代码封装为 LLM.py,后续将直接从该文件中引入自定义的 LLM 类。
调用
然后就可以像使用任何其他的langchain大模型功能一样使用了。
注意:记得修改模型路径为你的路径哦~
from LLM import LLaMA3_1_LLM
llm = LLaMA3_1_LLM(mode_name_or_path = "/root/autodl-tmp/LLM-Research/Meta-Llama-3___1-8B-Instruct")

print(llm("你好呀"))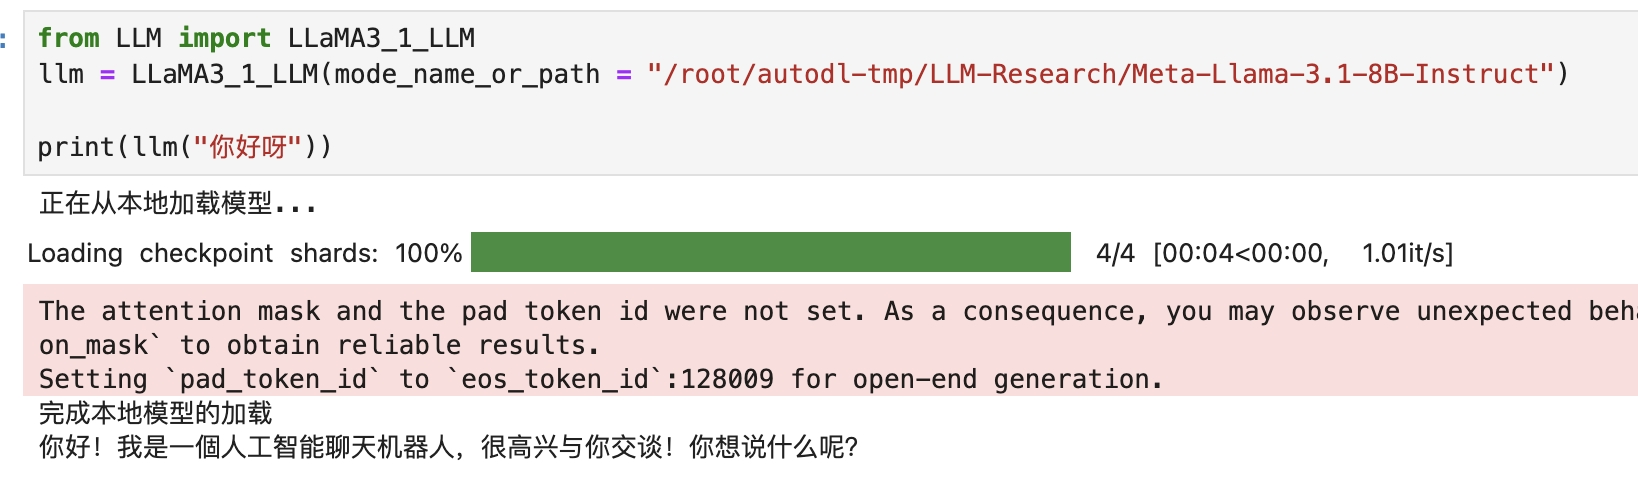
LLaMA3_1-8B-Instruct WebDemo 部署
环境准备
----------------
ubuntu 22.04
python 3.12
cuda 12.1
pytorch 2.3.0
----------------本文默认学习者已安装好以上 Pytorch(cuda) 环境,如未安装请自行安装。
pip 换源加速下载并安装依赖包
# 升级pip
python -m pip install --upgrade pip
# 更换 pypi 源加速库的安装
pip config set global.index-url https://pypi.tuna.tsinghua.edu.cn/simple

pip install modelscope==1.16.1
pip install langchain==0.2.3
pip install streamlit==1.37.0
pip install transformers==4.43.2
pip install accelerate==0.32.1考虑到部分同学配置环境可能会遇到一些问题,我们在AutoDL平台准备了LLaMA3-1的环境镜像,点击下方链接并直接创建Autodl示例即可。 https://www.codewithgpu.com/i/datawhalechina/self-llm/self-llm-llama3.1
模型下载
使用 modelscope 中的 snapshot_download 函数下载模型,第一个参数为模型名称,参数 cache_dir 为模型的下载路径。
在新建 model_download.py 文件并在其中输入以下内容,粘贴代码后记得保存文件,如下图所示。并运行 python model_download.py 执行下载,模型大小为 16 GB,下载模型大概需要 12 分钟。
import torch
from modelscope import snapshot_download, AutoModel, AutoTokenizer
import os

model_dir = snapshot_download('LLM-Research/Meta-Llama-3.1-8B-Instruct', cache_dir='/root/autodl-tmp', revision='master')注意:记得修改
cache_dir为你的模型下载路径哦~
代码准备
新建 chatBot.py 文件并在其中输入以下内容,粘贴代码后记得保存文件。下面的代码有很详细的注释,大家如有不理解的地方,欢迎提出issue。
from transformers import AutoTokenizer, AutoModelForCausalLM
import torch
import streamlit as st

# 在侧边栏中创建一个标题和一个链接
with st.sidebar:
    st.markdown("## LLaMA3.1 LLM")
    "[开源大模型食用指南 self-llm](https://github.com/datawhalechina/self-llm.git)"

# 创建一个标题和一个副标题
st.title("💬 LLaMA3.1 Chatbot")
st.caption("🚀 A streamlit chatbot powered by Self-LLM")

# 定义模型路径
mode_name_or_path = '/root/autodl-tmp/LLM-Research/Meta-Llama-3___1-8B-Instruct'

# 定义一个函数,用于获取模型和tokenizer
@st.cache_resource
def get_model():
    # 从预训练的模型中获取tokenizer
    tokenizer = AutoTokenizer.from_pretrained(mode_name_or_path, trust_remote_code=True)
    tokenizer.pad_token = tokenizer.eos_token
    # 从预训练的模型中获取模型,并设置模型参数
    model = AutoModelForCausalLM.from_pretrained(mode_name_or_path, torch_dtype=torch.bfloat16).cuda()

    return tokenizer, model

# 加载LLaMA3的model和tokenizer
tokenizer, model = get_model()

# 如果session_state中没有"messages",则创建一个包含默认消息的列表
if "messages" not in st.session_state:
    st.session_state["messages"] = []

# 遍历session_state中的所有消息,并显示在聊天界面上
for msg in st.session_state.messages:
    st.chat_message(msg["role"]).write(msg["content"])

# 如果用户在聊天输入框中输入了内容,则执行以下操作
if prompt := st.chat_input():

    # 在聊天界面上显示用户的输入
    st.chat_message("user").write(prompt)

    # 将用户输入添加到session_state中的messages列表中
    st.session_state.messages.append({"role": "user", "content": prompt})

    # 将对话输入模型,获得返回
    input_ids = tokenizer.apply_chat_template(st.session_state["messages"],tokenize=False,add_generation_prompt=True)
    model_inputs = tokenizer([input_ids], return_tensors="pt").to('cuda')
    generated_ids = model.generate(model_inputs.input_ids,max_new_tokens=512)
    generated_ids = [
        output_ids[len(input_ids):] for input_ids, output_ids in zip(model_inputs.input_ids, generated_ids)
    ]
    response = tokenizer.batch_decode(generated_ids, skip_special_tokens=True)[0]

    # 将模型的输出添加到session_state中的messages列表中
    st.session_state.messages.append({"role": "assistant", "content": response})
    # 在聊天界面上显示模型的输出
    st.chat_message("assistant").write(response)
print(st.session_state)运行 demo
在终端中运行以下命令,启动streamlit服务,server.port可以更换端口
streamlit run chatBot.py --server.address 127.0.0.1 --server.port 6006点击自定义服务
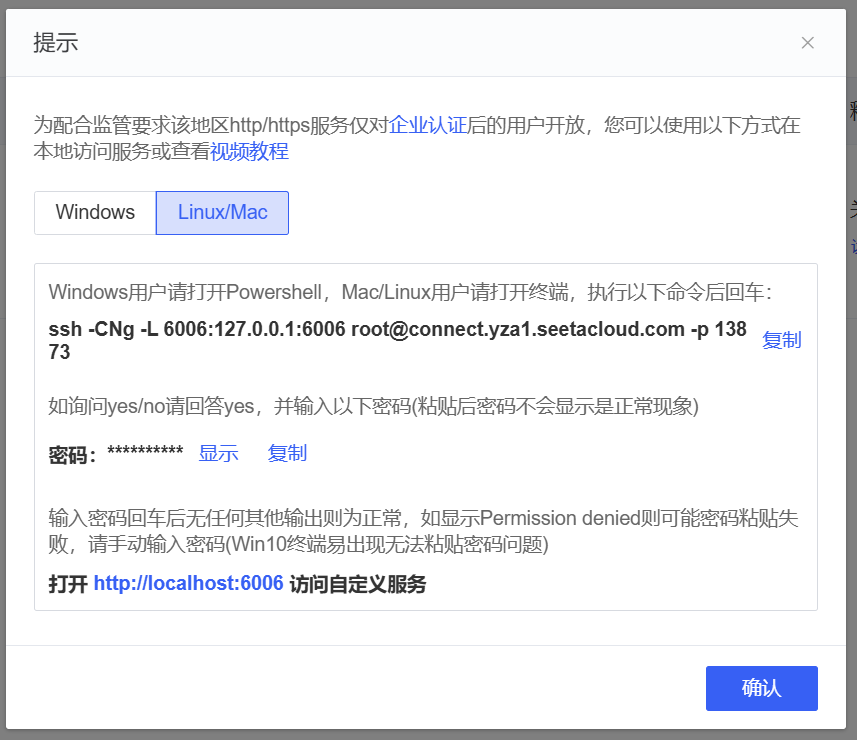
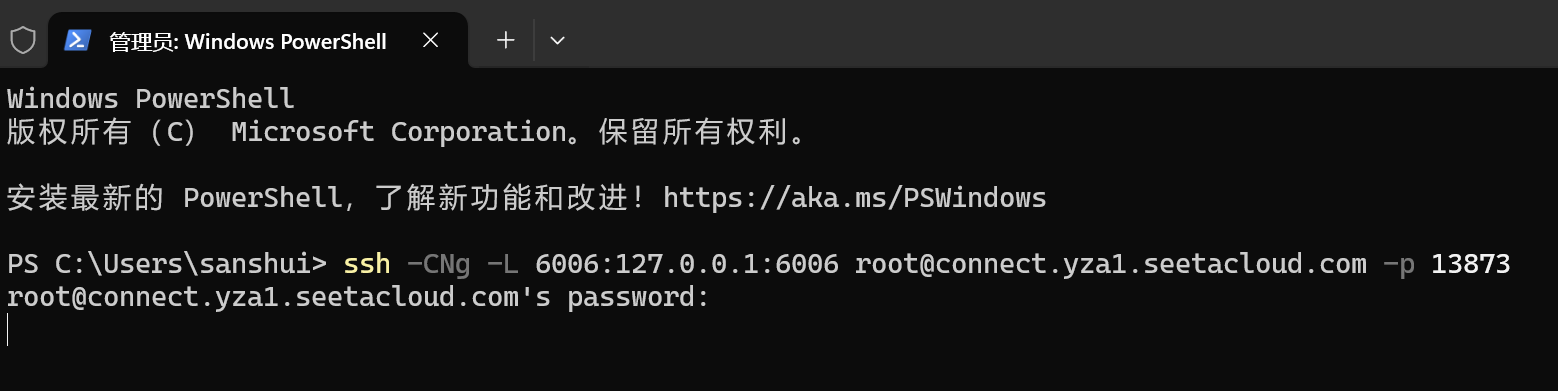
在本地终端中建立 ssh 连接与输入密码
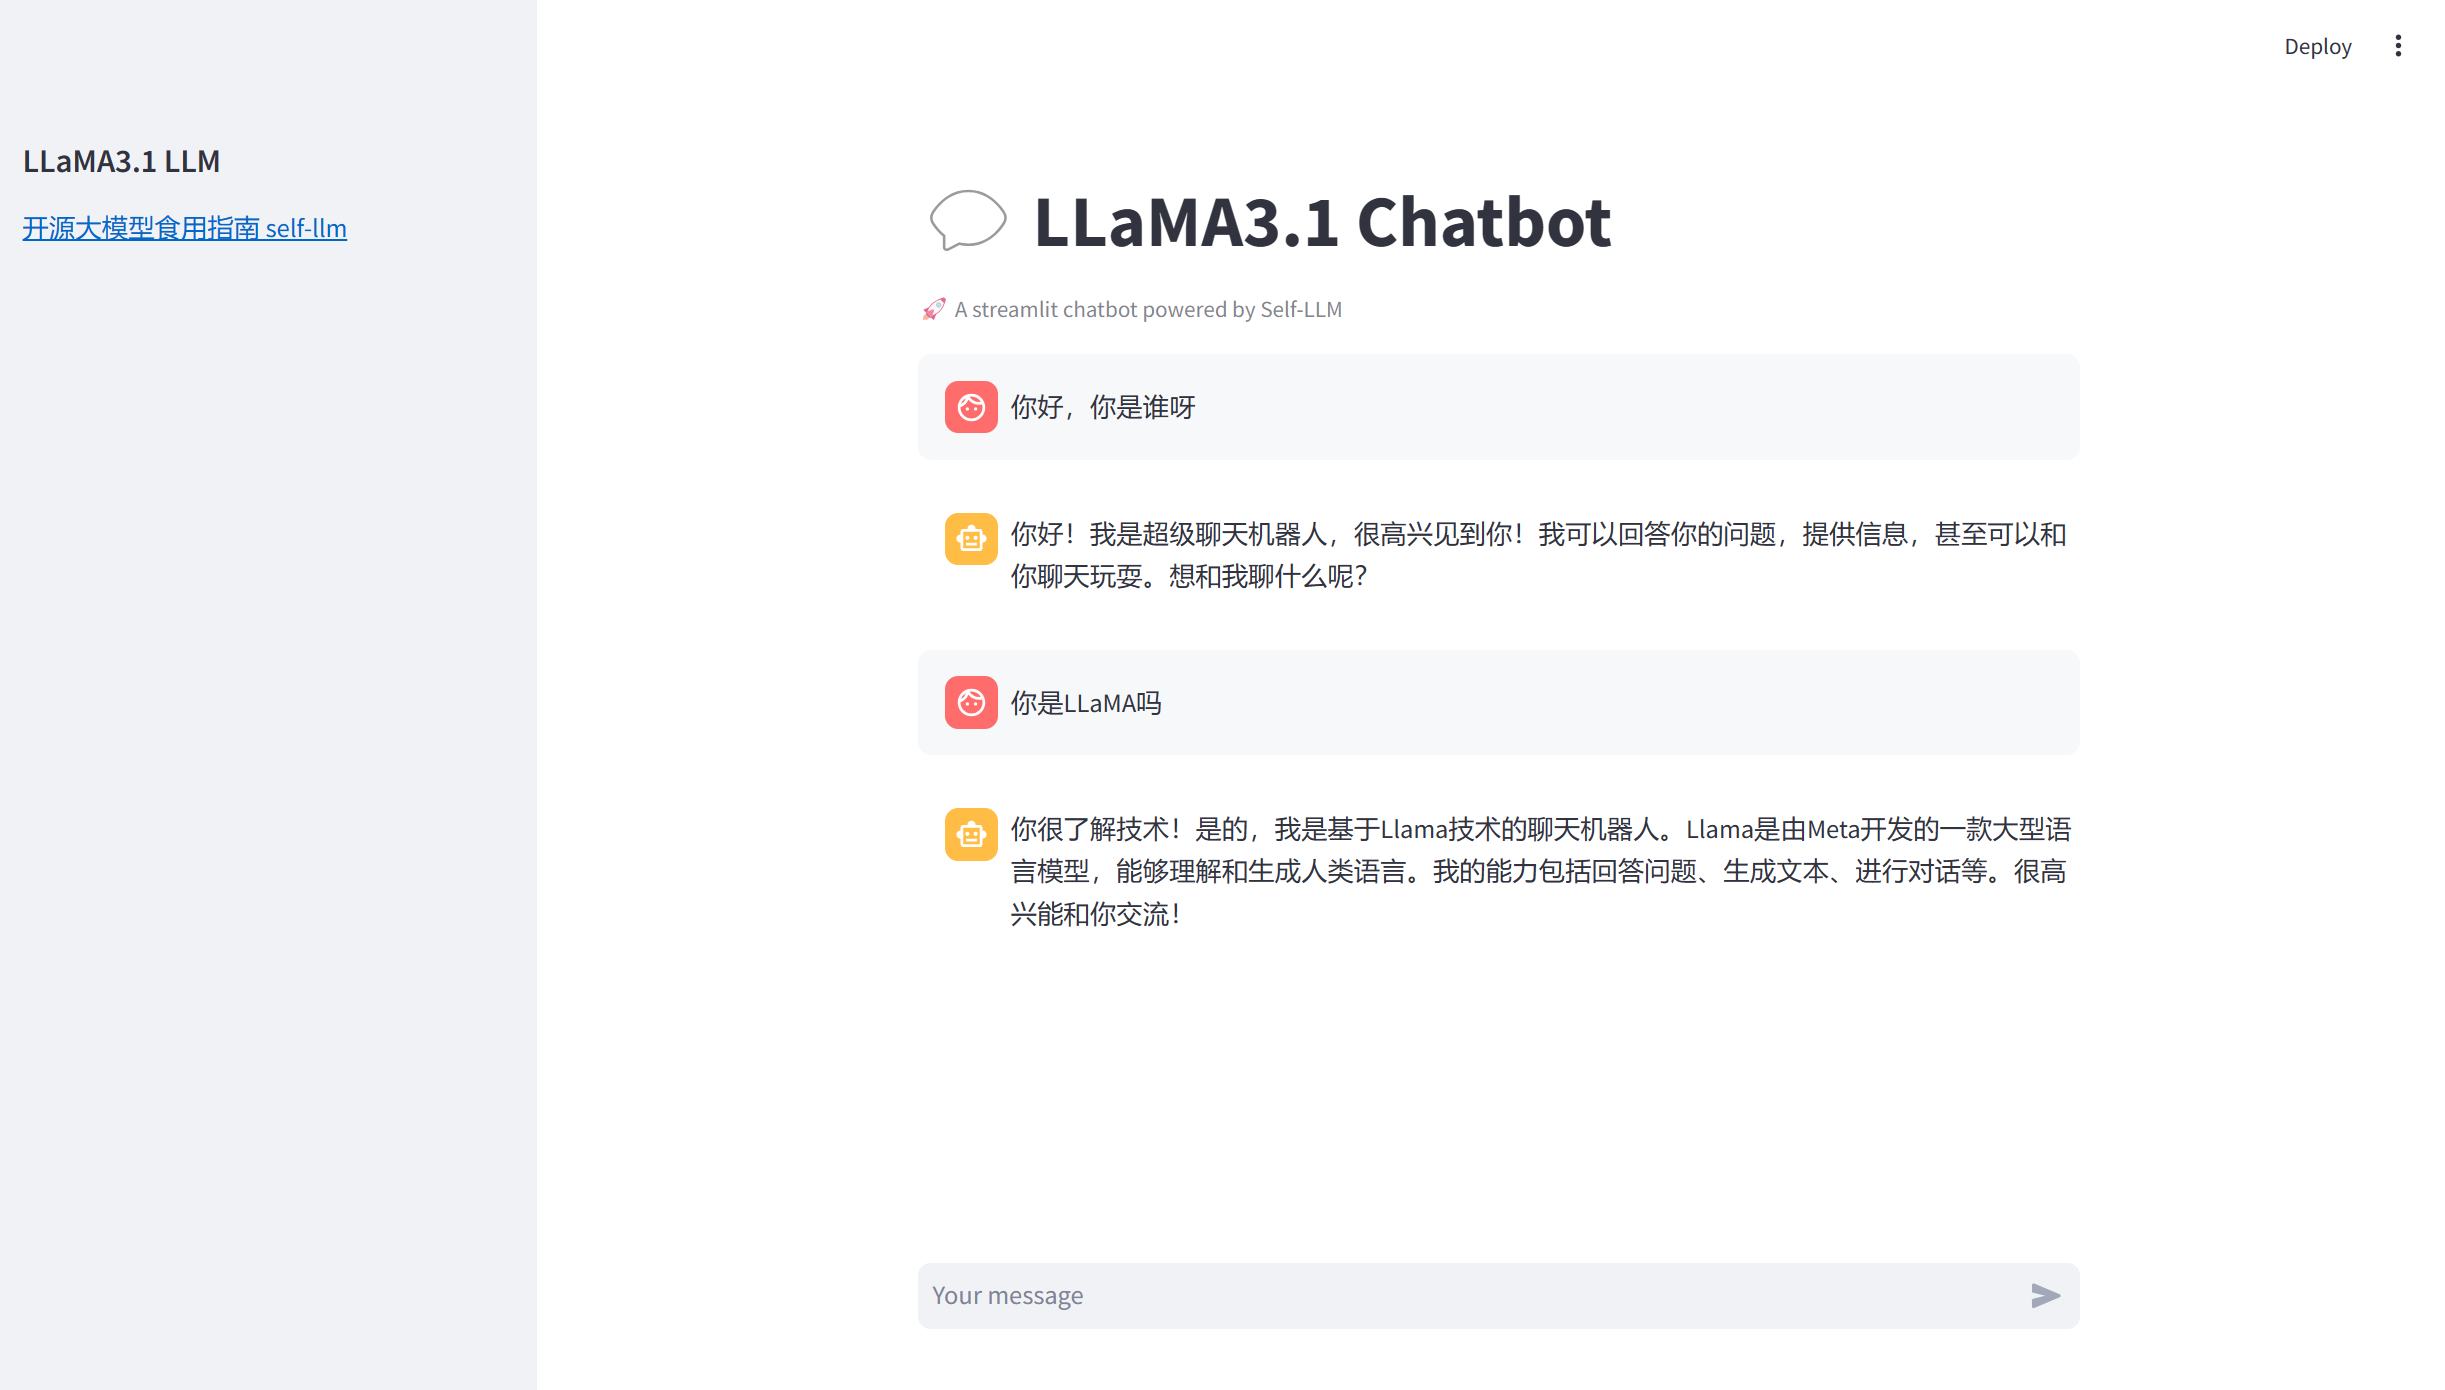
在本地浏览器中打开链接 http://localhost:6006/ ,即可查看部署的 WebDemo 聊天界面。运行效果如下:
LLaMA3_1-8B-Instruct Lora 微调
本节我们简要介绍如何基于 transformers、peft 等框架,对 LLaMA3_1-8B-Instruct 模型进行 Lora 微调。Lora 是一种高效微调方法,深入了解其原理可参见博客:知乎|深入浅出Lora。
环境配置
本文基础环境如下:
----------------
ubuntu 22.04
python 3.12
cuda 12.1
pytorch 2.3.0
----------------本文默认学习者已安装好以上 Pytorch(cuda) 环境,如未安装请自行安装。
首先 pip 换源加速下载并安装依赖包
# 升级pip
python -m pip install --upgrade pip
# 更换 pypi 源加速库的安装
pip config set global.index-url https://pypi.tuna.tsinghua.edu.cn/simple

pip install modelscope==1.16.1
pip install transformers==4.43.2
pip install accelerate==0.32.1
pip install peft==0.11.1
pip install datasets==2.20.0考虑到部分同学配置环境可能会遇到一些问题,我们在AutoDL平台准备了LLaMA3-1的环境镜像,点击下方链接并直接创建Autodl示例即可。 https://www.codewithgpu.com/i/datawhalechina/self-llm/self-llm-llama3.1
模型下载
使用 modelscope 中的 snapshot_download 函数下载模型,第一个参数为模型名称,参数 cache_dir 为模型的下载路径。
在当前路径下新建 model_download.py 文件并在其中输入以下内容,粘贴代码后请及时保存文件,如下图所示。并运行 python model_download.py 执行下载,模型大小为 15GB,下载模型大概需要 5 分钟。
import torch
from modelscope import snapshot_download, AutoModel, AutoTokenizer
import os
model_dir = snapshot_download('LLM-Research/Meta-Llama-3.1-8B-Instruct', cache_dir='/root/autodl-tmp', revision='master')注意:记得修改
cache_dir为你的模型下载路径哦~
指令集构建
LLM 的微调一般指指令微调过程。所谓指令微调,是说我们使用的微调数据形如:
{
    "instruction":"回答以下用户问题,仅输出答案。",
    "input":"1+1等于几?",
    "output":"2"
}其中,instruction 是用户指令,告知模型其需要完成的任务;input 是用户输入,是完成用户指令所必须的输入内容;output 是模型应该给出的输出。
即我们的核心训练目标是让模型具有理解并遵循用户指令的能力。因此,在指令集构建时,我们应针对我们的目标任务,针对性构建任务指令集。例如,在本节我们使用由笔者合作开源的 Chat-甄嬛 项目作为示例,我们的目标是构建一个能够模拟甄嬛对话风格的个性化 LLM,因此我们构造的指令形如:
{
    "instruction": "你是谁?",
    "input":"",
    "output":"家父是大理寺少卿甄远道。"
}我们所构造的全部指令数据集在根目录下。
数据格式化
Lora 训练的数据是需要经过格式化、编码之后再输入给模型进行训练的,如果是熟悉 Pytorch 模型训练流程的同学会知道,我们一般需要将输入文本编码为 input_ids,将输出文本编码为 labels,编码之后的结果都是多维的向量。我们首先定义一个预处理函数,这个函数用于对每一个样本,编码其输入、输出文本并返回一个编码后的字典:
def process_func(example):
    MAX_LENGTH = 384    # Llama分词器会将一个中文字切分为多个token,因此需要放开一些最大长度,保证数据的完整性
    input_ids, attention_mask, labels = [], [], []
    instruction = tokenizer(f"<|begin_of_text|><|start_header_id|>system<|end_header_id|>\n\nCutting Knowledge Date: December 2023\nToday Date: 26 Jul 2024\n\n现在你要扮演皇帝身边的女人--甄嬛<|eot_id|><|start_header_id|>user<|end_header_id|>\n\n{example['instruction'] + example['input']}<|eot_id|><|start_header_id|>assistant<|end_header_id|>\n\n", add_special_tokens=False)  # add_special_tokens 不在开头加 special_tokens
    response = tokenizer(f"{example['output']}<|eot_id|>", add_special_tokens=False)
    input_ids = instruction["input_ids"] + response["input_ids"] + [tokenizer.pad_token_id]
    attention_mask = instruction["attention_mask"] + response["attention_mask"] + [1]  # 因为eos token咱们也是要关注的所以 补充为1
    labels = [-100] * len(instruction["input_ids"]) + response["input_ids"] + [tokenizer.pad_token_id]
    if len(input_ids) > MAX_LENGTH:  # 做一个截断
        input_ids = input_ids[:MAX_LENGTH]
        attention_mask = attention_mask[:MAX_LENGTH]
        labels = labels[:MAX_LENGTH]
    return {
        "input_ids": input_ids,
        "attention_mask": attention_mask,
        "labels": labels
}LLaMA3.1 采用的Prompt Template格式如下:
<|begin_of_text|><|start_header_id|>system<|end_header_id|>

现在你要扮演皇帝身边的女人--甄嬛<|eot_id|><|start_header_id|>user<|end_header_id|>

你好呀<|eot_id|><|start_header_id|>assistant<|end_header_id|>

你好,我是甄嬛,你有什么事情要问我吗?<|eot_id|><|start_header_id|>assistant<|end_header_id|>加载tokenizer和半精度模型
模型以半精度形式加载,如果你的显卡比较新的话,可以用torch.bfolat形式加载。对于自定义的模型一定要指定trust_remote_code参数为True。
tokenizer = AutoTokenizer.from_pretrained('/root/autodl-tmp/LLM-Research/Meta-Llama-3.1-8B-Instruct', use_fast=False, trust_remote_code=True)

model = AutoModelForCausalLM.from_pretrained('/root/autodl-tmp/LLM-Research/Meta-Llama-3.1-8B-Instruct', device_map="auto",torch_dtype=torch.bfloat16)注意:此处要记得修改为自己的模型路径哦~
定义LoraConfig
LoraConfig这个类中可以设置很多参数,但主要的参数没多少,简单讲一讲,感兴趣的同学可以直接看源码。
task_type:模型类型
target_modules:需要训练的模型层的名字,主要就是attention部分的层,不同的模型对应的层的名字不同,可以传入数组,也可以字符串,也可以正则表达式。
r:lora的秩,具体可以看Lora原理
lora_alpha:Lora alaph,具体作用参见 Lora 原理
Lora的缩放是啥嘞?当然不是r(秩),这个缩放就是lora_alpha/r, 在这个LoraConfig中缩放就是4倍。
config = LoraConfig(
    task_type=TaskType.CAUSAL_LM,
    target_modules=["q_proj", "k_proj", "v_proj", "o_proj", "gate_proj", "up_proj", "down_proj"],
    inference_mode=False, # 训练模式
    r=8, # Lora 秩
    lora_alpha=32, # Lora alaph,具体作用参见 Lora 原理
    lora_dropout=0.1# Dropout 比例
)自定义 TrainingArguments 参数
TrainingArguments这个类的源码也介绍了每个参数的具体作用,当然大家可以来自行探索,这里就简单说几个常用的。
output_dir:模型的输出路径
per_device_train_batch_size:顾名思义 batch_size
gradient_accumulation_steps: 梯度累加,如果你的显存比较小,那可以把 batch_size 设置小一点,梯度累加增大一些。
logging_steps:多少步,输出一次log
num_train_epochs:顾名思义 epoch
gradient_checkpointing:梯度检查,这个一旦开启,模型就必须执行model.enable_input_require_grads(),这个原理大家可以自行探索,这里就不细说了。
args = TrainingArguments(
    output_dir="./output/llama3_1_instruct_lora",
    per_device_train_batch_size=4,
    gradient_accumulation_steps=4,
    logging_steps=10,
    num_train_epochs=3,
    save_steps=100,
    learning_rate=1e-4,
    save_on_each_node=True,
    gradient_checkpointing=True
)使用 Trainer 训练
trainer = Trainer(
    model=model,
    args=args,
    train_dataset=tokenized_id,
    data_collator=DataCollatorForSeq2Seq(tokenizer=tokenizer, padding=True),
)
trainer.train()加载 lora 权重推理
训练好了之后可以使用如下方式加载lora权重进行推理:
from transformers import AutoModelForCausalLM, AutoTokenizer
import torch
from peft import PeftModel

mode_path = '/root/autodl-tmp/LLM-Research/Meta-Llama-3.1-8B-Instruct'
lora_path = '/root/autodl-tmp/output/llama3_1_instruct_lora/checkpoint-100' # 这里改称你的 lora 输出对应 checkpoint 地址

# 加载tokenizer
tokenizer = AutoTokenizer.from_pretrained(mode_path, trust_remote_code=True)

# 加载模型
model = AutoModelForCausalLM.from_pretrained(mode_path, device_map="auto",torch_dtype=torch.bfloat16, trust_remote_code=True).eval()

# 加载lora权重
model = PeftModel.from_pretrained(model, model_id=lora_path)

prompt = "你是谁?"

messages = [
        {"role": "system", "content": "假设你是皇帝身边的女人--甄嬛。"},
        {"role": "user", "content": prompt}
]

input_ids = tokenizer.apply_chat_template(messages, tokenize=False, add_generation_prompt=True)
model_inputs = tokenizer([input_ids], return_tensors="pt").to('cuda')
generated_ids = model.generate(model_inputs.input_ids,max_new_tokens=512)
generated_ids = [
    output_ids[len(input_ids):] for input_ids, output_ids in zip(model_inputs.input_ids, generated_ids)
]
response = tokenizer.batch_decode(generated_ids, skip_special_tokens=True)[0]
print(response)05-Llama3_1-8B-Instruct o1-like 推理链实现
OpenAI o1 model 简介
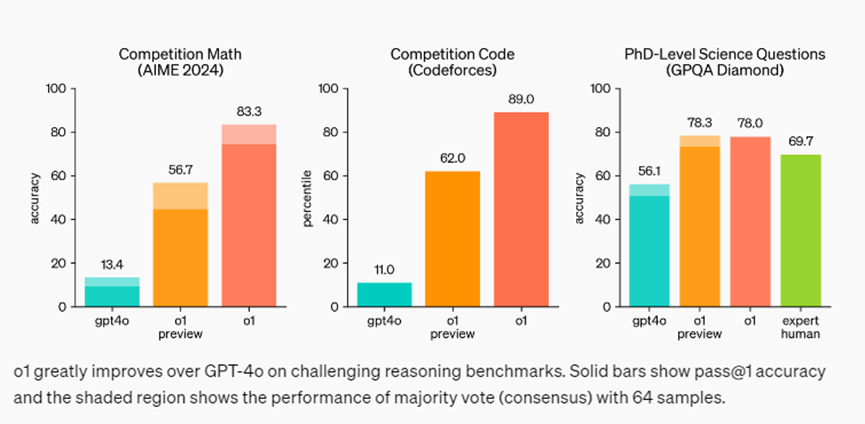
OpenAI o1 系列模型是使用强化学习训练的大语言模型,用于执行复杂推理。o1 模型在回答之前会思考,在向用户做出回应之前可以产生一个长的内部思维链。 o1 模型在科学推理方面表现出色,在编程竞赛(Codeforces)中排名 89%,在美国数学奥林匹克竞赛(AIME)的预选中位列前 500 名,在物理、生物学和化学问题基准测试(GPQA)中超越了人类博士水平。
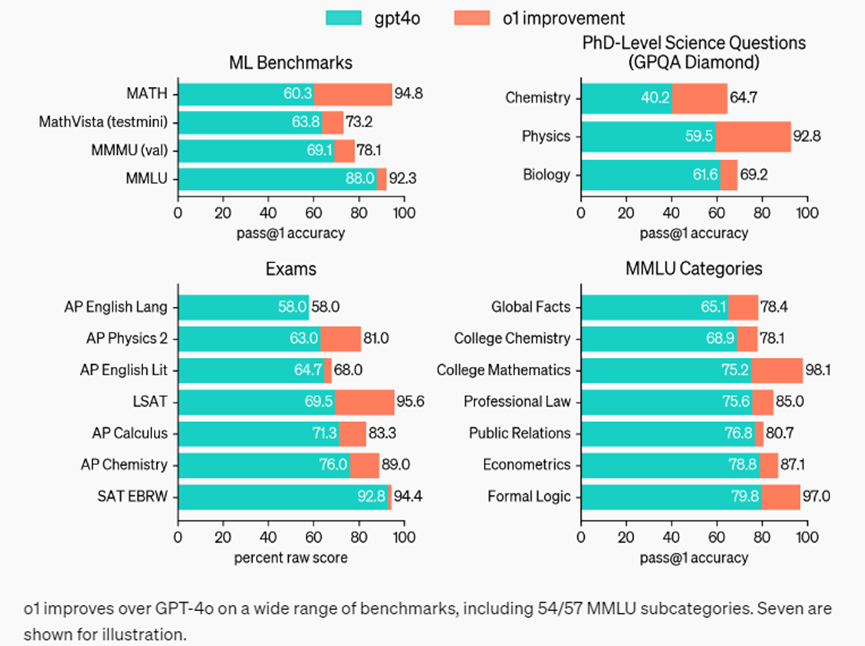
OpenAI o1 系列模型不仅提高了模型的实用性,还为未来AI技术的发展开辟了新的道路。目前,o1模型包括 o1-preview 和o1-mini 两个版本,其中 o1-preview 适用于解决各个领域的复杂问题,而 o1-mini 则速度更快,性价比更高,且更擅长代码领域。
参考文档:
环境准备
本文基础环境如下:
----------------
ubuntu 22.04
python 3.12
cuda 12.1
pytorch 2.3.0
----------------本文默认学习者已配置好以上
Pytorch (cuda)环境,如未配置请先自行安装。
首先 pip 换源加速下载并安装依赖包
python -m pip install --upgrade pip
pip config set global.index-url https://pypi.tuna.tsinghua.edu.cn/simple

pip install modelscope==1.18.0
pip install openai==1.46.0
pip install tqdm==4.66.2
pip install transformers==4.44.2
pip install vllm==0.6.1.post2
pip install streamlit==1.38.0考虑到部分同学配置环境可能会遇到一些问题,我们在AutoDL平台准备了
LLaMA3.1的环境镜像,点击下方链接并直接创建AutoDL示例即可。 https://www.codewithgpu.com/i/datawhalechina/self-llm/self-llm-llama3.1
模型下载
使用 modelscope 中的 snapshot_download 函数下载模型,第一个参数为模型名称,参数 cache_dir为模型的下载路径。
先切换到 autodl-tmp 目录,cd /root/autodl-tmp
然后新建名为 model_download.py 的 python 脚本,并在其中输入以下内容并保存
# model_download.py
from modelscope import snapshot_download
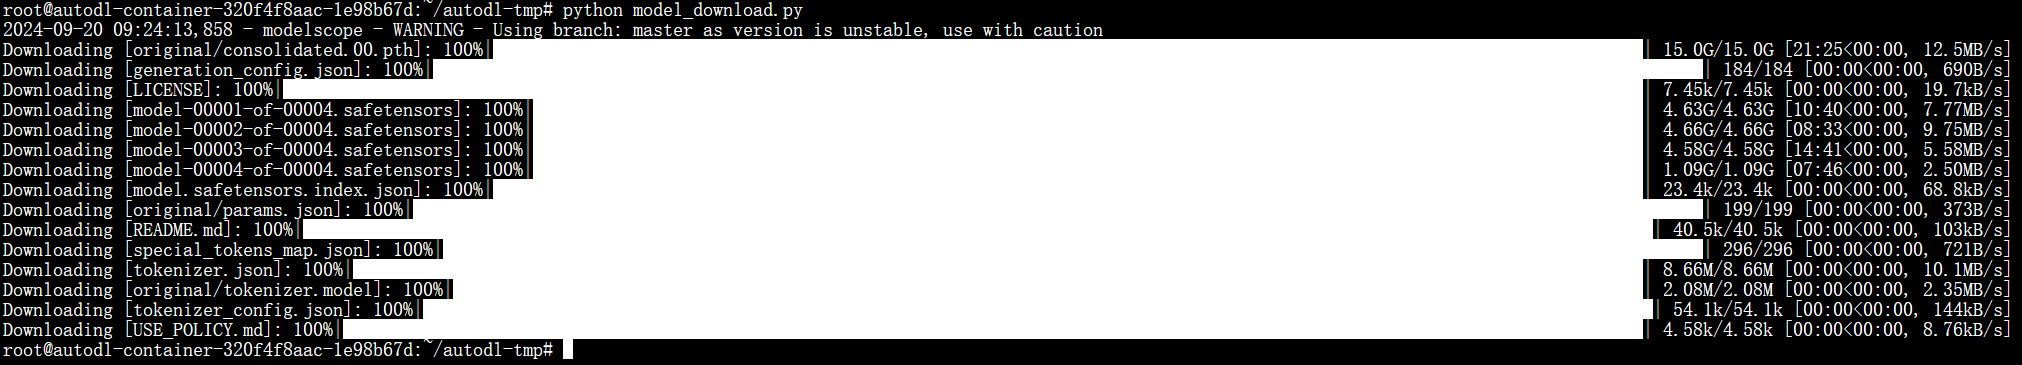
model_dir = snapshot_download('LLM-Research/Meta-Llama-3.1-8B-Instruct', cache_dir='/root/autodl-tmp', revision='master')然后在终端中输入 python model_download.py 执行下载,这里需要耐心等待一段时间直到模型下载完成。
注意:记得修改
cache_dir为你的模型下载路径哦~
代码准备
核心代码
在 /root/autodl-tmp 路径下新建 app_llama.py 文件并在其中输入以下内容,粘贴代码后请及时保存文件。
# app_llama.py
import os
import json
import time
import streamlit as st
from openai import OpenAI

client = OpenAI(
    api_key="sk-xxx",
    base_url="http://localhost:8000/v1",
)

def make_api_call(messages, max_tokens, is_final_answer=False):
    for attempt in range(3):
        try:
            response = client.chat.completions.create(
                model="Llama-3.1-8B-Instruct",
                messages=messages,
                max_tokens=max_tokens,
                temperature=0.0,
                response_format={"type": "json_object"}
            )
            content = response.choices[0].message.content
            print(f"Raw API response: {content}")  # 添加此行来打印原始响应
            try:
                return json.loads(content)
            except json.JSONDecodeError as json_error:
                print(f"JSON解析错误: {json_error}")
                # 如果JSON解析失败,返回一个包含原始内容的字典
                return {
                    "title": "API Response",
                    "content": content,
                    "next_action": "final_answer" if is_final_answer else "continue"
                }
        except Exception as e:
            if attempt == 2:
                return {
                    "title": "Error",
                    "content": f"Failed after 3 attempts. Error: {str(e)}",
                    "next_action": "final_answer"
                }
            time.sleep(1)  # 重试前等待1秒

def generate_response(prompt):
    messages = [
        {"role": "system", "content":
        """
        You are an expert AI assistant that explains your reasoning step by step. For each step, provide a title that describes what you're doing in that step, along with the content. Decide if you need another step or if you're ready to give the final answer. Respond in JSON format with 'title', 'content', and 'next_action' (either 'continue' or 'final_answer') keys. USE AS MANY REASONING STEPS AS POSSIBLE. AT LEAST 3. BE AWARE OF YOUR LIMITATIONS AS AN LLM AND WHAT YOU CAN AND CANNOT DO. IN YOUR REASONING, INCLUDE EXPLORATION OF ALTERNATIVE ANSWERS. CONSIDER YOU MAY BE WRONG, AND IF YOU ARE WRONG IN YOUR REASONING, WHERE IT WOULD BE. FULLY TEST ALL OTHER POSSIBILITIES. YOU CAN BE WRONG. WHEN YOU SAY YOU ARE RE-EXAMINING, ACTUALLY RE-EXAMINE, AND USE ANOTHER APPROACH TO DO SO. DO NOT JUST SAY YOU ARE RE-EXAMINING. USE AT LEAST 3 METHODS TO DERIVE THE ANSWER. USE BEST PRACTICES.

Example of a valid JSON response:{ "title": "Identifying Key Information", "content": "To begin solving this problem, we need to carefully examine the given information and identify the crucial elements that will guide our solution process. This involves...", "next_action": "continue" }``` Remember again that you analysis should be as concise as possible and DO NOT repeat yourself! USE AS MANY REASONING STEPS AS POSSIBLE!!! """ }, {"role": "user", "content": prompt}, {"role": "assistant", "content": "I will now think step by step following my instructions, starting at the beginning after decomposing the problem."} ]
steps = [] step_count = 1 total_thinking_time = 0
while True: start_time = time.time() step_data = make_api_call(messages, 300) end_time = time.time() thinking_time = end_time - start_time total_thinking_time += thinking_time
title = step_data.get('title', f'Step {step_count}') content = step_data.get('content', 'No content provided') next_action = step_data.get('next_action', 'continue')
steps.append((f"Step {step_count}: {title}", content, thinking_time))
messages.append({"role": "assistant", "content": json.dumps(step_data)})
if next_action == 'final_answer' or step_count > 25: # 最多25步,以防止无限的思考。可以适当调整 break
step_count += 1
yield steps, None # 在结束时生成总时间
messages.append({"role": "user", "content": "Please provide the final answer based on your reasoning above."})
start_time = time.time() final_data = make_api_call(messages, 500, is_final_answer=True) end_time = time.time() thinking_time = end_time - start_time total_thinking_time += thinking_time
final_content = final_data.get('content', 'No final content provided') steps.append(("最终推理结果", final_content, thinking_time))
yield steps, total_thinking_time
def main(): st.set_page_config(page_title="LLaMA3.1 o1-like Reasoning Chain", page_icon="💬", layout="wide")
st.title("LLaMA3.1实现类似o1 model的推理链") st.caption("🚀 A streamlit implementation powered by 开源大模型食用指南 self-llm")
st.markdown(""" 通过vLLM部署调用LLaMA3.1-8B-Instruct并实现类似OpenAI o1 model的长推理链效果以提高对复杂问题的推理准确性。 """)
user_query = st.text_input("输入问题:", placeholder="e.g., How many Rs are in strawberry?") if user_query: st.write("正在生成推理链中...")
response_container = st.empty() time_container = st.empty()
for steps, total_thinking_time in generate_response(user_query): with response_container.container(): for i, (title, content, thinking_time) in enumerate(steps): if title.startswith("最终推理结果"): st.markdown(f"### {title}") st.markdown(content.replace('\n', ' '), unsafe_allow_html=True) else: with st.expander(title, expanded=True): st.markdown(content.replace('\n', ' '), unsafe_allow_html=True)
if total_thinking_time is not None: time_container.markdown(f"总推理时间: {total_thinking_time:.2f} 秒")
if name == "main": main()
#### 实现原理

**注意:**代码中只是尝试实现了 **`o1-like`** 的 `Reasoning Chain` 的效果,而并非是在 `pretrain` 过程中训练得到 `Chain of Thought` 内置能力的 o1 模型。
#### 创建兼容 OpenAI API 接口的服务
`LLaMA` 兼容 `OpenAI API` 协议,所以我们可以直接使用 `vLLM` 创建 `OpenAI API` 服务器。`vLLM` 部署实现 `OpenAI API` 协议的服务器非常方便。默认会在 http://localhost:8000 启动服务器。服务器当前一次托管一个模型,并实现列表模型、`completions` 和 `chat completions` 端口。
- `completions`:是基本的文本生成任务,模型会在给定的提示后生成一段文本。这种类型的任务通常用于生成文章、故事、邮件等。
- `chat completions`:是面向对话的任务,模型需要理解和生成对话。这种类型的任务通常用于构建聊天机器人或者对话系统。
在创建服务器时,我们可以指定模型名称、模型路径、聊天模板等参数。
- `--host` 和 `--port` 参数指定地址。
- `--model` 参数指定模型名称。
- `--chat-template` 参数指定聊天模板。
- `--served-model-name` 指定服务模型的名称。
- `--max-model-len` 指定模型的最大长度。python -m vllm.entrypoints.openai.api_server --model /root/autodl-tmp/LLM-Research/Meta-Llama-3.1-8B-Instruct --served-model-name Llama-3.1-8B-Instruct --max-model-len=18016 --port 8000
加载完毕后出现如下信息说明服务成功启动

#### 启动 Streamlit 界面streamlit run /root/autodl-tmp/app_llama.py --server.address 127.0.0.1 --server.port 6003
在本地浏览器中打开链接 http://127.0.0.1:6003/ ,即可进入部署的 `Streamlit` 界面。
我们可以尝试示例中的问题,`How many Rs are in strawberry?` 来让实现了推理链的 `Llama3.1-8B-Instruct` 给出推理结果

我们可以观察到经过 **3** 步推理和思考,最终的推理结果是**正确的**,且总推理耗时还是很长的,这也符合了 o1 模型的基本特征,用推理时间的增加换取更高的推理准确率。
**说明:**作为对比,我们可以回到 [03-Llama3.1-8B-Instruct WebDemo 部署](./03-Llama3_1-8B-Instruct WebDemo部署.md) 来尝试一下提问相同的问题,最后得到的结果显然是**错误的**。
总结
llm #ollama #LoRA部署
引言
在上面的[[04-LLaMA3-8B-Instruct Lora 微调]]中, 介绍了构建大语言模型微调的数据集格式,数据集预处理, Q-LoRA 微调大模型, 本章我们将来到大模型的部署环节. 在模型的部署场景我们会希望部署后的模型服务可以提供一个标准的API, 同时部署模型的框架还要对Cuda 保持兼容性,Ollama就成为了很好的选择. 本文将通过模型导入到Ollama完成对大模型+LoRA的本地部署.
Ollama 介绍
Ollama是一个用于简化大语言模型本地部署和运行的工具,它提供了一个轻量\易于扩展的框架, 让开发者可以在本地部署和管理大模型. 通过Ollama,开发者可以访问和管理原始pre-trained 大模型,也可以导入自己的大模型, 而无需关注底层细节.
Ollama 主要支持的是GGUF格式的模型文件. GGUF(GPT-Generated Unified Format)是专为高效运行 LLM 设计的二进制格式,由 llama.cpp 项目引入,取代了旧版 GGML 格式。可以从Hugging face 下载预转换的GGUF 原始模型, 或者使用llama.cpp 自行转换
什么是GGUF
GGUF 格式的全名为(GPT-Generated Unified Format),提到 GGUF 就不得不提到它的前身 GGML(GPT-Generated Model Language)。GGML 是专门为了机器学习设计的张量库,最早可以追溯到 2022/10。其目的是为了有一个单文件共享的格式,并且易于在不同架构的 GPU 和 CPU 上进行推理。但在后续的开发中,遇到了灵活性不足、相容性及难以维护的问题。
根据上面Ollama 部分的介绍我们可以发现, pytorch训练后的模型文件不能直接导入到ollama中, 需要将其预先转为.gguf 文件. 本节将讲述如何将训练后的模型导出为gguf 文件.
动手转化基础模型和LoRA 文件到GGUF
从huggingface download 基础模型
最直觉是用 git clone 来下载模型,但是因为 LLM 每个一部分都按 GB 来计算,避免出现 OOM Error 的情况,简单用 Python 写一个 download.py 比较简单
#安装huggingface_hub
pip install huggingface_hub执行下面的代码
from huggingface_hub import snapshot_download
model_id="unsloth/Llama-3.1-8B-Instruct"
snapshot_download(repo_id=model_id, local_dir="yout_path",
local_dir_use_symlinks=False, revision="main")转换模型到GGUF
克隆llama.cpp
在控制台中部署下面的代码,clone 项目到本地
git clone https://github.com/ggerganov/llama.cpp.git

cd llama.cpp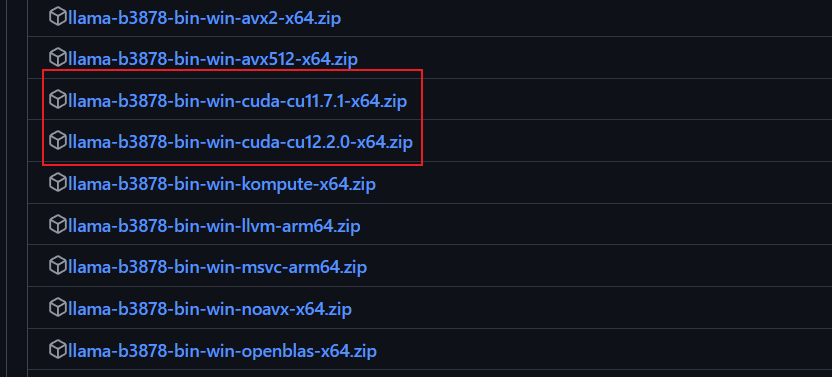
创建虚拟环境
使用conda
conda create -n llamacpp
conda activate llamacpp使用venv
python -m venv llamacpp
.\venv\Scripts\activate安装环境依赖
pip install -r .\requirements.txt转换基础模型
运行convert_hf_to_gguf.py, 此脚本用于将 Hugging Face 格式的模型转换为 GGUF 格式。请按照以下步骤操作:
确保您已经在llama.cpp目录下,并且已经激活了 Python 虚拟环境。
python convert_hf_to_gguf.py --outfile <gguf_path> <base_model_path>使用以下命令运行脚本:
--outfile 参数指定转换后的 GGUF 文件的输出路径。
最后的参数是您要转换的 Hugging Face 模型的路径。
请确保在运行这些脚本之前,所有路径和文件名都是正确的,并且所需的依赖项已经安装完毕。
通过日志可以看到导出成功

转换LoRA 适配器
继续使用下面的命令运行脚本
python .\convert_lora_to_gguf.py --outfile <lora_gguf_path> --base <base_model_path> <lora_model_path>--outfile参数指定转换后的GGUF 文件的输出路径
--base 参数指定转换gguf 前的基础模型的地址
最后的参数是您要转换的LoRA 模型的路径
基于GGUF文件创建模型
如果你有一个基于 GGUF 的模型或适配器,可以通过Ollama 的modelfile将其导入 Ollama.
Modelfile是一个模型的配置文件, 需要包含如下信息:
FROM(必须):模型的GGUF 文件地址
ADAPTER: 模型的LORA 适配器地址, 也需要转化为GGUF 文件
TEMPLATE: 模型的提示模板, 建议直接沿用基模型的TEMPLATE
FROM /path/to/model.gguf
ADAPTER /path/to/adapter.gguf
TEMPLATE 基础模型的template创建my_lora_adapter.Modelfile 文件, 并按照上述模板填写信息, 完成创建后通过下面的语句创建模型
ollama create <modelname> -f my_lora_adapter.Modelfile再次执行ollama list 即可看到自己的模型啦

将模型和LoRA适配器转换为GGUF格式需以下步骤:下载LLM至本地,准备环境并安装依赖,使用脚本将Hugging Face模型转为GGUF格式,再将LoRA适配器转为GGUF。后续介绍了ollama以及Modelfile 文件, 基于这些命令可以快速使用ollama 部署微调后的Lora 适配器