Hunyuan3D-2.0系列模型部署
基础配置环境如下:
PyTorch  2.5.1
Python  3.12
Cuda  12.4
ubuntu 22.04拉取项目仓库
安装git并验证版本信息
sudo apt install git
git --version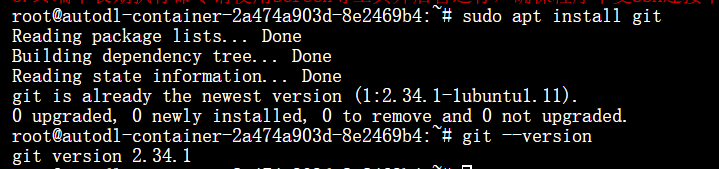
使用git clone拉取Hunyuan3D-2仓库
git clone https://github.com/Tencent/Hunyuan3D-2.gitgit clone拉取GitHub项目失败/太慢可以使用提供下载缓存的代码下载网站gitclone.com加速
git clone https://gitclone.com/github.com/Tencent/Hunyuan3D-2.git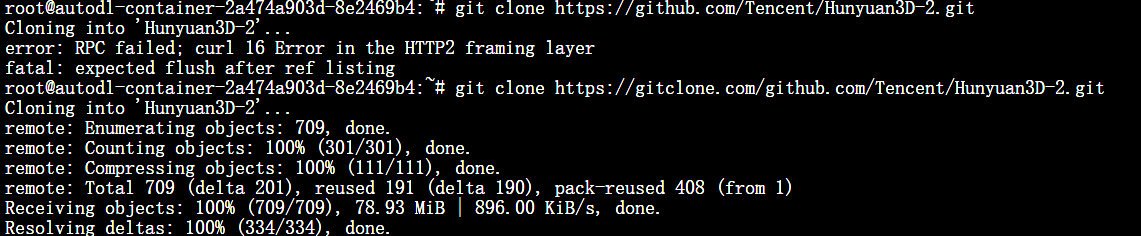
安装环境依赖
pip换源加速,进入项目目录,下载、安装依赖包
# 升级pip
python -m pip install --upgrade pip
# 更换 pypi 源加速库
pip config set global.index-url https://pypi.tuna.tsinghua.edu.cn/simple

cd ./Hunyuan3D-2
pip install -r requirements.txt

# for texture
cd hy3dgen/texgen/custom_rasterizer
python3 setup.py install

cd ../../..
cd hy3dgen/texgen/differentiable_renderer
python3 setup.py install考虑到部分同学配置环境可能会遇到一些问题,我们在 AutoDL 平台准备了 Hunyuan3D-2 的环境镜像,点击下方链接并直接创建 Autodl 示例即可。 https://www.codewithgpu.com/i/datawhalechina/self-llm/Hunyuan3D-2
执行官方代码会自动拉取huggingface模型,并存储至根目录缓存
也可以选择配置镜像网址"https://hf-mirror.com"加速,并将模型下载至指定数据盘目录
export HF_ENDPOINT="https://hf-mirror.com"
source ~/.bashrc
# Hunyuan3D-2
huggingface-cli download --resume-download tencent/Hunyuan3D-2 --local-dir /root/autodl-tmp/weights/Hunyuan3D-2
# Hunyuan3D-2mv
huggingface-cli download --resume-download tencent/Hunyuan3D-2mv --local-dir /root/autodl-tmp/weights/Hunyuan3D-2mv
#Hunyuan3D-2mini
huggingface-cli download --resume-download tencent/Hunyuan3D-2mini --local-dir /root/autodl-tmp/weights/Hunyuan3D-2miniHunyuan3D-2的仓库较大,约为56GB,可以使用魔搭社区的’AI-ModelScope/Hunyuan3D-2‘模型仓库进行下载拉取
import torch
from modelscope import snapshot_download, AutoModel, AutoTokenizer
import os
model_dir = snapshot_download('AI-ModelScope/Hunyuan3D-2', cache_dir='/root/autodl-tmp/weights', revision='master')记得将‘—local-dir’后或’cache_dir‘的路径替换为自己存放的本地数据盘路径
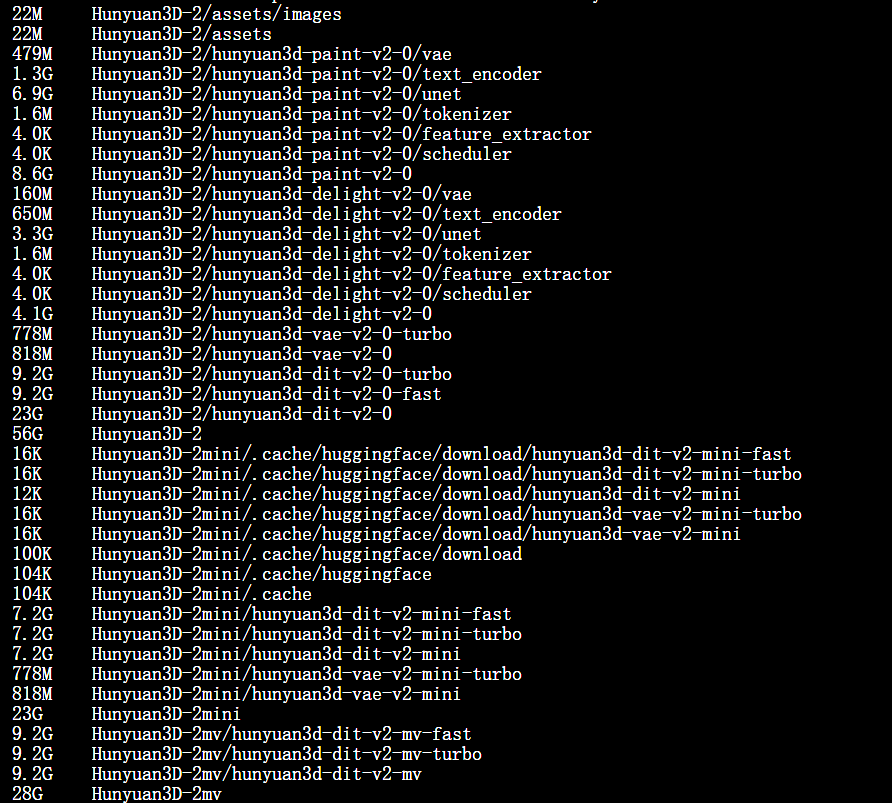
截至2025.3.20,Hunyuan3D-2模型仓库大小约为56GB,Hunyuan3D-2mv为28GB,Hunyuan3D-2mini为23GB,请参考官方运行硬件要求以及显存消耗拉取所需模型仓库,完整拉取供需106GB硬盘空间
Hunyuan3D-2系列模型代码调用
官方设计了一个类似diffusers的 API来供模型的加载执行,我们可以在项目仓库以及代码中修改,来指向我们模型存放的正确路径,默认加载路径为根目录下的缓存目录。
在项目仓库下:Hunyuan3D-2/hy3dgen/shapegen/utils.py:83
    original_model_path = model_path
    # try local path
    base_dir = os.environ.get('HY3DGEN_MODELS', '~/autodl-tmp') # 这里指向为自己模型存放路径的上级目录
    model_path = os.path.expanduser(os.path.join(base_dir, model_path, subfolder))
logger.info(f'Try to load model from local path: {model_path}')让我们先来进行单视图基础白模生成模型Dit的代码调用,这里以调用hunyuan3d-dit-v2-0模型为例
在项目目录下新建代码文件,并在其中输入以下内容,粘贴代码后请及时保存文件
import time

import torch
from PIL import Image

from hy3dgen.rembg import BackgroundRemover
from hy3dgen.shapegen import Hunyuan3DDiTFlowMatchingPipeline

image_path = 'assets/demo.png' # 这里修改为输入图像路径
image = Image.open(image_path).convert("RGBA")
if image.mode == 'RGB':
    rembg = BackgroundRemover()
    image = rembg(image)

pipeline = Hunyuan3DDiTFlowMatchingPipeline.from_pretrained(
    'weights/Hunyuan3D-2', # 这里修改为调用模型的本地路径
    subfolder='hunyuan3d-dit-v2-0',
    variant='fp16'
)

start_time = time.time()
mesh = pipeline(image=image,
                num_inference_steps=50,
                octree_resolution=380,
                num_chunks=20000,
                generator=torch.manual_seed(12345),
                output_type='trimesh'
                )[0]
print("--- %s seconds ---" % (time.time() - start_time))
mesh.export(f'demo.glb')示例输入图像为我们可爱小鲸鱼的正面靓图:
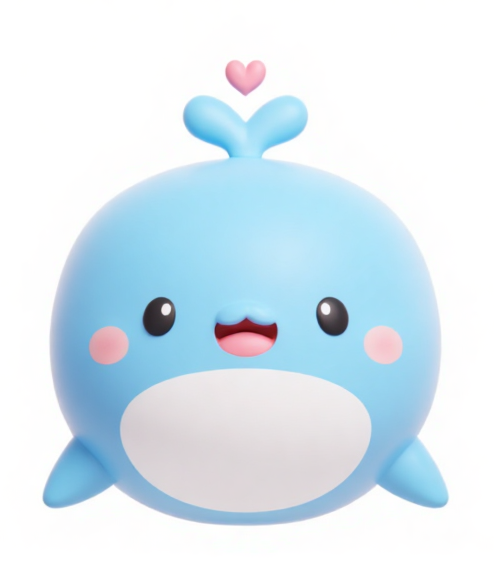
hunyuan3d-dit-v2-0实测默认参数下生成白模输出为27s左右,显存占用约为7GB;hunyuan3d-dit-v2-mni输出为15s左右,显存占用约为4GB
输出的glb文件可以通过在线转换器或Blender进行阅览和使用,可以看到在单图生成下,小鲸鱼的尾巴似乎有点过于“板正”了哈哈

接下来我们以加载模型hunyuan3d-dit-v2-mv为例,输入多视图图像来进行基础白模生成模型Dit的代码调用
同样的,在项目目录下新建代码文件,修改对应路径,粘贴代码后请及时保存文件
import time
import torch
from PIL import Image
from hy3dgen.rembg import BackgroundRemover
from hy3dgen.shapegen import Hunyuan3DDiTFlowMatchingPipeline

images = { # 这里修改为自己的多视图图像输入路径
    "front": "assets/front.png",
    "left": "assets/left.png",
    "back": "assets/back.png"
}

for key in images:
    image = Image.open(images[key]).convert("RGBA")
    if image.mode == 'RGB':
        rembg = BackgroundRemover()
        image = rembg(image)
    images[key] = image

pipeline = Hunyuan3DDiTFlowMatchingPipeline.from_pretrained(
    'weights/Hunyuan3D-2mv', # 这里修改为调用模型的本地路径
    subfolder='hunyuan3d-dit-v2-mv',
    variant='fp16'
)

start_time = time.time()
mesh = pipeline(
    image=images,
    num_inference_steps=50,
    octree_resolution=380,
    num_chunks=20000,
    generator=torch.manual_seed(12345),
    output_type='trimesh'
)[0]
print("--- %s seconds ---" % (time.time() - start_time))
mesh.export(f'demo_mv.glb')示例输入图像为小鲸鱼的三视图:
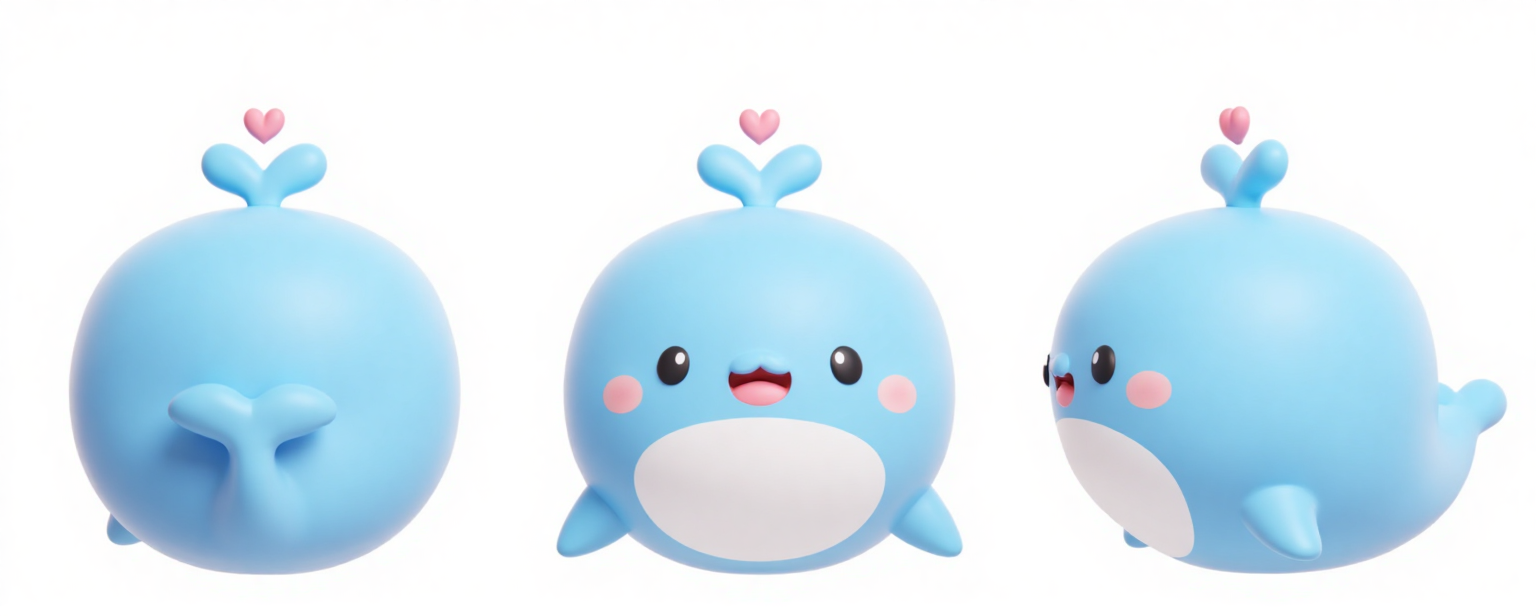
hunyuan3d-dit-v2-mv实测默认参数下输出为36s左右,显存占用约为7GB
同样的,输出的glb文件可以通过在线转换器或Blender进行阅览和使用

通过多视图的输入,小鲸鱼的尾巴可以完整准确的表达出来
现在我们成功生成了基础白模,当然也少不了图像纹理的合成Paint
如果您使用的是指定本地数据盘路径存储模型文件,需要引用的Hunyuan3DPaintPipeline方法代码中去修改指向的路径规则,在项目仓库下:Hunyuan3D-2/hy3dgen/texgen/pipelines.py:55
if not os.path.exists(model_path):
   # try local path
   base_dir = os.environ.get('HY3DGEN_MODELS', '~/autodl-tmp')  # 这里指向为自己模型存放路径的上级目录
   model_path = os.path.expanduser(os.path.join(base_dir, model_path))

   delight_model_path = os.path.join(model_path, 'hunyuan3d-delight-v2-0')
multiview_model_path = os.path.join(model_path, 'hunyuan3d-paint-v2-0')Paint需要在白模生成的基础上加载对应的Paint模型来实现,在本次示例中我们加载hunyuan3d-dit-v2-0来进行白模生成以及hunyuan3d-paint-v2-0进行纹理合成,具体代码如下:
from PIL import Image

from hy3dgen.rembg import BackgroundRemover
from hy3dgen.shapegen import Hunyuan3DDiTFlowMatchingPipeline
from hy3dgen.texgen import Hunyuan3DPaintPipeline

model_path = 'weights/Hunyuan3D-2'# 这里修改为调用模型的本地路径
pipeline_shapegen = Hunyuan3DDiTFlowMatchingPipeline.from_pretrained(model_path)
pipeline_texgen = Hunyuan3DPaintPipeline.from_pretrained(model_path)

image_path = 'assets/demo.png'# 这里修改为自己图像的输入路径
image = Image.open(image_path).convert("RGBA")

if image.mode == 'RGB':
    rembg = BackgroundRemover()
    image = rembg(image)

mesh = pipeline_shapegen(image=image)[0]
mesh = pipeline_texgen(mesh, image=image)
mesh.export('demo_textured.glb')加载hunyuan3d-paint-v2-0的纹理合成模型后,整体显存要求为14GB左右
渲染纹理后我们的小鲸鱼颜色就出来啦,但由于单图输入背部显得黝黑黝黑的,尾巴也被吃掉了!

最后让我们来尝试通过多视图来合成纹理,请输入下式代码
import time

import torch
from PIL import Image

from hy3dgen.rembg import BackgroundRemover
from hy3dgen.shapegen import Hunyuan3DDiTFlowMatchingPipeline
from hy3dgen.texgen import Hunyuan3DPaintPipeline

images = {
    "front": "assets/front.png", # 这里修改为自己的多视图图像输入路径
    "left": "assets/left.png",
    "back": "assets/back.png"
}

for key in images:
    image = Image.open(images[key]).convert("RGBA")
    if image.mode == 'RGB':
        rembg = BackgroundRemover()
        image = rembg(image)
    images[key] = image

pipeline = Hunyuan3DDiTFlowMatchingPipeline.from_pretrained(
    'weights/Hunyuan3D-2mv', # 这里修改为调用模型的本地路径
    subfolder='hunyuan3d-dit-v2-mv',
    variant='fp16'
)
pipeline_texgen = Hunyuan3DPaintPipeline.from_pretrained('weights/Hunyuan3D-2') # 这里修改为调用模型的本地路径

start_time = time.time()
mesh = pipeline(
    image=images,
    num_inference_steps=50,
    octree_resolution=380,
    num_chunks=20000,
    generator=torch.manual_seed(12345),
    output_type='trimesh'
)[0]

mesh = pipeline_texgen(mesh, image=images["front"])
mesh.export('demo_textured_mv.glb')
print("--- %s seconds ---" % (time.time() - start_time))进行多视图输入的纹理合成模型加载后,整体显存要求为18GB左右,且耗时较长,在默认参数下实测需要6min的输出时间

单式图纹理渲染

多视图纹理渲染

Hunyuan3D-2系列Gradio App
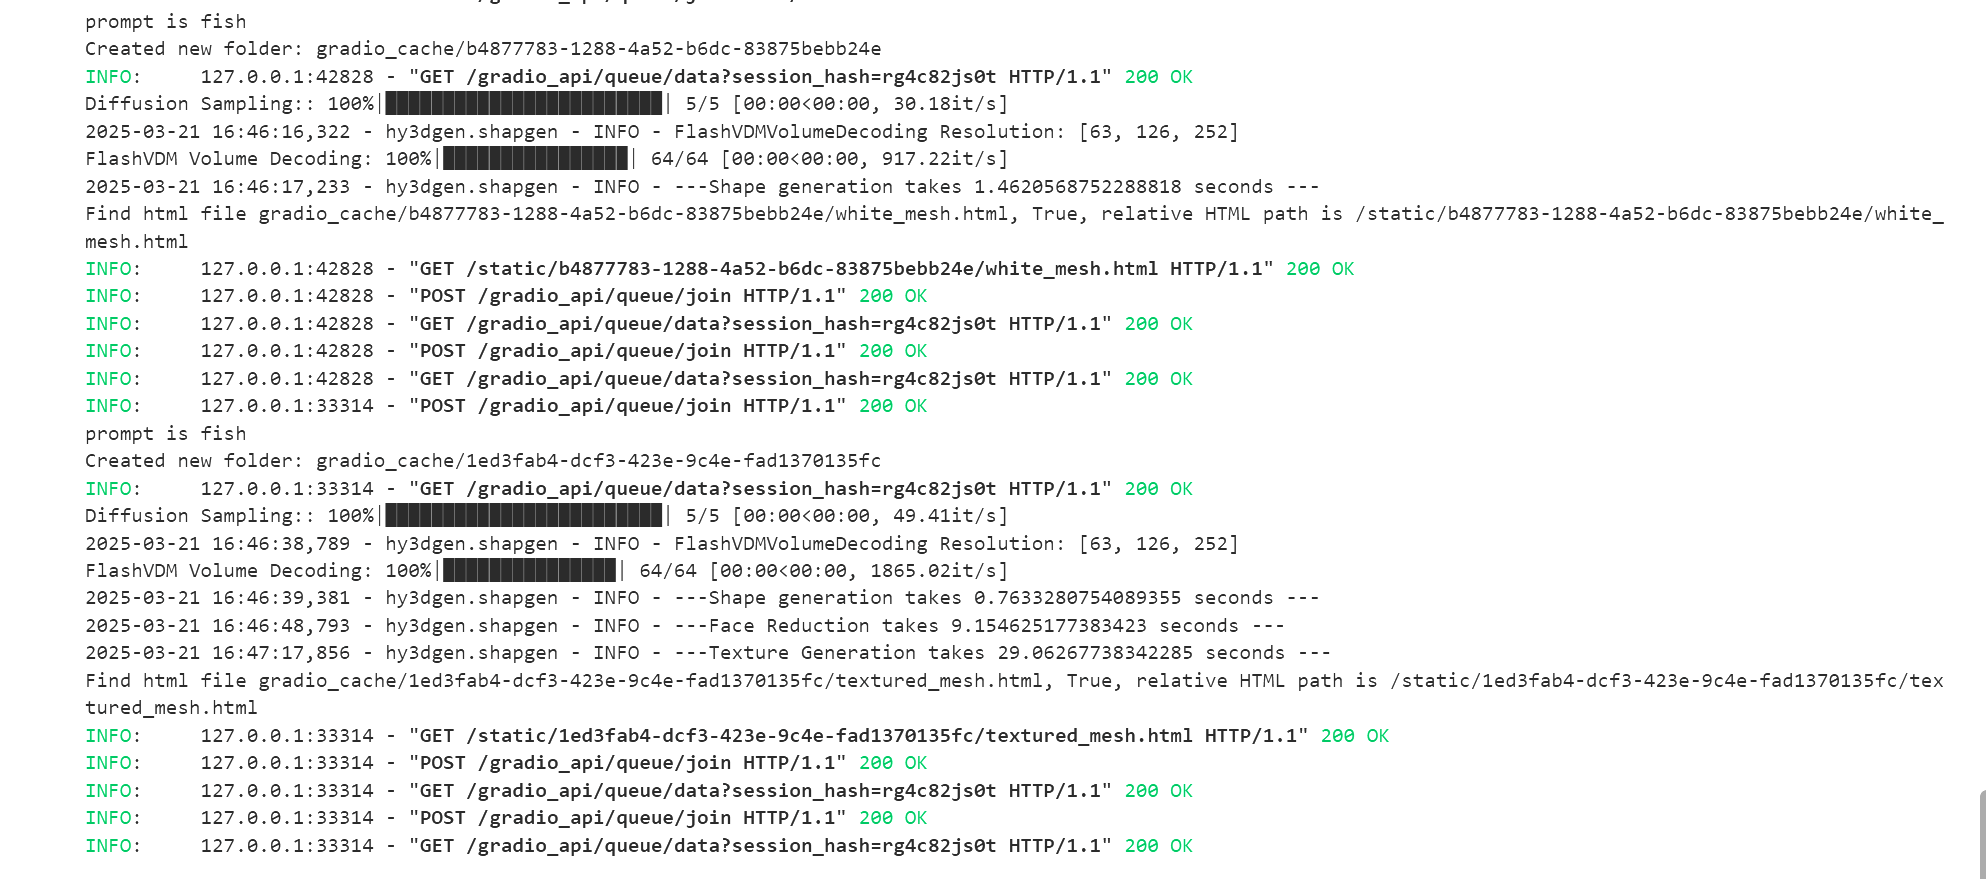
官方也提供了在自己的计算机上托管 Gradio 应用程序的方式代码:
标准版本
# Hunyuan3D-2mini
python3 gradio_app.py --model_path tencent/Hunyuan3D-2mini --subfolder hunyuan3d-dit-v2-mini-turbo --texgen_model_path tencent/Hunyuan3D-2 --low_vram_mode --enable_flashvdm
# Hunyuan3D-2mv
python3 gradio_app.py --model_path tencent/Hunyuan3D-2mv --subfolder hunyuan3d-dit-v2-mv-turbo --texgen_model_path tencent/Hunyuan3D-2 --low_vram_mode --enable_flashvdm
# Hunyuan3D-2
python3 gradio_app.py --model_path tencent/Hunyuan3D-2 --subfolder hunyuan3d-dit-v2-0-turbo --texgen_model_path tencent/Hunyuan3D-2 --low_vram_mode --enable_flashvdmTurbo版本
# Hunyuan3D-2mini
python3 gradio_app.py --model_path tencent/Hunyuan3D-2mini --subfolder hunyuan3d-dit-v2-mini-turbo --texgen_model_path tencent/Hunyuan3D-2 --low_vram_mode --enable_flashvdm
# Hunyuan3D-2mv
python3 gradio_app.py --model_path tencent/Hunyuan3D-2mv --subfolder hunyuan3d-dit-v2-mv-turbo --texgen_model_path tencent/Hunyuan3D-2 --low_vram_mode --enable_flashvdm
# Hunyuan3D-2
python3 gradio_app.py --model_path tencent/Hunyuan3D-2 --subfolder hunyuan3d-dit-v2-0-turbo --texgen_model_path tencent/Hunyuan3D-2 --low_vram_mode --enable_flashvdm需要注意的是,如果是采用指定数据盘存储模型文件的方式进行加载,以下位置需要修改为需要修改为对应的本地路径
’--model_path‘ 以及 ’--texgen_model_path‘
Hunyuan3D-2/gradio.py: 648-650
    if __name__ == '__main__':
        import argparse

        parser = argparse.ArgumentParser()
        parser.add_argument("--model_path", type=str, default='weights/Hunyuan3D-2mini') # 修改为自己的模型文件存储路径
        parser.add_argument("--subfolder", type=str, default='hunyuan3d-dit-v2-mini-turbo')
        parser.add_argument("--texgen_model_path", type=str, default='weights/Hunyuan3D-2') # 修改为自己的模型文件存储路径
        parser.add_argument('--port', type=int, default=8080)
        parser.add_argument('--host', type=str, default='0.0.0.0')
Hunyuan3D-2/hy3dgen/shapegen/pipeline.py:264-266
    turbo_vae_mapping = {
          'Hunyuan3D-2': ('weights/Hunyuan3D-2', 'hunyuan3d-vae-v2-0-turbo'), # 修改为自己的模型文件存储路径
          'Hunyuan3D-2mv': ('weights/Hunyuan3D-2', 'hunyuan3d-vae-v2-0-turbo'), # 修改为自己的模型文件存储路径
          'Hunyuan3D-2mini': ('weights/Hunyuan3D-2mini', 'hunyuan3d-vae-v2-mini-turbo'), # 修改为自己的模型文件存储路径
}启动示例
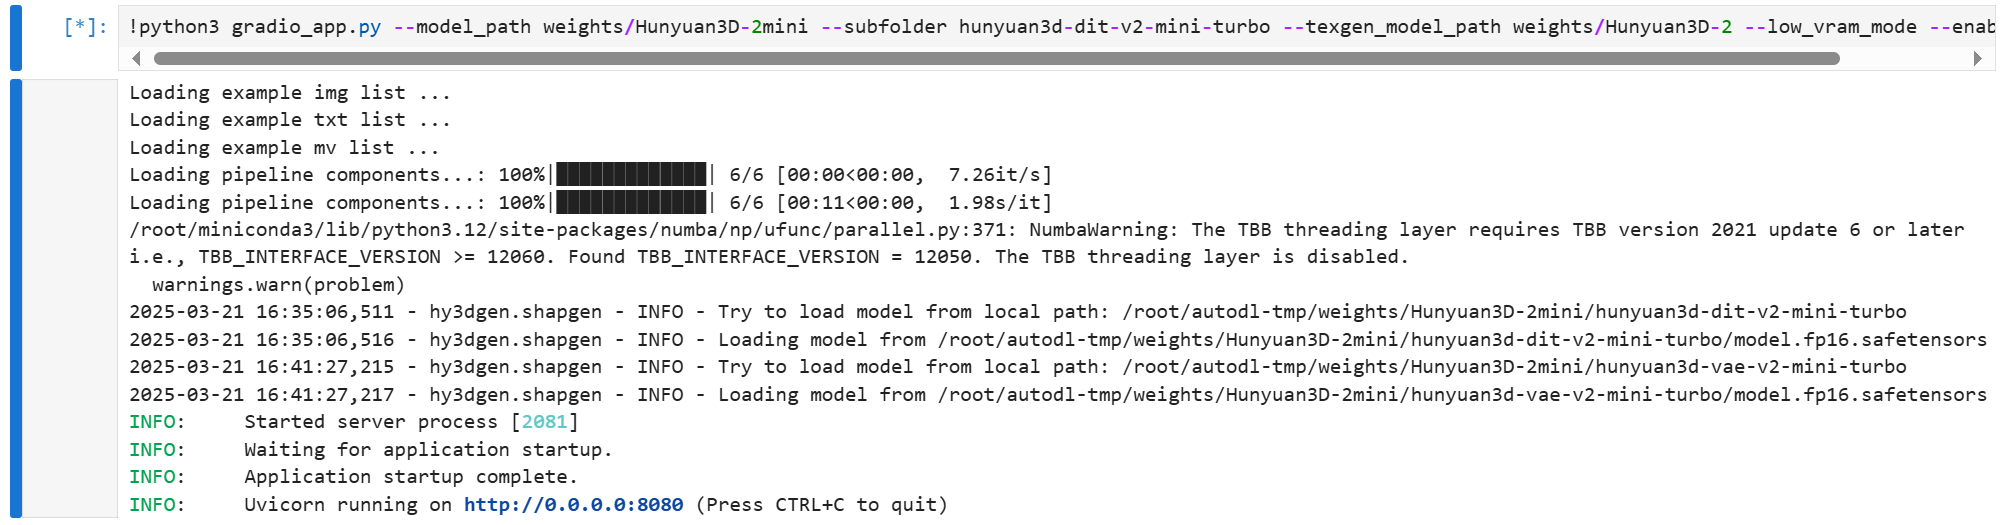
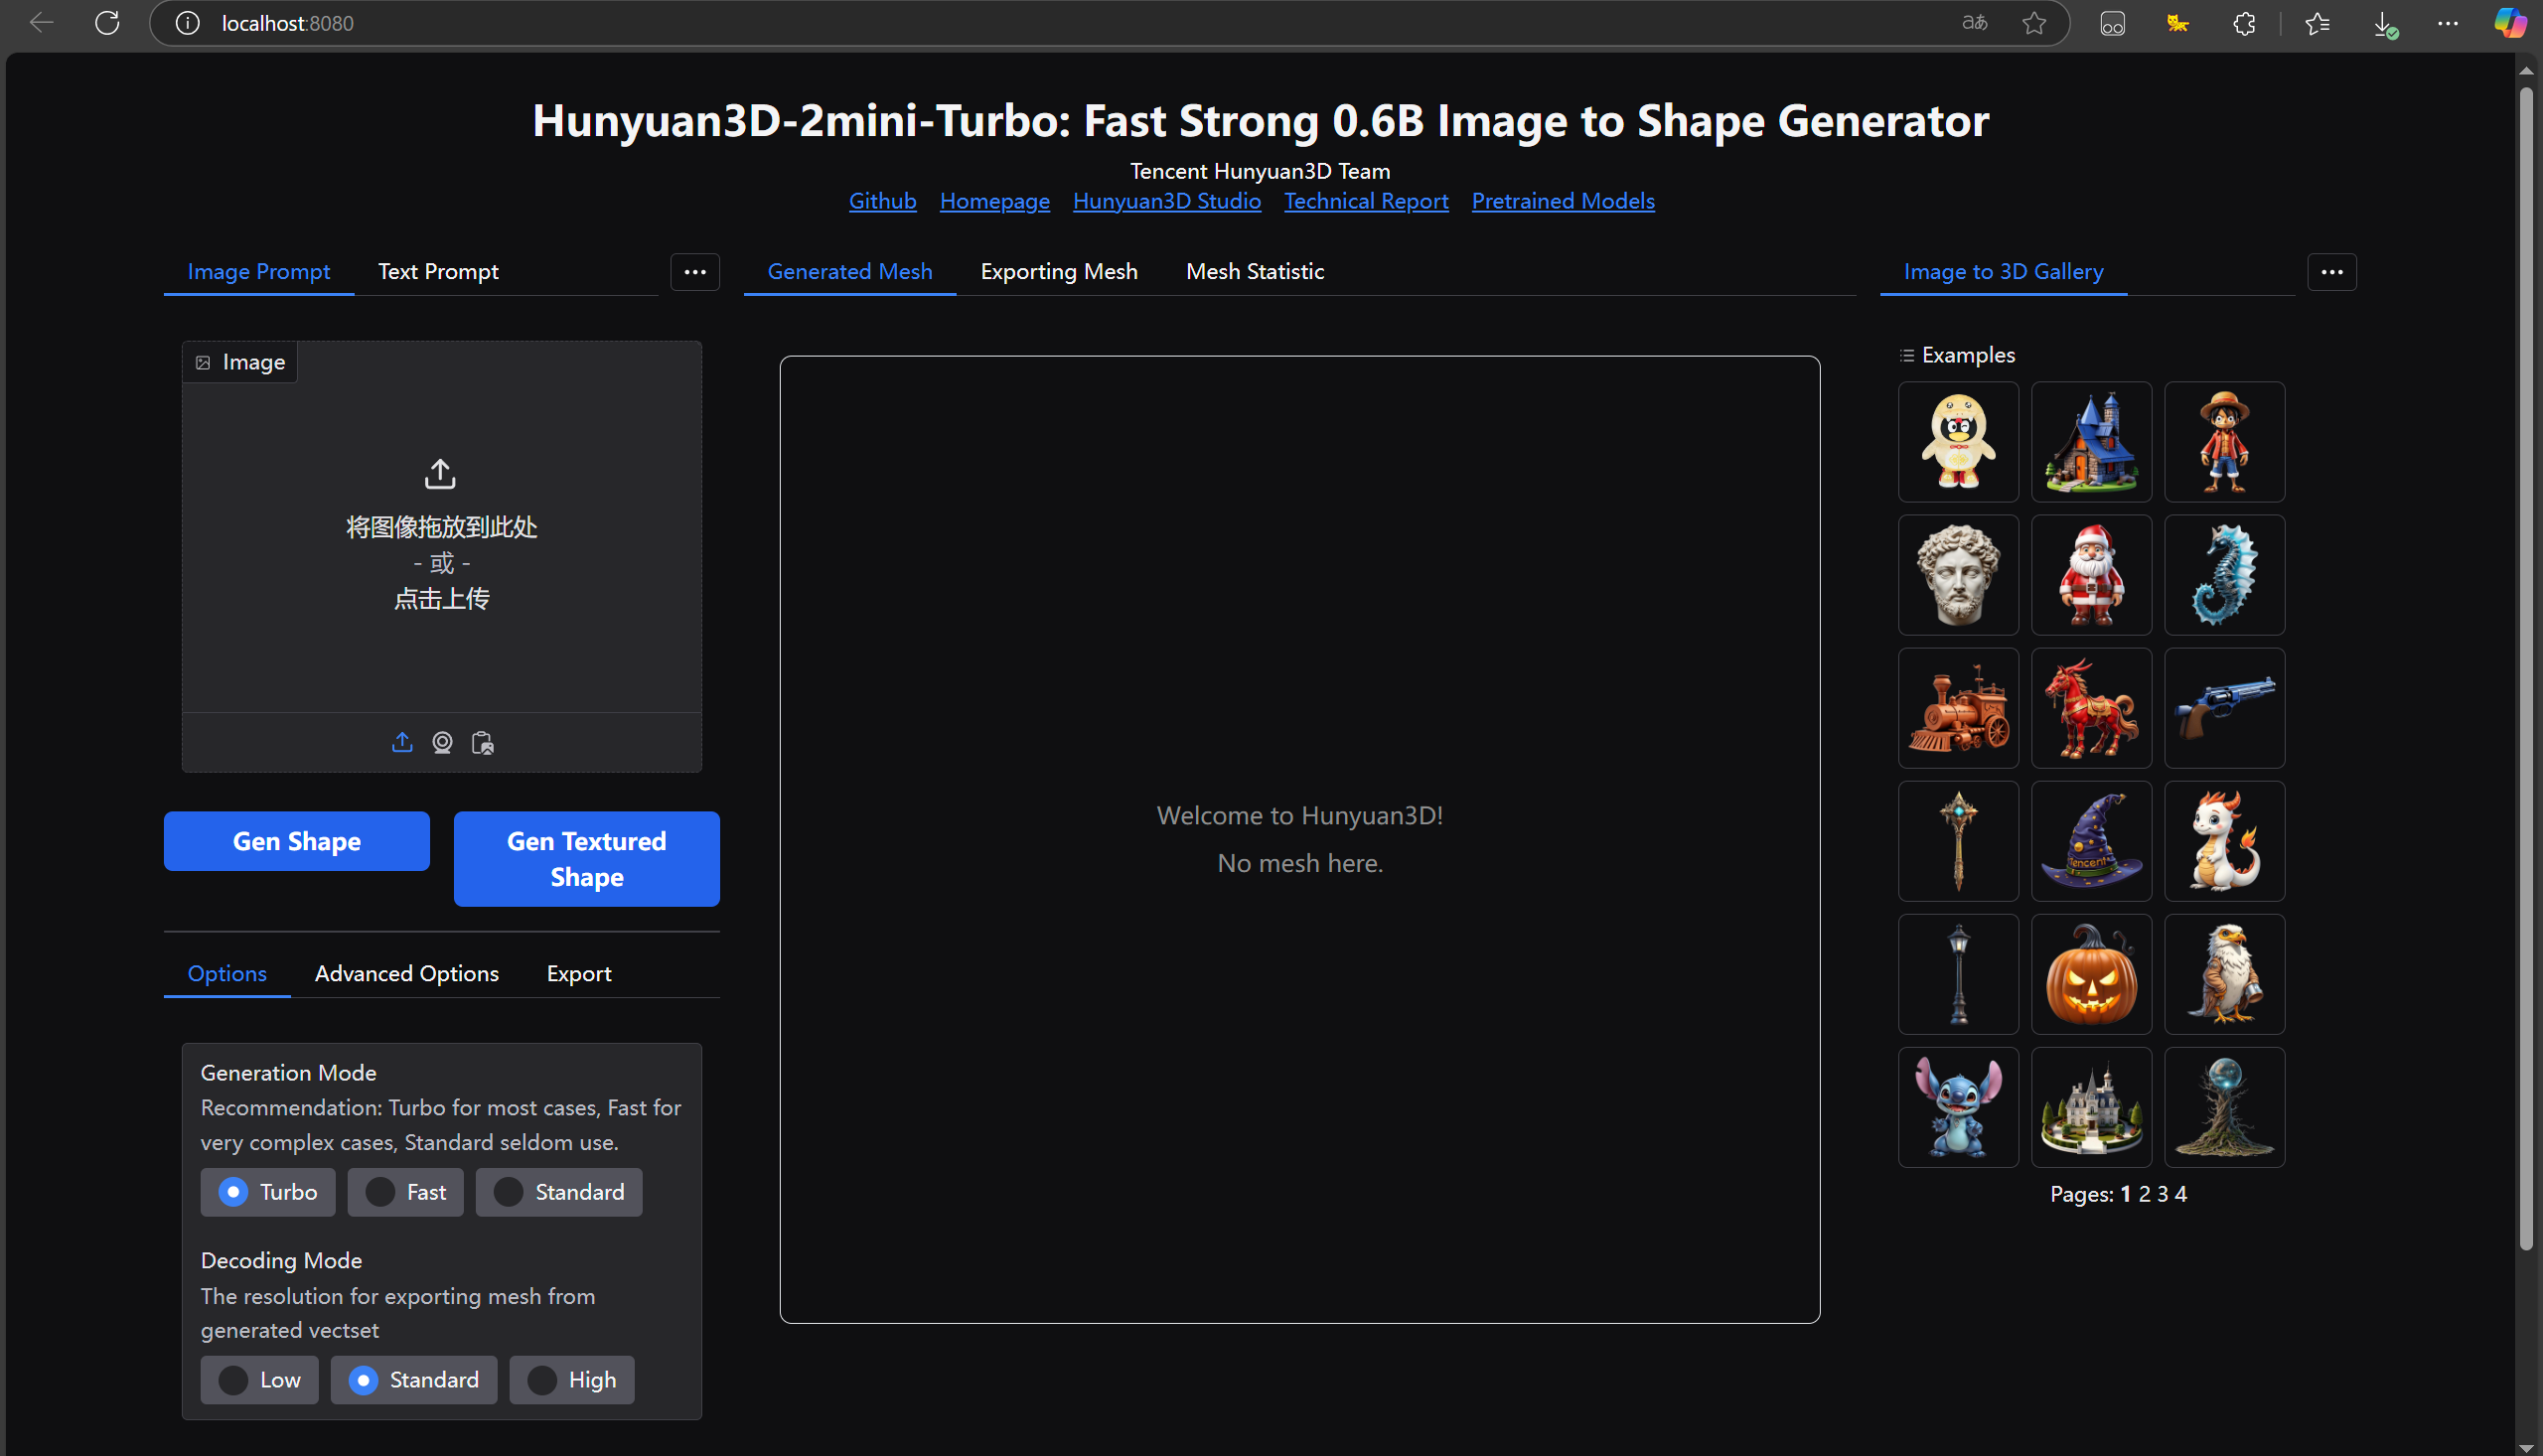
Hunyuan3D-2系列 API Server
Hunyuan3D-2支持在本地启动一个 API 服务器,该服务器可以将图像/文本发布到 3D、纹理化现有网格等的 Web 请求
python3 api_server.py --host 0.0.0.0 --port 8080同样的,如果是采用指定数据盘存储模型文件的方式进行加载,以下位置需要修改为需要修改为对应的本地路径:
Hunyuan3D-2/api_server.py: class ModelWorker: 148-150
        def __init__(self,
                     model_path='weights/Hunyuan3D-2mini',# 修改为自己的模型文件存储路径
                     tex_model_path='weights/Hunyuan3D-2',# 修改为自己的模型文件存储路径
                     subfolder='hunyuan3d-dit-v2-mini-turbo',
                     device='cuda',
enable_tex=False):Hunyuan3D-2/api_server.py: if name == "main": 304-305
    if __name__ == "__main__":
        parser = argparse.ArgumentParser()
        parser.add_argument("--host", type=str, default="0.0.0.0")
        parser.add_argument("--port", type=str, default="8081")
        parser.add_argument("--model_path", type=str, default='weights/Hunyuan3D-2mini')# 修改为自己的模型文件存储路径
        parser.add_argument("--tex_model_path", type=str, default='weights/Hunyuan3D-2')# 修改为自己的模型文件存储路径
        parser.add_argument("--device", type=str, default="cuda")
        parser.add_argument("--limit-model-concurrency", type=int, default=5)
        parser.add_argument('--enable_tex', action='store_true')
        args = parser.parse_args()
        logger.info(f"args: {args}")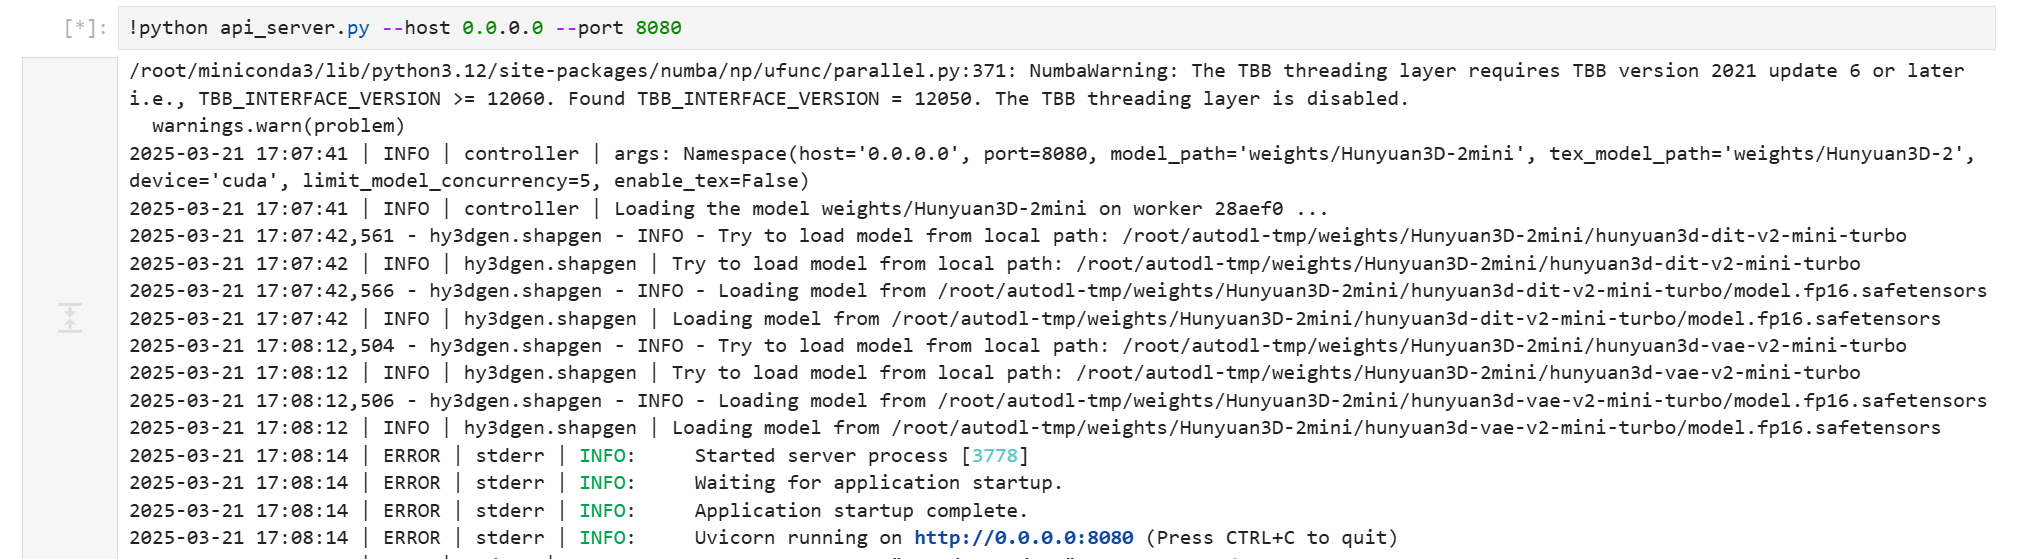
向服务器发送将图像转换为无纹理的3D的请求
# 生成 Base64 字符串
img_b64_str=$(base64 -w 0 input.jpg) # 修改为自己图像输入路径

# 生成 data.json
cat <<EOF > data.json
{
  "image": "$img_b64_str"
}
EOF

# 发送请求并调试
curl -v -X POST "http://localhost:8080/generate" \
     -H "Content-Type: application/json" \
     --data-binary @data.json \
     -o test2.glb # 输出glb文件命名

# 清理临时文件
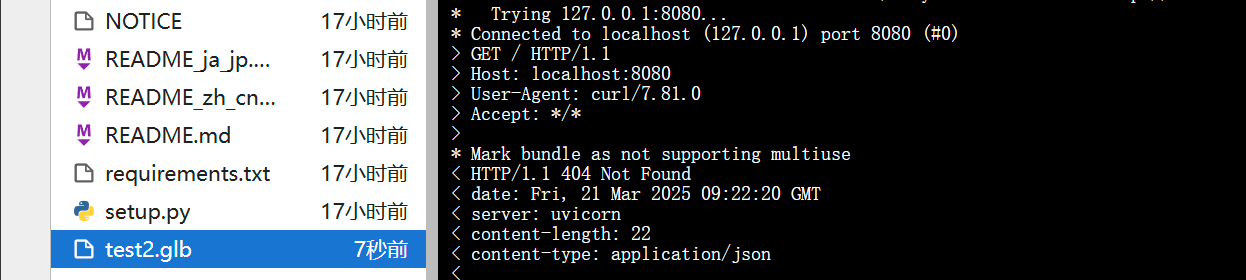
rm data.json可以在项目路径下得到输出的glb文件