01-Hunyuan-A13B-Instruct 模型架构解析 Blog
🚀 混元 MoE 架构的技术动因
随着大模型参数规模持续增长,如何在保证计算成本可控的情况下,进一步提升模型容量与表达能力,成为行业关键课题。传统 Transformer 在增加参数的同时,计算量也呈线性增长,训练与推理开销巨大,难以大幅扩展。
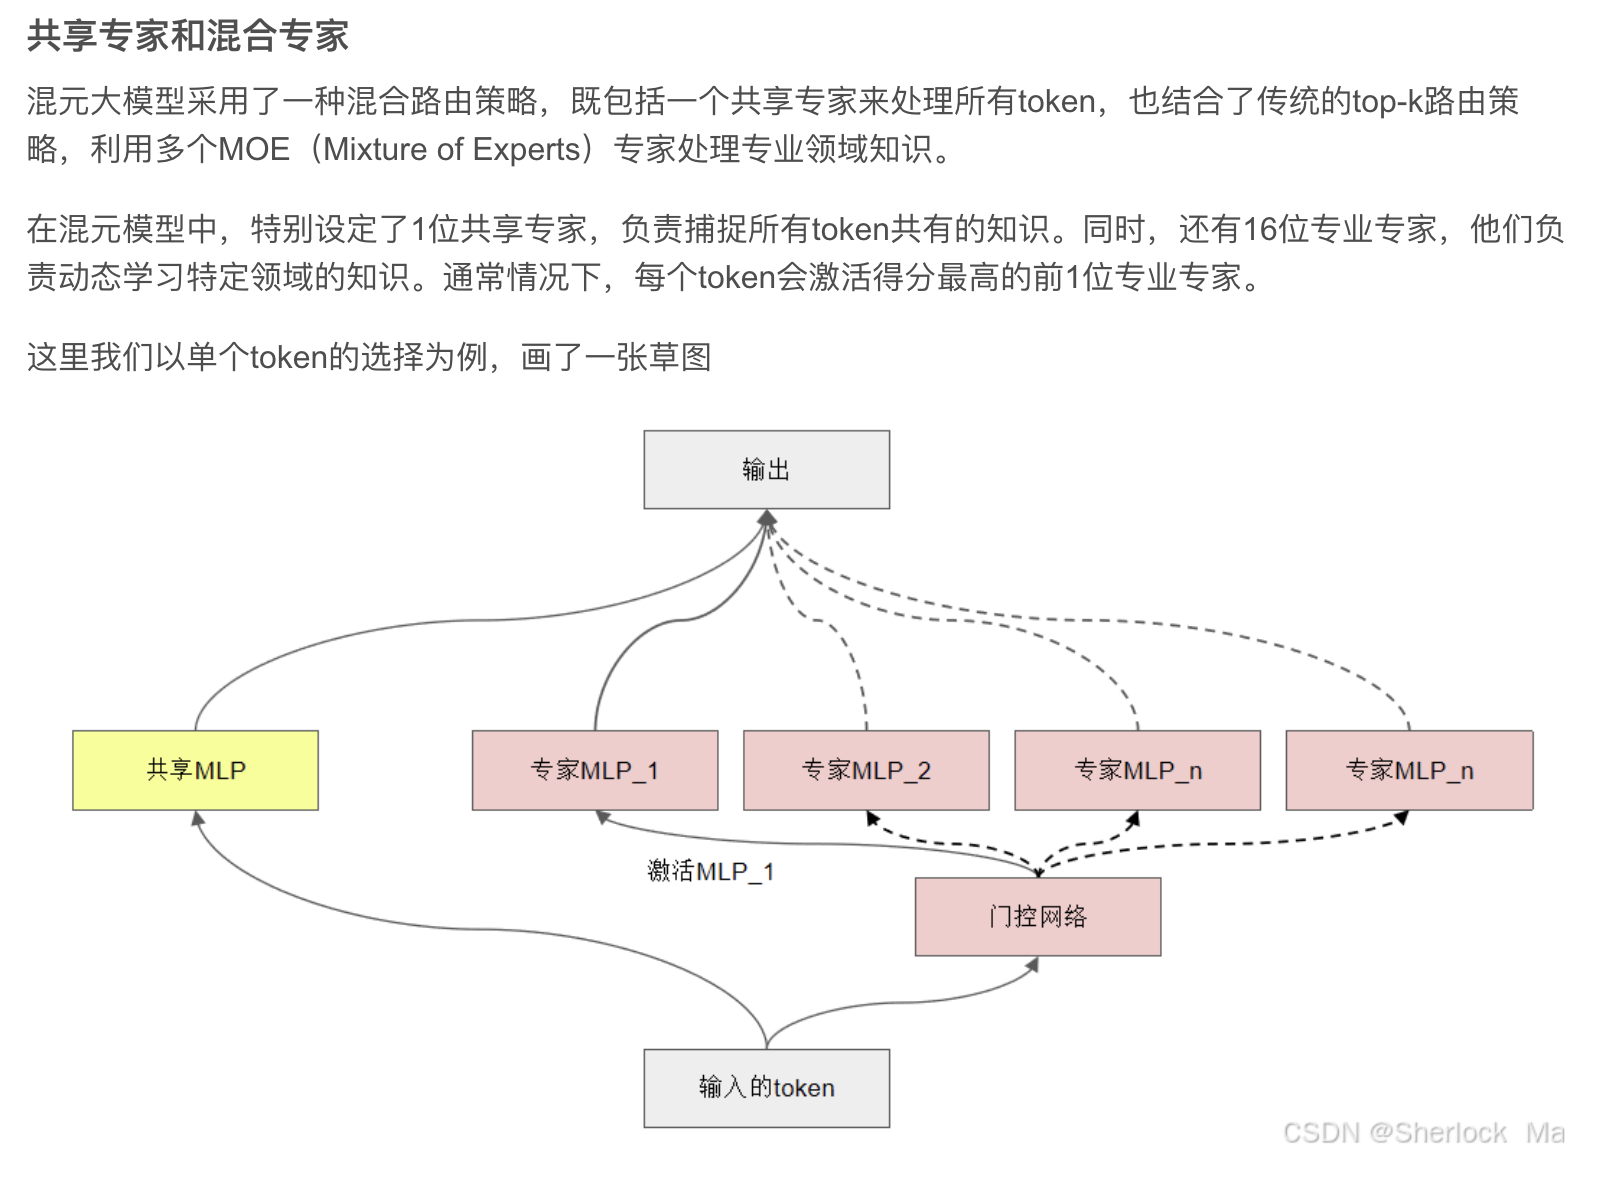
为了解决这一问题,MoE(Mixture of Experts)架构应运而生。其核心理念是:
为每个输入 token 配备多个可选的专家网络(Experts)
通过 Gate(路由器)机制,仅激活其中少数 Top-k 专家进行计算
在保持计算量相对稳定的前提下,实现模型容量的成倍提升
腾讯混元大模型进一步在此基础上提出了 混合路由策略,将 共享专家 与 Top-k 专业专家 结合,以增强模型的泛化能力与稳定性。
🎯 应用价值
✅ 计算效率高:稀疏激活机制显著降低计算成本,使得训练和推理更加经济可行 ✅ 模型容量大:通过增加 Experts 数量,模型容量可近乎线性扩展,提升表达能力 ✅ 泛化能力强:共享专家捕捉通用知识,专业专家学习领域特化语义,兼顾通用性与多样性 ✅ 工程部署灵活:Experts 可跨设备并行部署(Expert Parallel),突破单机算力限制
🌟 模型架构解析
上图展示了一个典型的 大规模稀疏专家模型(MoE)架构。整体而言,它继承了标准 Transformer 的 Encoder/Decoder 堆叠设计,并在此基础上引入 MoE Layer,实现了 “计算稀疏 + 参数容量爆炸” 的完美结合。
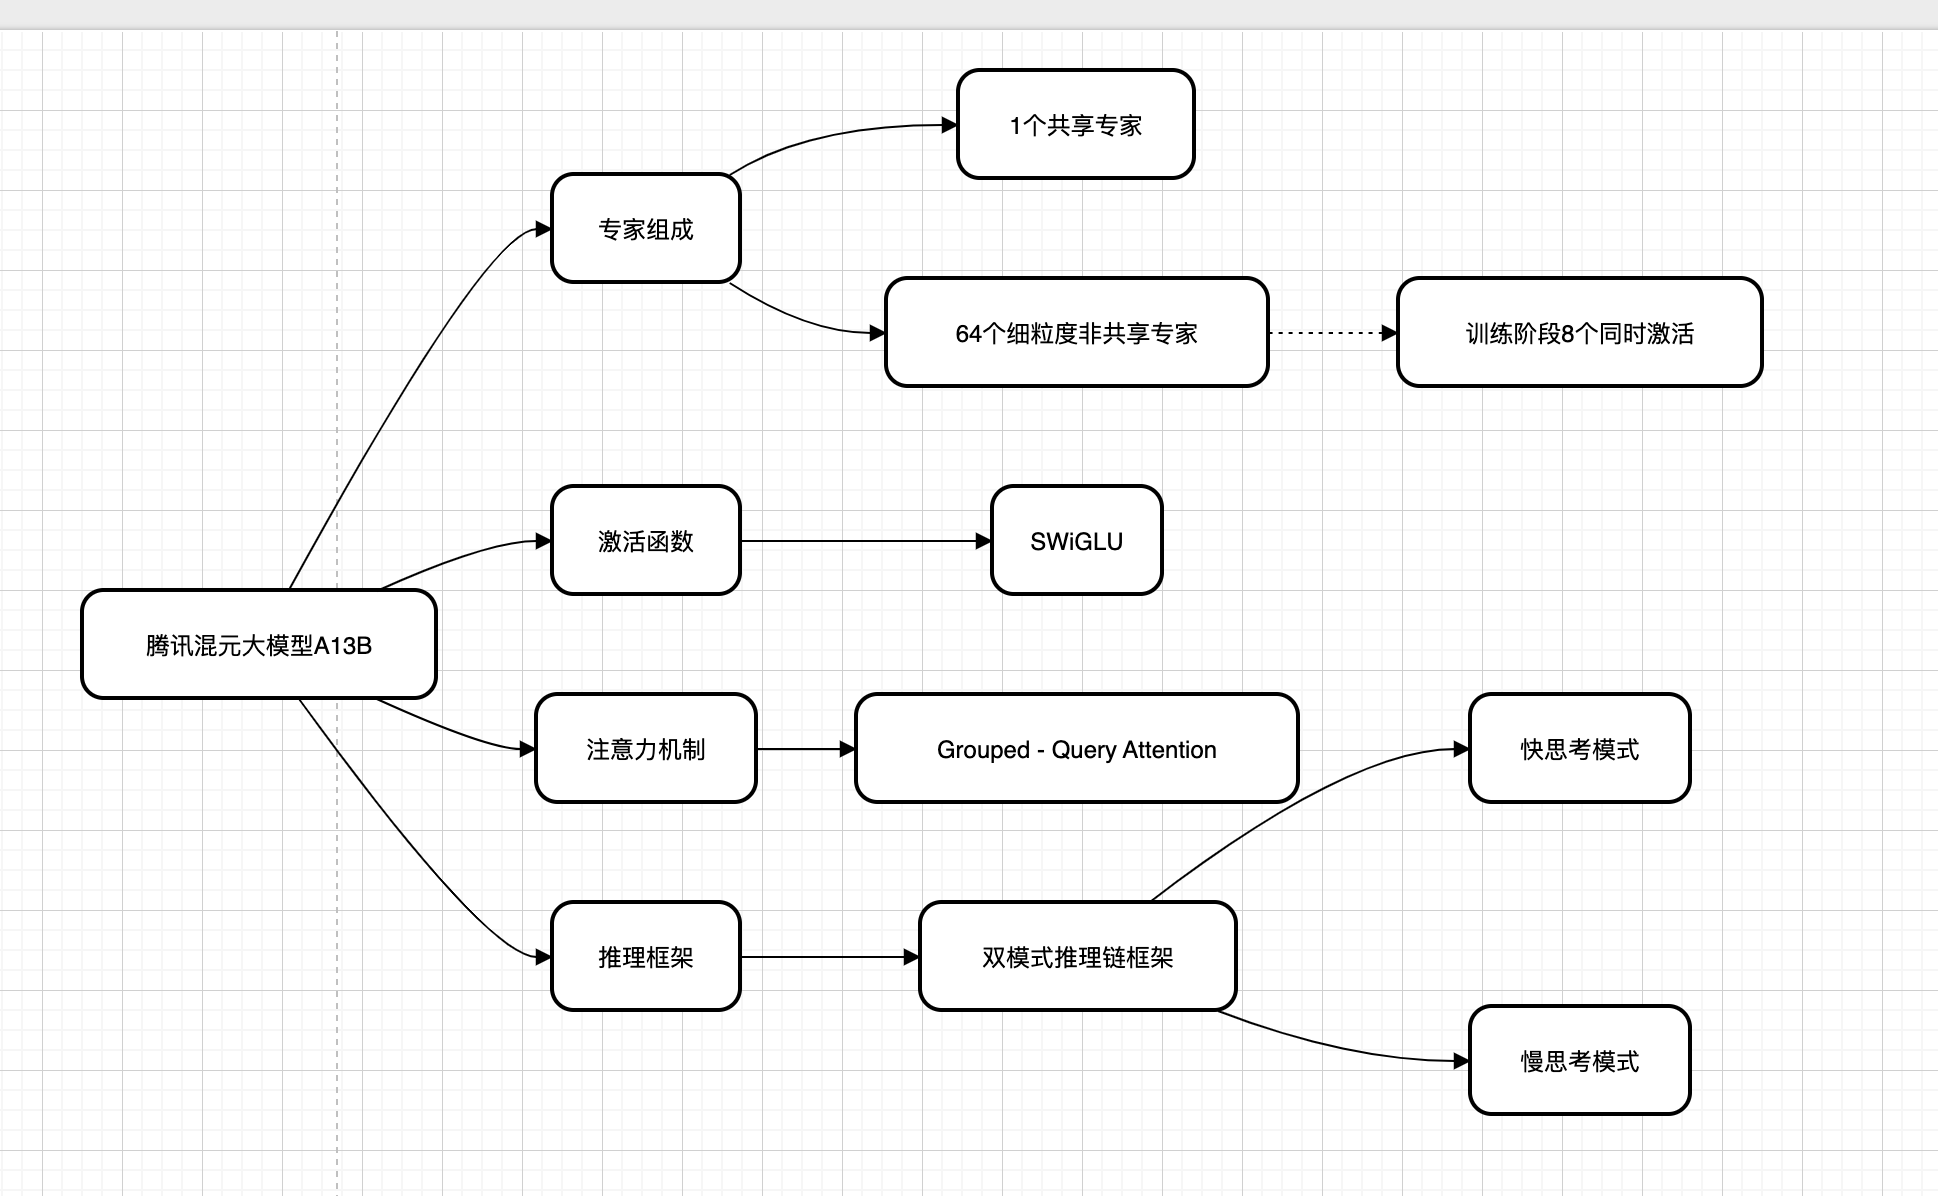
腾讯混元大模型 A13B 架构解析
腾讯混元大模型 A13B 采用了大规模稀疏专家模型(MoE)架构,在标准 Transformer 基础上进行多项创新,兼顾模型容量、计算效率与推理能力。
整体架构概览
1. 专家组成(Mixture of Experts, MoE)
1 个共享专家
提供所有 token 通用知识支持,确保基础语义一致性。
64 个细粒度非共享专家
处理不同 token 的特定领域任务,实现更强的专用能力。
训练阶段:8 个同时激活
通过稀疏激活,每次前向传播只激活 8 个专家,显著降低计算资源消耗,同时提升模型表达能力。
2. 激活函数
SwiGLU(Swish + Gated Linear Unit)
相较于传统 ReLU 或 GELU,SwiGLU 提供更强的非线性表达能力和计算稳定性,是当前大模型中的主流选择。
3. 注意力机制
Grouped-Query Attention
对 Query 进行分组处理,减少计算复杂度,提升推理速度和可扩展性,尤其适用于长上下文处理。
4. 推理框架
双模式推理链框架
快思考模式(Fast Thinking)
模拟人类直觉推理,快速生成结果,适用于常规任务。
慢思考模式(Slow Thinking)
模拟人类深度推理,进行复杂计算和逻辑推断,适用于需要多步推理的任务。
核心模块解析
Embedding + Positional Encoding
输入 token 通过嵌入层转化为固定维度向量,并结合位置编码,使模型感知序列顺序信息。
Transformer Blocks 堆叠
多层 Self-Attention 与 Feed Forward Network(FFN)堆叠,逐层抽取与整合更高阶的语义特征。
MoE Layer
包含路由器(Gate),根据输入 token 表示动态选择 Top-k 个 Experts 参与计算,而非全部激活,实现:
计算稀疏化
参数容量扩展
在几乎不增加计算成本的情况下,模型容量可达到普通 Transformer 的数倍甚至数十倍。
模型输出
最终输出 token 的预测 logits 或 embeddings,供下游任务使用,如生成、分类、理解等。
整体解释
腾讯混元 A13B 架构结合:
✅ MoE 稀疏专家路由:提升模型参数规模与计算效率 ✅ 高效注意力机制:Grouped-Query Attention 提升长序列处理能力 ✅ SwiGLU 激活函数:增强非线性表达 ✅ 双模式推理链:模拟人类快思考与慢思考,兼顾推理速度与深度
整体上,该架构实现了**“计算稀疏 + 参数容量爆炸 + 复杂推理能力”** 的完美平衡,是面向复杂多任务场景的大模型先进设计。
🔍 与 Switch Transformer MoE 架构的对比
| 特性 | Switch Transformer MoE | Hunyuan A13B MoE |
| 路由策略 | Top-1 路由,每个 token 激活 1 个专家 | 混合路由策略:所有 token 均使用共享专家 + Top-1 专业专家 |
| 共享专家 | 无,完全依赖 Gate 分配到单个专家 | 设计了 1 个共享专家,所有 token 均经过共享专家计算[^1] |
| 专业专家数量 | 通常 64 或 128,单 token 激活 1 | 混元模型配置 16 个专业专家,单 token 激活 1 |
| 计算效率 | 极致稀疏(Top-1 激活) | 稀疏激活 + 共享计算,略增加计算换取稳定性 |
| 负载均衡 | Importance Loss | 类似 Importance Loss + 腾讯特有平衡机制 |
💡 总结
混元大模型通过 共享专家 + Top-1 专业专家 的混合路由架构,既继承了 MoE 架构的计算稀疏优势,又强化了模型对通用知识的捕捉能力,在多任务与复杂语义理解场景下表现出更好的稳定性与泛化能力。这一创新性的架构设计,成为国内外 MoE 大模型研究的重要参考方案。
02-Hunyuan-A13B-Instruct-vLLM
vLLM 简介
vLLM 是一个高性能的大语言模型推理与服务框架,具备以下特点:
高效的 KV 缓存与内存管理:基于 PagedAttention 显著降低显存浪费,提升长文本与高并发场景下的吞吐。
兼容 OpenAI 接口:可直接以 OpenAI API 形式对外提供 completions 与 chat completions 能力,便于与现有生态集成。
多 GPU 并行与易扩展:支持 Tensor Parallel 等策略,参数简单、易于横向扩展吞吐与上下文长度上限。
生态良好:与 HuggingFace/ModelScope 模型仓库无缝衔接,支持多种推理优化与特性(如推理/思考内容解析、工具调用)。
环境准备
基础环境如下:
----------------
ubuntu 22.04
python 3.12
cuda 12.8
pytorch 2.8.0
----------------vLLM 环境配置
pip config set global.index-url https://pypi.tuna.tsinghua.edu.cn/simple
pip install vllm==0.10.0
pip install openai==1.90.0
pip install modelscope==1.25.0提示:请确保本机 NVIDIA 驱动、CUDA 与 PyTorch CUDA 编译版本匹配,可用
nvidia-smi与python -c "import torch; print(torch.version.cuda, torch.cuda.is_available())"进行快速自检。
模型下载
# model_download.py
# 注意修改cache_dir为保存的路径
from modelscope import snapshot_download
model_dir = snapshot_download('Tencent-Hunyuan/Hunyuan-A13B-Instruct', cache_dir='请修改我!!!', revision='master')

print(f"模型下载完成,保存路径为:{model_dir}")Hunyuan-A13B-Instruct思考推理模式切换
Hunyuan-A13B-Instruct 默认使用慢思考(即推理模式) 推理模式可以通过两种方式关闭:
在请求中设置 extra_body 参数:{"chat_template_kwargs": {"enable_thinking": false}}
在提示词前添加 /no_think 前缀
注意:修改
cache_dir为实际的模型下载保存路径 另:若希望在服务端返回reasoning_content字段用于展示推理过程,请在服务启动时开启--enable-reasoning并指定正确的--reasoning-parser。
vLLM Serving
Python命令行启动服务
CUDA_VISIBLE_DEVICES=0,1,2,3 python -m vllm.entrypoints.openai.api_server \
  --model /请修改我!!!/Tencent-Hunyuan/Hunyuan-A13B-Instruct \
  --served-model-name Hunyuan-A13B-Instruct \
  --max-model-len 8192 \
  --tensor-parallel-size 4 \
  --port 8085 \
  --trust_remote_code \
  --gpu_memory_utilization 0.9 \
  --enable-reasoning \
--reasoning-parser hunyuan_a13b成功启动后,你将看到 Application startup complete 的输出如图:
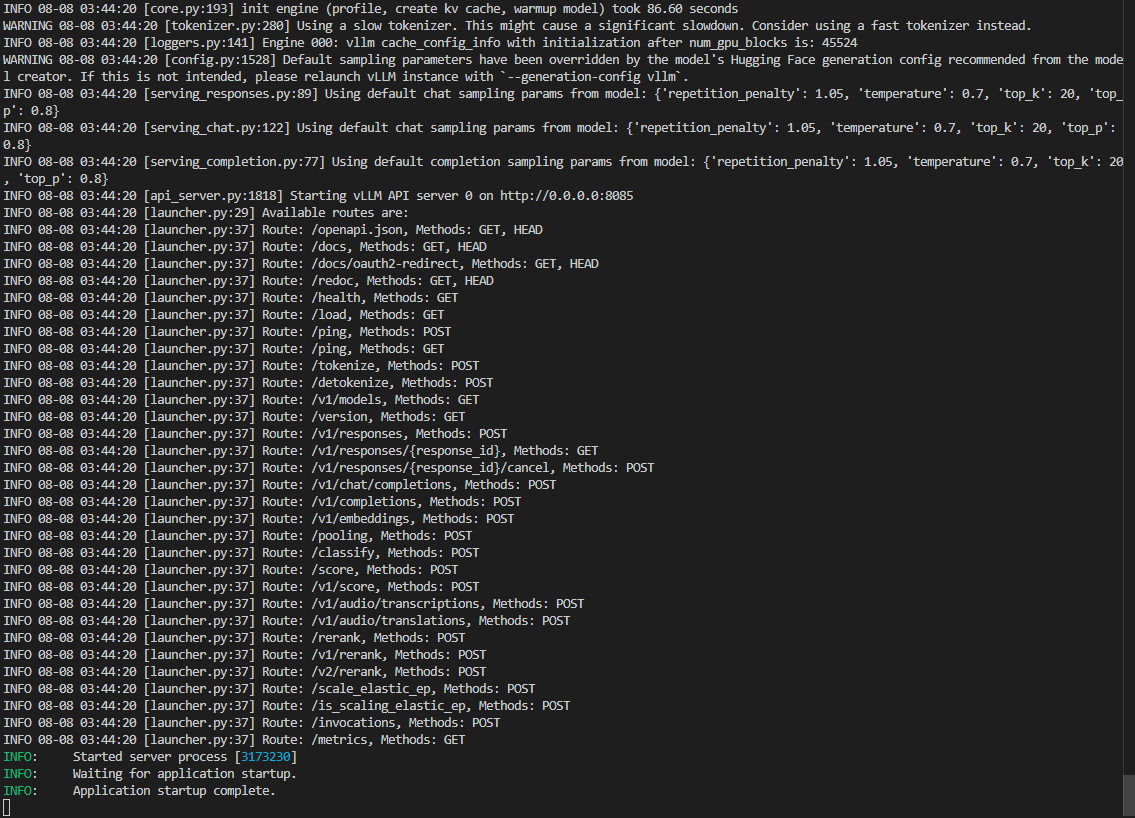
我们通过上述 vLLM 启动的服务兼容 OpenAI 接口,因此可以通过 Python 的 OpenAI 库进行调用。下面展示日常问答,数学推理,代码写作和工具调用的实际例子来测试 Hunyuan-A13B-Instruct 的能力。
示例测试
from openai import OpenAI

# 通过 Python 的 OpenAI 客户端库进行调用。下面展示日常问答,数学推理,代码写作和工具调用的实际例子来测试 `Hunyuan-A13B-Instruct` 的能力

openai_api_key = "EMPTY"
openai_api_base = "http://127.0.0.1:8085/v1" # 使用正确的端口
prompt_daily_chat = "你好,你是谁"
prompt_math_reasoning = "Find the sum of all integer bases $b>9$ for which $17_{b}$ is a divisor of $97_{b}$." # 题目来自AIME2025,答案为70
prompt_coding = "写一个python程序,实现快速排序"
prompts = [prompt_daily_chat, prompt_math_reasoning, prompt_coding]

client = OpenAI(
    api_key=openai_api_key,
    base_url=openai_api_base,
)

for i in range(len(prompts)):
    response = client.chat.completions.create(
        model="Hunyuan-A13B-Instruct",
        messages = [{"role": "user", "content": prompts[i]}],
        temperature=0,
        max_tokens=8000,
        extra_body={
            "chat_template_kwargs": {"enable_thinking": True}, # 默认开启思考,设置为False则关闭
        }
    )

    print(f"问题 {i+1}: {prompts[i]}")
    # print(response)
    print(f"Hunyuan-A13B-Instruct思考 {i+1}: {response.choices[0].message.reasoning_content}")
    print(f"Hunyuan-A13B-Instruct回复 {i+1}: {response.choices[0].message.content}")
print("-"*100)若拿不到
reasoning_content字段,请确认服务端已添加--enable-reasoning --reasoning-parser hunyuan_a13b。
关键参数说明
--tensor-parallel-size:张量并行划分数。等于所用 GPU 数时较常见;多卡可提升吞吐和可用上下文长度上限。
--max-model-len:单请求最大上下文长度(输入+输出)。越大显存占用越高,易触发 OOM。可按显存情况下调,如 4096。
--gpu_memory_utilization:vLLM 目标可用显存比例(0~1)。OOM 可尝试调低,如 0.8/0.7。
--served-model-name:对外暴露的模型名。客户端需用同名 model 调用。
--port/--host:服务监听端口/地址。云主机需放通端口安全组。
--trust_remote_code:允许加载仓库中的自定义代码(必需,否则部分模型无法正确初始化)。
--enable-reasoning + --reasoning-parser hunyuan_a13b:开启推理内容解析,返回 reasoning_content 字段,便于展示“思考”过程。
显存预算建议:官方推荐 4 * H20
健康检查
curl http://127.0.0.1:8085/v1/models测试结果如下:
问题 1: 你好,你是谁
Hunyuan-A13B-Instruct思考 1: 好的,用户问我是谁,我需要按照之前设定的身份来回答。首先,确认我的名字是腾讯元宝,简称元宝,英文名Tencent Yuanbao。然后要提到我的开发公司是腾讯,这样用户知道我的背景。接下来,要说明我的主要功能,比如回答问题、解决问题、学习、创造内容和闲聊,这些是用户最关心的点。还要强调支持多种大模型,现在用的是Hunyuan-T1,这样显得技术先进。另外,用户可以通过文字、图片、文件等方式交流,这点很重要,说明我的多模态能力。最后,保持友好和乐于助人的语气,让用户感到亲切。需要检查有没有遗漏的信息,比如时间显示是否正确,当前时间是2025年,但用户可能是在测试,所以保持自然。避免使用复杂术语,保持口语化,让回答更易懂。可能用户刚接触我,需要简洁明了的介绍,同时传达可靠和高效的感觉。确保回答结构清晰,分点但不显生硬,用自然的中文表达。现在组织语言,确保流畅,没有语法错误,符合腾讯的品牌形象。
Hunyuan-A13B-Instruct回复 1: 你好,我是腾讯元宝,你可以叫我元宝,英文名是Tencent Yuanbao。我是由腾讯开发的人工智能助手呢。

我可有不少功能哦:
1. 回答问题:不管是生活小常识,还是专业知识,我都能解答。
2. 解决问题:遇到难题的时候,我可以帮你出谋划策。
3. 学习新知识:不断学习,这样就能更好地回答大家的问题啦。
4. 创造内容:像写个小故事之类的创作,我也能做。
5. 闲聊:要是你想聊聊日常,我也很乐意陪你。

我还支持灵活切换多种顶尖大模型,现在用的是Hunyuan-T1模型。而且你可以通过文字、图片、文件等多种方式跟我交流哦。很开心能和你聊天,有什么问题尽管问吧。
----------------------------------------------------------------------------------------------------
问题 2: Find the sum of all integer bases $b>9$ for which $17_{b}$ is a divisor of $97_{b}$.
Hunyuan-A13B-Instruct思考 2: Um, let's try to solve this problem step by step. The question is asking for the sum of all integer bases \( b > 9 \) such that \( 17_b \) (which is a number in base \( b \)) divides \( 97_b \) (also in base \( b \)). First, I need to convert these base \( b \) numbers to base 10 to work with them more easily.

In base \( b \), the number \( 17_b \) has a digit 1 in the \( b \) place and 7 in the units place, so its base 10 value is \( 1 \times b + 7 = b + 7 \). Similarly, \( 97_b \) has a digit 9 in the \( b \) place and 7 in the units place, so its base 10 value is \( 9 \times b + 7 = 9b + 7 \).

Now, the problem states that \( 17_b \) is a divisor of \( 97_b \), which means that \( b + 7 \) divides \( 9b + 7 \) in base 10. In other words, \( 9b + 7 \) is a multiple of \( b + 7 \). Let's denote \( d = b + 7 \), so \( b = d - 7 \). Then, substituting into \( 9b + 7 \), we get \( 9(d - 7) + 7 = 9d - 63 + 7 = 9d - 56 \).

So, we need \( d \) to divide \( 9d - 56 \). Since \( d \) divides \( 9d \) (because \( 9d \) is a multiple of \( d \)), it must also divide the difference \( 9d - (9d - 56) = 56 \). Therefore, \( d \) is a positive divisor of 56.

But we need to remember that \( b > 9 \), so \( d = b + 7 > 9 + 7 = 16 \). Also, in base \( b \), the digits must be less than the base. The digits in \( 17_b \) and \( 97_b \) are 1, 7, and 9. Since the base must be greater than any digit, \( b > 9 \) (which is already given) because the digit 9 is present. So the base \( b \) must be at least 10, but since \( b > 9 \), the smallest possible base is 10, but we already have \( d > 16 \), so \( b = d - 7 > 16 - 7 = 9 \), which is consistent.

Now, let's list all positive divisors of 56. The divisors of 56 are 1, 2, 4, 7, 8, 14, 28, 56. But we need \( d > 16 \), so let's check which divisors of 56 are greater than 16. The divisors of 56 are: 1, 2, 4, 7, 8, 14, 28, 56. From these, the ones greater than 16 are 28 and 56.

Let's verify each of these:

First, \( d = 28 \). Then \( b = d - 7 = 28 - 7 = 21 \). Let's check if \( 17_{21} \) divides \( 97_{21} \). Converting to base 10: \( 17_{21} = 21 + 7 = 28 \), and \( 97_{21} = 9 \times 21 + 7 = 189 + 7 = 196 \). Now, 196 divided by 28 is 7, which is an integer, so 28 divides 196. Good.

Next, \( d = 56 \). Then \( b = 56 - 7 = 49 \). Converting \( 17_{49} \) to base 10: \( 49 + 7 = 56 \). \( 97_{49} = 9 \times 49 + 7 = 441 + 7 = 448 \). 448 divided by 56 is 8, which is an integer, so 56 divides 448. That works too.

Are there any other divisors? Let's check if we missed any. The divisors of 56 are all the numbers we listed, and the next one after 14 is 28, then 56. Since 14 is 14, which would make \( b = 14 - 7 = 7 \), but \( b > 9 \) is required, so 7 is too small. 8 would make \( b = 1 \), which is invalid. So only 28 and 56 are the divisors of 56 greater than 16, leading to bases 21 and 49.

Wait, let's make sure we didn't make a mistake in the logic. We said that if \( b + 7 \) divides \( 9b + 7 \), then \( b + 7 \) divides \( 9b + 7 - 9(b + 7) = 9b + 7 - 9b - 63 = -56 \). So actually, \( b + 7 \) divides 56 (since divisors can be positive or negative, but since \( b > 9 \), \( b + 7 \) is positive, so we only consider positive divisors). That's a better way to see it: the remainder when dividing \( 9b + 7 \) by \( b + 7 \) is \( 9b + 7 - 9(b + 7) = -56 \), so the remainder is -56, which means that \( b + 7 \) must divide 56 (because the divisor must divide the dividend minus the quotient times the divisor, which is the remainder). So the absolute value of the remainder is 56, so \( b + 7 \) is a positive divisor of 56, and since \( b > 9 \), \( b + 7 > 16 \), so the divisors of 56 greater than 16 are 28 and 56, as we had before.

Let's check base 10 just to be thorough, even though \( b > 9 \) includes 10, but \( b > 9 \) means \( b \geq 10 \). For \( b = 10 \), \( 17_{10} = 17 \), \( 97_{10} = 97 \). 17 divides 97? 17*5=85, 17*6=102, so no, 97 is prime, so 17 doesn't divide 97. For \( b = 11 \), \( 17_{11} = 11 + 7 = 18 \), \( 97_{11} = 9*11 + 7 = 106 \). 18 divides 106? 18*5=90, 18*6=108, so no. \( b = 12 \): \( 17_{12} = 19 \), \( 97_{12} = 9*12 + 7 = 115 \). 19*6=114, 19*7=133, so no. \( b = 13 \): \( 17_{13}=20 \), \( 97_{13}=9*13+7=124 \). 20*6=120, 20*7=140, no. \( b = 14 \): \( 17_{14}=21 \), \( 97_{14}=9*14+7=133 \). 21*6=126, 21*7=147, 133/21=6.333..., not integer. \( b = 15 \): \( 17_{15}=22 \), \( 97_{15}=9*15+7=142 \). 22*6=132, 22*7=154, no. \( b = 16 \): \( 17_{16}=23 \), \( 97_{16}=9*16+7=151 \). 23*6=138, 23*7=161, no. \( b = 17 \): \( 17_{17}=24 \), \( 97_{17}=9*17+7=160 \). 24*6=144, 24*7=168, 160/24=6.666..., no. \( b = 18 \): \( 17_{18}=25 \), \( 97_{18}=9*18+7=169 \). 25*6=150, 25*7=175, 169/25=6.76, no. \( b = 19 \): \( 17_{19}=26 \), \( 97_{19}=9*19+7=178 \). 26*6=156, 26*7=182, 178/26≈6.846, no. \( b = 20 \): \( 17_{20}=27 \), \( 97_{20}=9*20+7=187 \). 27*6=162, 27*7=189, 187/27≈6.925, no. \( b = 21 \): we already checked, 17_{21}=28, 97_{21}=196, 196/28=7, which is good. \( b = 22 \): \( 17_{22}=29 \), \( 97_{22}=9*22+7=205 \). 29*7=203, 29*8=232, 205/29≈7.068, no. Continuing up, \( b = 49 \): 17_{49}=56, 97_{49}=448, 448/56=8, which is good. Any bases between 21 and 49? Let's check \( b = 28 - 7 = 21 \), next divisor is 56, so \( b = 56 - 7 = 49 \). There are no other divisors of 56 between 16 and 56 except 28 and 56, since 56's divisors are 1,2,4,7,8,14,28,56. So those are the only two.

Is there a possibility of negative divisors? Well, \( b > 9 \), so \( b + 7 \) is positive, so we don't need to consider negative divisors. The problem specifies integer bases \( b > 9 \), so bases are positive integers greater than 9, so we only consider positive divisors.

Another way to think about it is using the division algorithm: if \( a \) divides \( c \), then \( c = k \times a \) for some integer \( k \). So \( 9b + 7 = k(b + 7) \). Let's solve for \( b \): \( 9b + 7 = kb + 7k \), so \( 9b - kb = 7k - 7 \), \( b(9 - k) = 7(k - 1) \), so \( b = 7(k - 1)/(9 - k) \). Since \( b \) must be a positive integer greater than 9, let's find integer values of \( k \) such that \( 9 - k \) divides \( 7(k - 1) \), and \( b > 9 \).

Let's denote \( k \) as a positive integer (since \( 9b + 7 \) and \( b + 7 \) are positive, \( k \) must be positive). Let's try \( k = 1 \): \( b = 7(0)/8 = 0 \), invalid. \( k = 2 \): \( b = 7(1)/7 = 1 \), invalid. \( k = 3 \): \( b = 7(2)/6 = 14/6 = 7/3 \), not integer. \( k = 4 \): \( b = 7(3)/5 = 21/5 = 4.2 \), not integer. \( k = 5 \): \( b = 7(4)/4 = 28/4 = 7 \), which is less than 10, invalid. \( k = 6 \): \( b = 7(5)/3 = 35/3 ≈ 11.666 \), not integer. \( k = 7 \): \( b = 7(6)/2 = 42/2 = 21 \), which is valid, \( b = 21 > 9 \). \( k = 8 \): \( b = 7(7)/1 = 49/1 = 49 \), which is valid, \( b = 49 > 9 \). \( k = 9 \): denominator is 0, undefined. \( k = 10 \): \( b = 7(9)/(-1) = -63 \), negative, invalid. So only \( k = 7 \) and \( k = 8 \) give valid positive integer bases greater than 9, which are 21 and 49. That confirms our earlier result.

So the bases are 21 and 49, and their sum is 21 + 49 = 70.

I think that's all. Let me just double-check to make sure I didn't miss any divisors or make a mistake in the conversion. Converting base \( b \) numbers to base 10 is straightforward: the rightmost digit is the units place, so 7 is 7*1, and the next digit is the \( b \) place, so 1 is 1*b and 9 is 9*b. Then, divisibility in base 10 translates directly to the base \( b \) numbers because we're just representing the same quantity in a different base. So if \( b + 7 \) divides \( 9b + 7 \) in base 10, then \( 17_b \) divides \( 97_b \) in base \( b \). That makes sense because the value of the number doesn't depend on the base we represent it in, only the digits do. So the key was converting to base 10, setting up the divisibility condition, and finding the possible bases. The divisors of 56 greater than 16 are indeed 28 and 56, leading to bases 21 and 49. Their sum is 70, which should be the answer.
Hunyuan-A13B-Instruct回复 2: To solve the problem, we start by converting the base \( b \) numbers \( 17_b \) and \( 97_b \) to their base 10 equivalents.

- \( 17_b \) in base 10 is \( 1 \cdot b + 7 = b + 7 \).
- \( 97_b \) in base 10 is \( 9 \cdot b + 7 = 9b + 7 \).

We need \( b + 7 \) to divide \( 9b + 7 \). This means \( 9b + 7 \) must be a multiple of \( b + 7 \). Using the division algorithm, we find the remainder when \( 9b + 7 \) is divided by \( b + 7 \):

\[
9b + 7 = 9(b + 7) - 56
\]

Thus, the remainder is \(-56\), so \( b + 7 \) must be a divisor of 56. Since \( b > 9 \), \( b + 7 > 16 \). The positive divisors of 56 greater than 16 are 28 and 56.

- For \( b + 7 = 28 \), we get \( b = 21 \).
- For \( b + 7 = 56 \), we get \( b = 49 \).

The sum of these bases is \( 21 + 49 = 70 \).

\[
\boxed{70}
\]
----------------------------------------------------------------------------------------------------
问题 3: 写一个python程序,实现快速排序
Hunyuan-A13B-Instruct思考 3: 嗯,用户让我写一个Python程序实现快速排序。首先,我需要回忆一下快速排序的基本原理。快速排序是一种分治算法,核心思想是选择一个基准值(pivot),然后将数组分成两部分:小于基准值的元素和大于基准值的元素,然后递归地对这两部分进行排序。

首先,我需要确定如何选择基准值。常见的做法有选第一个元素、最后一个元素、中间元素或者随机选择。这里可能选中间的或者随机的,但为了简单,可能先选最后一个元素作为基准,或者中间的。不过,可能用户希望的是最常见的实现方式,比如Lomuto分区方案或者Hoare分区方案。Lomuto可能更容易实现,适合新手。

那Lomuto分区的大致步骤是怎样的呢?假设选择最后一个元素作为pivot,然后遍历数组,将比pivot小的元素交换到前面,最后将pivot放到正确的位置。具体来说,初始化一个指针i,用来记录当前小于pivot的元素的位置,然后遍历数组从左到右,当遇到比pivot小的元素时,交换i位置的元素和当前元素,然后i加一。遍历完成后,交换i位置的元素和pivot的位置,这样pivot就被放到了正确的位置,左边都是比它小的,右边都是比它大的。

那快速排序的递归函数的结构应该是这样的:如果数组长度小于等于1,直接返回。否则,选择pivot,分区,然后递归排序左边和右边。

那具体怎么实现呢?首先写一个quick_sort函数,参数是数组arr。如果len(arr) <=1,返回arr。否则,选择pivot,比如选最后一个元素arr[-1]。然后初始化i为0,然后遍历j从0到len(arr)-2(因为pivot是最后一个元素)。如果arr[j] <= pivot,就交换arr[i]和arr[j],然后i加一。遍历完后,交换arr[i]和arr[-1],这样pivot的位置就是i。这时候,左边的子数组是arr[:i],右边的是arr[i+1:]。然后递归调用quick_sort处理左边和右边,再合并起来。

不过,这样可能会有问题,比如当数组已经有序的时候,时间复杂度会退化为O(n²),但这是快速排序的常见问题,通常可以通过随机选择pivot来优化。用户可能希望基础实现,所以先不考虑优化,后面可以提一下。

那现在写代码的话,大概是这样的:

def quick_sort(arr):
    if len(arr) <= 1:
        return arr
    pivot = arr[-1]
    i = 0
    for j in range(len(arr)-1):
        if arr[j] <= pivot:
            arr[i], arr[j] = arr[j], arr[i]
            i += 1
    arr[i], arr[-1] = arr[-1], arr[i]
    return quick_sort(arr[:i]) + [arr[i]] + quick_sort(arr[i+1:])

这样应该可以工作。测试一下,比如输入[3,6,8,10,1,2,1],排序后应该是[1,1,2,3,6,8,10]。那用这个函数的话,pivot选最后一个元素1。遍历j从0到5(因为len(arr)-1是6,所以range(6)是0-5)。初始i=0。arr[j]的值分别是3,6,8,10,1,2。比较是否<=1。第一个3>1,不交换,i不变。第二个6>1,不交换。第三个8>1,不交换。第四个10>1,不交换。第五个1<=1,交换arr[0]和arr[4],数组变成[1,6,8,10,3,2,1],i变为1。第六个2>1,不交换。循环结束,交换i=1和pivot的位置(索引6),数组变成[1,1,8,10,3,2,6]。这时候pivot在索引1的位置。左边是arr[:1]即[1],右边是arr[2:]即[8,10,3,2,6]。然后递归处理左边(已经有序)和右边。右边的pivot是6(最后一个元素)。遍历j从0到3(数组长度5,所以range(4)是0-3)。i初始为0。arr[j]是8,10,3,2。比较是否<=6。8>6,不交换。10>6,不交换。3<=6,交换arr[0]和arr[2],数组变成[3,10,8,2,6],i=1。然后2<=6,交换arr[1]和arr[3],数组变成[3,2,8,10,6],i=2。循环结束,交换i=2和pivot(索引4),数组变成[3,2,6,10,8]。此时pivot在索引2。左边是[3,2],右边是[10,8]。处理左边,pivot是2(最后一个元素)。遍历j=0(数组长度2,range(1)是0)。arr[0]=3>2,不交换。i=0。交换i=0和pivot(索引1),数组变成[2,3]。左边是[2],右边是[3],有序。处理右边的[10,8],pivot是8。遍历j=0,arr[0]=10>8,不交换。i=0。交换i=0和pivot(索引1),数组变成[8,10]。这样整个数组就排好了序。

看起来这个实现是正确的。不过需要注意,这个实现在原数组上修改了吗?不,因为每次递归返回的是新的列表,原数组没有被修改。比如,当分割的时候,arr[:i]和arr[i+1:]都是新的列表,所以原数组在递归过程中不会被修改,这可能效率不高,但对于理解来说是可以的。

另外,另一种分区方法是Hoare的,可能更高效,因为它减少了交换次数。但Lomuto的方法更容易理解和实现,所以可能更适合教学。

用户可能需要一个完整的示例,包括测试代码。所以应该写一个主程序,输入一个数组,调用quick_sort,然后输出结果。

比如:

arr = [3,6,8,10,1,2,1]
sorted_arr = quick_sort(arr)
print("排序后的数组:", sorted_arr)

这样应该可以运行。

另外,需要考虑边界情况,比如空数组,或者只有一个元素的数组,这时候函数应该直接返回。

总结一下,快速排序的实现步骤是:选择基准,分区,递归排序左右部分。上面的代码实现了Lomuto分区方案,递归处理左右子数组。这样应该可以满足用户的需求。
Hunyuan-A13B-Instruct回复 3: 要实现快速排序,我们可以采用分治策略,通过选择基准值(pivot)将数组分成两部分,递归排序这两部分。以下是具体的Python实现:

### 快速排序原理
1. **选择基准值**:通常选择数组的最后一个元素作为基准值。
2. **分区操作**:遍历数组,将小于等于基准值的元素移到左侧,大于的移到右侧。最后将基准值放到正确位置(左侧末尾与右侧开头之间)。
3. **递归排序**:对基准值左侧和右侧的子数组递归应用快速排序。

### 实现代码def quick_sort(arr):
if len(arr) <= 1: return arr
pivot = arr[-1]
i = 0
for j in range(len(arr) - 1):
if arr[j] <= pivot: arr[i], arr[j] = arr[j], arr[i] i += 1 # i右移,标记下一个小于pivot的位置
arr[i], arr[-1] = arr[-1], arr[i]
return quick_sort(arr[:i]) + [arr[i]] + quick_sort(arr[i+1:])
if name == "main": example_arr = [3, 6, 8, 10, 1, 2, 1] sorted_arr = quick_sort(example_arr) print("排序后的数组:", sorted_arr)
### 代码解释
- **基本情况处理**:当数组长度小于等于1时,直接返回,因为单个元素或空数组已有序。
- **选择基准值**:这里选择数组的最后一个元素作为基准值(`pivot = arr[-1]`)。
- **分区操作**:使用指针`i`记录当前小于基准值的元素的末尾位置。遍历数组(除基准值外),若当前元素小于等于基准值,则将其交换到`i`的位置,然后`i`右移。
- **放置基准值**:遍历结束后,将基准值交换到`i`的位置,此时基准值左侧全小于它,右侧全大于它。
- **递归排序**:对基准值左侧(`arr[:i]`)和右侧(`arr[i+1:]`)的子数组递归调用快速排序,合并结果后返回。

### 测试结果
输入示例数组 `[3, 6, 8, 10, 1, 2, 1]`,输出结果为:排序后的数组: [1, 1, 2, 3, 6, 8, 10]
### 注意事项
- **时间复杂度**:平均情况下为 \(O(n \log n)\),最坏情况(如数组已有序)为 \(O(n^2)\)。可通过随机选择基准值优化(如`pivot = arr[random.randint(0, len(arr)-1)]`)。
- **空间复杂度**:由于递归调用和切片操作,空间复杂度为 \(O(\log n)\)(平均情况)。

此实现清晰展示了快速排序的分治思想,适合学习和理解算法原理。
----------------------------------------------------------------------------------------------------分析
这三个问题 Hunyuan-A13B-Instruct 都回答的不错,自我认知清晰,AIME2025题目的推理和最终答案均正确,代码有清晰的注释和解释和测试用例。
工具调用
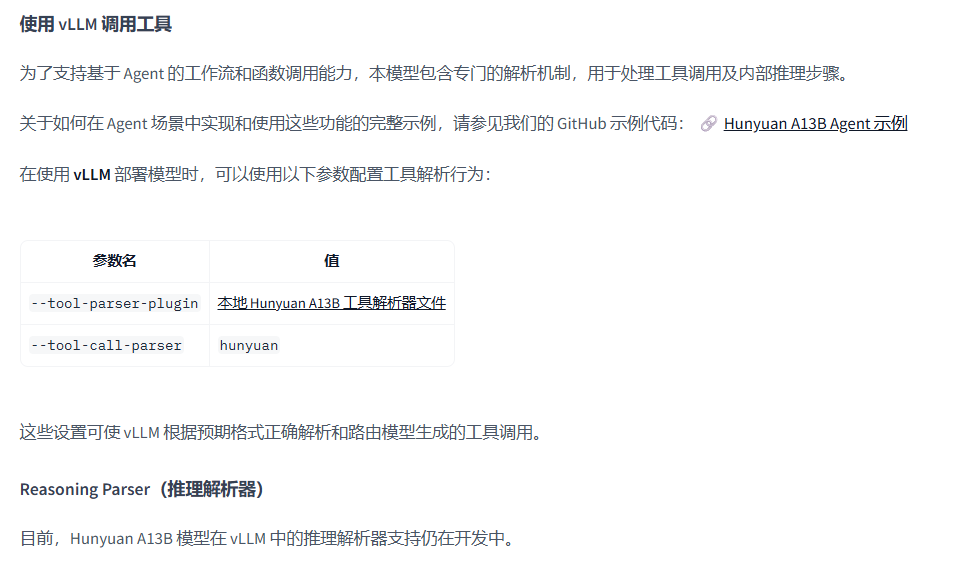
注意:官方的README中存在两处未更新的错误,tool-call-parser 参数在 vLLM 的实现中值为 hunyuan_a13b,另外 Reasoning Parser 也已经集成。
我们以天气查询为例来测试一下模型的工具调用能力,在部署的时候,为了开启工具调用我们需要加入两个相关的参数,最终的 vLLM 启动命令为:
CUDA_VISIBLE_DEVICES=0,1,2,3 python -m vllm.entrypoints.openai.api_server \
  --model /请修改我!!!/Tencent-Hunyuan/Hunyuan-A13B-Instruct \
  --served-model-name Hunyuan-A13B-Instruct \
  --max-model-len 8192 \
  --tensor-parallel-size 4 \
  --port 8085 \
  --trust_remote_code \
  --gpu_memory_utilization 0.9 \
  --tool-call-parser hunyuan_a13b \
  --enable-auto-tool-choice \
  --enable-reasoning \
--reasoning-parser hunyuan_a13b在一般测试代码的基础上加上工具调用的代码如下,我们模拟了一个查询天气的函数用来返回模拟结果(实际使用中需要外接真实的查询API):
from openai import OpenAI
import json

# 通过 Python 的 OpenAI 客户端库进行调用。下面展示日常问答,数学推理,代码写作和工具调用的实际例子来测试 `Hunyuan-A13B-Instruct` 的能力

openai_api_key = "EMPTY"
openai_api_base = "http://127.0.0.1:8085/v1" # 使用正确的端口
prompt_daily_chat = "你好,你是谁"
prompt_math_reasoning = "Find the sum of all integer bases $b>9$ for which $17_{b}$ is a divisor of $97_{b}$." # 题目来自AIME2025,答案为70
prompt_coding = "写一个python程序,实现快速排序"
prompts = [prompt_daily_chat, prompt_math_reasoning, prompt_coding]

client = OpenAI(
    api_key=openai_api_key,
    base_url=openai_api_base,
)

def get_weather(location: str, date: str = "今天", unit: str = "celsius") -> str:
    """示例工具:查询天气(示例中返回模拟结果)。

    Args:
        location: 城市名
        date: 日期(如“今天”/“明天”或 YYYY-MM-DD)
        unit: 温度单位(celsius/fahrenheit)
    Returns:
        一个简要的天气描述字符串
    """
    normalized_unit = "°C" if unit == "celsius" else "°F"
    # 这里返回一个模拟结果,真实场景可替换为外部 API 调用
    return f"{location}{date}多云,气温 28{normalized_unit},湿度 70%,东北风 3 级。"

for i in range(len(prompts)):
    response = client.chat.completions.create(
        model="Hunyuan-A13B-Instruct",
        messages = [{"role": "user", "content": prompts[i]}],
        temperature=0,
        max_tokens=8000,
        extra_body={
            "chat_template_kwargs": {"enable_thinking": True}, # 默认开启思考,设置为False则关闭
        }
    )

    print(f"问题 {i+1}: {prompts[i]}")
    # print(response)
    print(f"Hunyuan-A13B-Instruct思考 {i+1}: {response.choices[0].message.reasoning_content}")
    print(f"Hunyuan-A13B-Instruct回复 {i+1}: {response.choices[0].message.content}")
    print("-"*100)

# ============== 工具调用示例(OpenAI 格式):weather 查询 ==============
tool_messages = [
    {"role": "system", "content": "你可以调用工具来获取实时天气。"},
    {"role": "user", "content": "帮我查一下深圳今天的天气,用摄氏度。"},
]

weather_tools = [
    {
        "type": "function",
        "function": {
            "name": "get_weather",
            "description": "根据地点与日期查询天气,返回简要的天气描述。",
            "parameters": {
                "type": "object",
                "properties": {
                    "location": {"type": "string", "description": "城市名,如北京、深圳"},
                    "date": {"type": "string", "description": "日期,YYYY-MM-DD 或 今天/明天", "default": "今天"},
                    "unit": {"type": "string", "enum": ["celsius", "fahrenheit"], "default": "celsius"}
                },
                "required": ["location"]
            }
        }
    }
]

first_tool_response = client.chat.completions.create(
    model="Hunyuan-A13B-Instruct",
    messages=tool_messages,
    temperature=0,
    max_tokens=7500,
    tools=weather_tools,
    tool_choice="auto",
    extra_body={
        "chat_template_kwargs": {"enable_thinking": True},
    }
)

assistant_msg = first_tool_response.choices[0].message
# 将包含 tool_calls 的 assistant 消息加入到对话历史
tool_messages.append({
    "role": "assistant",
    "content": assistant_msg.content or "",
    "tool_calls": assistant_msg.tool_calls,
})

tool_calls = assistant_msg.tool_calls or []
for tool_call in tool_calls:
    function_name = tool_call.function.name
    try:
        function_args = json.loads(tool_call.function.arguments or "{}")
    except json.JSONDecodeError:
        function_args = {}

    if function_name == "get_weather":
        tool_result = get_weather(
            location=function_args.get("location", "未知城市"),
            date=function_args.get("date", "今天"),
            unit=function_args.get("unit", "celsius"),
        )
    else:
        tool_result = f"不支持的工具: {function_name}"

    tool_messages.append({
        "role": "tool",
        "tool_call_id": tool_call.id,
        "content": tool_result,
    })

final_tool_response = client.chat.completions.create(
    model="Hunyuan-A13B-Instruct",
    messages=tool_messages,
    temperature=0,
    max_tokens=8000,
    extra_body={
        "chat_template_kwargs": {"enable_thinking": True},
    }
)

print("问题 4: 使用工具调用(天气查询)")
print(f"Hunyuan-A13B-Instruct工具调用思考: {first_tool_response.choices[0].message.reasoning_content}")
print(f"Hunyuan-A13B-Instruct工具调用回复: {first_tool_response.choices[0].message.content}")
print(f"Hunyuan-A13B-Instruct思考 4: {final_tool_response.choices[0].message.reasoning_content}")
print(f"Hunyuan-A13B-Instruct回复 4: {final_tool_response.choices[0].message.content}")
print("-"*100)输出结果为:
问题 4: 使用工具调用(天气查询)
Hunyuan-A13B-Instruct工具调用思考: 好的,用户让我帮忙查深圳今天的天气,并且要用摄氏度。首先,我需要确认用户的需求是否明确。用户提到了地点是深圳,日期是今天,单位是摄氏度。这些信息都符合函数get_weather的参数要求。

接下来,检查函数get_weather的参数。函数需要location,这是必填项,用户已经提供了深圳。日期参数date有默认值“今天”,所以即使用户没指定日期,也可以使用默认值。不过用户这里明确说了“今天”,所以还是填进去比较好。单位unit的默认是摄氏度,用户也特别指定了用摄氏度,所以这个参数可以保留默认或者显式填写,但为了准确,最好还是加上。

然后,考虑是否有其他潜在需求。用户可能只是想知道温度,但天气描述可能包括更多信息,比如湿度、风速等,不过用户没有提到这些,所以按基本需求处理即可。另外,用户可能希望得到简洁的回答,不需要太详细的数据。

现在,确定是否需要调用函数。所有必要参数都已提供,没有缺失。因此,应该调用get_weather函数,传入location为深圳,date为今天,unit为摄氏度。不需要进一步询问用户,因为所有参数都齐了。最后,确保按照格式返回工具调用,不添加其他内容。
Hunyuan-A13B-Instruct工具调用回复: None
Hunyuan-A13B-Instruct思考 4: 好的,用户让我查深圳今天的天气,用摄氏度。我之前已经调用了天气API,得到了回复:深圳今天多云,气温28°C,湿度70%,东北风3级。现在需要把这些信息整理成用户友好的回答。

首先,确认用户的需求是获取深圳的实时天气,并且特别提到用摄氏度,所以温度部分要突出显示。然后,其他信息如湿度、风力也需要包含进去,但可能不需要太详细。用户可能计划出门,所以天气状况和风力风向对他们安排活动可能有帮助。

接下来,检查回复的结构是否清晰。应该先直接回答温度,再补充其他细节。使用简洁的语言,避免专业术语,让用户容易理解。另外,考虑到用户可能来自不同地区,可能需要确认是否需要更多信息,比如未来几天的预报,但根据当前问题,暂时不需要扩展。

还要注意单位和符号的正确性,比如摄氏度符号°C,风力等级用“级”表示。最后,保持语气友好,让用户感觉被帮助到。可能用户没有说出来的深层需求是希望快速了解天气情况,以便做出出行或穿衣的决定,所以信息要准确且一目了然。
Hunyuan-A13B-Instruct回复 4: 深圳今天多云,气温28°C,湿度70%,东北风3级。希望这些信息对你有帮助哦。
----------------------------------------------------------------------------------------------------在工具调用中, Hunyuan-A13B-Instruct 也表现的很好,能够适时调用工具并最终返回准确的天气查询信息。
03-Hunyuan-A13B-Instruct-SGLang部署调用
SGLang 简介
SGLang 是一个高性能的大语言模型推理与编程框架,具备以下特性:
快速后端运行时:采用 RadixAttention 实现高效前缀缓存,支持零开销 CPU 调度器、推测解码、分页注意力、连续批处理、分块预填充、结构化输出、张量并行、管道并行、专家并行以及多种量化格式(FP8/INT4/AWQ/GPTQ),支持多 LoRA 批处理,提供高吞吐低延迟服务。
灵活的前端语言:提供直观的编程接口,支持链式调用、高级提示设计、控制流、多模态输入、并行执行和外部交互,便于构建复杂应用。
广泛的模型支持:兼容多种主流模型(如 LLaMA、Gemma、Mistral、Qwen、DeepSeek、LLaVA 等)、嵌入模型(如 e5-mistral、GTE、MCDSE)以及奖励模型(如 Skywork),支持扩展接入新模型。
开源与社区:SGLang 是开源项目,拥有活跃的开发社区,并被多个组织和项目采用。
环境准备
本文基础环境如下:
----------------
ubuntu 22.04
python 3.12
cuda 12.4
pytorch 2.5.1
----------------本文默认学习者已配置好以上
Pytorch (cuda)环境,如未配置请先自行安装。
首先 pip 换源加速下载并安装依赖包
python -m pip install --upgrade pip
pip config set global.index-url https://pypi.tuna.tsinghua.edu.cn/simple

pip install --upgrade pip
pip install "sglang[all]>=0.4.6.post4"
pip install modelscope
pip install openai模型下载
使用 modelscope 中的 snapshot_download 函数下载模型,第一个参数为模型名称,参数 cache_dir 为模型的下载路径。
新建 model_download.py 文件并在其中输入以下内容,粘贴代码后记得保存文件。
from modelscope import snapshot_download

model_dir = snapshot_download('Tencent-Hunyuan/Hunyuan-A13B-Instruct', cache_dir='/root/autodl-tmp', revision='master')然后在终端中输入 python model_download.py 执行下载,这里需要耐心等待一段时间直到模型下载完成。
注意:记得修改
cache_dir为你的模型下载路径哦~
代码准备
启动服务器
SGLang 框架提供了简单的方法来启动服务器。下面的代码展示了如何启动一个 SGLang 服务器,该服务器将加载 Hunyuan-A13B-Instruct 模型并在指定端口上提供服务。
新建 start_server.py 文件并在其中输入以下内容:
from sglang.test.test_utils import is_in_ci
from sglang.utils import launch_server_cmd, wait_for_server, print_highlight, terminate_process

server_process, port = launch_server_cmd(
    "python3 -m sglang.launch_server --model-path /root/autodl-tmp/Tencent-Hunyuan/Hunyuan-A13B-Instruct --host 0.0.0.0 --port 8080 --tp-size 2 --mem-fraction-static 0.8 --trust-remote-code --reasoning-parser qwen3", port = 8080
)

wait_for_server(f"http://localhost:{port}")
print(f"Server started on http://localhost:{port}")注意:请将
--model-path参数修改为你的模型实际下载路径。
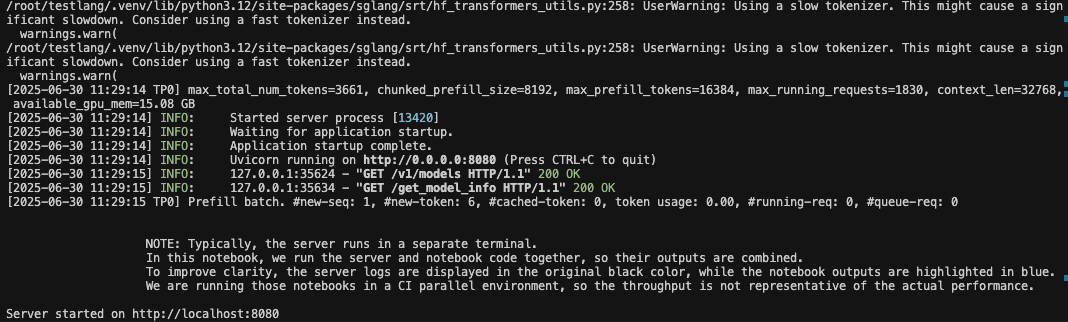
在终端中执行以下命令启动服务器:
python start_server.py成功启动后,你将看到类似以下的输出:
基本调用示例
SGLang 提供了与 OpenAI API 兼容的接口,可以通过 Python 的 OpenAI 客户端库进行调用。以下是几个基本的调用示例。
文本补全示例
新建 test_completion.py 文件并在其中输入以下内容:
from openai import OpenAI
# 补全 API 与聊天补全 API 类似,但没有 messages 参数或聊天模板。
# 补全 API 接受 OpenAI Completions API 的参数。有关更多详细信息,请查阅OpenAI Completions API。

openai_api_key = "EMPTY"
openai_api_base = "http://127.0.0.1:8080/v1" # 使用正确的端口

client = OpenAI(
    api_key=openai_api_key,
    base_url=openai_api_base,
)
response = client.completions.create(
    model="/root/autodl-tmp/Tencent-Hunyuan/Hunyuan-A13B-Instruct",
    prompt="给我一个关于大模型的简短介绍。",
    temperature=0,
    max_tokens=600,
    n=1,
    stop=None,
)

print(f"Response: {response}")结果如下:
Response: Completion(id='092771d863de45d8bd40fd60b954c9a5', choices=[CompletionChoice(finish_reason='length', index=0, logprobs=None, text='<think>\n好的,用户需要一个关于大模型的简短介绍。首先,我需要明确大模型的核心定义,可能包括参数规模、训练数据、能力特点。然后,要提到关键技术,比如Transformer架构,因为这是大模型的基础。接下来,应用场景也很重要,用户可能想知道大模型能做什么,比如对话、生成、分析等。还要区分大模型和传统模型的不同,比如参数规模、泛化能力。另外,可能需要提到发展现状,比如从GPT-3到GPT-4,LLaMA系列,说明技术进步。还要注意语言简洁,避免太技术化,保持易懂。需要结构清晰,先定义,再技术基础,然后能力,应用,最后现状。检查有没有遗漏的关键点,比如自监督学习、海量数据、上下文学习能力。确保信息准确,比如Transformer是2017年提出的,大模型参数通常在十亿到万亿级别。可能用户是普通读者,所以需要通俗解释,避免术语堆砌。最后总结大模型的影响,比如推动AI发展,改变应用模式。现在组织这些点,形成一个连贯的简短介绍。\n</think>\n<answer>\n### 大模型(Large Language Model, LLM)简短介绍 \n\n**核心定义**:大模型是一类基于深度学习的人工智能系统,通过海量文本、代码等数据训练,具备超大规模参数(通常达十亿至万亿级别)', matched_stop=None)], created=1751258302, model='/root/autodl-fs/Hunyuan-A13B-Instruct', object='text_completion', system_fingerprint=None, usage=CompletionUsage(completion_tokens=300, prompt_tokens=9, total_tokens=309, completion_tokens_details=None, prompt_tokens_details=None))注意:请将
model参数修改为你的模型实际下载路径。
聊天补全示例(带思考功能)
新建 test_chat_with_think.py 文件并在其中输入以下内容:
from openai import OpenAI

# 修改 OpenAI 的 API 密钥和 API 基础地址以使用 SGLang 的 API 服务器。
def chatcompletionwiththink(messages):
    openai_api_key = "EMPTY"
    openai_api_base = "http://127.0.0.1:8080/v1" # 使用正确的端口

    client = OpenAI(
        api_key=openai_api_key,
        base_url=openai_api_base,
    )

    model = "/root/autodl-tmp/Tencent-Hunyuan/Hunyuan-A13B-Instruct" # 使用服务器加载的模型
    messages = [{"role": "user", "content": messages}]

    response = client.chat.completions.create(
        model=model,
        messages=messages,
    )
    print("======================")
    print(response)
    print("模型思考: \n", response.choices[0].message.reasoning_content)
    print("模型回答: \n", response.choices[0].message.content)
    print("======================")


def chatcompletionwiththinkbyargs(messages, enable_thinking=True):
    openai_api_key = "EMPTY"
    openai_api_base = "http://127.0.0.1:8080/v1" # 使用正确的端口

    client = OpenAI(
        api_key=openai_api_key,
        base_url=openai_api_base,
    )

    model = "/root/autodl-tmp/Tencent-Hunyuan/Hunyuan-A13B-Instruct" # 使用服务器加载的模型
    messages = [{"role": "user", "content": messages}]

    response = client.chat.completions.create(
        model=model,
        messages=messages,
        extra_body={
            "chat_template_kwargs": {"enable_thinking": enable_thinking},
            "separate_reasoning": True
        }
    )
    print("======================")
    print(response)
    print("模型思考: \n", response.choices[0].message.reasoning_content)
    print("模型回答: \n", response.choices[0].message.content)
    print("======================")

if __name__ == "__main__":
    print("参数方式不启用思考")
    chatcompletionwiththinkbyargs("给我一个关于大模型的简短介绍。", enable_thinking=False)
    print("参数方式启用思考")
    chatcompletionwiththinkbyargs("给我一个关于大模型的简短介绍。", enable_thinking=True)
    print("提示词方式不启用思考")
    chatcompletionwiththink("/no_think 给我一个关于大模型的简短介绍。")
    print("提示词方式启用思考")
chatcompletionwiththink("/think 给我一个关于大模型的简短介绍。")注意:请将
model参数修改为你的模型实际下载路径。
结果大概如下:
参数方式不启用思考
======================
ChatCompletion(id='08aa899ef5ac40a7a0e4f386fc1a99f2', choices=[Choice(finish_reason='stop', index=0, logprobs=None, message=ChatCompletionMessage(content='<answer>\n大模型指的是大规模语言模型,英文一般称为Large Language Model,简称LLM。下面从基本定义、技术原理、特点、应用场景几个方面介绍:\n- **基本定义**:它是一种基于深度学习的人工智能算法,通过海量文本数据进行预训练,学习语言的模式、结构和语义信息。\n- **技术原理**:以Transformer架构为基础,使用自注意力机制捕捉文本中词语间的关联,通过大规模无监督学习,让模型学习语言规律和知识。\n- **特点**:具备强大语言理解和生成能力,能处理多种自然语言处理任务;知识储备丰富,可回答不同领域问题;可扩展性强,通过增加参数和数据提升性能。\n- **应用场景**:在智能客服领域,能快速准确响应用户咨询;在内容创作上,可生成文章、诗歌等;还能辅助代码编写、翻译、绘画提示生成等。\n</answer>', refusal=None, role='assistant', annotations=None, audio=None, function_call=None, tool_calls=None, reasoning_content=None), matched_stop=127960)], created=1751258348, model='/root/autodl-fs/Hunyuan-A13B-Instruct', object='chat.completion', service_tier=None, system_fingerprint=None, usage=CompletionUsage(completion_tokens=190, prompt_tokens=17, total_tokens=207, completion_tokens_details=None, prompt_tokens_details=None))
模型思考:
 None
模型回答:
 <answer>
大模型指的是大规模语言模型,英文一般称为Large Language Model,简称LLM。下面从基本定义、技术原理、特点、应用场景几个方面介绍:
- **基本定义**:它是一种基于深度学习的人工智能算法,通过海量文本数据进行预训练,学习语言的模式、结构和语义信息。
- **技术原理**:以Transformer架构为基础,使用自注意力机制捕捉文本中词语间的关联,通过大规模无监督学习,让模型学习语言规律和知识。
- **特点**:具备强大语言理解和生成能力,能处理多种自然语言处理任务;知识储备丰富,可回答不同领域问题;可扩展性强,通过增加参数和数据提升性能。
- **应用场景**:在智能客服领域,能快速准确响应用户咨询;在内容创作上,可生成文章、诗歌等;还能辅助代码编写、翻译、绘画提示生成等。
</answer>
======================
参数方式启用思考
======================
ChatCompletion(id='29f1d349b6cc4aa1a63df628d16e5cd7', choices=[Choice(finish_reason='stop', index=0, logprobs=None, message=ChatCompletionMessage(content='<answer>\n### 大模型:重新定义人工智能的“通用引擎”  \n\n**大模型(Large Language Model, LLM)** 是近年来人工智能领域的突破性技术,核心是通过海量参数(通常达百亿至万亿级)和大规模数据训练,构建具备强泛化能力的通用型智能模型。其技术基础以2017年提出的 **Transformer架构** 为核心,通过“自注意力机制(Self-Attention)”高效处理长序列数据(如文本),突破了传统模型对固定任务或短序列的依赖。  \n\n**关键特点**:  \n- **参数与数据“规模制胜”**:参数规模从早期的亿级(如BERT-base)跃升至千亿级(如GPT-3、PaLM)甚至万亿级(如GPT-4),需TB级文本、图像等多模态数据训练;  \n- **跨任务泛化**:无需为每个任务单独设计模型,通过“指令微调”即可适配对话、翻译、写作、代码生成等数百种场景;  \n- **多模态融合**:从单一文本扩展至文本+图像(如GPT-4V)、语音、视频等,理解与生成能力更接近人类。  \n\n**应用与影响**:  \n大模型已渗透至智能助手(ChatGPT、文心一言)、内容创作(AIGC)、代码开发(GitHub Copilot)、科研辅助(蛋白质结构预测)等领域,推动AI从“专用工具”向“通用智能体”演进。同时,其也引发对信息准确性、隐私安全、伦理风险(如深度伪造)的关注,成为技术发展与治理平衡的关键议题。  \n\n简言之,大模型是当前人工智能的“基础设施”,正重塑人机交互方式,并为通用人工智能(AGI)的探索提供核心支撑。\n</answer>', refusal=None, role='assistant', annotations=None, audio=None, function_call=None, tool_calls=None, reasoning_content='好的,用户让我写一个关于大模型的简短介绍。首先,我需要明确大模型的核心是什么。大模型通常指参数规模极大的机器学习模型,尤其是自然语言处理领域的,比如GPT、BERT这些。用户可能想了解基本概念、特点、应用和影响。\n\n首先,定义部分要简洁,说明大模型是基于深度学习,参数规模大,通常千亿级以上。然后,技术基础可能需要提到Transformer架构,因为这是当前大模型的基础,比如自注意力机制,处理长序列的能力。\n\n接下来是关键特点,参数规模大、数据需求大、计算资源需求高,这些是大模型区别于传统模型的地方。然后是能力表现,比如多模态处理(文本、图像、语音)、复杂推理、泛化能力,这些能力让它们在各种任务上表现好。\n\n应用场景需要举几个例子,比如对话交互、内容生成(写文章、代码)、智能助手、医疗诊断辅助,这样用户更容易理解。然后是影响部分,推动AI发展,改变人机交互,但也带来伦理问题,比如信息准确、隐私、就业影响,这样介绍更全面。\n\n用户可能的深层需求是快速了解大模型的全貌,不需要太技术化的细节,所以要保持简短易懂。需要避免专业术语过多,用通俗的语言。还要注意结构清晰,逻辑连贯,从定义到技术基础,再到特点、应用和影响,这样用户能一步步理解。\n\n可能需要检查是否有遗漏的重要点,比如大模型的发展历程?但用户要简短,可能不需要。重点突出核心要素。另外,确保信息准确,比如Transformer是2017年提出的,大模型参数确实从亿级到千亿级甚至万亿级,比如GPT-3是1750亿,GPT-4可能更大。\n\n最后,总结大模型的意义,强调其作为通用人工智能(AGI)的探索,既是技术突破,也带来挑战。这样介绍会比较完整,满足用户的需求。\n'), matched_stop=127960)], created=1751258354, model='/root/autodl-fs/Hunyuan-A13B-Instruct', object='chat.completion', service_tier=None, system_fingerprint=None, usage=CompletionUsage(completion_tokens=802, prompt_tokens=11, total_tokens=813, completion_tokens_details=None, prompt_tokens_details=None))
模型思考:
 好的,用户让我写一个关于大模型的简短介绍。首先,我需要明确大模型的核心是什么。大模型通常指参数规模极大的机器学习模型,尤其是自然语言处理领域的,比如GPT、BERT这些。用户可能想了解基本概念、特点、应用和影响。

首先,定义部分要简洁,说明大模型是基于深度学习,参数规模大,通常千亿级以上。然后,技术基础可能需要提到Transformer架构,因为这是当前大模型的基础,比如自注意力机制,处理长序列的能力。

接下来是关键特点,参数规模大、数据需求大、计算资源需求高,这些是大模型区别于传统模型的地方。然后是能力表现,比如多模态处理(文本、图像、语音)、复杂推理、泛化能力,这些能力让它们在各种任务上表现好。

应用场景需要举几个例子,比如对话交互、内容生成(写文章、代码)、智能助手、医疗诊断辅助,这样用户更容易理解。然后是影响部分,推动AI发展,改变人机交互,但也带来伦理问题,比如信息准确、隐私、就业影响,这样介绍更全面。

用户可能的深层需求是快速了解大模型的全貌,不需要太技术化的细节,所以要保持简短易懂。需要避免专业术语过多,用通俗的语言。还要注意结构清晰,逻辑连贯,从定义到技术基础,再到特点、应用和影响,这样用户能一步步理解。

可能需要检查是否有遗漏的重要点,比如大模型的发展历程?但用户要简短,可能不需要。重点突出核心要素。另外,确保信息准确,比如Transformer是2017年提出的,大模型参数确实从亿级到千亿级甚至万亿级,比如GPT-3是1750亿,GPT-4可能更大。

最后,总结大模型的意义,强调其作为通用人工智能(AGI)的探索,既是技术突破,也带来挑战。这样介绍会比较完整,满足用户的需求。

模型回答:
 <answer>
### 大模型:重新定义人工智能的“通用引擎”

**大模型(Large Language Model, LLM)** 是近年来人工智能领域的突破性技术,核心是通过海量参数(通常达百亿至万亿级)和大规模数据训练,构建具备强泛化能力的通用型智能模型。其技术基础以2017年提出的 **Transformer架构** 为核心,通过“自注意力机制(Self-Attention)”高效处理长序列数据(如文本),突破了传统模型对固定任务或短序列的依赖。

**关键特点**:
- **参数与数据“规模制胜”**:参数规模从早期的亿级(如BERT-base)跃升至千亿级(如GPT-3、PaLM)甚至万亿级(如GPT-4),需TB级文本、图像等多模态数据训练;
- **跨任务泛化**:无需为每个任务单独设计模型,通过“指令微调”即可适配对话、翻译、写作、代码生成等数百种场景;
- **多模态融合**:从单一文本扩展至文本+图像(如GPT-4V)、语音、视频等,理解与生成能力更接近人类。

**应用与影响**:
大模型已渗透至智能助手(ChatGPT、文心一言)、内容创作(AIGC)、代码开发(GitHub Copilot)、科研辅助(蛋白质结构预测)等领域,推动AI从“专用工具”向“通用智能体”演进。同时,其也引发对信息准确性、隐私安全、伦理风险(如深度伪造)的关注,成为技术发展与治理平衡的关键议题。

简言之,大模型是当前人工智能的“基础设施”,正重塑人机交互方式,并为通用人工智能(AGI)的探索提供核心支撑。
</answer>
======================
提示词方式不启用思考
======================流式输出示例
新建 test_streaming.py 文件并在其中输入以下内容:
from openai import OpenAI

# 修改 OpenAI 的 API 密钥和 API 基础地址以使用 SGLang 的 API 服务器。
openai_api_key = "EMPTY"
openai_api_base = "http://127.0.0.1:8080/v1"  # 默认端口,可能会有所不同

client = OpenAI(
    api_key=openai_api_key,
    base_url=openai_api_base,
)

stream = client.chat.completions.create(
    model="/root/autodl-tmp/Tencent-Hunyuan/Hunyuan-A13B-Instruct",
    messages=[{"role": "user", "content": "给我一个关于大模型的简短介绍。"}],
    stream=True,
    # 可选择是否启用思考,默认启用
    # extra_body={
    #     "chat_template_kwargs": {"enable_thinking": True},
    #     "separate_reasoning": True
    # }
)
# 流式输出不论是否开启思考,所有token都会放在content中
for chunk in stream:
    if chunk.choices[0].delta.content is not None:
print(chunk.choices[0].delta.content, end="")注意:请将
model参数修改为你的模型实际下载路径。
命令行方式启动服务器
除了通过 Python 脚本启动服务器外,你还可以直接在命令行中启动 SGLang 服务器。以下是命令行启动服务器的示例:
python -m sglang.launch_server \
    --model-path /root/autodl-tmp/Tencent-Hunyuan/Hunyuan-A13B-Instruct \
    --host 0.0.0.0 \
    --port 8080 \
    --tp-size 2 \
    --mem-fraction-static 0.8 \
    --trust-remote-code \
--reasoning-parser qwen3参数说明:
--model-path:模型路径
--host:服务器主机地址,0.0.0.0 表示允许所有 IP 访问
--port:服务器端口
--tp-size:张量并行大小,根据你的 GPU 数量调整
--mem-fraction-static:静态内存分配比例
--trust-remote-code:信任远程代码
--reasoning-parser:推理解析器,这里使用 qwen3,适用于解析 ... 格式的思考内容
使用 curl 测试 API
服务器启动后,你可以使用 curl 命令测试 API。以下是一些示例:
查看模型列表:
curl http://localhost:8080/v1/models{
"object": "list",
"data": [
{
"id": "/root/autodl-fs/Hunyuan-A13B-Instruct",
"object": "model",
"created": 1751257651,
"owned_by": "sglang",
"root": "/root/autodl-fs/Hunyuan-A13B-Instruct",
"max_model_len": 32768
}
]
}测试补全 API:
curl http://localhost:8080/v1/completions \
    -H "Content-Type: application/json" \
    -d '{
        "model": "/root/autodl-tmp/Tencent-Hunyuan/Hunyuan-A13B-Instruct",
        "prompt": "给我一个关于大模型的简短介绍。",
        "max_tokens":3000,
        "temperature": 0
}'{
"id": "416c69caef134e16aaadc2dafcef2c27",
"object": "text_completion",
"created": 1751258615,
"model": "/root/autodl-tmp/Tencent-Hunyuan/Hunyuan-A13B-Instruct",
"choices": [
{
"index": 0,
"text": "<think>\n好的,用户需要一个关于大模型的简短介绍。首先,我需要明确大模型的核心定义,可能包括参数规模、训练数据、能力特点。然后,要提到关键技术,比如Transformer架构,因为这是大模型的基础。接下来,应用场景也很重要,用户可能想知道大模型能做什么,比如对话、生成、分析等。还要区分大模型和传统模型的不同,比如参数规模、泛化能力。另外,可能需要提到发展现状,比如从GPT-3到GPT-4,LLaMA系列,说明技术进步。还要注意语言简洁,避免太技术化,保持易懂。需要结构清晰,先定义,再技术基础,然后能力,应用,最后现状。检查有没有遗漏的关键点,比如自监督学习、海量数据、上下文学习能力。确保信息准确,比如Transformer是2017年提出的,大模型参数通常在十亿到万亿级别。可能用户是普通读者,所以需要通俗解释,避免术语堆砌。最后总结大模型的影响,比如推动AI发展,改变应用模式。现在组织这些点,形成一个连贯的简短介绍。\n</think>\n<answer>\n### 大模型(Large Language Model, LLM)简短介绍 \n\n**核心定义**:大模型是一类基于深度学习的人工智能系统,通过海量文本、代码等数据训练,具备超大规模参数(通常达十亿至万亿级别)和强大泛化能力,能理解、生成自然语言,并完成复杂任务。 \n\n**技术基础**:以Transformer架构(2017年提出)为核心,通过自注意力机制(Self-Attention)捕捉长距离语义关联,突破了传统循环神经网络(RNN)的局限,使模型能并行处理海量信息,显著提升学习效率。 \n\n**核心能力**: \n- **上下文学习(In-Context Learning)**:仅需少量示例(甚至零样本),即可理解新任务并生成符合要求的输出(如“写一首关于春天的诗”); \n- **多模态扩展**:从纯文本扩展到文本+图像(如GPT-4、DALL·E)、文本+语音等,覆盖更复杂场景; \n- **逻辑与推理**:通过训练数据中的隐含逻辑,支持简单数学计算、代码生成、常识问答等。 \n\n**典型应用**:智能对话(如ChatGPT)、内容生成(文案/代码/绘画)、信息分析(总结/翻译/问答)、行业垂直场景(医疗/教育/金融的智能助手)等。 \n\n**发展现状**:自2020年GPT-3(1750亿参数)起,大模型进入“万亿参数”时代(如GPT-4、LLaMA 2、PaLM 2),技术迭代加速,同时推动AI从“专用”向“通用”探索,成为当前人工智能领域的核心方向。 \n\n**意义**:大模型通过“数据-参数-算力”的规模效应,重新定义了AI的能力边界,正在重塑人机交互、内容生产、科学研究等领域的效率与模式。\n</answer>",
"logprobs": null,
"finish_reason": "stop",
"matched_stop": 127960
}
],
"usage": {
"prompt_tokens": 9,
"total_tokens": 669,
"completion_tokens": 660,
"prompt_tokens_details": null
}
}测试聊天补全 API:
curl http://localhost:8080/v1/chat/completions \
    -H "Content-Type: application/json" \
    -d '{
        "model": "/root/autodl-tmp/Tencent-Hunyuan/Hunyuan-A13B-Instruct",
        "messages": [
            {"role": "user", "content": "给我一个关于大模型的简短介绍。"}
        ],
        "extra_body": {
            "chat_template_kwargs": {"enable_thinking": true},
            "separate_reasoning": true
        }
}'{
"id": "dbc0af7e71c14d40959008c3e92caaa3",
"object": "chat.completion",
"created": 1751257762,
"model": "/root/autodl-fs/Tencent-Hunyuan/Hunyuan-A13B-Instruct",
"choices": [
{
"index": 0,
"message": {
"role": "assistant",
"content": "<answer>\n大模型(通常指**大语言模型,LLM**)是近年来人工智能领域的突破性技术,核心是通过海量数据训练、参数规模极大的深度学习模型,展现出接近人类的复杂语言理解与生成能力。 \n\n### 技术基础 \n其底层多基于**Transformer架构**(2017年提出的革命性神经网络模型),通过“自注意力机制”捕捉文本中长距离的语义关联,突破了传统循环神经网络的局限。训练模式通常为“预训练+微调”:先在万亿级文本(如书籍、网页、对话等)上通用预训练,学习语言规律;再针对具体任务(如问答、翻译)微调,快速适配不同场景。 \n\n### 核心特点 \n- **涌现能力**:参数超过一定阈值(如千亿级)后,模型会突然具备小模型不具备的“推理”“创作”“逻辑总结”等能力,仿佛“跨越式”进化。 \n- **强泛化性**:无需为每个任务单独设计模型,预训练的知识可跨领域迁移(如用同一模型写代码、写文案、回答问题)。 \n- **自然交互**:支持多轮对话、上下文理解,输出符合人类表达习惯的文本(如对话、故事、代码、学术摘要等)。 \n\n### 应用与影响 \n大模型已渗透至智能对话(如ChatGPT)、内容创作(文案/代码生成)、办公辅助(会议纪要总结)、多模态交互(结合图像/视频理解)等场景,推动AI从“工具”向“协作伙伴”升级。同时,其发展也引发对伦理的关注(如虚假信息、算法偏见),成为全球AI研究的核心方向之一。\n</answer>",
"reasoning_content": "好的,用户让我写一个关于大模型的简短介绍。首先,我需要明确大模型的核心是什么。大模型通常指的是参数规模极大的机器学习模型,尤其是基于深度学习的。现在最火的是Transformer架构,比如GPT和BERT这些。\n\n用户可能想要的是简洁但涵盖关键点的介绍。需要包括定义、技术基础、特点、应用场景,可能还要提到影响。要注意不要太技术化,保持易懂。\n\n首先,定义部分:大语言模型(LLM)是深度学习模型,参数规模大,比如千亿甚至万亿级,通过海量数据训练,具备强大的语言理解和生成能力。\n\n然后技术基础:Transformer架构是关键,自注意力机制让模型能捕捉长距离依赖,预训练+微调的模式,预训练在通用数据上,微调适应具体任务。\n\n特点:涌现能力(小模型没有的,比如推理、创作)、泛化性强(跨任务处理)、交互自然(对话、文本生成)。\n\n应用场景:智能对话(ChatGPT)、内容创作(写文章、代码)、辅助办公(总结、翻译)、多模态扩展(结合图像、视频)。\n\n影响:推动AI发展,改变人机交互,促进各行业效率提升,同时带来伦理挑战(虚假信息、偏见)。\n\n需要检查是否简短,有没有冗余。可能用户是普通读者,不是专业人士,所以术语要解释,比如Transformer可以简单说“革命性架构”。还要注意逻辑连贯,从定义到技术,再到特点和应用,最后影响。\n\n可能用户的需求是快速了解大模型是什么,所以结构要清晰,重点突出。避免太深入的技术细节,保持概述。需要确认信息准确,比如参数规模,现在主流是大语言模型,参数从百亿到万亿,比如GPT-3是1750亿,GPT-4可能更大。预训练数据量也是关键,比如万亿token。\n\n总结下来,结构大概是:定义→技术基础(Transformer、预训练)→特点(涌现、泛化、自然交互)→应用→影响。这样应该能满足用户的需求。\n",
"tool_calls": null
},
"logprobs": null,
"finish_reason": "stop",
"matched_stop": 127960
}
],
"usage": {
"prompt_tokens": 11,
"total_tokens": 815,
"completion_tokens": 804,
"prompt_tokens_details": null
}
}SGLang 特性
思考能力
Hunyuan-A13B-Instruct 模型通过 SGLang 框架可以启用思考能力,类似于 Qwen3 系列模型。当启用思考模式时,模型会在生成最终回答前先进行推理过程,这有助于提升生成回答的质量。
思考模式可以通过两种方式启用:
在 API 请求中设置 extra_body 参数:{"chat_template_kwargs": {"enable_thinking": true}, "separate_reasoning": true}
在提示词前添加 /think 前缀
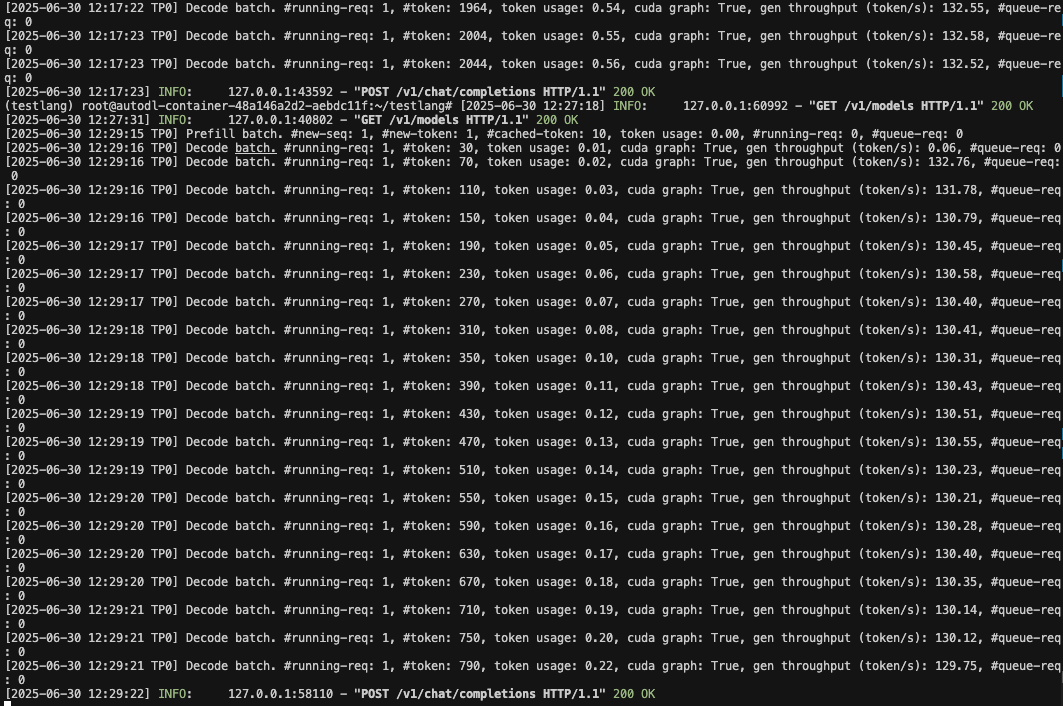
另外,在以上所有的在请求处理过程中, API 后端都会打印相对应的日志和统计信息:
04-Hunyuan-A13B-Instruct EvalScope 并发测试
大模型评测是什么
大语言模型评测是指对大语言模型(LLM)在多种任务和场景下的性能进行全面评估的过程。评测的目的是衡量模型的通用能力、特定领域表现、效率、鲁棒性、安全性等多方面性能,以便优化模型设计、指导技术选型和推动模型在实际应用中的部署。
评测的主要内容包括以下几个方面:
通用能力:评估模型在语言理解、生成、推理等方面的基础能力。
特定领域表现:针对特定任务(如数学推理、代码生成、情感分析等)的性能评估。
效率与资源消耗:包括模型的训练和推理时间、计算资源需求等。
鲁棒性与可靠性:评估模型在面对噪声、对抗攻击或输入扰动时的稳定性。
伦理与安全性:检测模型是否会产生有害内容、是否存在偏见或歧视。
EvalScope 是魔搭社区官方推出的模型评测与性能基准测试框架,内置多个常用测试基准和评测指标,如 MMLU、CMMLU、C-Eval、GSM8K、ARC、HellaSwag、TruthfulQA、MATH 和 HumanEval 等;支持多种类型的模型评测,包括 LLM、多模态 LLM、embedding 模型和 reranker 模型。EvalScope 还适用于多种评测场景,如端到端 RAG 评测、竞技场模式和模型推理性能压测等。此外,通过 ms-swift 训练框架的无缝集成,可一键发起评测,实现了模型训练到评测的全链路支持。 官网地址:https://evalscope.readthedocs.io/zh-cn/latest/get_started
环境准备
本文基础环境如下:
----------------
ubuntu 22.04
python 3.12
Cuda  12.4
PyTorch  2.5.1
----------------pip 安装 EvalScope:
pip install evalscope                # 安装 Native backend (默认)
# 额外选项
pip install evalscope[opencompass]   # 安装 OpenCompass backend
pip install evalscope[vlmeval]       # 安装 VLMEvalKit backend
pip install evalscope[rag]           # 安装 RAGEval backend
pip install evalscope[perf]          # 安装 模型压测模块 依赖
pip install evalscope[all] # 安装所有 backends (Native, OpenCompass, VLMEvalKit, RAGEval)考虑到部分同学配置环境可能会遇到一些问题,我们在 AutoDL 平台准备了 Qwen3 的环境镜像,点击下方链接并直接创建 Autodl 示例即可。 https://www.codewithgpu.com/i/datawhalechina/self-llm/Qwen3
模型评测方法
关于 Qwen3 模型的评测,EvalScope 官方给了一个实践教程供我们参考:https://evalscope.readthedocs.io/zh-cn/latest/best_practice/qwen3.html
下面我们以智商情商评测为例,对 Qwen3-8 模型进行评测。
我们将使用 EvalScope 模型评测框架,在 IQuiz 数据集上进行评测,这个数据集中收集了 40 道 IQ 测试和 80 道 EQ 测试选择题,其中包括一些经典问题:
数字 9.8 和 9.11 哪个大?
单词 strawberry 和 blueberry 中一共有多少个 r ?
刘雨正在休假,突然被要求开车送领导去机场,他正为休假计划的泡汤而懊恼,因此在送领导时,刹车踩得比较用力。在车上,领导突然说:“小刘啊,这不愧是有着悠久历史的西安,我这坐车有一种回到古代坐马车的感觉。” 领导是什么意思?
步骤一: 创建 vLLM 服务器
这里我们参照第 2 节教程内容(02-Qwen3-8B-vLLM 部署调用),使用 vLLM 创建兼容 OpenAI API 接口的服务器,然后使用 EvalScope 进行评测。当然接入其他的 api 也是可以的。
在终端输入以下命令,即可用 vLLM 部署 Qwen3-8B 模型到一个兼容 OpenAI API 接口的服务器上。
VLLM_USE_MODELSCOPE=true vllm serve /root/autodl-tmp/Qwen/Qwen3-8B --served-model-name Qwen3-8B --max_model_len 8192 --enable-reasoning --reasoning-parser deepseek_r1步骤二: 执行评测
我们可以使用 EvalScope 命令进行评测,直接在终端输入以下命令:
evalscope eval \
  --model Qwen3-8B \
  --api-url http://localhost:8000/v1 \
  --api-key EMPTY \
  --eval-type service \
  --eval-batch-size 16 \
  --datasets iquiz \
--work-dir outputs/Qwen3-8B也可以使用 Python 命令进行评测:
新建 eval_api.py 文件,并输入以下代码:
# 导入执行任务的函数和任务配置类
from evalscope.run import run_task
from evalscope.config import TaskConfig

"""
以下为多个AI服务的API端点地址,用于配置任务:
- siliconflow: https://api.siliconflow.cn/v1/chat/completions
- dashscope: https://dashscope.aliyuncs.com/compatible-mode/v1/chat/completions
- modelscope: https://api-inference.modelscope.cn/v1/chat/completions
- xunfei: https://maas-api.cn-huabei-1.xf-yun.com/v1/chat/completions
"""

# 配置任务参数
task_cfg = TaskConfig(
    model='Qwen3-8B',  # 指定使用的模型
    api_url='http://localhost:8000/v1/chat/completions',  # 指定API端点,这里使用的是ollama默认的api接口
    api_key='sk-xxxxxxx',  # API密钥(需替换为实际密钥,ollama 的api_key)
    eval_type='service',  # 指定评估类型为服务模式
    datasets=['iquiz'],  # 指定使用的数据集(这个测试集可以快速测试模型的智商和情商)
    generation_config={  # 文本生成配置
        'max_tokens': 4096,  # 最大令牌数
        'max_new_tokens': 4096,  # 最大新生成令牌数
        'temperature': 1.0,  # 温度参数,这里设置为1.0,模型的输出随机性较大,所以可能会有些实验误差
    },
    work_dir='outputs/Qwen3-8b',  # 输出目录
)

# 执行任务
run_task(task_cfg=task_cfg)新建一个 bash 窗口,也就是终端中执行。 控制台运行python eval_api.py命令即可。
等待 3 分钟左右评测就完成啦,控制台输出的结果如下图所示:
(该图片在源文档中已缺失或失效)
实验结果可能有误差,因为在评测任务配置中我们把 temperature 调到了 1.0,如果调小一些,可能会得到更精确的结果。 可以看到模型的得分还是不错的,模型评测的文件保存在/root/autodl-tmp/outputs/Qwen3-8B/20250502_002809/reviews/Qwen3-8B目录下。
(该图片在源文档中已缺失或失效)
EvalScope 简介:
EvalScope 支持多种模型评测 backend,包括 OpenAI API、OpenCompass、VLMEvalKit、RAGEval 等。
(该图片在源文档中已缺失或失效)
EvalScope 也支持自定义评测任务和数据集,支持多种评测指标。
(该图片在源文档中已缺失或失效)
模型评测对于验证和优化大模型至关重要。通过评测,我们可以全面了解模型的性能、能力边界及潜在问题,确保其在实际应用中的表现符合预期,并推动持续改进。此外,评测还能检测模型的公平性和安全性,提升用户体验,并为不同模型间的对比分析提供客观依据。最终,评测结果为后续版本迭代提供了关键数据支持,保障模型在实际场景中的可靠性和有效性。
Hunyuan-A13B-Instruct-LoRA 及 SwanLab 可视化记录
环境配置
# 换清华镜像源
!pip config set global.index-url https://pypi.tuna.tsinghua.edu.cn/simple

!pip install modelscope==1.25.0
!pip install transformers==4.51.3
!pip install accelerate==1.6.0
!pip install datasets==3.5.1
!pip install peft==0.15.2
!pip install swanlab==0.5.7
!pip install tiktoken考虑到部分同学配置环境可能会遇到一些问题,我们在 AutoDL 平台准备了 Hunyuan-A13B-Instruct 的环境镜像,点击下方链接并直接创建 Autodl 示例即可。 https://www.codewithgpu.com/i/datawhalechina/self-llm/Hunyuan-A13B-Instruct-lora
模型下载
# model_download.py
# 注意修改cache_dir为保存的路径
from modelscope import snapshot_download
model_dir = snapshot_download('Tencent-Hunyuan/Hunyuan-A13B-Instruct', cache_dir='/root/autodl-tmp', revision='master') ###可以根据自己需要修改下载模型所在的存储路径:cache_dir


print(f"模型下载完成,保存路径为:{model_dir}")注意事项!!!
在模型下载完成后,需要修改模型文件夹下的hunyuan.py文件,在开头加入以下代码:
import logging
logger = logging.getLogger(__name__)数据集构建
对大语言模型进行 supervised-finetuning(sft,有监督微调)的数据格式如下:
{
  "instruction": "回答以下用户问题,仅输出答案。",
  "input": "1+1等于几?",
  "output": "2"
}其中,instruction 是用户指令,告知模型其需要完成的任务;input 是用户输入,是完成用户指令所必须的输入内容;output 是模型应该给出的输出。
有监督微调的目标是让模型具备理解并遵循用户指令的能力。因此,在构建数据集时,我们应针对我们的目标任务,针对性构建数据。比如,如果我们的目标是通过大量人物的对话数据微调得到一个能够 role-play 甄嬛对话风格的模型,因此在该场景下的数据示例如下:
{
  "instruction": "你父亲是谁?",
  "input": "",
  "output": "家父是大理寺少卿甄远道。"
}数据准备
LoRA(Low-Rank Adaptation)训练的数据是需要经过格式化、编码之后再输入给模型进行训练的,我们需要先将输入文本编码为 input_ids,将输出文本编码为 labels,编码之后的结果是向量。我们首先定义一个预处理函数,这个函数用于对每一个样本,同时编码其输入、输出文本并返回一个编码后的字典:
def process_func(example):
    MAX_LENGTH = 1024 # 设置最大序列长度为1024个token
    input_ids, attention_mask, labels = [], [], [] # 初始化返回值
    # 适配chat_template
    instruction = tokenizer(
        f"<s><|im_start|>system\n现在你要扮演皇帝身边的女人--甄嬛<|im_end|>\n"
        f"<|im_start|>user\n{example['instruction'] + example['input']}<|im_end|>\n"
        f"<|im_start|>assistant\n<think>\n\n</think>\n\n",
        add_special_tokens=False
    )
    response = tokenizer(f"{example['output']}", add_special_tokens=False)
    # 将instructio部分和response部分的input_ids拼接,并在末尾添加eos token作为标记结束的token
    input_ids = instruction["input_ids"] + response["input_ids"] + [tokenizer.pad_token_id]
    # 注意力掩码,表示模型需要关注的位置
    attention_mask = instruction["attention_mask"] + response["attention_mask"] + [1]
    # 对于instruction,使用-100表示这些位置不计算loss(即模型不需要预测这部分)
    labels = [-100] * len(instruction["input_ids"]) + response["input_ids"] + [tokenizer.pad_token_id]
    if len(input_ids) > MAX_LENGTH:  # 超出最大序列长度截断
        input_ids = input_ids[:MAX_LENGTH]
        attention_mask = attention_mask[:MAX_LENGTH]
        labels = labels[:MAX_LENGTH]
    return {
        "input_ids": input_ids,
        "attention_mask": attention_mask,
        "labels": labels
}Hunyuan-A13B-Instruct 采用的 Chat Template格式如下:
messages = [
    {"role": "system", "content": "===system_message_test==="},
    {"role": "user", "content": "===user_message_test==="},
    {"role": "assistant", "content": "===assistant_message_test==="},
]由于 Hunyuan-A13B-Instruct 是混合推理模型,因此可以手动选择开启思考模式
不开启 thinking mode
messages = [
    {"role": "system", "content": "===system_message_test==="},
    {"role": "user", "content": "===user_message_test==="},
    {"role": "assistant", "content": "===assistant_message_test==="},
]

text = tokenizer.apply_chat_template(
    messages,
    tokenize=False,
    add_generation_prompt=True,
    enable_thinking=False
)
print(text)<|im_start|>system
===system_message_test===<|im_end|>
<|im_start|>user
===user_message_test===<|im_end|>
<|im_start|>assistant
<think>
</think>
===assistant_message_test===<|im_end|>
<|im_start|>assistant
<think>
</think>开启 thinking mode
messages = [
    {"role": "system", "content": "===system_message_test==="},
    {"role": "user", "content": "===user_message_test==="},
    {"role": "assistant", "content": "===assistant_message_test==="},
]

text = tokenizer.apply_chat_template(
    messages,
    tokenize=False,
    add_generation_prompt=True,
    enable_thinking=True
)
print(text)<|im_start|>system
===system_message_test===<|im_end|>
<|im_start|>user
===user_message_test===<|im_end|>
<|im_start|>assistant
<think>
</think>
===assistant_message_test===<|im_end|>
<|im_start|>assistant加载模型和 tokenizer
mode_path = '/root/autodl-tmp/Tencent-Hunyuan/Hunyuan-A13B-Instruct'
# 加载tokenizer
tokenizer = AutoTokenizer.from_pretrained(mode_path, trust_remote_code=True)

# 加载模型
model = AutoModelForCausalLM.from_pretrained(mode_path, device_map="auto",torch_dtype=torch.bfloat16, trust_remote_code=True)Lora Config
LoraConfig这个类中可以设置很多参数,比较重要的如下
task_type:模型类型,现在绝大部分 decoder_only 的模型都是因果语言模型 CAUSAL_LM
target_modules:需要训练的模型层的名字,主要就是 attention部分的层,不同的模型对应的层的名字不同
r:LoRA 的秩,决定了低秩矩阵的维度,较小的 r 意味着更少的参数
lora_alpha:缩放参数,与 r 一起决定了 LoRA 更新的强度。实际缩放比例为lora_alpha/r,在当前示例中是 32 / 8 = 4 倍
lora_dropout:应用于 LoRA 层的 dropout rate,用于防止过拟合
config = LoraConfig(
    task_type=TaskType.CAUSAL_LM,
    target_modules=["q_proj", "k_proj", "v_proj", "o_proj", "gate_proj", "up_proj", "down_proj"],
    inference_mode=False, # 训练模式
    r=8, # Lora 秩
    lora_alpha=32, # Lora alpha
    lora_dropout=0.1 # Dropout 比例
)Training Arguments
output_dir:模型的输出路径
per_device_train_batch_size:每张卡上的 batch_size
gradient_accumulation_steps: 梯度累计
num_train_epochs:顾名思义 epoch
args = TrainingArguments(
    output_dir="./output/Hunyuan-A13B-Instruct", # 注意修改
    per_device_train_batch_size=4,
    gradient_accumulation_steps=4,
    logging_steps=10,
    num_train_epochs=1,
    save_steps=100,
    learning_rate=1e-4,
    save_on_each_node=True,
    gradient_checkpointing=True,
    report_to="none",
)SwanLab 简介
SwanLab 是一个开源的模型训练记录工具,面向 AI 研究者,提供了训练可视化、自动日志记录、超参数记录、实验对比、多人协同等功能。在 SwanLab 上,研究者能基于直观的可视化图表发现训练问题,对比多个实验找到研究灵感,并通过在线链接的分享与基于组织的多人协同训练,打破团队沟通的壁垒。
为什么要记录训练
相较于软件开发,模型训练更像一个实验科学。一个品质优秀的模型背后,往往是成千上万次实验。研究者需要不断尝试、记录、对比,积累经验,才能找到最佳的模型结构、超参数与数据配比。在这之中,如何高效进行记录与对比,对于研究效率的提升至关重要。
实例化 SwanLabCallback
(2) Use an existing SwanLab account 并使用 private API Key 登录
import swanlab
from swanlab.integration.transformers import SwanLabCallback

# 实例化SwanLabCallback
swanlab_callback = SwanLabCallback(
    project="Hunyuan-A13B-Instruct-Lora",  # 注意修改
    experiment_name="Hunyuan-A13B-Instruct-LoRA-experiment"  # 注意修改
)使用 Trainer 训练
trainer = Trainer(
    model=model,
    args=args,
    train_dataset=tokenized_id,
    data_collator=DataCollatorForSeq2Seq(tokenizer=tokenizer, padding=True),
    callbacks=[swanlab_callback] # 传入之前的swanlab_callback
)
trainer.train()TrainOutput(global_step=233, training_loss=3.3132195984345136, metrics={'train_runtime': 4321.001, 'train_samples_per_second': 0.863, 'train_steps_per_second': 0.054, 'total_flos': 2.225441122839429e+17, 'train_loss': 3.3132195984345136, 'epoch': 0.9989281886387996})训练完成后,打开 SwanLab ,可以查看训练过程中记录的参数和可视化的训练 loss 曲线:
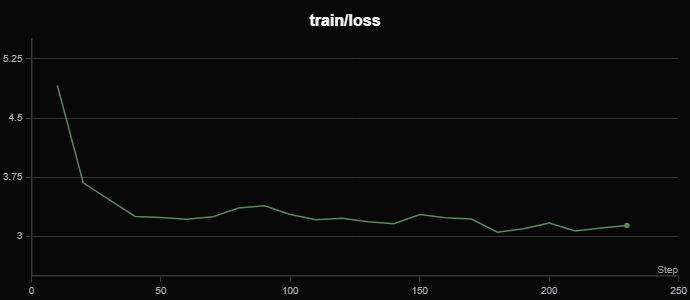
示例的训练记录公开链接如下,供参考
加载 lora 权重推理
得到任意 checkpoints 之后加载 lora 权重进行推理:
from transformers import AutoModelForCausalLM, AutoTokenizer
import torch
from peft import PeftModel

mode_path = '/root/autodl-tmp/Tencent-Hunyuan/Hunyuan-A13B-Instruct' #这里修改实际的模型路径
lora_path = '/root/output/Hunyuan-A13B-Instruct/checkpoint-233' # 这里改称你的 lora 输出对应 checkpoint 地址

# 加载tokenizer
tokenizer = AutoTokenizer.from_pretrained(mode_path, trust_remote_code=True)

# 加载模型
model = AutoModelForCausalLM.from_pretrained(mode_path, device_map="auto",torch_dtype=torch.bfloat16, trust_remote_code=True)

# 加载lora权重
model = PeftModel.from_pretrained(model, model_id=lora_path)
import re
messages = [
    {"role": "user", "content": "who are you?"},
]
tokenized_chat = tokenizer.apply_chat_template(messages, tokenize=True, return_tensors="pt",
                                                enable_thinking=False # Toggle thinking mode (default: True)
                                                )

outputs = model.generate(tokenized_chat.to(model.device), max_new_tokens=4096)


output_text = tokenizer.decode(outputs[0])

answer_pattern = r'<answer>(.*?)</answer>'
answer_matches = re.findall(answer_pattern, output_text, re.DOTALL)

answer_content = [match.strip() for match in answer_matches][0]
print(f"answer_content:{answer_content}\n\n")answer_content:I'm HunYuan, Tencent's AI assistant. I'm here to help you with any questions or tasks you have. How can I assist you today?