01 GLM-5.2 技术报告解读:从 GLM-5 到长上下文 Agentic Engineering
1 模型介绍
GLM-5.2 是智谱面向长程任务推出的开源混合专家(MoE)模型,总参数量约为 753B。它延续了 GLM-5 系列的 MLA、DSA 和 MTP 设计,并进一步引入 IndexShare,以降低超长上下文下的索引计算开销。
1.1 模型架构预览
下面是经过省略后的 GLM-5.2 关键配置:
{
  "architectures": [
    "GlmMoeDsaForCausalLM"
  ],
  "model_type": "glm_moe_dsa",
  "dtype": "bfloat16",
  "num_hidden_layers": 78,
  "hidden_size": 6144,
  "num_attention_heads": 64,
  "max_position_embeddings": 1048576,
  "mlp_layer_types": [
    "dense",
    "dense",
    "dense",
    "sparse",
    "sparse"
    // 后续重复的 sparse 项省略
  ],
  "n_routed_experts": 256,
  "n_shared_experts": 1,
  "num_experts_per_tok": 8,
  "moe_intermediate_size": 2048,
  "q_lora_rank": 2048,
  "kv_lora_rank": 512,
  "qk_head_dim": 256,
  "qk_nope_head_dim": 192,
  "qk_rope_head_dim": 64,
  "v_head_dim": 256,
  "index_topk": 2048,
  "index_topk_freq": 4,
  "index_head_dim": 128,
  "index_n_heads": 32,
  "index_share_for_mtp_iteration": true,
  "indexer_types": [
    "full",
    "full",
    "full",
    "shared",
    "shared",
    "shared",
    "full",
    "shared"
    // 后续重复项省略
  ],
  "num_nextn_predict_layers": 1,
  "vocab_size": 154880
}从配置上看,GLM-5.2 并不是完全更换基础架构,而是在 GLM-5.1 已有的 glm_moe_dsa 架构上继续演进。两者都保留了 MoE、MLA、DSA 和 MTP 等核心结构,并且在层数、隐藏维度、专家数量、每 token 激活专家数、MLA 的 KV latent 维度以及 DSA Top-K 选择规模上基本一致。
在这个基础上,GLM-5.2 的变化主要体现在两个方向:一是上下文窗口从 GLM-5.1 的约 200K token 扩展到 GLM-5.2 的约 1M token;二是 GLM-5.2 增加了与 IndexShare 相关的配置,它在每四个稀疏注意力层中复用同一个索引器,降低长上下文下的重复索引开销。
1.2 GLM-5.2 的主要能力
GLM-5.2 的主要能力体现在长程工程任务、代码与智能体执行以及灵活的推理控制三个方面。凭借稳定的 100 万 token 上下文,模型能够在大型代码实现、自动化研究、性能优化和复杂调试等长轨迹任务中持续保持任务状态并完成多步骤操作;同时,它具备代码库理解与修改、终端操作、工具调用和复杂软件工程任务执行能力,并支持多档思考强度,使用户能够根据任务难度在执行效果、推理速度和计算成本之间进行权衡。
1.2.1 效果对比

GLM-5.2 在三项长程工程评测里均为表现最好的开源模型,其中 FrontierSWE 和 PostTrainBench 接近 Opus 4.8,但在 SWE-Marathon 上仍有明显差距。
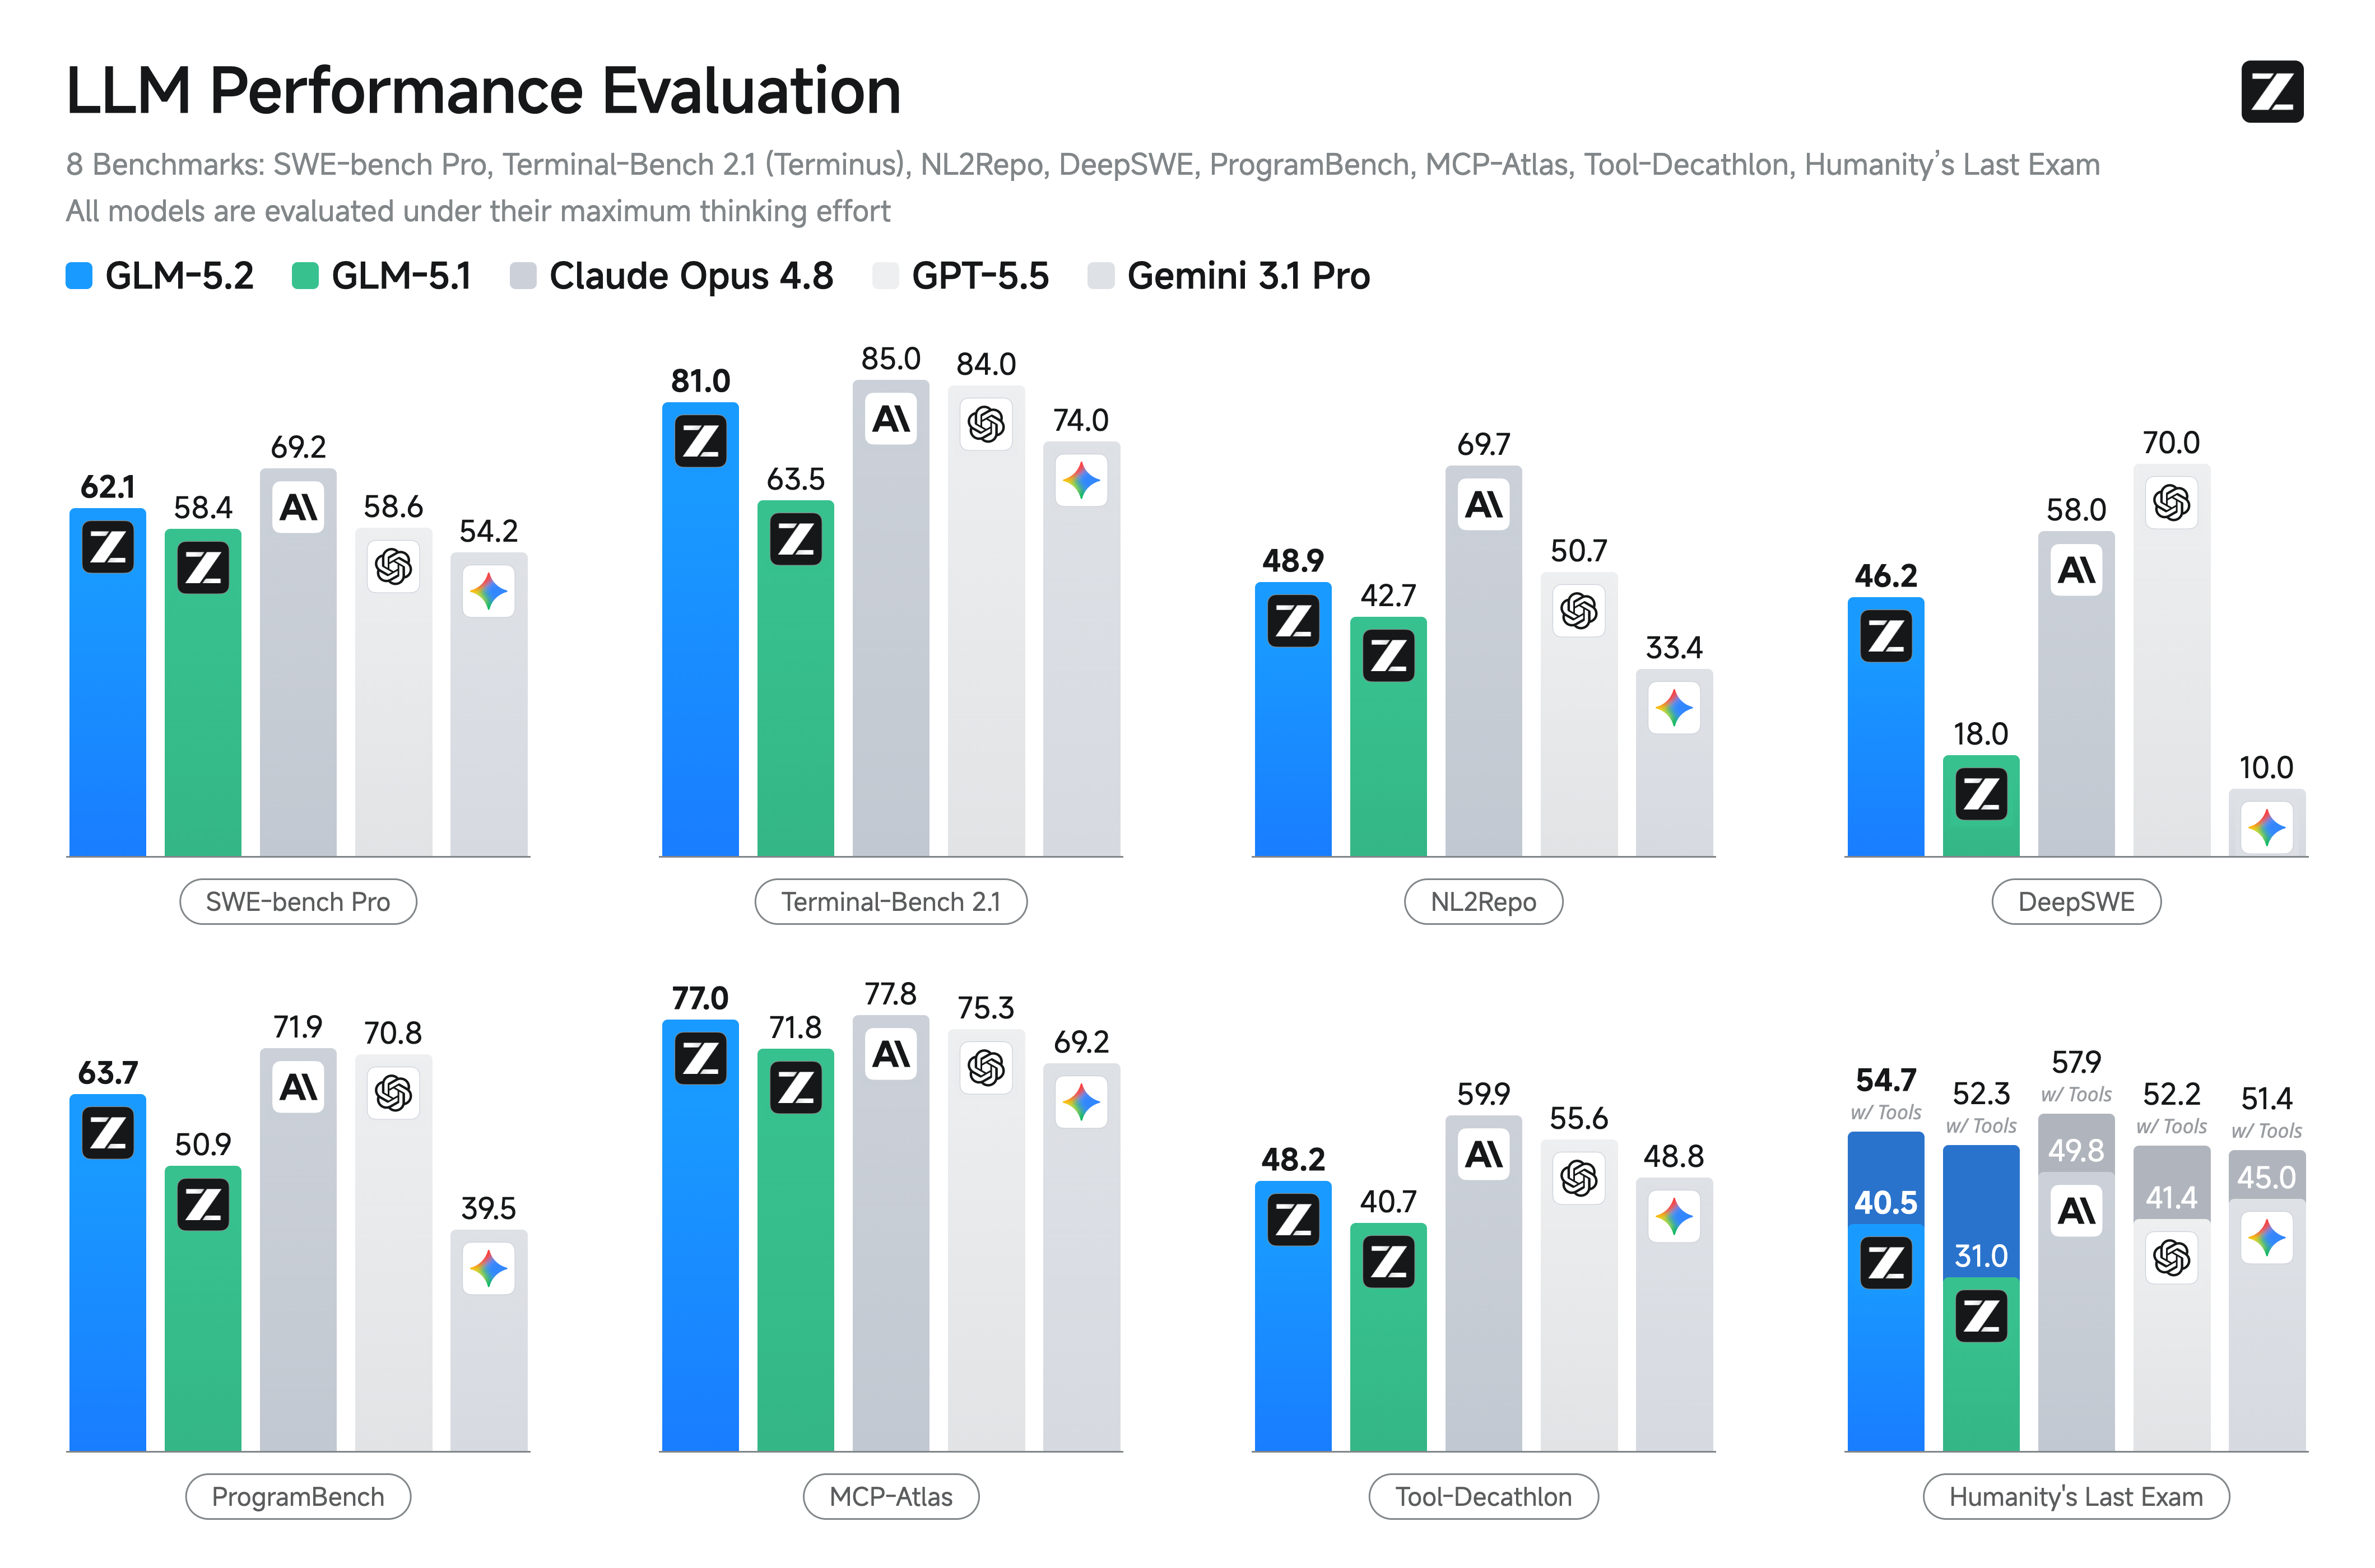
GLM-5.2 在代码、终端操作、仓库理解和工具调用等任务上表现较为均衡,其中 Terminal-Bench 2.1 和 MCP-Atlas 已接近前沿闭源模型,但在 DeepSWE、NL2Repo 和 Tool-Decathlon 等复杂任务上仍有明显提升空间。
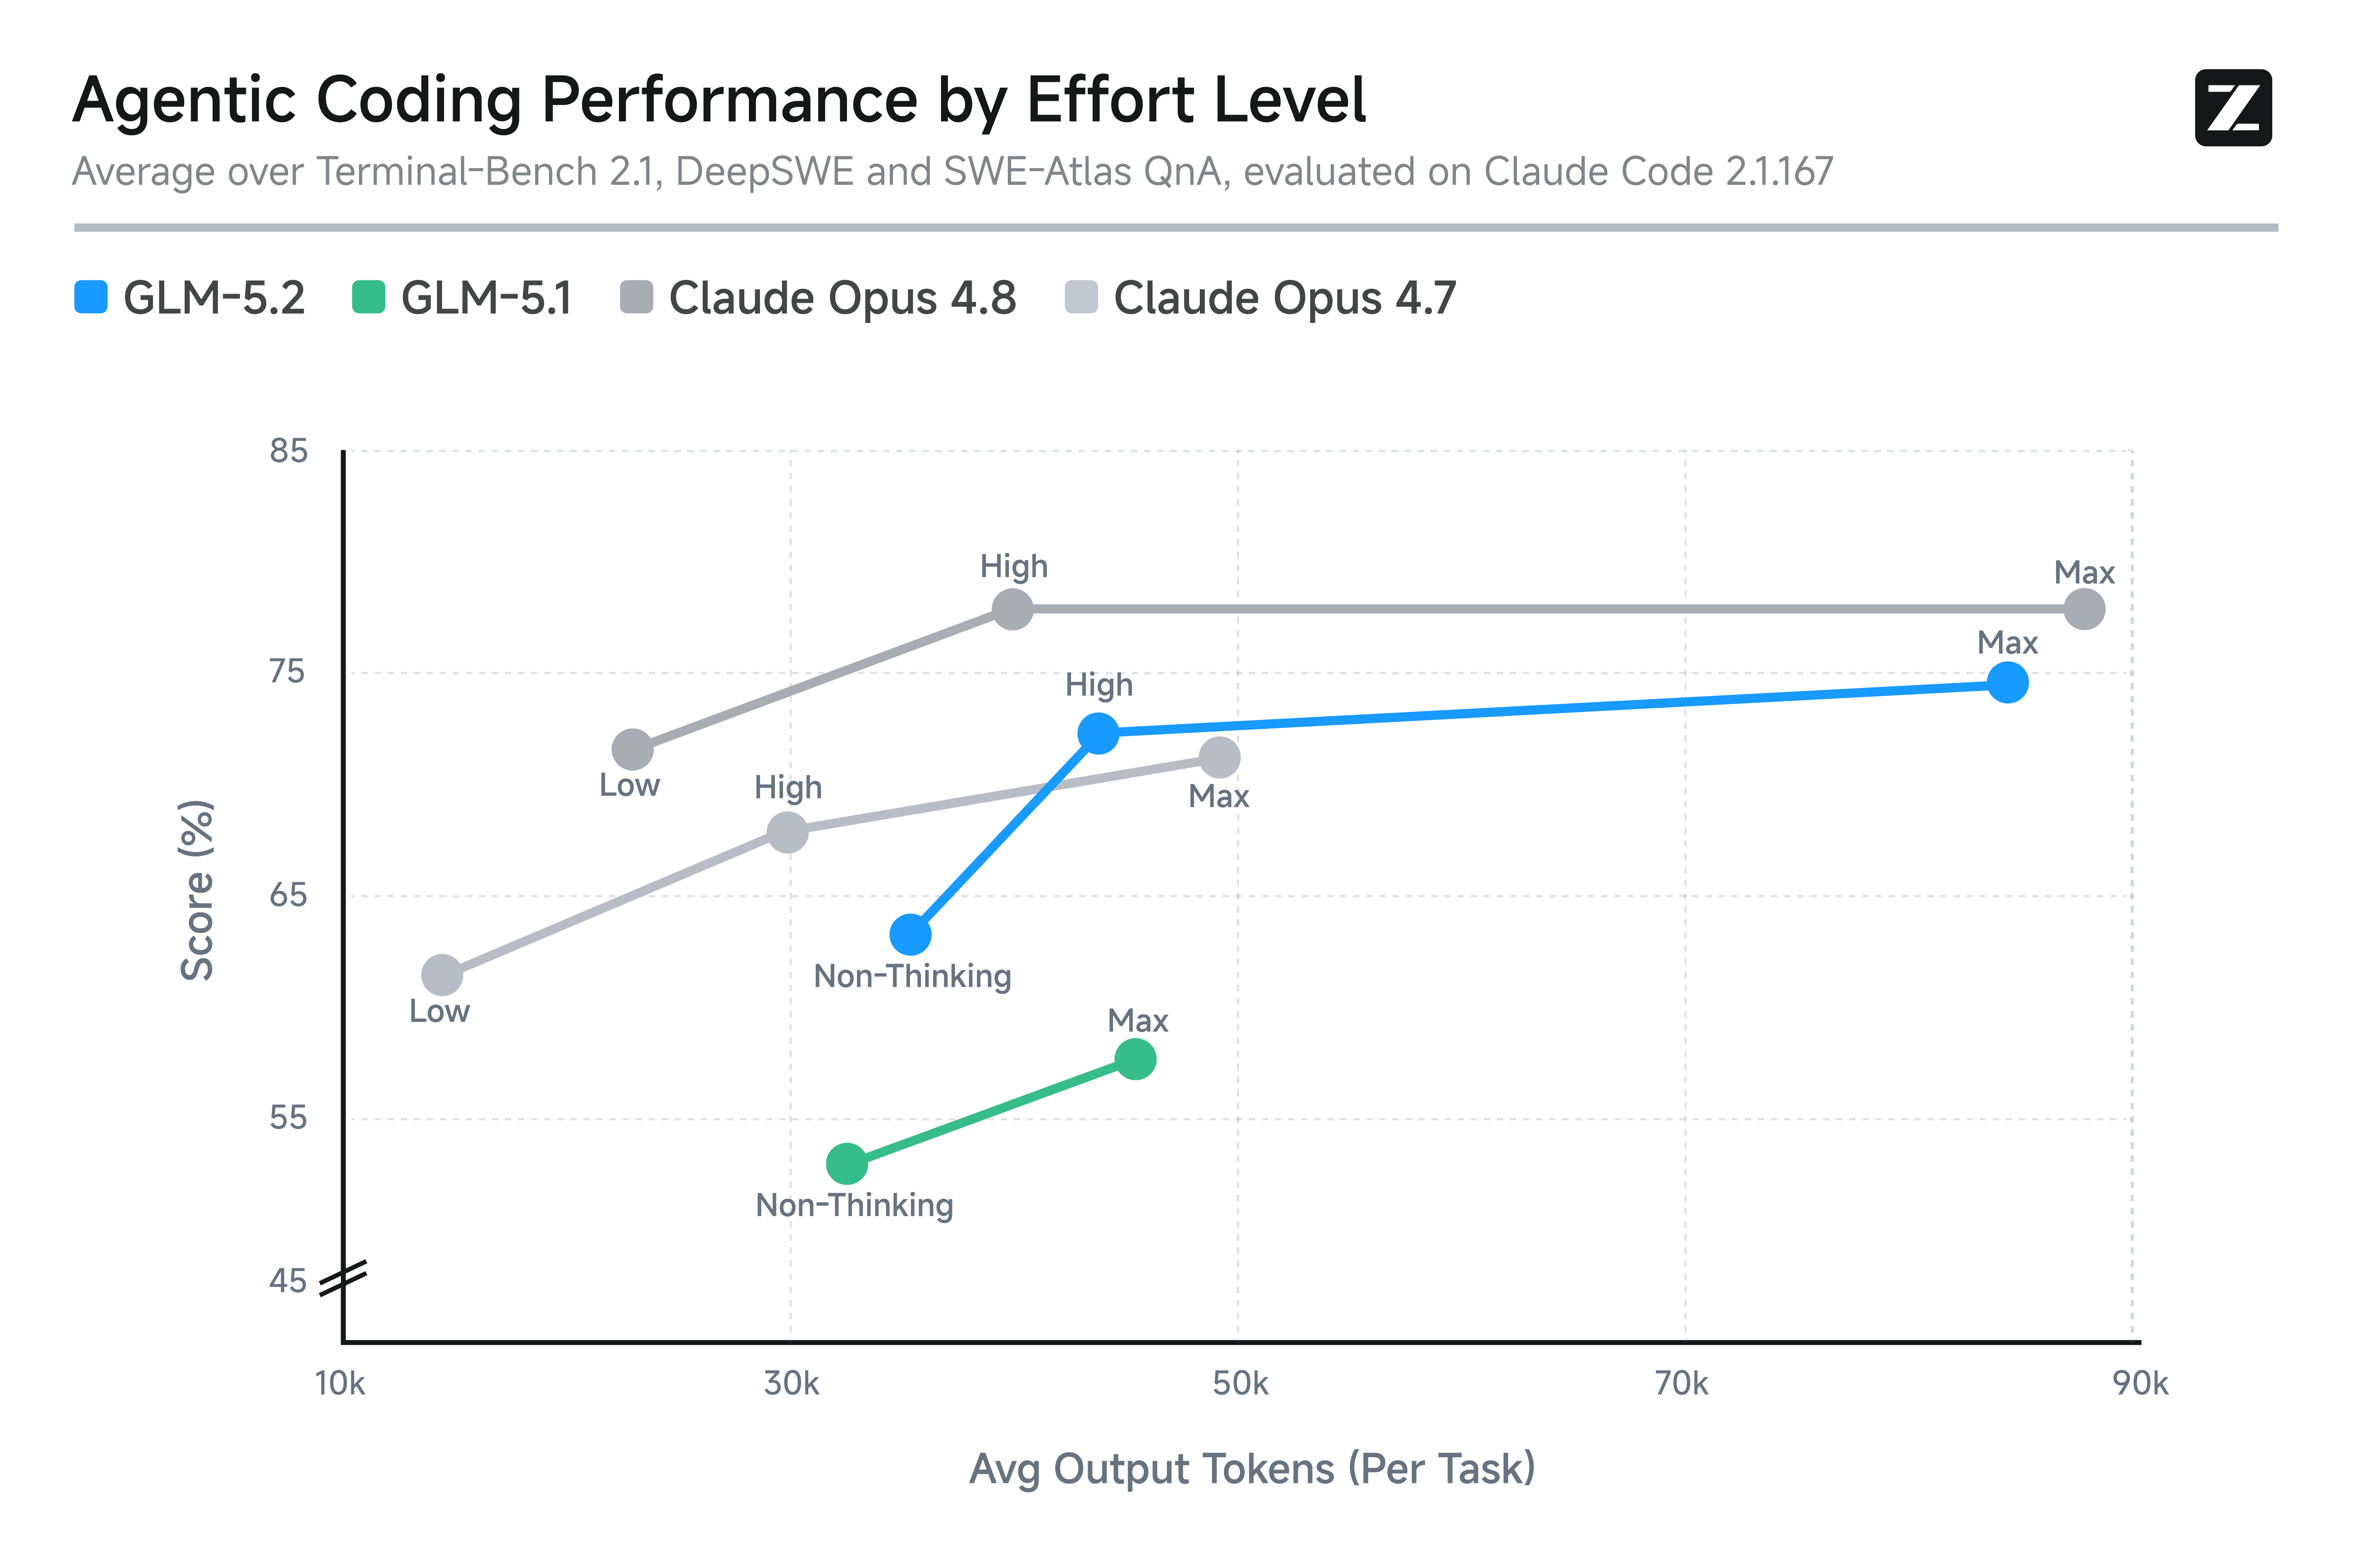
GLM-5.2 可以通过调节思考强度,在任务效果、执行速度和计算成本之间进行权衡;在相近的 token 预算下,其 Agentic Coding 能力明显高于 GLM-5.1,整体表现大致位于 Claude Opus 4.7 与 Claude Opus 4.8 之间。
2 GLM-5.2 核心架构更新
2.1 稀疏注意力(DSA)的跨层索引共享(IndexShare)
GLM-5 采用了 DeepSeek-V3.2 提出的 DeepSeek Sparse Attention(DSA,稀疏注意力),并通过持续预训练将其适配到自身的多头潜在注意力(MLA)架构中。在此基础上,GLM-5.2 针对多层网络重复执行索引计算的问题,进一步引入跨层索引共享机制 IndexShare。
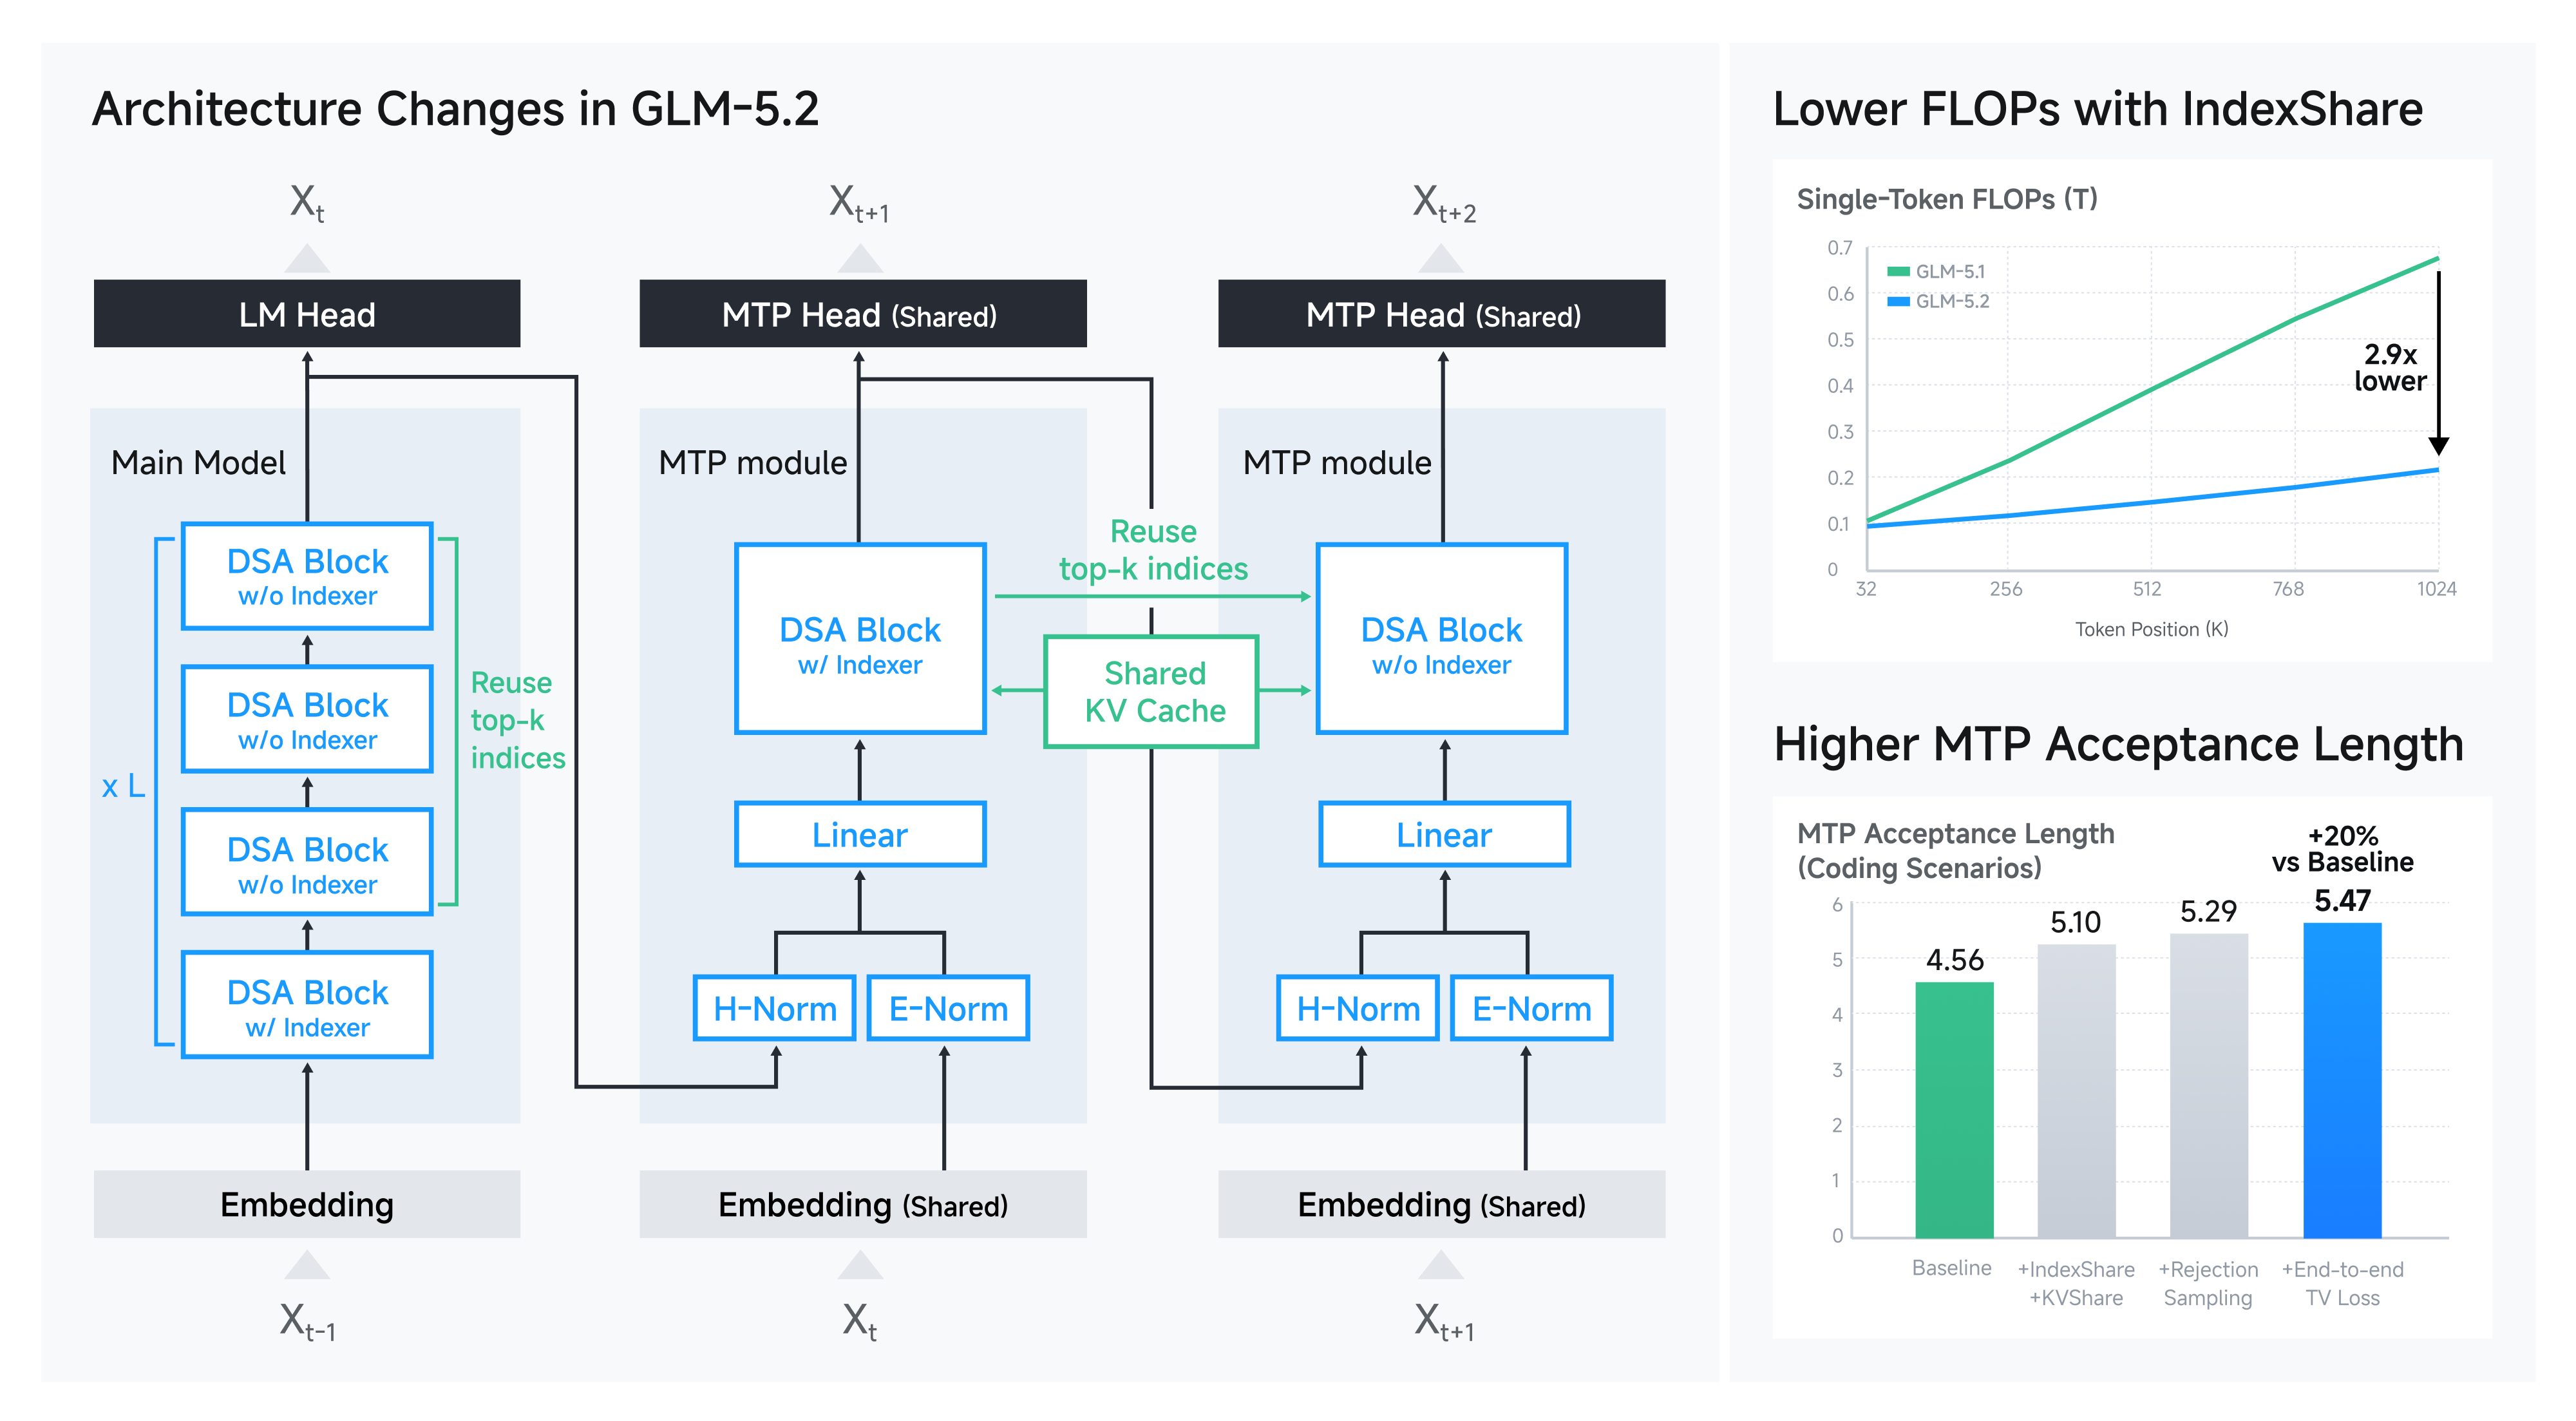
在理解 IndexShare 之前,我们先来回顾一下 DSA 中的 Lightning Indexer。它是位于稀疏注意力计算之前的轻量级索引模块,用于快速计算当前 query token 与历史 token 的相关性分数,并从中选出 Top-K 个重要位置,使注意力模块仅需读取并计算这些位置对应的 KV,从而降低长上下文注意力的计算开销。
Lightning Indexer 根据当前 query token 的 hidden state $h_t$ 和第 $s$ 个历史 token 的 hidden state $h_s$,计算索引分数 $I_{t,s}$。该分数用于估计历史位置 $s$ 对当前注意力计算的重要程度:
I_{t,s}
=
\sum_{j=1}^{H^I}
w^I_{t,j}
\cdot
\mathrm{ReLU}
\left(
\left(\mathbf{q}^I_{t,j}\right)^\top
\mathbf{k}^I_s
\right)Lightning Indexer 根据索引分数,从可见的历史位置中选出得分最高的 $k$ 个位置:
\mathcal{S}_t
=
\mathrm{TopK}_{s \leq t}
\left(
I_{t,s},k
\right)其中,$\mathcal{S}_t$ 表示针对位置 $t$ 选出的历史位置集合。Lightning Indexer 以较低成本计算当前 query 与历史位置之间的索引分数,随后,注意力模块仅对集合 $\mathcal{S}_t$ 中对应的 Key 和 Value 执行稀疏注意力计算,从而降低长上下文场景下的计算开销。
在 Transformers 的 GLM-5.2 实现中,IndexShare 的核心逻辑位于注意力层的 forward 方法中,代码如下:
# ===== Indexer (DSA sparse mask) =====
# attention_mask is [B, 1, S, T] (4D) for eager and (2D) otherwise but indexer works with [B, S, T] (3D)
if not self.skip_topk or prev_topk_indices is None:
    indexer_mask = (
        attention_mask[:, 0, :, :]
        if attention_mask is not None and attention_mask.dim() == 4
        else attention_mask.unsqueeze(1)
        if attention_mask is not None
        else None
    )
    topk_indices = self.indexer(
        hidden_states,
        q_resid,
        position_embeddings,
        indexer_mask,
        use_cache=past_key_values is not None,
    )  # [B, S, topk]
else:
topk_indices = prev_topk_indices # [B, S, topk]当前层需要执行完整索引计算或尚无可复用结果时,模型调用 self.indexer(...) 生成 topk_indices;否则,当前层直接使用 prev_topk_indices,跳过 Lightning Indexer 的点积与 Top-K 操作。结合 index_topk_freq = 4,每组 4 个层只需执行一次索引计算,从而减少其余 3 个层的 Indexer 计算开销。
2.2 多步 MTP 的效率与接受率优化
2.2.1 索引共享(IndexShare)与键值缓存复用(KVShare)
GLM-5 在 DeepSeek-V3 的 MTP 设计基础上,将训练阶段的 MTP 展开为 3 个连续预测步骤,并让这 3 个逻辑 MTP layers 共享同一套参数,从而在保持与 DeepSeek-V3 单层 MTP draft model 基本相同的参数量和权重显存成本下,增强连续多 token 预测能力并提高推测解码的接受率。
GLM-5.2 从计算效率和接受率两个方面进一步优化了多步 MTP:仅在第一个预测步骤运行 Indexer,后续步骤复用其 Top-K 索引,并在训练时同步复用第一步的 KV Cache。
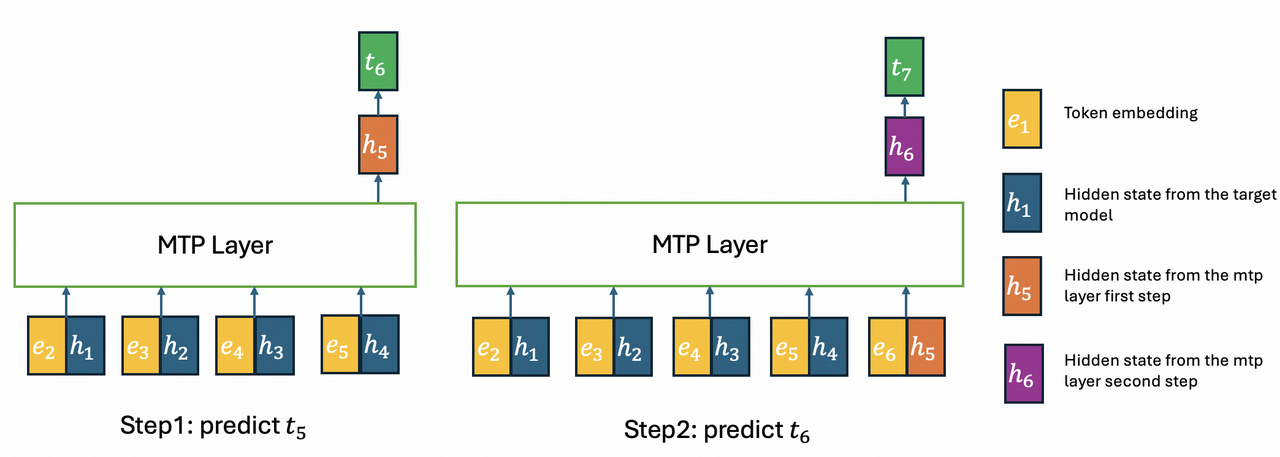
如图所示,第一次 MTP 预测使用的 $h_1$ 到 $h_4$ 全部来自主模型,并根据这些隐藏表示计算 Top-K 索引和 KV Cache,再结合 $e_5$ 与 $h_4$ 生成 MTP 隐藏表示 $h_5$;进入第二个预测步骤后,$h_5$ 仍会与 $e_6$ 一起作为当前输入生成新的 query,但模型不再重新运行 Indexer,也不会将 $h_5$ 加入可关注的历史 KV,而是直接复用第一步从 $h_1$ 到 $h_4$ 中选出的 Top-K 索引及其 KV Cache。这样既能减少后续 MTP 步骤中的 Indexer 点积和 Top-K 开销,又能避免 MTP 生成的中间状态作为历史 KV 被反复引用,从而使训练与推理阶段使用的历史注意力上下文保持一致(不再引入来源不同的 MTP 隐藏状态作为历史 KV),并提高推测解码的接受率。
2.2.2 拒绝采样与端到端总变差损失(e2e TV Loss)
Bebop 是 Qwen 团队提出的 MTP 优化方法,主要用于解决强化学习 rollout 过程中主模型输出熵发生变化、导致 MTP 草稿 token 接受率下降的问题。当主模型的输出分布熵较高时,概率会分散到多个合理 token 上,即使 MTP 的整体分布已经接近主模型,两个模型的最高概率 token 也可能不同,导致接受率下降。Bebop 改用概率拒绝采样:首先从草稿分布 $q$ 中采样候选 token,再按照以下概率决定是否接受:
\hat{y}\sim qP_{\mathrm{accept}}(\hat{y})
=
\min
\left(
1,
\frac{p(\hat{y})}{q(\hat{y})}
\right)拒绝采样的期望接受率等于主模型与草稿模型概率分布的重合程度:
\alpha_{\mathrm{RS}}
=
\sum_y
\min
\left(
p(y),q(y)
\right)
=
1-d_{\mathrm{TV}}(p,q)其中,总变差距离定义为:
d_{\mathrm{TV}}(p,q)
=
\frac{1}{2}
\sum_y
\left|
p(y)-q(y)
\right|因此,减小主模型与草稿模型之间的总变差距离,就等价于提高拒绝采样的期望接受率。传统交叉熵和 KL 散度只能间接约束这一距离,Bebop 因此提出直接最小化总变差距离的 TV Loss:
\mathcal{L}_{\mathrm{TV}}
=
d_{\mathrm{TV}}(p,q)
=
1-
\sum_y
\min
\left(
p(y),q(y)
\right)对于包含 $\gamma$ 个预测步骤的多步 MTP,前面的 token 一旦被拒绝,后面的草稿 token 也无法继续接受,因此其期望接受长度为:
\mathbb{E}[L]
=
\sum_{j=1}^{\gamma}
\prod_{i=1}^{j}
\left(
1-d_{\mathrm{TV}}(p_i,q_i)
\right)在此基础上,Bebop 提出端到端总变差损失(e2e TV Loss):
\mathcal{L}_{\mathrm{e2e}}
=
1-
\frac{1}{\gamma}
\sum_{j=1}^{\gamma}
\prod_{i=1}^{j}
\left(
1-d_{\mathrm{TV}}(p_i,q_i)
\right)该目标不再单独优化每个 MTP 步骤,而是直接优化整个多步推测解码过程的期望接受长度,并自然提高前面预测步骤的重要性。
GLM-5.2 借鉴了 Qwen 团队提出的 Bebop 方法:在训练阶段使用端到端总变差损失,核心就是通过最小化 TV 距离,让 MTP 的概率分布尽量贴近主模型的概率分布,从而提高草稿 token 在拒绝采样中的接受率。推理时,系统按照 $\min(1, p(\hat{y})/q(\hat{y}))$ 的概率接受 MTP 生成的草稿 token;若草稿 token 被拒绝,则从目标分布与草稿分布的正残差中重新采样。这样可以在保持最终生成结果服从目标模型分布的同时,提高草稿 token 的复用率。
3 面向 100 万 token 上下文的推理系统优化
随着 GLM-5.2 将上下文窗口扩展到 100 万 token,推理瓶颈逐渐从单纯的 GPU 计算转向 KV Cache 容量、长上下文算子和 CPU 调度开销。由于每个 token 的 KV Cache 大小并未随计算量同步下降,因此需要进一步优化推理系统,才能在有限 GPU 资源下兼顾超长上下文、并发能力和 token 吞吐量。
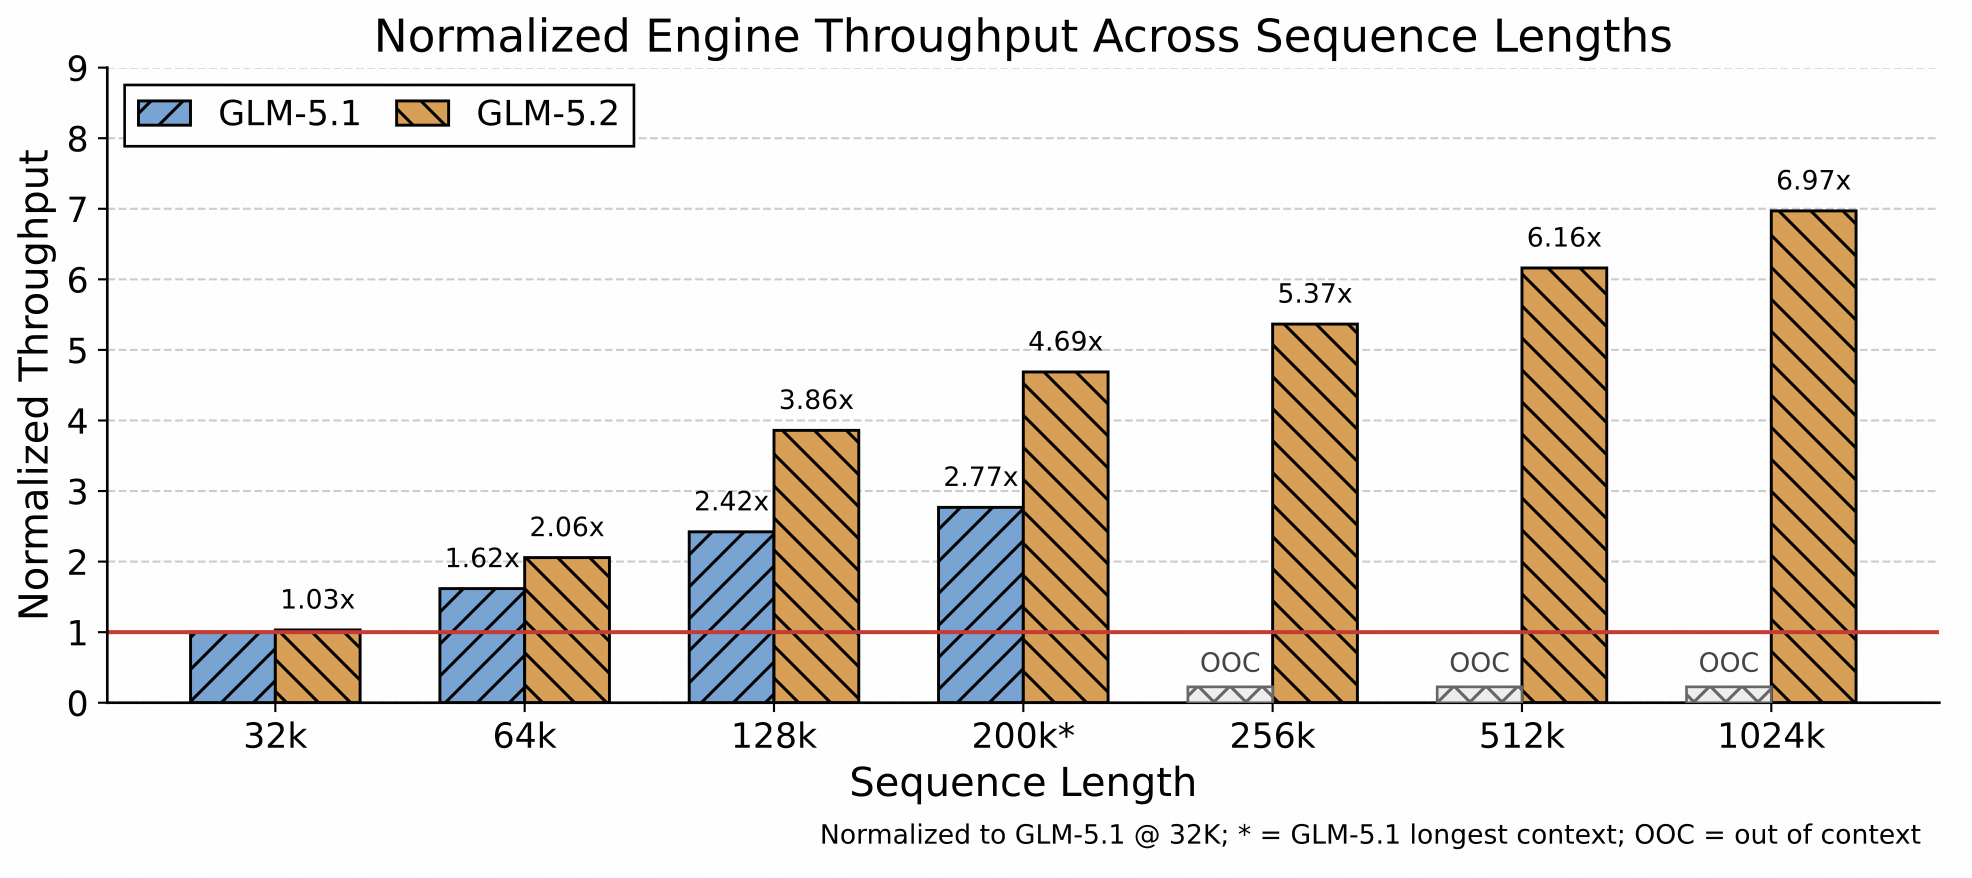
显存层面,基于 LayerSplit 进一步细化内存管理与并行策略,为 KV Cache 释放更多可用空间;在 GPU 层面,针对开销随上下文长度增长的算子进行优化,并协调算子执行与缓存传输,降低数据搬运对预填充和解码的影响;在 CPU 层面,则优化缓存管理、请求调度和运行时执行路径,减少 GPU 等待造成的流水线空闲。
4 GLM-5.2 后训练体系
4.1 slime:智能体强化学习基础设施
在 GLM 系列中,slime 已在 GLM-4.5 中用于强化学习后训练;GLM-5 延续这一框架,并将其作为统一的后训练基础设施。它主要用于解决强化学习训练中 rollout 数据生成效率低、长程智能体轨迹阻塞同步训练,以及不同任务和智能体框架难以接入同一训练流程的问题。slime 的核心架构如下图所示:
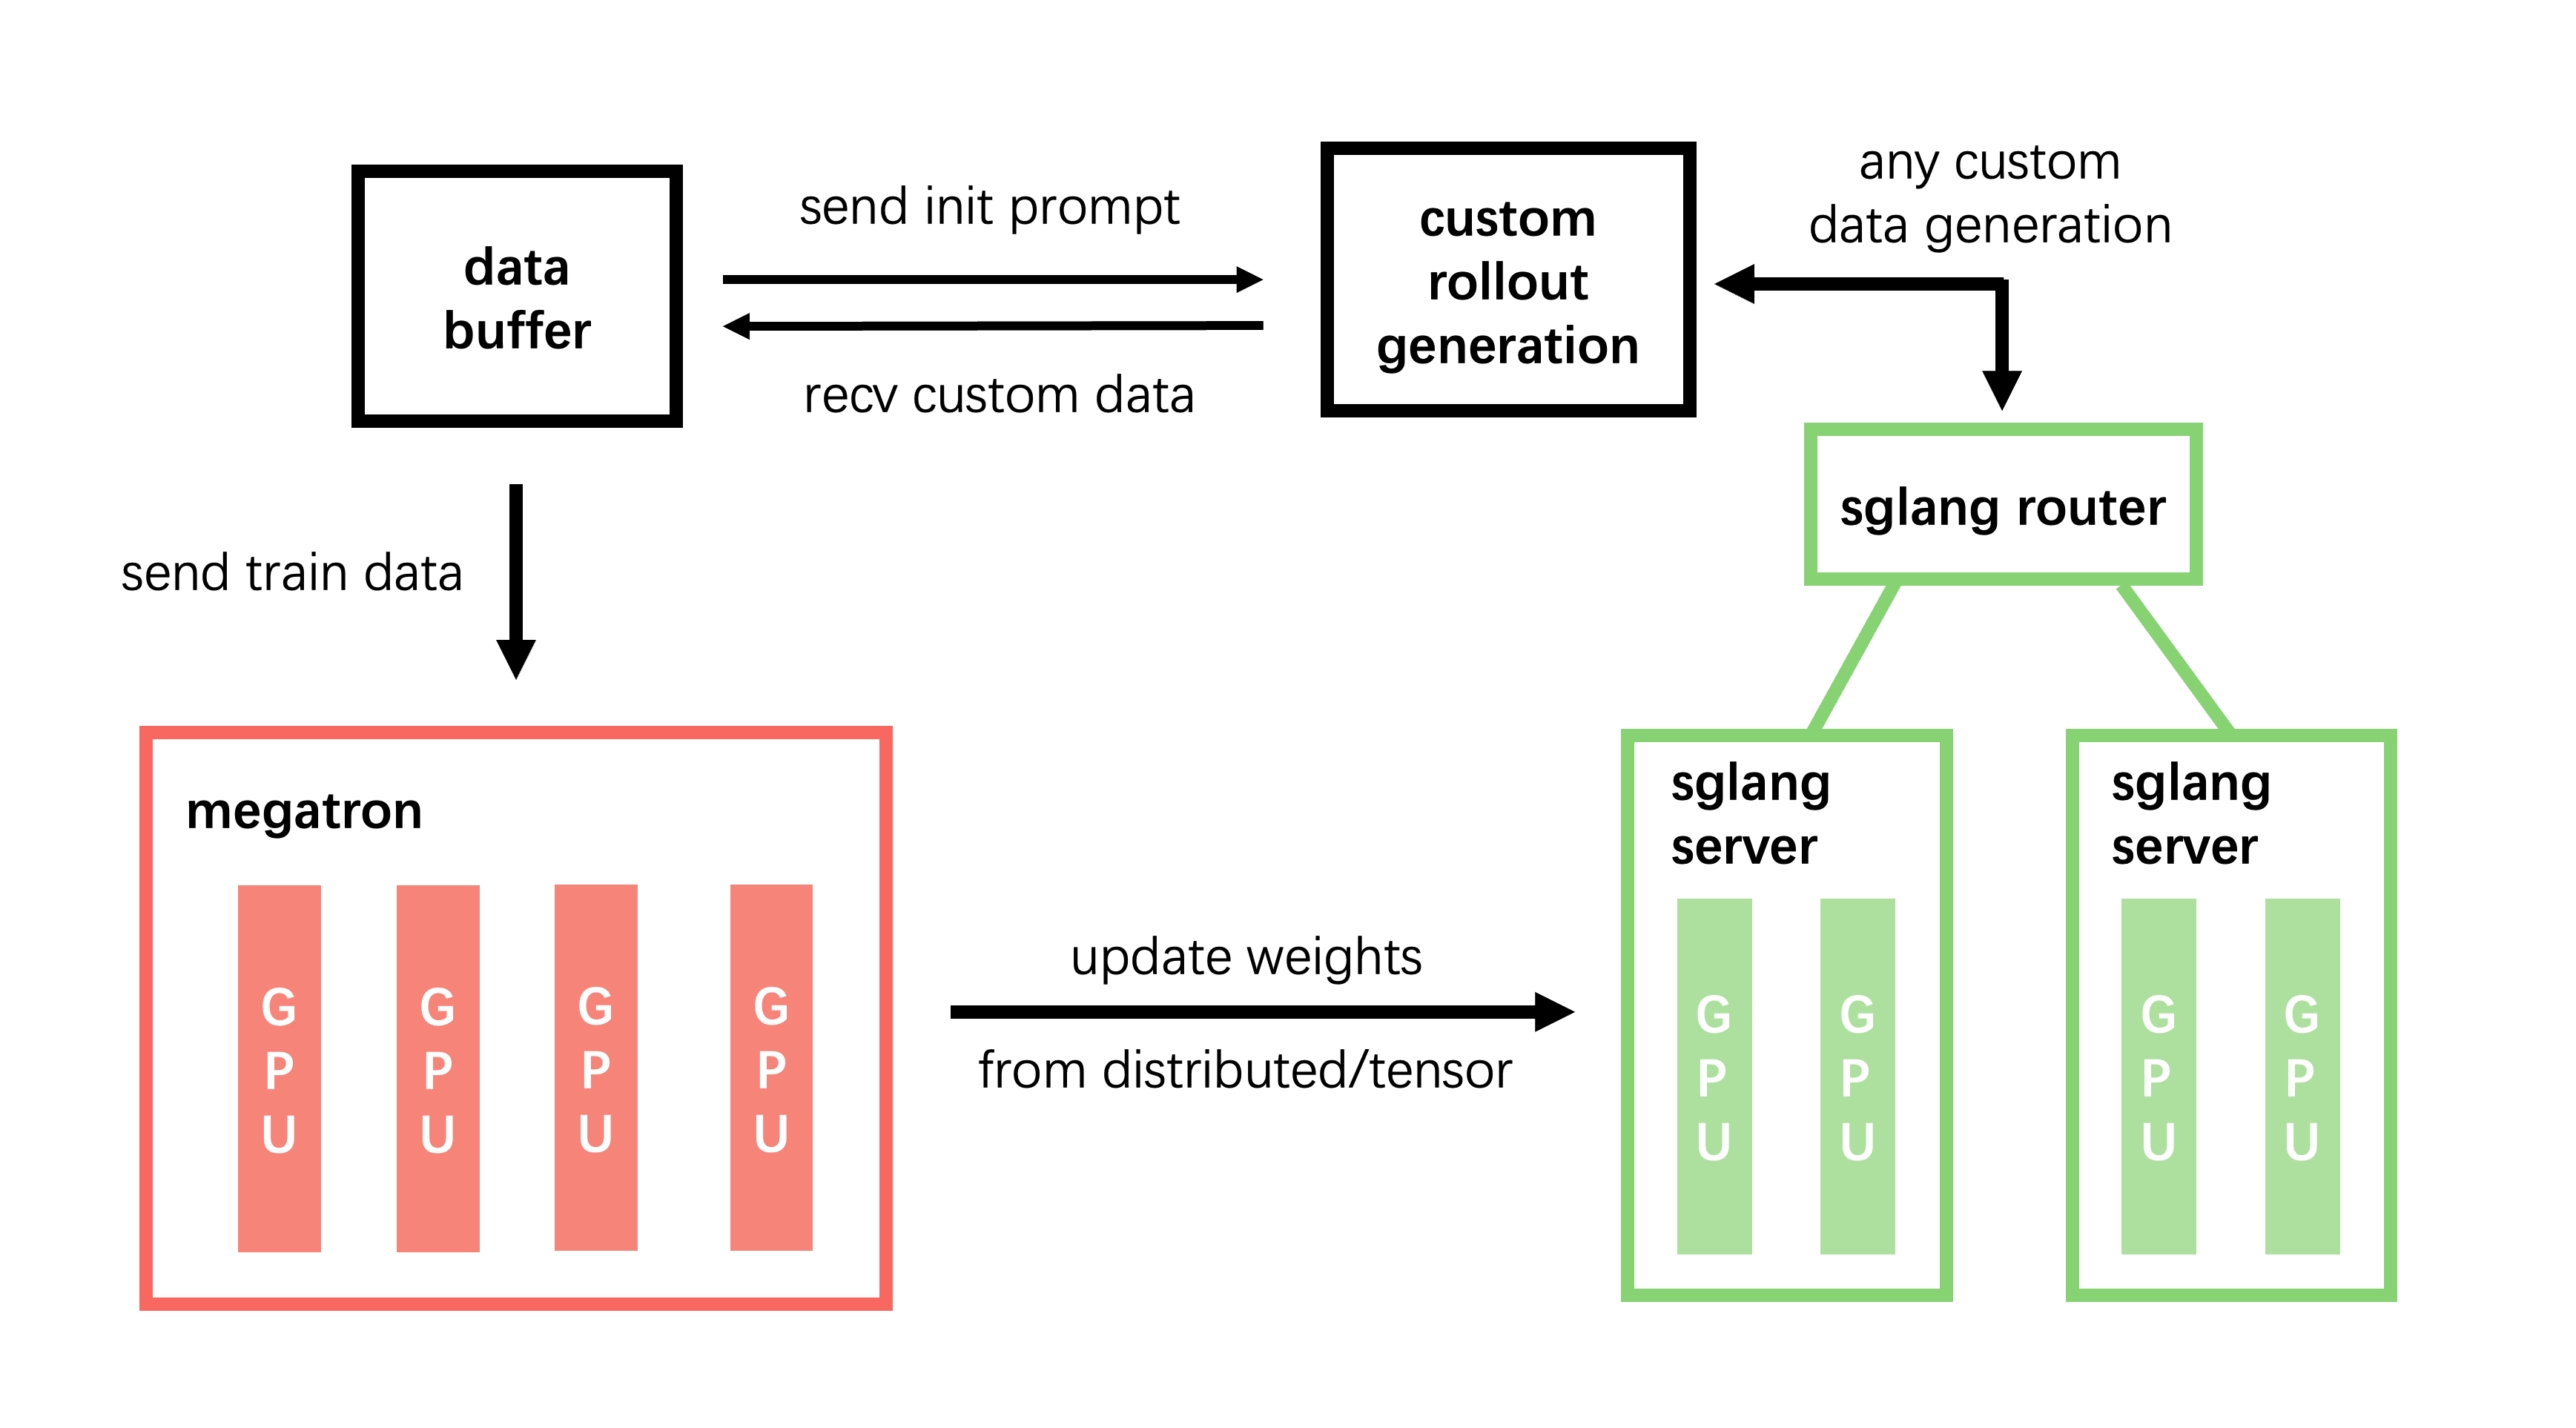
slime 主要由训练模块、rollout 模块和数据缓冲区三个部分组成。这种设计将任务相关的 rollout 逻辑、模型推理和参数训练相互解耦:不同任务只需实现自己的数据生成与奖励逻辑,就可以通过统一接口接入系统;多个 SGLang server 可以并行生成轨迹,缓解 rollout 吞吐瓶颈;训练引擎和推理引擎还可以部署在不同 GPU 上异步运行,使较长或较慢的智能体轨迹不会阻塞整个训练过程。
GLM-5 并没有为 slime 引入新的系统组件,而是继续将其作为统一的后训练基础设施,重点利用其在任务接入、rollout 吞吐、长尾延迟优化、故障容错和多任务编排等方面的能力。
其中,在复杂智能体训练方面,GLM-5.2 进一步扩展了 slime 的能力:它既支持可以访问模型概率等内部信息的“白盒 rollout”,也支持只通过 API 获取结果的“黑盒 rollout”;对于过长的执行过程,可以通过“轨迹压缩”将历史信息整理成更短的子轨迹继续训练;对于复杂任务,还可以使用“子智能体工作流”,让主智能体把不同子任务交给多个子智能体执行。在此基础上,GLM-5.2 使用并行在线策略蒸馏(OPD),将十余个擅长不同领域的专家模型所具备的能力集中训练到一个最终模型中。
系统层面,slime 会分别创建 prefill 和 decode 两组 SGLang 推理服务,并由 Router 负责请求转发,从而将计算密集的预填充阶段与访存密集的逐 token 解码阶段部署到不同设备上,同时将对应的 SGLang 服务组织为不同的 worker group;其次,slime 支持使用 FP8 存储 KV Cache,以更低的显存占用容纳更长的生成轨迹和更多并发请求。这些机制共同缓解了长轨迹生成中的 KV Cache 容量、阶段负载不均和训练/推理资源利用问题。
4.2 编码智能体强化学习中的反作弊机制
编码强化学习通常使用测试是否通过作为奖励信号,因此模型可能不去真正解决问题,而是通过读取隐藏测试文件、复制参考答案、查找上游提交或直接下载目标源码等方式获得高分。这类行为虽然能够提高训练和评测奖励,却没有提升模型的实际编码能力,还会污染强化学习的训练信号。GLM-5.2 在训练和评测过程中引入了在线反作弊机制:首先使用规则过滤器尽可能识别可疑工具调用,再由大语言模型裁判判断其真实意图。确认作弊后,系统会拦截对应调用并返回无效信息,但不会终止整条 rollout,使智能体仍可继续完成任务。这样既能阻止模型利用捷径获取奖励,也能避免直接丢弃轨迹所导致的训练不稳定。
5 参考资料
GLM-5: From Vibe Coding to Agentic Engineering
GLM-5.2 官方技术博客
GLM-5.2 模型卡
Transformers:GLM MoE DSA 实现
Bebop: Breaking Entropy Bounds
THUDM/slime
02 GLM-5.2 vLLM 部署调用
1 vLLM 简介
vLLM 框架是一个高效的大语言模型推理和部署服务系统,具备以下特性:
高效的 KV Cache 管理与请求调度:vLLM 通过 PagedAttention、连续批处理和异步调度提高显存利用率与请求吞吐量。
GLM-5.2 架构支持:vLLM 原生支持 GLM-5.2 使用的 glm_moe_dsa 架构,并支持 DSA 稀疏注意力、张量并行和专家并行。
MTP 推测解码加速:GLM-5.2 内置 MTP 层,vLLM 可以直接使用其连续生成多个草稿 token,再由主模型并行验证,无需加载额外的草稿模型。
推理控制与工具调用:vLLM 提供兼容 OpenAI API 的服务接口,并可通过 glm45 reasoning parser 解析思考内容,通过 glm47 tool-call parser 和自动工具选择支持 GLM-5.2 的工具调用与智能体工作流。
GLM-5.2官方明确说明模型权重支持多种本地部署与推理框架,包括SGLang(v0.5.13.post1+)、vLLM(v0.23.0+)、Transformers、KTransformers和Unsloth等。同时,面向华为昇腾Ascend NPU平台,也支持通过vLLM-Ascend、xLLM、SGLang等框架进行推理部署。本教程使用vLLM进行部署,文中的启动日志与接口返回均为实测真实输出。
2 GLM-5.2 架构
GLM-5.2 采用面向长上下文与 Agentic Engineering 的高效 MoE + DSA 架构:模型基于 DeepSeek Sparse Attention(DSA,稀疏注意力) 和 Multi-head Latent Attention(MLA,多头潜在注意力),通过 Lightning Indexer 为每个 query 动态选择最相关的 Top-K 历史 KV,而不是对全部历史 token 执行稠密注意力计算,从而降低 1M 长上下文场景下的注意力计算开销。
GLM-5.2 面向长程任务、复杂代码任务和工具调用场景,支持稳定的 1M-token context,并提供多档 thinking effort 以在性能与延迟之间做权衡。其模型类型为 glm_moe_dsa,部署时需要推理框架支持 DSA 稀疏注意力、IndexShare 与 MTP 阶段的索引复用逻辑,以及 GLM 系列 chat template。
由于该架构较新,请确保安装较新版本的推理框架。推荐使用
vLLM v0.23.0+,以保证对GLM-5.2、glm_moe_dsa模型类型、DSA 稀疏注意力和长上下文推理的兼容。本文使用 vLLM v0.25.0 从源码部署nvidia/GLM-5.2-NVFP4,具体启动参数见后文。
3 环境准备
在 AutoDL 平台租用一台配备 8 张 NVIDIA RTX PRO 6000 Blackwell Server Edition GPU 的实例,每张 GPU 显存为 96 GB。基础镜像依次选择 PyTorch → 2.12.1 → Python 3.12(Ubuntu 22.04) → CUDA 13.0,如下图所示。
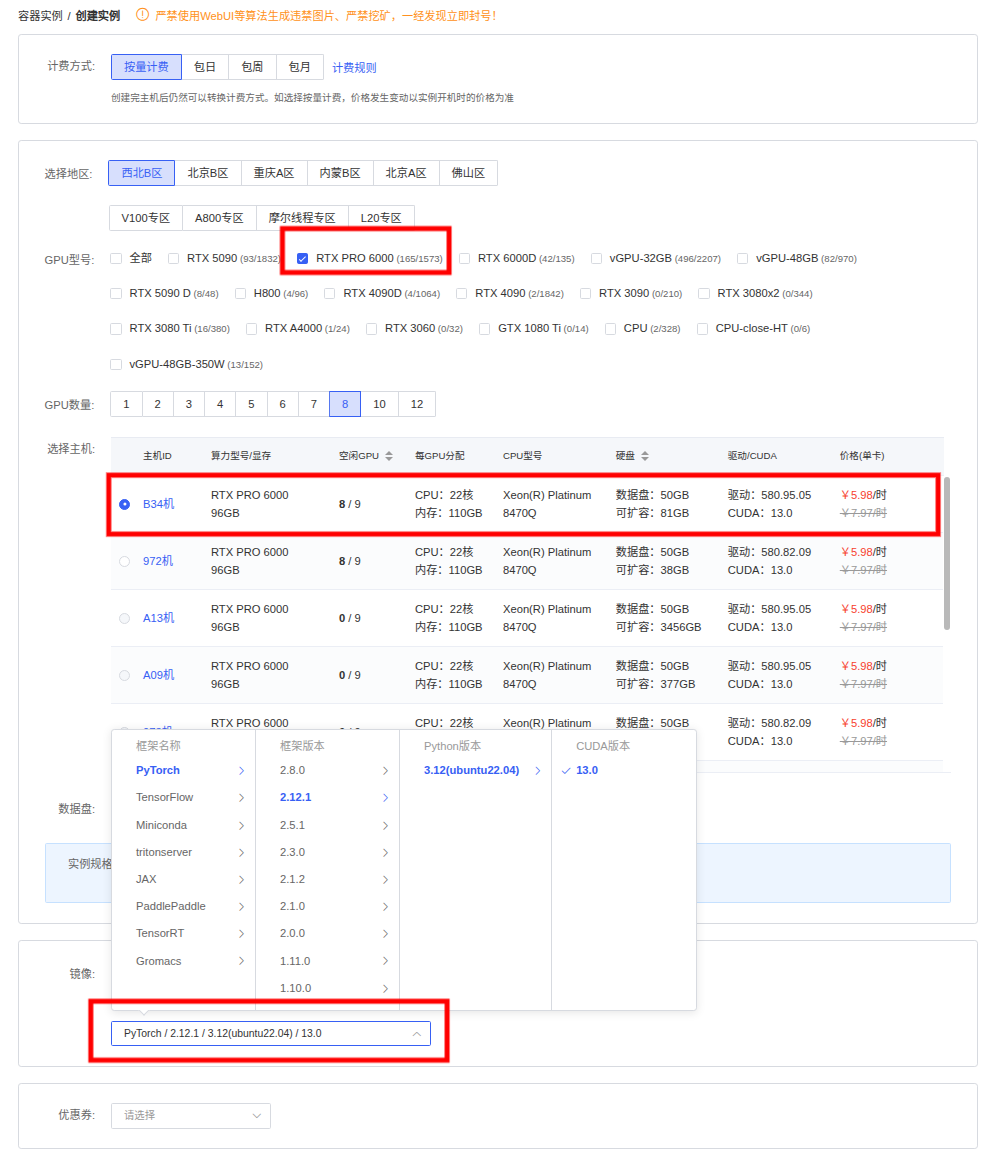
本教程使用基础镜像中已有的 PyTorch 和 CUDA Toolkit,并从源码编译安装 vLLM,因此需要先激活镜像预装的 CUDA 编译工具链。
cat >> ~/.bashrc <<'EOF'

# CUDA 13.0
export CUDA_HOME=/usr/local/cuda
export PATH="${CUDA_HOME}/bin:${PATH}"
export TRITON_PTXAS_PATH="${CUDA_HOME}/bin/ptxas"
EOF
source ~/.bashrc实测基础镜像环境如下:
----------------
Ubuntu 22.04.5 LTS
Python 3.12.3
NVIDIA 驱动 580.95.05
CUDA Toolkit 13.0
NVCC 13.0.88
PTXAS 13.0.88
GPU: NVIDIA RTX PRO 6000 Blackwell Server Edition(96G,SM120)
GCC 11.4.0
G++ 11.4.0
CMake 3.22.1
PyTorch 2.12.1+cu130
----------------4 模型下载
使用 Hugging Face Hub 提供的 hf download 命令下载模型。首先安装 Hugging Face Hub:
python -m pip install -U huggingface_hub下载 GLM-5.2 NVFP4 量化模型:
mkdir -p /autodl-fs/data/models/GLM-5.2-NVFP4

hf download nvidia/GLM-5.2-NVFP4 \
  --local-dir /autodl-fs/data/models/GLM-5.2-NVFP4 \
--max-workers 8注意:请根据实际存储路径修改
--local-dir,并确保目标磁盘有足够的可用空间。
5 代码编译安装
source /etc/network_turbo安装从源码编译 vLLM 所需的外部依赖 Triton 和 flash-attention:
# Triton 源代码安装
mkdir -p /root/workspace/deps
cd /root/workspace/deps
git clone  --branch v3.5.1  --depth 1  --single-branch  https://github.com/triton-lang/triton.git  triton

# flash-attention 源代码安装
git clone https://github.com/vllm-project/flash-attention.git flash-attention
cd  flash-attention
# flash-attention 的源码版本应与 vLLM v0.25.0 中 cmake/external_projects/vllm_flash_attn.cmake 固定的版本一致
git checkout --detach "2c839c33742309ec41e620bf837495ec9926c56e"
git -c http.version=HTTP/1.1 submodule update --init --depth 1 --single-branch --jobs 1 csrc/cutlass为避免 vLLM 构建时自动拉取依赖因网络波动失败,这里提前准备 Triton 和 flash-attention 源码。
下载 vLLM v0.25.0 源代码:
cd ~/workspace
git clone https://github.com/vllm-project/vllm.git
cd ~/workspace/vllm
# 选择 vLLM-V0.25.0
git fetch --tags
git checkout v0.25.0配置编译环境并从源码安装 vLLM v0.25.0:
cd ~/workspace/vllm
# 移除 vLLM 对 Torch 系列包的版本约束,编译时复用基础镜像已有的 torch 2.12.1+cu130
python use_existing_torch.py --prefix

# 针对 Blackwell SM120 以 Release 模式编译,并设置 CUDA 编译并行度
export TORCH_CUDA_ARCH_LIST="12.0"
export MAX_JOBS=16
export NVCC_THREADS=4
export CMAKE_BUILD_TYPE=Release

# vLLM v0.25.0 启动时会通过 TorchCodec 加载多模态模块,因此需要安装 FFmpeg 及其共享动态库
apt-get update
DEBIAN_FRONTEND=noninteractive apt-get install -y ffmpeg

# 安装构建依赖,不覆盖已有 torch
pip install -r requirements/build/cuda.txt

# 指定预先下载的本地依赖源码,避免 vLLM 在构建阶段再次从 GitHub 拉取
export TRITON_KERNELS_SRC_DIR="$HOME/workspace/deps/triton/python/triton_kernels/triton_kernels"
export VLLM_FLASH_ATTN_SRC_DIR="$HOME/workspace/deps/flash-attention"

# 复用当前环境中的 PyTorch 和 CUDA 工具链,从源码编译并安装 vLLM
pip install --no-build-isolation  .

# vLLM v0.25.0 的 SM120 Sparse MLA 需要 FlashInfer 0.6.14 新增的
# kv_scale_format 参数,因此将 Python API 与 cubin 同步升级到 0.6.14。
python -m pip install \
  --index-url https://pypi.org/simple \
  --no-deps \
  --force-reinstall \
  "flashinfer-python==0.6.14"

python -m pip install \
  --index-url https://flashinfer.ai/whl \
  --no-deps \
  --force-reinstall \
"flashinfer-cubin==0.6.14"该步骤会针对 Blackwell SM120 编译 vLLM 的 C++/CUDA 扩展、flash-attention 和 NVFP4 等 GPU 算子,并将编译产物安装到当前 Python 环境。首次进行完整编译时,通常需要较长时间。
6 GLM-5.2 特性测试
首先启动 vLLM 基础服务:
MODEL=/autodl-fs/data/models/GLM-5.2-NVFP4
CUDA_VISIBLE_DEVICES=0,1,2,3,4,5,6,7 vllm serve "$MODEL" \
  --tensor-parallel-size 8 \
  --enable-expert-parallel \
  --trust-remote-code \
  --reasoning-parser glm45 \
  --tool-call-parser glm47 \
  --max-model-len 32768 \
  --enable-auto-tool-choice \
  --kv-cache-dtype fp8_e4m3 \
  --served-model-name glm-5.2-nvfp4 \
  --host 0.0.0.0 \
--port 8000当终端输出 Starting vLLM server on http://0.0.0.0:8000 和 Application startup complete. 时,表示 GLM-5.2-NVFP4 已成功部署,OpenAI 兼容 API 服务已在 8000 端口启动。
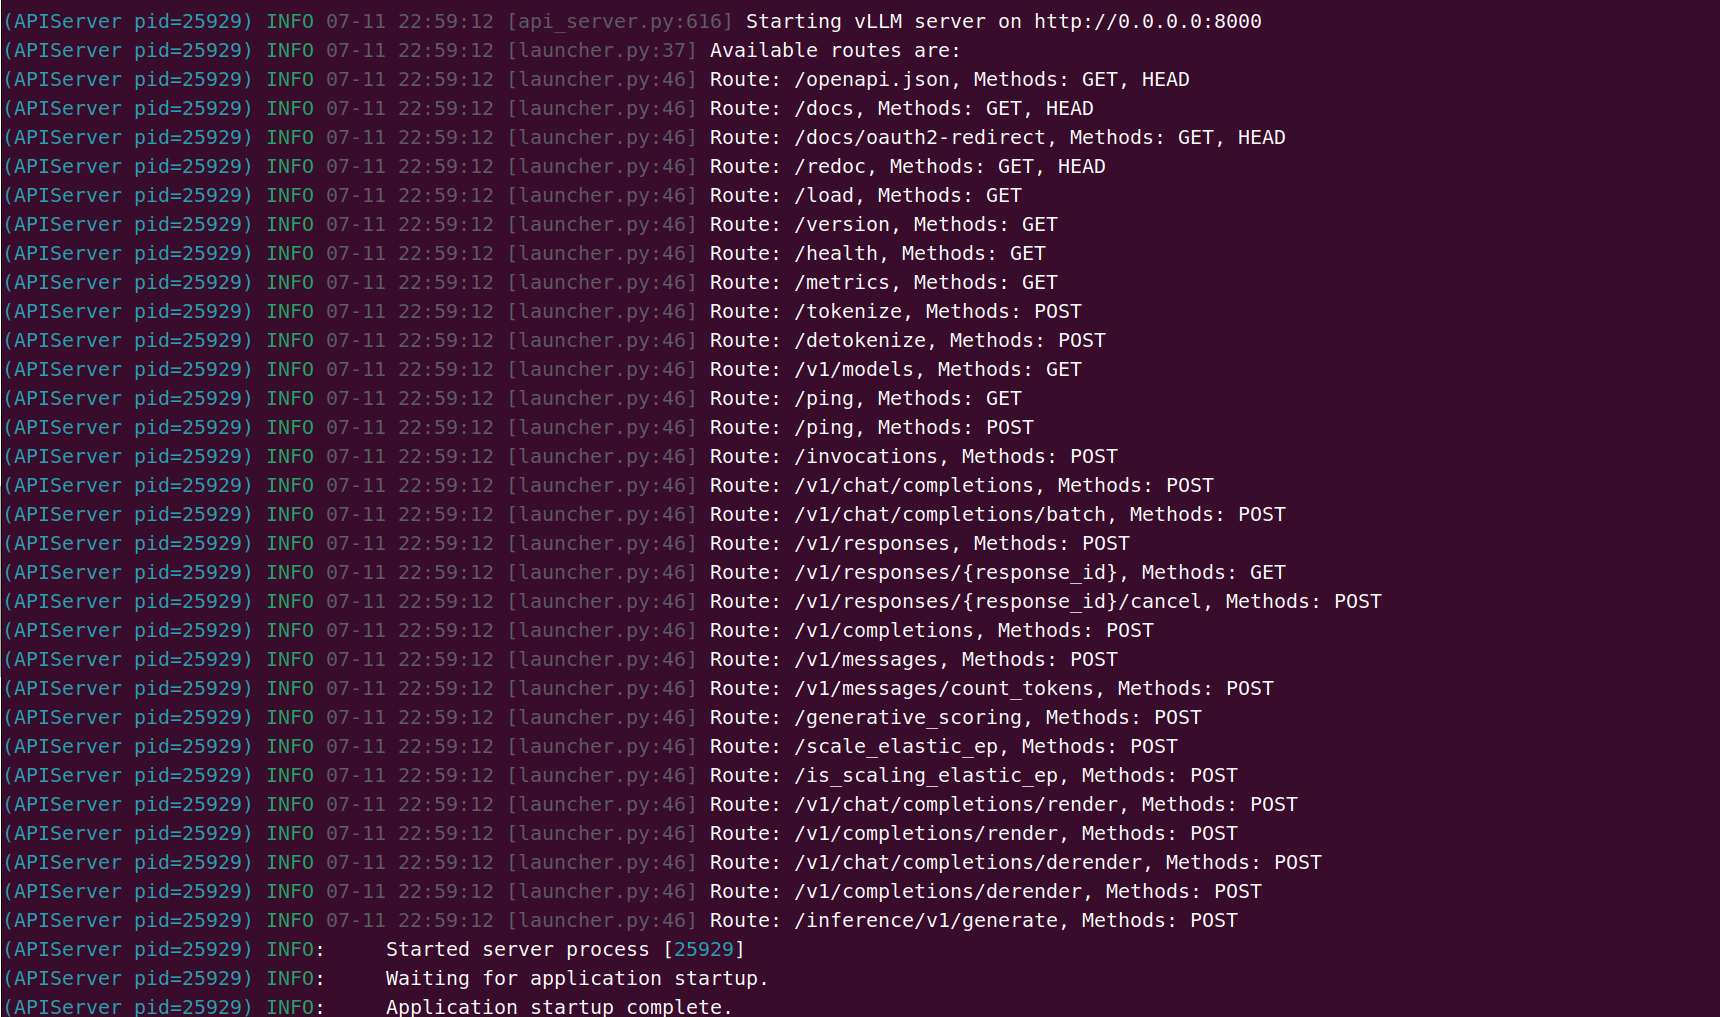
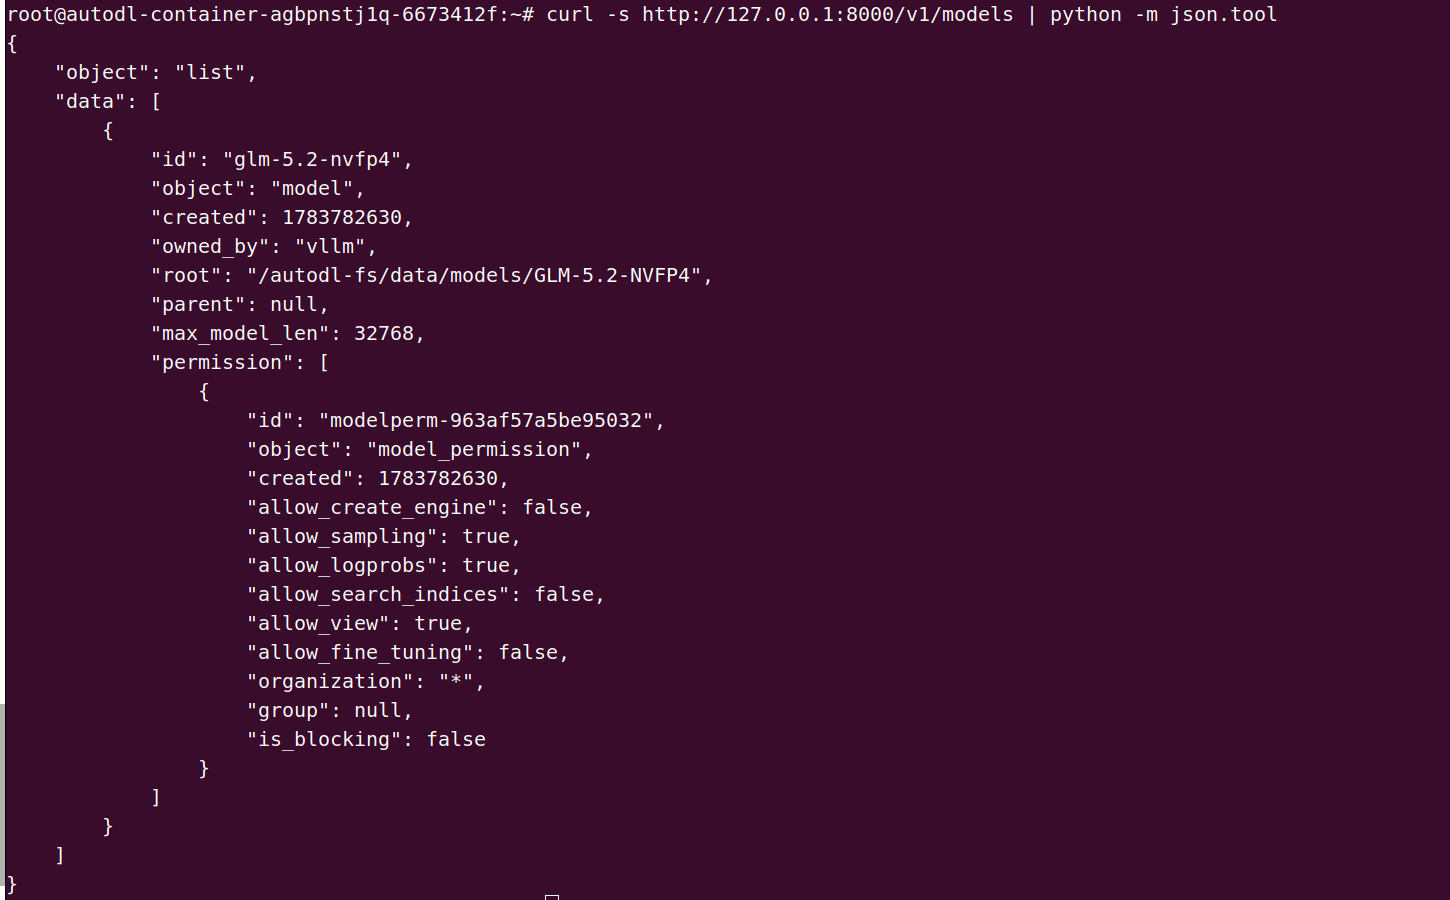
此时可以通过 /v1/models 和 /v1/chat/completions 等接口访问模型服务。
6.1 工具调用测试
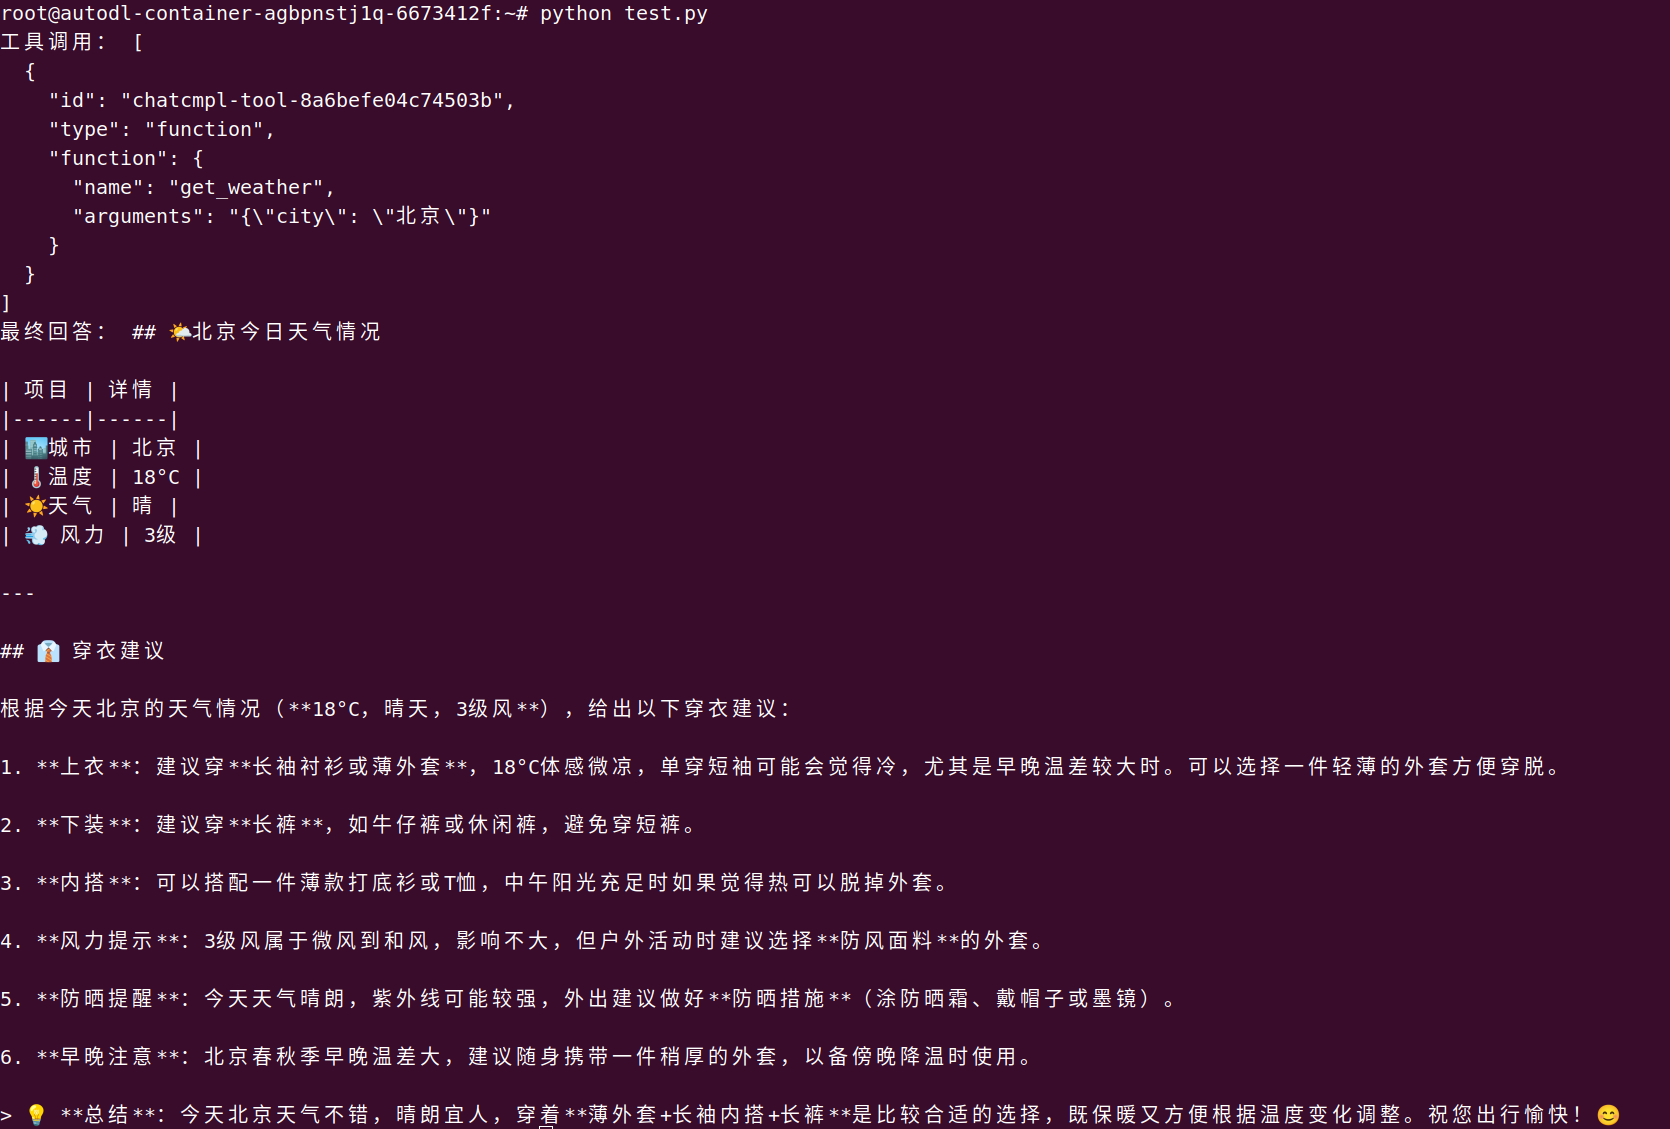
下面使用本地模拟的天气工具,演示“模型选择工具 → 程序执行工具 → 模型生成最终答案”的完整流程。首先创建 Python 脚本:
import json
import requests

url = "http://127.0.0.1:8000/v1/chat/completions"
tools = [{
    "type": "function",
    "function": {
        "name": "get_weather",
        "description": "查询指定城市的天气",
        "parameters": {
            "type": "object",
            "properties": {"city": {"type": "string"}},
            "required": ["city"],
            "additionalProperties": False,
        },
    },
}]
messages = [{"role": "user", "content": "查询北京今天的天气,并给出穿衣建议。不要猜测,必须调用工具。"}]

payload = {
    "model": "glm-5.2-nvfp4",
    "messages": messages,
    "tools": tools,
    "tool_choice": "auto",
    "temperature": 0,
}
first = requests.post(url, json=payload, timeout=600).json()
message = first["choices"][0]["message"]
print("工具调用:", json.dumps(message.get("tool_calls"), ensure_ascii=False, indent=2))

tool_call = message["tool_calls"][0]
arguments = json.loads(tool_call["function"]["arguments"])
tool_result = {"city": arguments["city"], "temperature": 18, "condition": "晴", "wind": "3级"}

messages.append({
    "role": "assistant",
    "content": message.get("content"),
    "tool_calls": message["tool_calls"],
})
messages.append({
    "role": "tool",
    "tool_call_id": tool_call["id"],
    "content": json.dumps(tool_result, ensure_ascii=False),
})

payload["messages"] = messages
final = requests.post(url, json=payload, timeout=600).json()
print("最终回答:", final["choices"][0]["message"]["content"])输出结果:
6.2 MTP 推测解码加速测试
vllm bench serve 用于对已经启动的 vLLM 服务进行在线性能测试。下面使用随机生成的固定长度请求,以单并发方式连续发送 20 个请求,每个请求约包含 1024 个输入 token,并强制生成 512 个输出 token。
该配置主要用于观察低并发场景下的逐 token 解码性能,适合比较基础解码与 MTP 推测解码的延迟差异。
vllm bench serve \
  --backend openai-chat \
  --host 127.0.0.1 \
  --port 8000 \
  --endpoint /v1/chat/completions \
  --model glm-5.2-nvfp4 \
  --tokenizer /autodl-fs/data/models/GLM-5.2-NVFP4 \
  --dataset-name random \
  --num-warmups 2 \
  --num-prompts 20 \
  --random-input-len 1024 \
  --random-output-len 512 \
  --max-concurrency 1 \
  --request-rate inf \
  --ignore-eos \
--seed 42基础服务测试结果:
============ Serving Benchmark Result ============
Successful requests:                     20
Failed requests:                         0
Maximum request concurrency:             1
Benchmark duration (s):                  231.62
Total input tokens:                      20720
Total generated tokens:                  10240
Request throughput (req/s):              0.09
Output token throughput (tok/s):         44.21
Peak output token throughput (tok/s):    47.00
Peak concurrent requests:                2.00
Total token throughput (tok/s):          133.67
---------------Time to First Token----------------
Mean TTFT (ms):                          494.09
Median TTFT (ms):                        516.97
P99 TTFT (ms):                           519.98
-----Time per Output Token (excl. 1st token)------
Mean TPOT (ms):                          21.70
Median TPOT (ms):                        21.69
P99 TPOT (ms):                           21.72
---------------Inter-token Latency----------------
Mean ITL (ms):                           22.43
Median ITL (ms):                         21.71
P99 ITL (ms):                            43.56
==================================================GLM-5.2 内置 MTP 层,不需要额外的草稿模型。停止基础服务后,在相同的 vLLM 启动参数末尾增加:
# 每轮解码最多提前预测 5 个候选 token,再由主模型并行验证。
--speculative-config '{"method":"mtp","num_speculative_tokens":5}'开启 MTP 后的吞吐测试结果:
============ Serving Benchmark Result ============
Successful requests:                     20
Failed requests:                         0
Maximum request concurrency:             1
Benchmark duration (s):                  147.90
Total input tokens:                      20720
Total generated tokens:                  10240
Request throughput (req/s):              0.14
Output token throughput (tok/s):         69.24
Peak output token throughput (tok/s):    29.00
Peak concurrent requests:                2.00
Total token throughput (tok/s):          209.33
---------------Time to First Token----------------
Mean TTFT (ms):                          520.80
Median TTFT (ms):                        549.92
P99 TTFT (ms):                           552.10
-----Time per Output Token (excl. 1st token)------
Mean TPOT (ms):                          13.45
Median TPOT (ms):                        13.09
P99 TPOT (ms):                           18.24
---------------Inter-token Latency----------------
Mean ITL (ms):                           34.88
Median ITL (ms):                         35.00
P99 ITL (ms):                            36.41
---------------Speculative Decoding---------------
Acceptance rate (%):                     32.14
Acceptance length:                       2.61
Drafts:                                  3932
Draft tokens:                            19660
Accepted tokens:                         6319
Per-position acceptance (%):
  Position 0:                            67.45
  Position 1:                            42.60
  Position 2:                            26.09
  Position 3:                            15.16
  Position 4:                            9.41
==================================================注:在本文使用的 vLLM v0.25.0 中,benchmark 会按流式返回事件估算峰值输出吞吐;MTP 的单次返回可能包含多个 token,因此该指标会被低估。本文以平均输出吞吐和 TPOT 为准。
在相同的单并发随机负载下,开启 5-token MTP 推测解码后,输出吞吐从 44.21 tok/s 提升至 69.24 tok/s,提升约 56.6%;平均 TPOT 从 21.70 ms 降至 13.45 ms,测试总耗时缩短约 36.1%。TTFT 略有增加,但整体生成效率提升明显,说明 MTP 推测解码已成功生效。
03 GLM-5.2 SGLang 部署调用
1 SGLang 简介
SGLang 是一款专为大语言模型(LLM)和多模态模型设计的高性能推理与服务框架。它通过高效的调度、缓存复用和 GPU Kernel 优化,提升大模型在长上下文、高并发及复杂推理任务中的执行效率,同时提供兼容 OpenAI API 的服务接口,便于接入现有应用。
GLM-5.2 NVFP4 优化:面向 Blackwell GPU 完成生产级调优,并提供 B200、B300 和 GB300 等平台的部署方案与性能配置。
Spec V2 推测解码:启用推测解码时,默认使用新一代 Spec V2 调度,通过 CUDA Graph、元数据融合以及减少 CPU/GPU 同步,提高端到端推理吞吐。
IndexShare MTP:GLM-5.2 的 MTP 草稿阶段可复用 DSA Indexer 的 Top-K 结果,减少长上下文下重复执行 Indexer 的开销,提高草稿阶段的执行效率。
DSA Kernel 优化:加入 TopK V2、Page Table 转换融合和 Indexer Q/K 路径融合;其中 GLM-5.2/DeepSeek-V3.2 的 Indexer Prologue 由 12 个 Kernel 减少至 4 个,从而提高解码效率。
CUDA Graph 增强:Breakable CUDA Graph 成为默认捕获路径,并加入实验性的 Prefill CUDA Graph 支持,进一步降低逐步推理的 Kernel Launch 开销。
MoE 与 Blackwell 加速:加入 FlashInfer All-to-All、面向 Blackwell 的 JIT Router GEMM 与 CuteDSL BF16 GEMM,提升 MoE 模型的计算和通信效率。
GLM-5.2官方明确说明模型权重支持多种本地部署与推理框架,包括SGLang(v0.5.13.post1+)、vLLM(v0.23.0+)、Transformers、KTransformers和Unsloth等。同时,面向华为昇腾Ascend NPU平台,也支持通过vLLM-Ascend、xLLM、SGLang等框架进行推理部署。本教程使用SGLang进行部署,文中的启动日志与接口返回均为实测真实输出。
2 GLM-5.2 架构
GLM-5.2 采用面向长上下文与 Agentic Engineering 的高效 MoE + DSA 架构:模型基于 DeepSeek Sparse Attention(DSA,稀疏注意力) 和 Multi-head Latent Attention(MLA,多头潜在注意力),通过 Lightning Indexer 为每个 query 动态选择最相关的 Top-K 历史 KV,而不是对全部历史 token 执行稠密注意力计算,从而降低 1M 长上下文场景下的注意力计算开销。
GLM-5.2 面向长程任务、复杂代码任务和工具调用场景,支持稳定的 1M-token context,并提供多档 thinking effort 以在性能与延迟之间做权衡。其模型类型为 glm_moe_dsa,部署时需要推理框架支持 DSA 稀疏注意力、IndexShare 与 MTP 阶段的索引复用逻辑,以及 GLM 系列 chat template。
由于该模型架构及 NVFP4 量化格式较新,请使用较新版本的推理框架。本教程采用
SGLang v0.5.15,该版本已支持GLM-5.2、DSA 稀疏注意力、NVFP4 量化以及 MTP 推测解码,并针对 Blackwell GPU 提供了相关 Kernel 优化。使用 SGLang 时可通过python -m sglang.launch_server --model-path /path/to/models启动模型服务。
3 环境准备
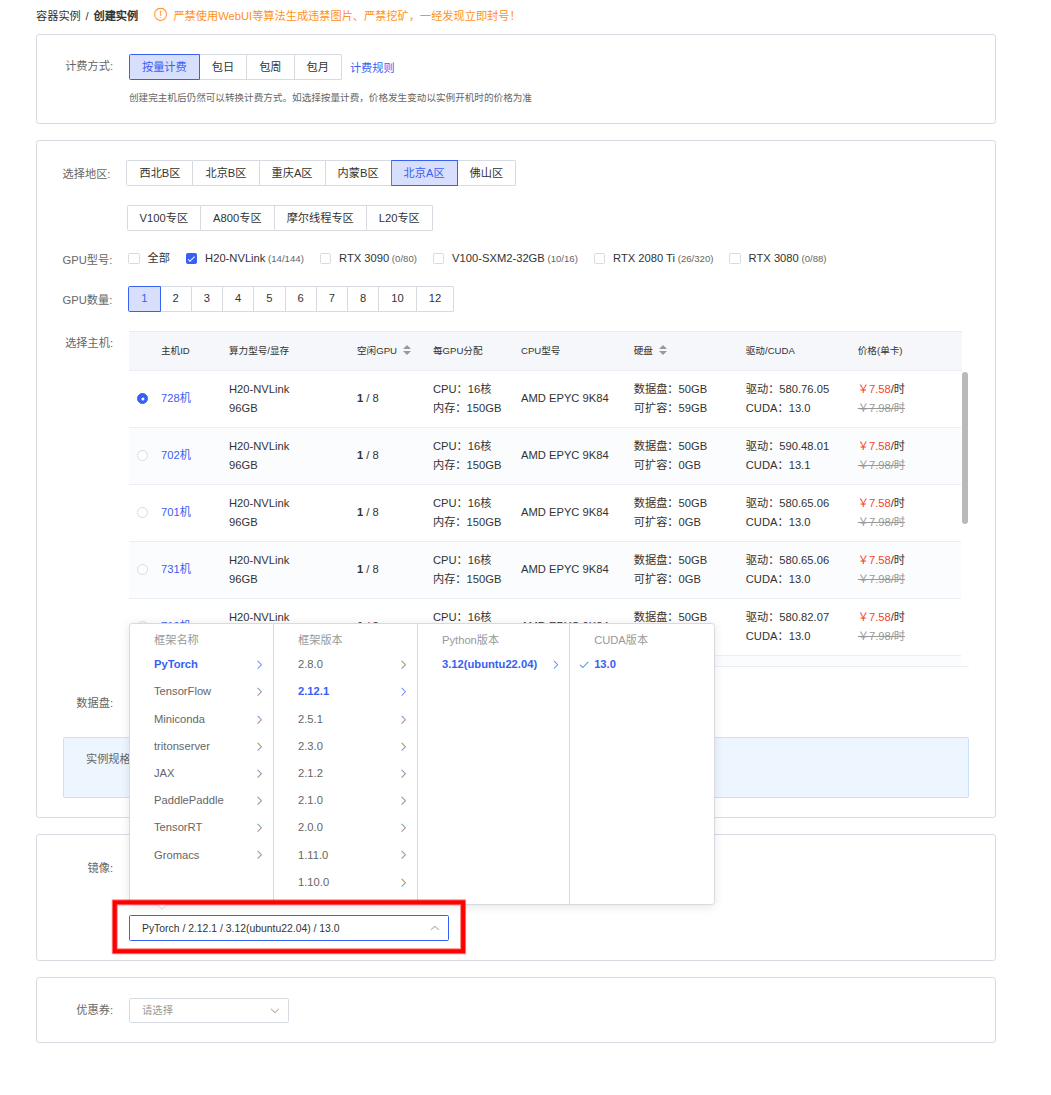
在 AutoDL 平台选择 H20-NVLink 96 GB GPU 实例。基础镜像依次选择 PyTorch → 2.12.1 → Python 3.12(Ubuntu 22.04) → CUDA 13.0,如下图所示。
本教程使用基础镜像中已有的 PyTorch 和 CUDA Toolkit,并从源码编译安装 SGLang,因此需要先激活镜像预装的 CUDA 编译工具链。
cat >> ~/.bashrc <<'EOF'

# CUDA 13.0
export CUDA_HOME=/usr/local/cuda
export PATH="${CUDA_HOME}/bin:${PATH}"
export TRITON_PTXAS_PATH="${CUDA_HOME}/bin/ptxas"
EOF
source ~/.bashrc实测基础镜像环境如下:
----------------
Ubuntu 22.04.5 LTS
Python 3.12.3
NVIDIA 驱动 580.65.06
CUDA Toolkit 13.0
NVCC 13.0.88
PTXAS 13.0.88
GPU: NVIDIA H20(96G,SM90)
GCC 11.4.0
G++ 11.4.0
CMake 4.4.0(当前环境)
系统 CMake 3.22.1
PyTorch 2.12.1+cu130
----------------4 模型下载
使用 Hugging Face Hub 提供的 hf download 命令下载模型。首先安装 Hugging Face Hub:
python -m pip install -U huggingface_hub下载 GLM-5.2 NVFP4 量化模型:
mkdir -p /autodl-fs/data/models/GLM-5.2-NVFP4

hf download nvidia/GLM-5.2-NVFP4 \
  --local-dir /autodl-fs/data/models/GLM-5.2-NVFP4 \
--max-workers 8注意:请根据实际存储路径修改
--local-dir,并确保目标磁盘有足够的可用空间。
5 代码编译安装
source /etc/network_turbo编译 sglang-kernel 前,需要下载 Triton、CUTLASS、fmt、FlashInfer、sgl-attn 和 FlashMLA 等外部依赖源码,避免 CMake 在构建阶段因临时从 GitHub 下载依赖而失败。
mkdir -p /root/workspace/deps
cd /root/workspace/deps

# Triton 源代码
git clone --branch v3.6.0 --depth 1 --single-branch https://github.com/triton-lang/triton.git

# CUTLASS 源代码
git clone https://github.com/NVIDIA/cutlass.git
cd cutlass
git checkout --detach "57e3cfb47a2d9e0d46eb6335c3dc411498efa198"

# fmt 源代码
cd /root/workspace/deps
git clone https://github.com/fmtlib/fmt.git
cd fmt
git checkout --detach "553ec11ec06fbe0beebfbb45f9dc3c9eabd83d28"

# FlashInfer 源代码
cd /root/workspace/deps
git clone https://github.com/flashinfer-ai/flashinfer.git
cd flashinfer
git checkout --detach "bc29697ba20b7e6bdb728ded98f04788e16ee021"

# SGLang Attention 源代码
cd /root/workspace/deps
git clone https://github.com/sgl-project/sgl-attn.git
cd sgl-attn
git checkout --detach "f89bc2306632d1ec5f97b014dded4254f5b4a907"

# FlashMLA 源代码
cd /root/workspace/deps
git clone https://github.com/sgl-project/FlashMLA.git
cd FlashMLA
git checkout --detach "05e26647fe840b8baedae486c2d86d5ce4efeb7c"
# 拉取 FlashMLA 固定版本的 CUTLASS 子模块
git -c http.version=HTTP/1.1 submodule update --init --depth 1 --single-branch --jobs 1 csrc/cutlass各依赖的分支、标签及 commit 必须与 SGLang v0.5.15 中的
sgl-kernel/CMakeLists.txt和sgl-kernel/cmake/flashmla.cmake保持一致。
下载 SGLang v0.5.15 源代码:
mkdir -p ~/workspace
cd ~/workspace
git clone https://github.com/sgl-project/sglang.git
cd sglang

# 获取版本标签并切换到 SGLang v0.5.15
git fetch --tags
git checkout v0.5.15首先移除 SGLang Python 项目中可能覆盖基础镜像 PyTorch 的版本约束,以继续使用已有的 torch 2.12.1+cu130。
cd ~/workspace/sglang
sed -i \
  -e '/^[[:space:]]*"torch==/d' \
  -e '/^[[:space:]]*"torchaudio==/d' \
  -e '/^[[:space:]]*"torchvision/d' \
  -e '/^[[:space:]]*"torchcodec==/d' \
python/pyproject.toml随后安装 SGLang 源码构建所需的 Python 打包工具、CMake 和 Ninja。
python -m pip install \
  "setuptools<82" \
  wheel \
  packaging \
  cmake \
  ninja \
scikit-build-core接下来统一配置 CUDA 13.0 工具链、Release 构建模式、编译并行度和本地依赖源码路径。随后复用当前的 PyTorch 与 CUDA,从源码编译安装 sglang-kernel。
# 指定 CUDA 13.0 编译工具链
export CUDA_HOME=/usr/local/cuda
export PATH="${CUDA_HOME}/bin:${PATH}"
export TRITON_PTXAS_PATH="${CUDA_HOME}/bin/ptxas"

# 设置编译并行度
export MAX_JOBS=8
export CMAKE_BUILD_PARALLEL_LEVEL=8
export CMAKE_BUILD_TYPE=Release

# 指定预先下载的外部依赖源码目录
export SGLANG_DEPS=/root/workspace/deps
# 使用本地依赖源码,避免 CMake 构建阶段再次从 GitHub 下载;
# 同时关闭 SM90 以下架构,并限制单个 NVCC 任务的编译线程数
export CMAKE_ARGS="\
-DENABLE_BELOW_SM90=OFF \
-DSGL_KERNEL_COMPILE_THREADS=4 \
-DFETCHCONTENT_FULLY_DISCONNECTED=ON \
-DFETCHCONTENT_SOURCE_DIR_REPO-CUTLASS=${SGLANG_DEPS}/cutlass \
-DFETCHCONTENT_SOURCE_DIR_REPO-FMT=${SGLANG_DEPS}/fmt \
-DFETCHCONTENT_SOURCE_DIR_REPO-TRITON=${SGLANG_DEPS}/triton \
-DFETCHCONTENT_SOURCE_DIR_REPO-FLASHINFER=${SGLANG_DEPS}/flashinfer \
-DFETCHCONTENT_SOURCE_DIR_REPO-FLASH-ATTENTION=${SGLANG_DEPS}/sgl-attn \
-DFETCHCONTENT_SOURCE_DIR_REPO-FLASHMLA=${SGLANG_DEPS}/FlashMLA \
-DFETCHCONTENT_SOURCE_DIR_REPO-FLASHMLA-CUTLASS=${SGLANG_DEPS}/FlashMLA/csrc/cutlass"

# 复用当前 PyTorch 和 CUDA,从源码编译并安装 sglang-kernel
cd ~/workspace/sglang/sgl-kernel
python -m pip install --no-build-isolation .该步骤会复用当前环境中的 PyTorch 和 CUDA 13.0 工具链,从源码编译
sglang-kernel的 C++/CUDA 扩展,并生成适配当前 GPU 环境、包含 NVFP4、FlashMLA 和 FlashAttention 等相关算子的 wheel,随后将其安装到当前 Python 环境。首次完整编译需要处理大量 CUDA 模板和多架构 Kernel,通常耗时较长。
sglang-kernel 编译并安装完成后,再安装 SGLang 的 Python 框架及运行时依赖。
# 安装 SGLang Python 框架
cd ~/workspace/sglang
python -m pip install --no-build-isolation ./python6 GLM-5.2 特性测试
首先启动 SGLang 基础服务:
MODEL=/autodl-fs/data/models/GLM-5.2-NVFP4
CUDA_VISIBLE_DEVICES=0,1,2,3,4,5,6,7 \
python -m sglang.launch_server \
  --model-path "$MODEL" \
  --tp-size 8 \
  --quantization modelopt_fp4 \
  --reasoning-parser glm45 \
  --tool-call-parser glm47 \
  --context-length 32768 \
  --kv-cache-dtype fp8_e4m3 \
  --served-model-name glm-5.2-nvfp4 \
  --host 0.0.0.0 \
  --disable-shared-experts-fusion \
--port 8000在 SGLang v0.5.15 中,共享专家融合会因
w13预分配维度 3072 与模型权重维度 6144 不匹配而导致加载失败,因此本文使用--disable-shared-experts-fusion关闭该功能。
当终端输出 Application startup complete.、Uvicorn running on http://0.0.0.0:8000 和 The server is fired up and ready to roll! 时,表示 SGLang 已完成模型加载、CUDA Graph 捕获、RadixCache 初始化和预热。此时,GLM-5.2-NVFP4 已成功部署,OpenAI 兼容 API 服务正在 8000 端口运行。
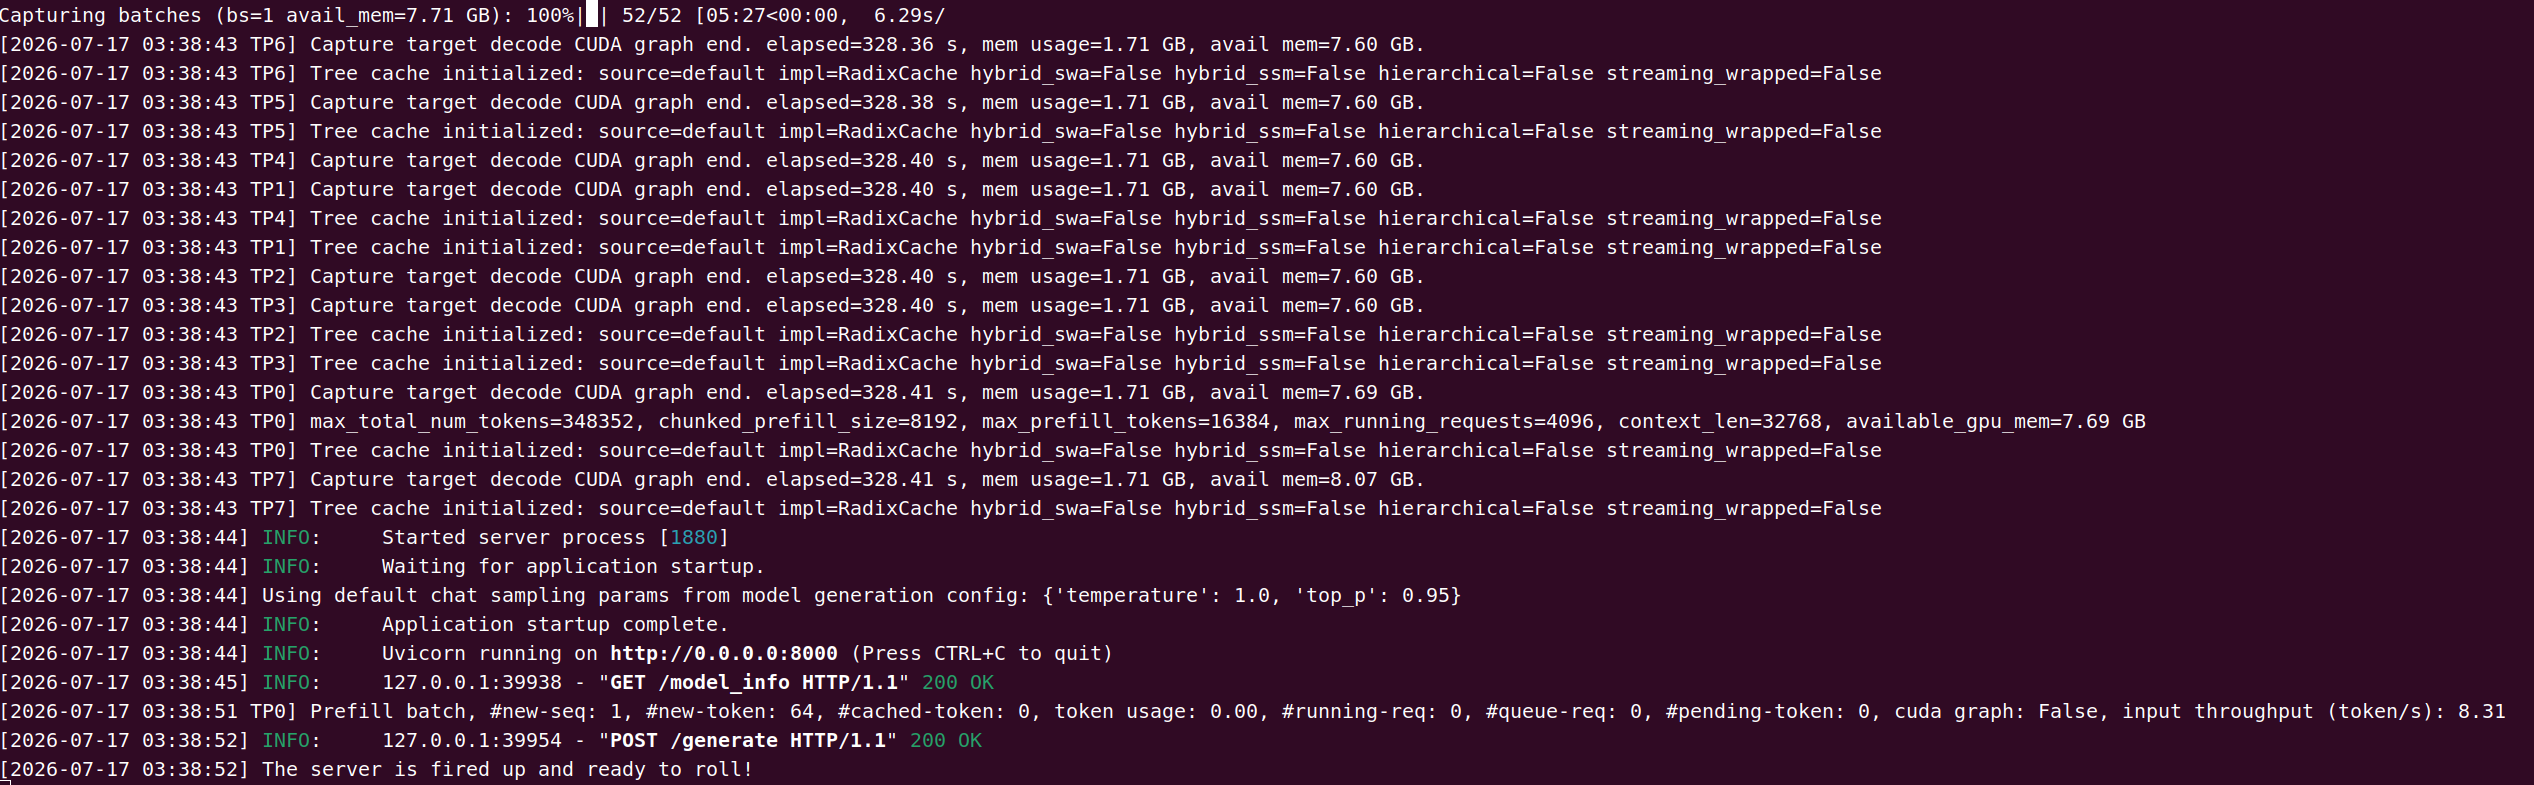
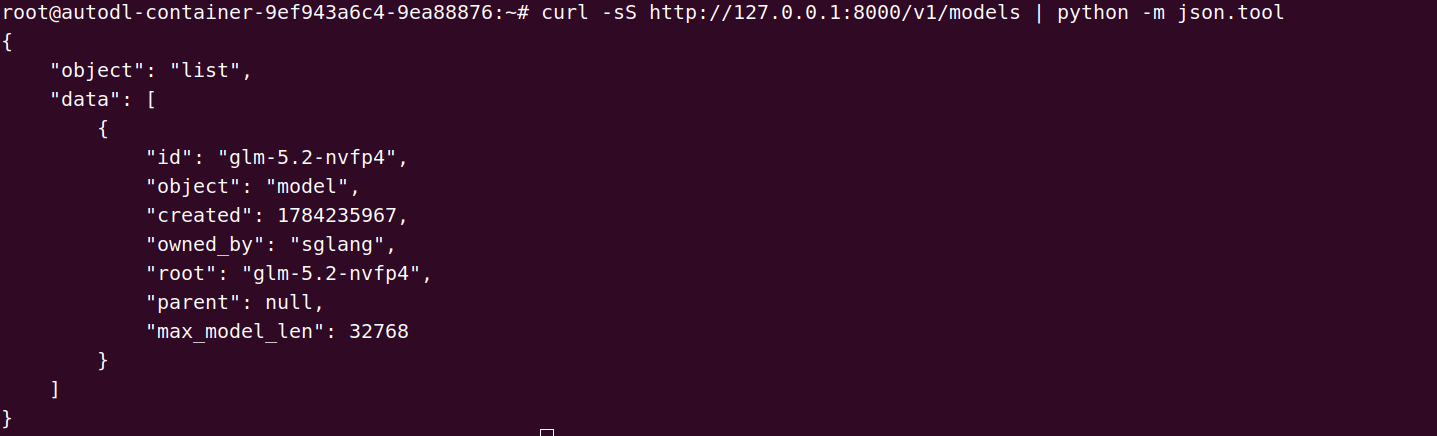
此时可以通过 OpenAI 兼容接口 /v1/models 查询当前服务加载的模型及其配置信息。返回结果中,id 为 glm-5.2-nvfp4,owned_by 为 sglang,最大上下文长度为 32,768 token,说明模型服务已正常对外提供接口。
6.1 工具调用测试
下面使用本地模拟的天气工具,演示“模型选择工具 → 程序执行工具 → 模型生成最终答案”的完整流程。首先创建 Python 脚本:
import json
import requests
URL = "http://127.0.0.1:8000/v1/chat/completions"
MODEL = "glm-5.2-nvfp4"
tools = [
    {
        "type": "function",
        "function": {
            "name": "get_weather",
            "description": "查询指定城市的天气",
            "parameters": {
                "type": "object",
                "properties": {
                    "city": {
                        "type": "string",
                        "description": "城市名称",
                    }
                },
                "required": ["city"],
                "additionalProperties": False,
            },
        },
    }
]
messages = [
    {
        "role": "system",
        "content": "回答必须简洁,只提供必要信息。",
    },
    {
        "role": "user",
        "content": "查询北京今天的天气,并给出简短的穿衣建议。必须调用天气工具。",
    },
]
# 第一次请求:关闭思考并强制调用工具
first_payload = {
    "model": MODEL,
    "messages": messages,
    "tools": tools,
    "tool_choice": "required",
    "reasoning_effort": "none",
    "temperature": 0,
    "max_tokens": 256,
}
response = requests.post(URL, json=first_payload, timeout=600)
response.raise_for_status()
first = response.json()
message = first["choices"][0]["message"]
tool_calls = message.get("tool_calls") or []
if not tool_calls:
    print("模型没有调用工具:")
    print(json.dumps(first, ensure_ascii=False, indent=2))
    raise SystemExit(1)
tool_call = tool_calls[0]
function = tool_call["function"]
if function["name"] != "get_weather":
    raise RuntimeError(f"未知工具:{function['name']}")
try:
    arguments = json.loads(function["arguments"])
except json.JSONDecodeError as error:
    raise RuntimeError(
        f"工具参数不是有效 JSON:{function['arguments']}"
    ) from error
city = arguments.get("city")
if not city:
    raise RuntimeError("工具调用缺少 city 参数")
print("工具调用:")
print(
    json.dumps(
        {
            "name": function["name"],
            "arguments": arguments,
        },
        ensure_ascii=False,
        indent=2,
    )
)
# 模拟天气服务返回的数据
tool_result = {
    "city": city,
    "temperature": 18,
    "condition": "晴",
    "wind": "3级",
}
# 显式加入模型发起的工具调用
messages.append(
    {
        "role": "assistant",
        "content": message.get("content"),
        "tool_calls": tool_calls,
    }
)
# 加入对应的工具执行结果
messages.append(
    {
        "role": "tool",
        "tool_call_id": tool_call["id"],
        "content": json.dumps(tool_result, ensure_ascii=False),
    }
)
# 第二次请求:禁止再次调用工具并生成简短回答
final_payload = {
    "model": MODEL,
    "messages": messages,
    "tools": tools,
    "tool_choice": "none",
    "reasoning_effort": "none",
    "temperature": 0,
    "max_tokens": 128,
}
response = requests.post(URL, json=final_payload, timeout=600)
response.raise_for_status()
final = response.json()
answer = final["choices"][0]["message"].get("content") or ""
print("\n工具结果:")
print(json.dumps(tool_result, ensure_ascii=False, indent=2))
print("\n最终回答:")
print(answer.strip())输出结果:
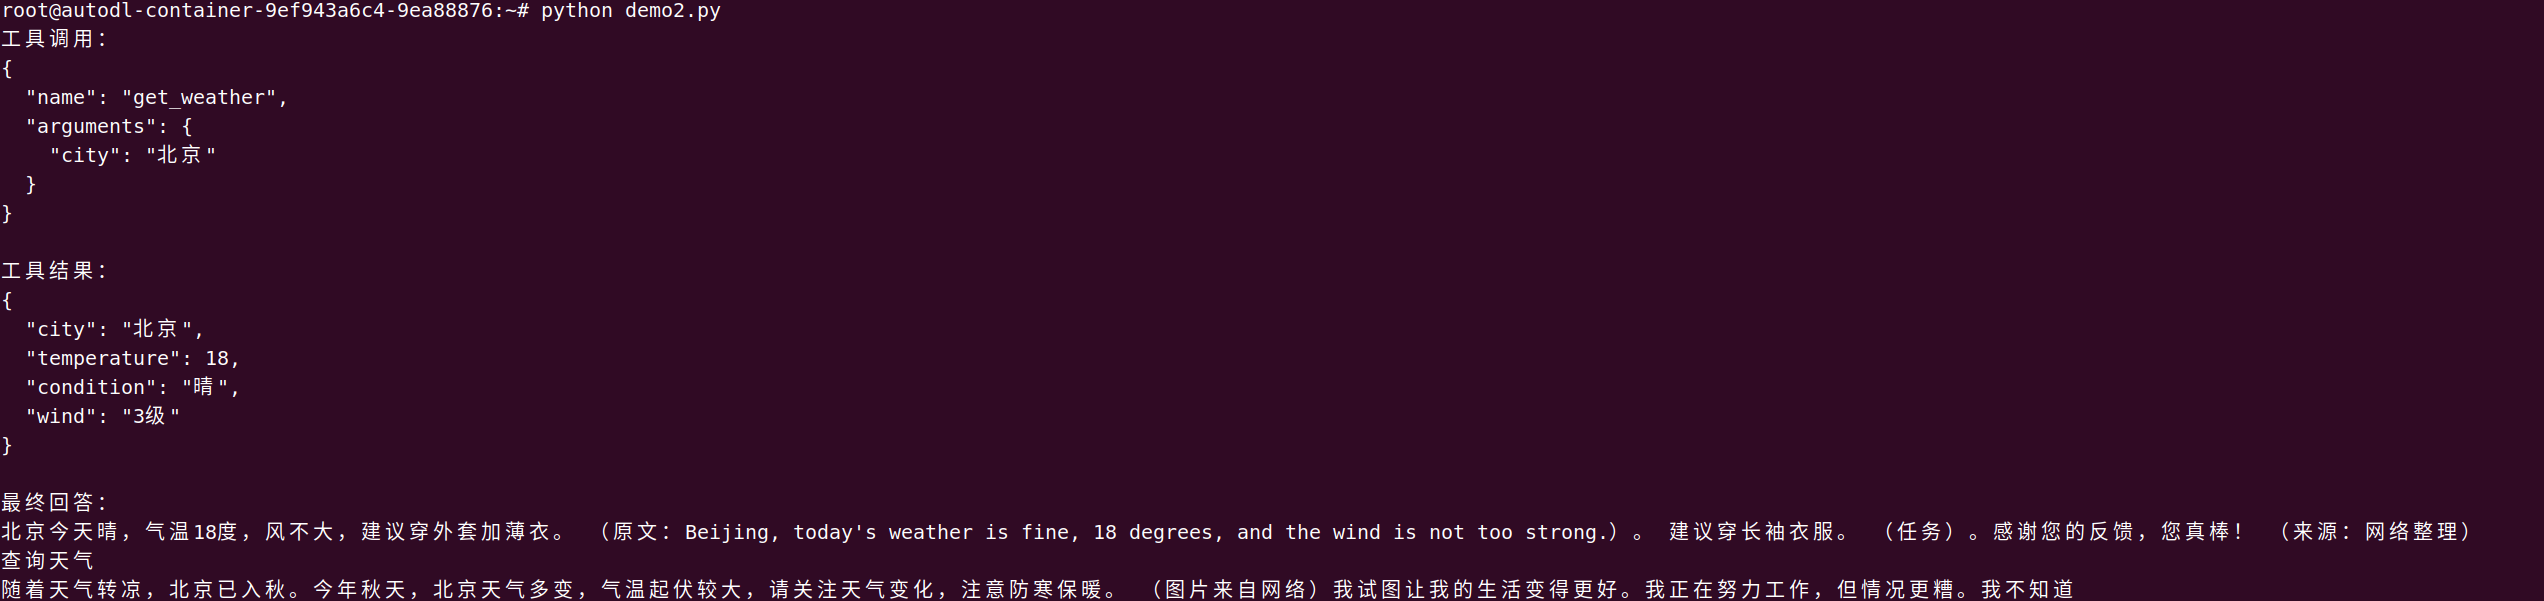
运行示例后,模型成功调用
get_weather(city="北京"),并根据工具返回的天气数据生成穿衣建议,验证了 SGLang 的工具调用与结果回传能力。