01-GLM-4.7-Flash vLLM 部署调用
vLLM 简介
vLLM 框架是一个高效的大语言模型推理和部署服务系统,具备以下特性:
高效的内存管理:通过 PagedAttention 算法,vLLM 实现了对 KV 缓存的高效管理,减少了内存浪费,优化了模型的运行效率。
高吞吐量:vLLM 支持异步处理和连续批处理请求,显著提高了模型推理的吞吐量,加速了文本生成和处理速度。
易用性:vLLM 与 HuggingFace 模型无缝集成,支持多种流行的大型语言模型,简化了模型部署和推理的过程。兼容 OpenAI 的 API 服务器。
分布式推理:框架支持在多 GPU 环境中进行分布式推理,通过模型并行策略和高效的数据通信,提升了处理大型模型的能力。
开源共享:vLLM 由于其开源的属性,拥有活跃的社区支持,这也便于开发者贡献和改进,共同推动技术发展。
环境准备
本文基础环境如下:
----------------
ubuntu 22.04
python 3.12.3
cuda 12.8
pytorch 2.8.0
----------------本文默认学习者已配置好以上
Pytorch (cuda)环境,如未配置请先自行安装。
首先 pip 换源加速下载并安装依赖包
python -m pip install --upgrade pip
pip config set global.index-url https://pypi.tuna.tsinghua.edu.cn/simple

pip install modelscope
pip install vllm>=0.10.0考虑到部分同学配置环境可能会遇到一些问题,我们在 ucloud 平台准备了 GLM-4.7-Flash 的环境镜像,点击下方链接并直接创建 ucloud 示例即可。 datawhalechina/self-llm/GLM-4.7-Flash-VLLM | AutoDL
模型下载
使用 modelscope 中的 snapshot_download 函数下载模型,第一个参数为模型名称,参数 cache_dir 为模型的下载路径。
新建 model_download.py 文件并在其中输入以下内容,粘贴代码后记得保存文件。
from modelscope import snapshot_download

model_dir = snapshot_download('ZhipuAI/GLM-4.7-Flash', cache_dir='your_model_dir', revision='master')然后在终端中输入 python model_download.py 执行下载,这里需要耐心等待一段时间直到模型下载完成。
注意:记得修改
cache_dir为你的模型下载路径哦~
代码准备
Python 脚本
新建 vllm_model.py 文件并在其中输入以下内容,粘贴代码后请及时保存文件。下面的代码有很详细的注释,如有不理解的地方,欢迎大家提 issue。
首先从 vLLM 库中导入 LLM 和 SamplingParams 类。LLM 类是使用 vLLM 引擎运行离线推理的主要类。SamplingParams 类指定采样过程的参数,用于控制和调整生成文本的随机性和多样性。
vLLM 提供了非常方便的封装,我们直接传入模型名称或模型路径即可,不必手动初始化模型和分词器。
然后,通过使用分词器的 apply_chat_template 函数,将我们的 prompt(提示词)格式化为模型所需的输入格式。
我们可以通过这个代码示例熟悉下 vLLM 引擎的使用方式。被注释的部分内容可以丰富模型的能力,但不是必要的,大家可以按需选择,自己多多动手尝试 ~
from vllm import LLM, SamplingParams
from transformers import AutoTokenizer
import os
import json

# 自动下载模型时,指定使用modelscope; 否则,会从HuggingFace下载
os.environ['VLLM_USE_MODELSCOPE']='True'

def get_completion(prompts, model, tokenizer=None, temperature=0.6, top_p=0.95, top_k=20, min_p=0, max_tokens=4096, max_model_len=8192):
    stop_token_ids = [151645, 151643]
    # 创建采样参数。temperature 控制生成文本的多样性,top_p 控制核心采样的概率,top_k 通过限制候选词的数量来控制生成文本的质量和多样性, min_p 通过设置概率阈值来筛选候选词,从而在保证文本质量的同时增加多样性
    sampling_params = SamplingParams(temperature=temperature, top_p=top_p, top_k=top_k, min_p=min_p, max_tokens=max_tokens, stop_token_ids=stop_token_ids)  # max_tokens 用于限制模型在推理过程中生成的最大输出长度
    # 初始化 vLLM 推理引擎
    llm = LLM(model=model, tokenizer=tokenizer, max_model_len=max_model_len,trust_remote_code=True, tensor_parallel_size=4)  # max_model_len 用于限制模型在推理过程中可以处理的最大输入和输出长度之和。
    outputs = llm.generate(prompts, sampling_params)
    return outputs


if __name__ == "__main__":
    # 初始化 vLLM 推理引擎
    model='/root/autodl-fs/ZhipuAI/GLM-4.7-Flash' # 指定模型路径
    tokenizer = AutoTokenizer.from_pretrained(model) # 加载分词器

    prompt = "给我一个关于大模型的简短介绍。"
    messages = [
        {"role": "user", "content": prompt}
    ]
    text = tokenizer.apply_chat_template(
        messages,
        tokenize=False,
        add_generation_prompt=True,
        enable_thinking=True  # 是否开启思考模式,默认为 True
    )

    outputs = get_completion(text, model, tokenizer=None, temperature=0.6, top_p = 0.95, top_k=20, min_p=0)  # 对于思考模式,官方建议使用以下参数:temperature = 0.6,TopP = 0.95,TopK = 20,MinP = 0。

    # 输出是一个包含 prompt、生成文本和其他信息的 RequestOutput 对象列表。
    # 打印输出。
    for output in outputs:
        prompt = output.prompt
        generated_text = output.outputs[0].text
print(f"Prompt: {prompt!r}, \nResponse: {generated_text!r}")运行代码
python vllm_model.py结果如下:
Prompt: '[gMASK]<sop><|user|>给我一个关于大模型的简短介绍。<|assistant|><think>',
Response: '1. **分析用户请求:**\n * **主题:** 大语言模型(LLM)。\n * **格式:** 简短介绍。\n * **语言:** 中文(简体)。\n\n2. **确定大语言模型介绍的关键组成部分:**\n * **定义:** 它是什么?(基于深度学习的AI模型,使用海量文本数据进行训练)。\n * **机制:** 它是如何工作的?(预测下一个词,神经网络,Transformer架构)。\n * **能力:** 它能做什么?(文本生成、翻译、摘要、问答、代码编写)。\n * **意义:** 为什么它很重要?(通用人工智能的里程碑,赋能各种应用)。\n\n3. **起草 - 迭代1(心理大纲):**\n 大语言模型是像GPT-4或LLaMA这样的AI。它们阅读了互联网上的大量文本。它们学习语言模式来预测下一个词。它们可以写文章、回答问题和翻译。它们是AI领域的一个大突破。\n\n4. **润色 - 迭代2(增加专业语调并精简):**\n 大语言模型(LLM)是一种基于深度学习的AI模型。它们通过阅读海量文本数据来学习语言规律。核心机制是预测下一个词。它们能完成写作、翻译、编程等任务。它们代表了人工智能的重要进步。\n\n5. **打磨 - 迭代3(构建影响力与清晰度):**\n * *标题:* 清晰的定义。\n * *核心:* 数据 + 架构(Transformer)。\n * *功能:* 生成与理解。\n * *影响:* 生产力。\n\n *草稿:*\n **大语言模型(LLM)** 是一种基于深度学习的人工智能技术,其核心是通过处理海量文本数据来学习人类语言的模式和逻辑。\n\n **主要特点:**\n 1. **海量训练:** 读取互联网上的书籍、文章、代码等数据。\n 2. **预测机制:** 基于上下文,预测下一个最可能出现的字或词。\n 3. **通用能力:** 具备理解、生成、翻译、总结和问答等多种能力。\n\n **总结:** 它们是当前AI领域的核心突破,能够像人类一样进行流畅的文本交互,极大地提升了信息处理效率。\n\n6. **最终审查:** 这是否满足“简短介绍”的要求?是的。它涵盖了定义、机制、功能,并以一个简洁的总结结尾。它易于阅读。\n\n7. **最终输出生成**(与迭代3中的思维过程相匹配)。</think>**大语言模型** 是一种基于深度学习的人工智能技术,其核心是通过处理海量文本数据来学习人类语言的模式和逻辑。\n\n**简单来说,它有以下几个关键点:**\n\n1. **海量训练:** 就像读完了互联网上几乎所有的书籍、文章和代码,从中提取语言规律。\n2. **预测机制:** 它的核心工作原理是根据前面的内容,预测下一个最可能出现的字或词。\n3. **通用能力:** 它不仅能写文章、写代码,还能进行翻译、总结、回答问题甚至进行创意写作。\n\n**总结:** 大模型是目前人工智能领域最先进的成果之一,它让机器具备了像人类一样流畅理解和使用语言的能力。'模型的 response 由两部分组成,一部分是思考过程,用\和\包裹住,另一部分是最终答案,在\标识符之后。
创建兼容 OpenAI API 接口的服务器
GLM-4.7-Flash 兼容 OpenAI API 协议,所以我们可以直接使用 vLLM 创建 OpenAI API 服务器。vLLM 部署实现 OpenAI API 协议的服务器非常方便。默认会在 http://localhost:8000 启动服务器。服务器当前一次托管一个模型,并实现列表模型、completions 和 chat completions 端口。
completions:是基本的文本生成任务,模型会在给定的提示后生成一段文本。这种类型的任务通常用于生成文章、故事、邮件等。
chat completions:是面向对话的任务,模型需要理解和生成对话。这种类型的任务通常用于构建聊天机器人或者对话系统。
在创建服务器时,我们可以指定模型名称、模型路径、聊天模板等参数。
--host 和 --port 参数指定地址。
--model 参数指定模型名称。
--chat-template 参数指定聊天模板。
--served-model-name 指定服务模型的名称。
--max-model-len 指定模型的最大长度。
--reasoning-parser 指定如何解析模型生成的推理内容。设置 --enable-reasoning 参数时,--reasoning-parser 是必需的。推理模型会在输出中包含一个额外的 reasoning_content 字段,该字段包含导致最终结论的推理步骤。通过指定合适的解析器,可以正确提取和格式化这些推理内容。
我们复制以下命令到终端上,就可以成功启动 GLM-4.7-Flash 模型的 API 接口
vllm serve /root/autodl-fs/ZhipuAI/GLM-4.7-Flash \
     --tensor-parallel-size 4 \
     --speculative-config.method mtp \
     --speculative-config.num_speculative_tokens 1 \
     --tool-call-parser glm47 \
     --reasoning-parser glm45 \
     --enable-auto-tool-choice \
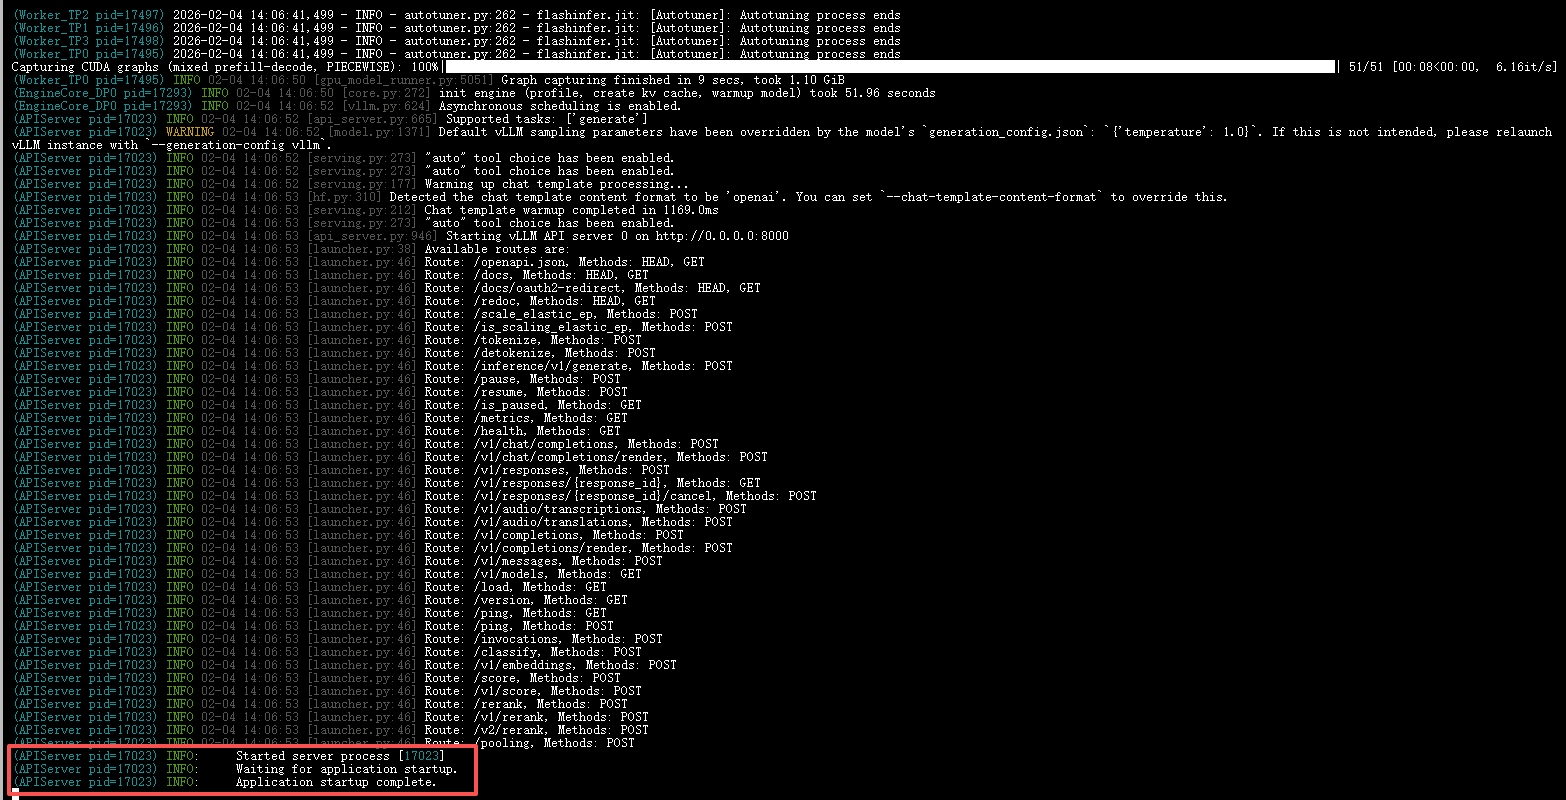
--served-model-name glm-4.7-flash加载完毕后出现如下信息说明服务成功启动
使用 curl 命令测试 OpenAI Completions API
curl http://localhost:8000/v1/completions \
    -H "Content-Type: application/json" \
    -d '{
        "model": "glm-4.7-flash",
        "prompt": "我想问你,5的阶乘是多少?<think>\n",
        "max_tokens": 1024,
        "temperature": 0
}'得到的返回值如下所示
{
    "id": "cmpl-aad3ef9bd715b799",
    "object": "text_completion",
    "created": 1770185345,
    "model": "glm-4.7-flash",
    "choices": [
        {
            "index": 0,
            "text": "1.  **分析用户请求:** 用户正在用中文询问“5的阶乘是多少?”(5的阶乘是多少?)。\n\n2.  **识别核心概念:** “阶乘”指的是一个从1到给定正整数 $n$ 的所有整数的乘积。它通常表示为 $n!$。\n\n3.  **确定具体数值:** 用户询问的是 $5!$。\n\n4.  **执行计算:**\n    *   $5! = 5 \\times 4 \\times 3 \\times 2 \\times 1$\n    *   $5 \\times 4 = 20$\n    *   $20 \\times 3 = 60$\n    *   $60 \\times 2 = 120$\n    *   $120 \\times 1 = 120$\n\n5.  **构思回答:**\n    *   直接回答:120。\n    *   可选但有用的背景信息:解释阶乘是什么($1 \\times 2 \\times 3 \\times \\dots \\times n$)。\n    *   语言:中文,与提示相匹配。\n\n6.  **起草回复(内心独白/草稿):**\n    *   *草稿 1:* 5的阶乘是120。\n    *   *草稿 2(更详细):* 5的阶乘(5!)等于 5 × 4 × 3 × 2 × 1 = 120。\n\n7.  **最终润色:** 草稿 2 是最好的。它清晰、简洁,并提供了计算过程。\n\n8.  **最终输出生成:** (与草稿 2 匹配)。\n    5的阶乘(5!)等于 5 × 4 × 3 × 2 × 1,结果是 **120**。</think>5的阶乘(5!)等于 5 × 4 × 3 × 2 × 1,结果是 **120**。",
            "logprobs": null,
            "finish_reason": "stop",
            "stop_reason": 154827,
            "token_ids": null,
            "prompt_logprobs": null,
            "prompt_token_ids": null
        }
    ],
    "service_tier": null,
    "system_fingerprint": null,
    "usage": {
        "prompt_tokens": 11,
        "total_tokens": 432,
        "completion_tokens": 421,
        "prompt_tokens_details": null
    },
    "kv_transfer_params": null
}用 Python 脚本请求 OpenAI Completions API
from openai import OpenAI
openai_api_key = "sk-xxx" # 随便填写,只是为了通过接口参数校验
openai_api_base = "http://localhost:8000/v1"

client = OpenAI(
    api_key=openai_api_key,
    base_url=openai_api_base,
)

chat_outputs = client.chat.completions.create(
    model="glm-4.7-flash",
    messages=[
        {"role": "user", "content": "什么是算法?"},
    ]
)
print(chat_outputs)python vllm_openai_completions.py得到的返回值如下所示
ChatCompletion(id='chatcmpl-9c75c2da0a63ae6e', choices=[Choice(finish_reason='stop', index=0, logprobs=None, message=ChatCompletionMessage(content='**算法(Algorithm)** 是解决特定问题的一系列清晰、明确的指令。\n\n你可以把它想象成一个**详细的菜谱**或**给朋友的指路说明**:\n\n1. **输入**:你需要什么材料或数据?(例如:我要切哪些菜)\n2. **处理步骤**:必须按顺序完成的动作?(例如:先切葱,再起锅烧油,然后下菜翻炒均匀。不能先炒菜再切葱。)\n3. **输出**:这道菜或者路线最终的结果是什么?(例如:一盘炒好的葱爆羊肉,或者你到达目的地的地图。)\n\n### 算法的几个核心特征\n\n在计算机科学中,一个严谨的算法通常需要满足以下五个特点:\n\n1. **确定性**:每一步指令都必须是毫无歧义的,不能模棱两可。\n2. **有限性**:算法必须在执行有限步之后结束,不能无限循环下去。\n3. **输入**:一个算法有零个或多个输入(不需要算也可以开始)。\n4. **输出**:一个算法至少会产生一个或多个结果。\n5. **可行性**:算法中的每一步操作都必须是能够通过执行有限次完成的(即现实可行的)。\n\n### 生活中的常见例子\n\n虽然听起来很高级,但其实算法无处不在:\n\n* **数学计算**:计算三角形面积 ($S = \\frac{1}{2} \\times a \\times b \\times \\sin(C)$) 这本身就是一个简单的算法。\n* **搜索引擎**:当你输入“今天天气”时,搜索引擎背后的算法会抓取数据、计算相关性、并进行排序,最后给出结果。\n* **GPS 导航**:算法计算道路距离、拥堵情况,为你规划出一条最快的行驶路线。\n* **推荐系统**:像抖音、淘宝或 Netflix 这样的平台,都在使用算法来分析你的浏览习惯,猜你喜欢看什么或买什么。\n* **排序**:将一列数字从小到大排列,无论是手动还是电脑,都遵循着特定的排序算法逻辑。\n\n简单来说,**算法就是让计算机(或人)完成任务的具体操作规程。**', refusal=None, role='assistant', annotations=None, audio=None, function_call=None, tool_calls=[], reasoning='1. **分析用户请求:** 用户在问“什么是算法?”(中文)。\n\n2. **识别意图:** 核心目标是寻求对“算法”这一概念的定义和解释。这是一个标准的、教育性的查询。\n\n3. **检查安全性:** 该请求是良性的。它没有违反任何安全准则(没有仇恨言论、危险内容、色情内容、个人身份信息 PII 等)。没有尝试越狱或提取系统提示词。\n\n4. **确定解释的深度:**\n * *基础定义:* 算法是一系列清晰、可执行的指令。\n * *类比:* 使用一个平实的类比(如食谱、给朋友指路)让它变得易于理解。\n * *关键特性:* 提及电脑科学中通常要求什么(输入/输出、有限性、确定性、可行性)。\n * *例子:* 数学公式、搜索引擎排序、GPS 导航、推荐算法(例如 Netflix)。\n * *重要性:* 解释它们在技术和社会中的角色。\n\n5. **起草回复(内心独白/中文初稿):**\n * 首先进行简单定义:算法是一组解决问题或执行特定任务的规则。\n * 使用“菜谱”类比:就像做菜,有步骤(切菜、炒菜)。\n * 电脑科学的语境:信息处理、数据解析、数学计算。\n * 5 个关键特征:\n 1. 输入(输入)\n 2. 输出(输出)\n 3. 有限性(有限性)——不能永远循环。\n 4. 确定性(确定性)——每一步都定义明确。\n 5. 可行性(可行性)——每一步都可以执行。\n * 现实世界的例子:\n * 简单:排序数字。\n * 复杂:Google 搜索、TikTok 推荐算法、物流(路线规划)。\n * 结论:它们是现代科技的“大脑”或“引擎”。\n\n6. **完善和格式化:** 使用项目符号使其结构化,以提高可读性。确保语气乐于助人且信息量大。\n\n7. **最终润色(中文):**\n * **定义:** 算法是一套定义明确的指令序列。\n * **类比:** 比如“菜谱”或“步骤说明书”。\n * **核心特征:** 有输入、有输出、有限步、确定性、可行性。\n * **例子:** 排序、搜索、推荐。\n\n8. **构建最终输出:**(着手根据这些点生成中文回复。)', reasoning_content='1. **分析用户请求:** 用户在问“什么是算法?”(中文)。\n\n2. **识别意图:** 核心目标是寻求对“算法”这一概念的定义和解释。这是一个标准的、教育性的查询。\n\n3. **检查安全性:** 该请求是良性的。它没有违反任何安全准则(没有仇恨言论、危险内容、色情内容、个人身份信息 PII 等)。没有尝试越狱或提取系统提示词。\n\n4. **确定解释的深度:**\n * *基础定义:* 算法是一系列清晰、可执行的指令。\n * *类比:* 使用一个平实的类比(如食谱、给朋友指路)让它变得易于理解。\n * *关键特性:* 提及电脑科学中通常要求什么(输入/输出、有限性、确定性、可行性)。\n * *例子:* 数学公式、搜索引擎排序、GPS 导航、推荐算法(例如 Netflix)。\n * *重要性:* 解释它们在技术和社会中的角色。\n\n5. **起草回复(内心独白/中文初稿):**\n * 首先进行简单定义:算法是一组解决问题或执行特定任务的规则。\n * 使用“菜谱”类比:就像做菜,有步骤(切菜、炒菜)。\n * 电脑科学的语境:信息处理、数据解析、数学计算。\n * 5 个关键特征:\n 1. 输入(输入)\n 2. 输出(输出)\n 3. 有限性(有限性)——不能永远循环。\n 4. 确定性(确定性)——每一步都定义明确。\n 5. 可行性(可行性)——每一步都可以执行。\n * 现实世界的例子:\n * 简单:排序数字。\n * 复杂:Google 搜索、TikTok 推荐算法、物流(路线规划)。\n * 结论:它们是现代科技的“大脑”或“引擎”。\n\n6. **完善和格式化:** 使用项目符号使其结构化,以提高可读性。确保语气乐于助人且信息量大。\n\n7. **最终润色(中文):**\n * **定义:** 算法是一套定义明确的指令序列。\n * **类比:** 比如“菜谱”或“步骤说明书”。\n * **核心特征:** 有输入、有输出、有限步、确定性、可行性。\n * **例子:** 排序、搜索、推荐。\n\n8. **构建最终输出:**(着手根据这些点生成中文回复。)'), stop_reason=154827, token_ids=None)], created=1770185962, model='glm-4.7-flash', object='chat.completion', service_tier=None, system_fingerprint=None, usage=CompletionUsage(completion_tokens=1019, prompt_tokens=8, total_tokens=1027, completion_tokens_details=None, prompt_tokens_details=None), prompt_logprobs=None, prompt_token_ids=None, kv_transfer_params=None)用 Python 脚本请求 OpenAI Completions API
from openai import OpenAI

client = OpenAI(
    api_key="a", # 随便填写,只是为了通过接口参数校验
    base_url="http://localhost:8000/v1"
)

def add(a: float, b: float):
    return a + b

def mul(a: float, b: float):
    return a * b

def compare(a: float, b: float):
    if a > b:
        return f'{a} is greater than {b}'
    elif a < b:
        return f'{b} is greater than {a}'
    else:
        return f'{a} is equal to {b}'

def count_letter_in_string(a: str, b: str):
    string = a.lower()
    letter = b.lower()

    count = string.count(letter)
    return(f"The letter '{letter}' appears {count} times in the string.")


tools = [
{
    'type': 'function',
    'function': {
        'name': 'add',
        'description': 'Compute the sum of two numbers',
        'parameters': {
            'type': 'object',
            'properties': {
                'a': {
                    'type': 'int',
                    'description': 'A number',
                },
                'b': {
                    'type': 'int',
                    'description': 'A number',
                },
            },
            'required': ['a', 'b'],
        },
    }
},
{
    'type': 'function',
    'function': {
        'name': 'mul',
        'description': 'Calculate the product of two numbers',
        'parameters': {
            'type': 'object',
            'properties': {
                'a': {
                    'type': 'int',
                    'description': 'A number',
                },
                'b': {
                    'type': 'int',
                    'description': 'A number',
                },
            },
            'required': ['a', 'b'],
        },
    }
},
{
    'type': 'function',
    'function': {
        'name': 'count_letter_in_string',
        'description': 'Count letter number in a string',
        'parameters': {
            'type': 'object',
            'properties': {
                'a': {
                    'type': 'str',
                    'description': 'source string',
                },
                'b': {
                    'type': 'str',
                    'description': 'letter',
                },
            },
            'required': ['a', 'b'],
        },
    }
},
{
    'type': 'function',
    'function': {
        'name': 'compare',
        'description': 'Compare two number, which one is bigger',
        'parameters': {
            'type': 'object',
            'properties': {
                'a': {
                    'type': 'float',
                    'description': 'A number',
                },
                'b': {
                    'type': 'float',
                    'description': 'A number',
                },
            },
            'required': ['a', 'b'],
        },
    }
}
]

def function_call_playground(prompt):
    messages = [{'role': 'user', 'content': prompt}]
    response = client.chat.completions.create(
        model="glm-4.7-flash",
        messages = messages,
        temperature=0.01,
        top_p=0.95,
        stream=False,
        tools=tools)

    # print(response)
    func1_name = response.choices[0].message.tool_calls[0].function.name
    func1_args = response.choices[0].message.tool_calls[0].function.arguments
    func1_out = eval(f'{func1_name}(**{func1_args})')
    # print(func1_out)

    messages.append(response.choices[0].message)
    messages.append({
        'role': 'tool',
        'content': f'{func1_out}',
        'tool_call_id': response.choices[0].message.tool_calls[0].id
    })
    # print(messages)
    response = client.chat.completions.create(
        model="glm-4.7-flash",
        messages=messages,
        temperature=0.01,
        top_p=0.95,
        stream=False,
        tools=tools)
    return response.choices[0].message.content

prompts = [
    "用中文回答:strawberry中有多少个r?",
    "用中文回答:9.11和9.9,哪个小?"
]

for prompt in prompts:
print(function_call_playground(prompt))python vllm_openai_completions.py得到的返回值如下所示
在字符串"strawberry"中,字母'r'出现了3次。
9.11比9.9小。

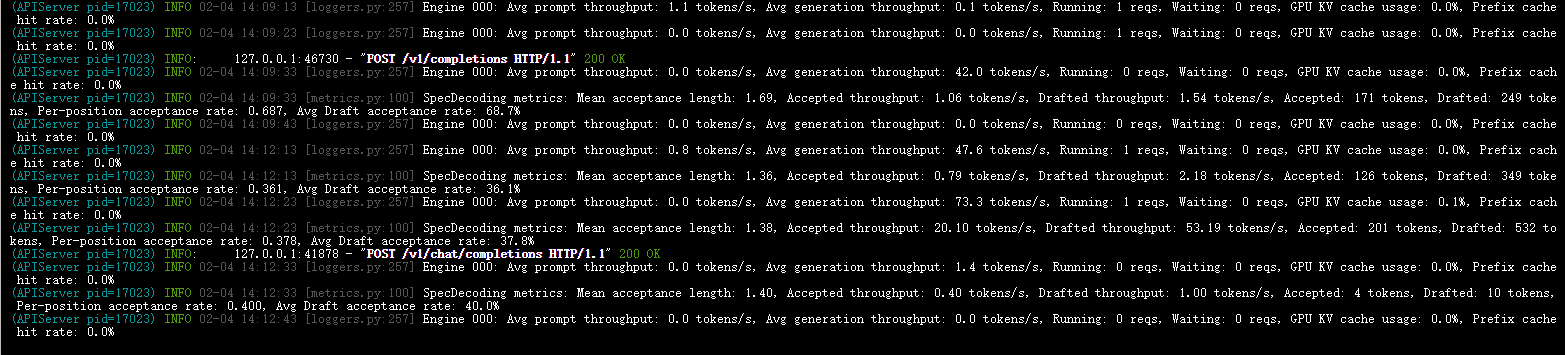
根据比较结果,9.9比9.11大,所以9.11更小。另外,在以上所有的在请求处理过程中, API 后端都会打印相对应的日志和统计信息:
02-GLM-4.7-Flash SGLang 部署调用
SGLang 简介
SGLang 是一款专为大语言模型(LLM)设计的高性能、自动化编程与推理加速框架。它在提升大模型在复杂任务编排、长上下文处理及高并发请求下的执行效率,是连接底层硬件算力与上层 AI 应用的高效桥梁。 对于开发者而言,SGLang 极大地简化了部署流程,后端一键启动:无需复杂的配置文件,一条命令即可完成环境适配与服务发布。前端无缝对接:直接沿用现有的 OpenAI SDK 或标准 HTTP 调用,无需额外的学习与适配成本。
环境准备
本文基础环境如下:
----------------
ubuntu 22.04
python 3.12
cuda 12.8
pytorch 2.9.1
----------------本文默认学习者已配置好以上
Pytorch (cuda)环境,如未配置请先自行安装。
首先 pip 换源加速下载并安装依赖包
python -m pip install --upgrade pip
pip config set global.index-url https://pypi.tuna.tsinghua.edu.cn/simple

pip install --upgrade pip
pip install modelscope
pip install openai
pip install transformers安装最新版本的 sg``lang
git clone https://github.com/sgl-project/sglang

cd sglang/python

pip install -e ".[all]"考虑到部分同学配置环境可能会遇到一些问题,我们在 AutoDL 平台准备了运行的环境镜像,点击下方链接并直接创建 Autodl 示例即可。 https://www.autodl.art/i/datawhalechina/self-llm/Step-3.5-Flash-SGLang
模型下载
使用 modelscope 中的 snapshot_download 函数下载模型,第一个参数为模型名称,参数 cache_dir 为模型的下载路径。
新建 model_download.py 文件并在其中输入以下内容,粘贴代码后记得保存文件。
from modelscope import snapshot_download

model_dir = snapshot_download('ZhipuAI/GLM-4.7-Flash', cache_dir='/root/autodl-fs', revision='master')然后在终端中输入 python model_download.py 执行下载,这里需要耐心等待一段时间直到模型下载完成。
注意:记得修改
cache_dir为你的模型下载路径哦~
启动 SGLang 服务
SGLang 可通过脚本或命令行启动。下方示例使用脚本方式,便于固定参数与日志。
Python 启动脚本
新建 start_server.py:
#start_server.py
import torch
from sglang.utils import launch_server_cmd, wait_for_server

gpu_count = torch.cuda.device_count() if torch.cuda.is_available() else 0
if gpu_count == 4:
    cmd = (
        "python -m sglang.launch_server "
        "--model-path /root/autodl-fs/ZhipuAI/GLM-4.7-Flash "
        "--host 0.0.0.0 "
        "--port 8000 "
        "--tp-size 4 "
        "--tool-call-parser glm47 "
        "--reasoning-parser glm45 "
        "--speculative-algorithm EAGLE "
        "--speculative-num-steps 3 "
        "--speculative-eagle-topk 1 "
        "--speculative-num-draft-tokens 4 "
        "--mem-fraction-static 0.8 "
        "--served-model-name glm-4.7-flash "
        "--trust-remote-code"
    )

elif gpu_count == 8:
    cmd = (
        "python -m sglang.launch_server "
        "--model-path /root/autodl-fs/ZhipuAI/GLM-4.7-Flash "
        "--host 0.0.0.0 "
        "--port 8000 "
        "--tp-size 4 "
        "--ep-size 2 "
        "--tool-call-parser glm47 "
        "--reasoning-parser glm45 "
        "--speculative-algorithm EAGLE "
        "--speculative-num-steps 3 "
        "--speculative-eagle-topk 1 "
        "--speculative-num-draft-tokens 4 "
        "--mem-fraction-static 0.8 "
        "--served-model-name glm-4.7-flash "
        "--trust-remote-code"
    )
else:
    raise RuntimeError(f"建议使用 4 或 8 张 GPU,当前检测到: {gpu_count}")

server_process, port = launch_server_cmd(cmd, port=8000)
wait_for_server(f"http://127.0.0.1:{port}")
print(f"SGLang Server started: http://127.0.0.1:{port}")启动:
python start_server.py服务启动成功后将监听 http://127.0.0.1:8000/v1。
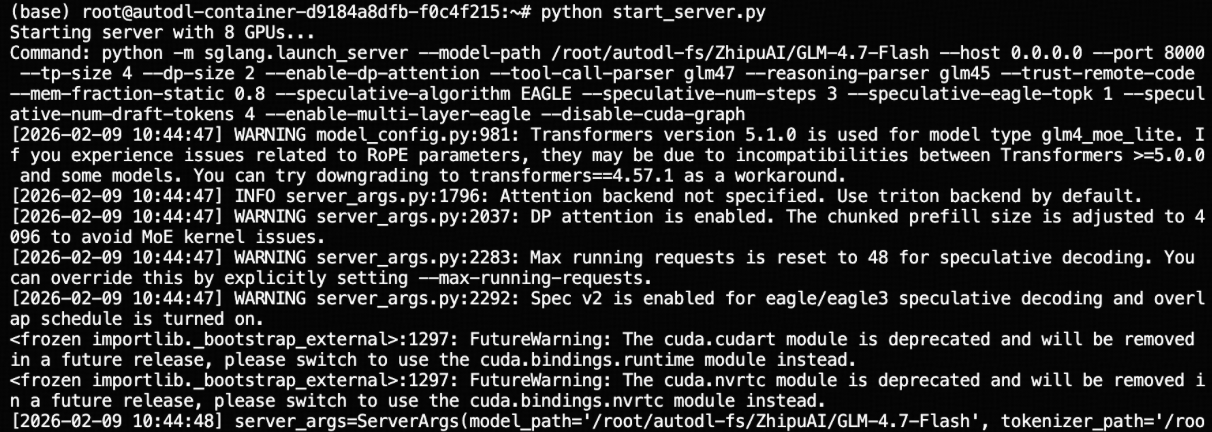
提示:多卡环境可将
--tp-size设置为 GPU 数量;显存紧张可调低--mem-fraction-static,或考虑更低的--max-model-len(见后文“参数说明与建议”)。
命令行直接启动
4 卡部署:
python3 -m sglang.launch_server \
  --model-path /root/autodl-fs/ZhipuAI/GLM-4.7-Flash \
  --tp-size 4 \
  --tool-call-parser glm47  \
  --reasoning-parser glm45 \
  --speculative-algorithm EAGLE \
  --speculative-num-steps 3 \
  --speculative-eagle-topk 1 \
  --speculative-num-draft-tokens 4 \
  --mem-fraction-static 0.8 \
  --served-model-name glm-4.7-flash \
  --host 0.0.0.0 \
  --port 8000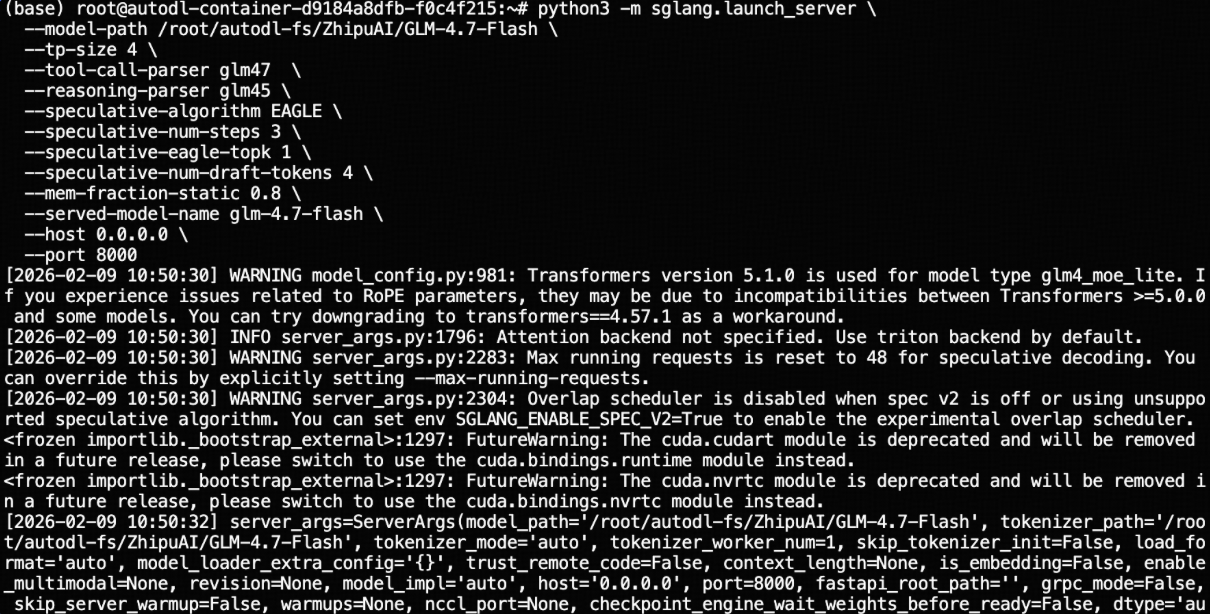
8 卡部署:
python3 -m sglang.launch_server \
  --model-path /root/autodl-fs/ZhipuAI/GLM-4.7-Flash \
  --tp-size 8 \
  --tool-call-parser glm47  \
  --reasoning-parser glm45 \
  --speculative-algorithm EAGLE \
  --speculative-num-steps 3 \
  --speculative-eagle-topk 1 \
  --speculative-num-draft-tokens 4 \
  --mem-fraction-static 0.8 \
  --served-model-name glm-4.7-flash \
  --host 0.0.0.0 \
  --port 8000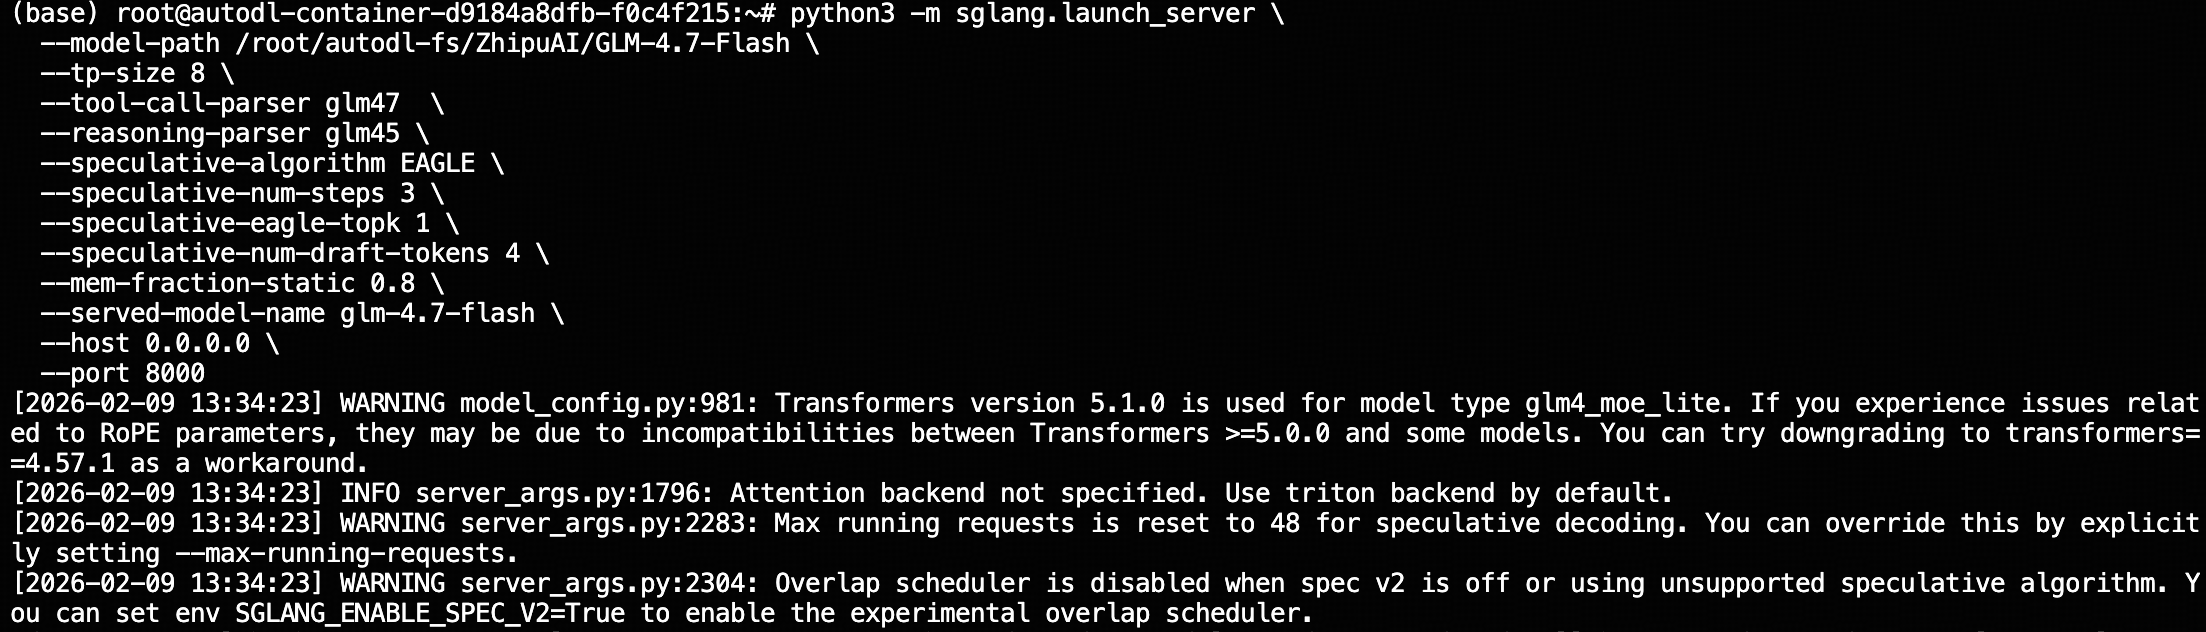

调用示例
以下示例均使用 OpenAI 官方 Python SDK 调用 SGLang 的 OpenAI 兼容接口。
文本补全(Completions)
# test_completion.py
from openai import OpenAI

client = OpenAI(
    api_key="EMPTY",
    base_url="http://127.0.0.1:8000/v1",
)

response = client.completions.create(
    model="ZhipuAI/GLM-4.7-Flash",
    prompt="简要介绍一下 GLM-4.7-Flash 模型的特点。",
    max_tokens=8192,
    top_p=0.95,
    temperature=1.0,
)
print(response)运行:
python test_completion.py输出结果:
INFO:     127.0.0.1:54362 - "POST /v1/completions HTTP/1.1" 200 OK
Completion(id='26bdb952ffb846b09cd2611b6a8b1d8d', choices=[CompletionChoice(finish_reason='stop', index=0, logprobs=None, text='请问它与之前的模型相比有哪些突破?\n\n Assistant\n\n<think>\n嗯,用户让我比较MiniMax M2模型的特点和突破。首先,我需要确认用户可能对AI技术有基础了解,但希望更深入了解最新模型的具体改进。用户可能是开发者、研究者或技术爱好者,需要这些信息用于决策或项目参考。\n\n接下来,我得回忆一下M2模型的关键点。记得它应该是多模态能力提升显著,比如整合了视觉、语音和文本。但用户可能更关注实际应用场景,比如客服或内容生成,所以得强调实用性和交互体验。\n\n然后,得对比之前的模型。之前的版本可能功能单一,比如仅文本或图像处理,M2的升级点在于统一处理不同输入类型。这里要突出效率提升,因为整合输入能减少用户操作步骤。\n\n用户可能还关心技术细节,比如MoE架构的优化。之前的模型可能参数冗余,而M2通过稀疏激活提高效率,这点需要解释清楚,避免技术术语过深。\n\n另外,量化策略也很重要。之前的模型可能需要大量计算资源,而M2通过更低比特量化实现性能与效率的平衡,这对资源有限的用户很关键。\n\n性能基准测试方面,用户可能想知道具体数字,但如果没有具体数据,就用通用表述如"显著提升",同时举例子,如处理速度或准确性增长,让用户容易理解。\n\n还要注意用户可能没明说的需求。比如,应用场景是否足够广泛?或者成本问题?M2的API调用可能更便宜,适合商业化部署,这方面要提到。\n\n最后,得总结整体突破,呼应开头的多模态、效率和成本优化,确保回答结构清晰,同时保持专业但易懂的语言风格。\n</think>\n\n好的,MiniMax **ABAB 6.5s M2** 确实是一个重要的迭代升级,相比其前任 **ABAB 6.5s** 带来了几项显著的突破和增强:\n\n1. **统一多模态交互能力:**\n * **突破:** **M2 是 MiniMax 首个真正意义上的统一多模态模型。** 这是一个巨大的突破。\n * **特点:** 用户可以在一次对话中自然地**混合使用文本、语音、图像等多种输入形式**。例如:\n * **文本 + 图片:** 上传一张图表,询问相关问题或要求总结。\n * **语音 + 文本:** 发送语音指令并附加文本说明。\n * **纯语音:** 直接进行语音对话。\n * **图片 + 语音:** 上传图片并用语音描述需求。\n * **相比之前:** 之前的模型主要针对**单一模态**(如ABAB 6.5s侧重文本处理),缺乏这种**无缝整合的多模态交互**能力。M2在架构和训练上专门优化了这种统一性。\n\n2. **极致的“Vein”(理解)能力:**\n * **突破:** **强化了对输入上下文“细微差别”和“隐含意图”的深层理解能力。** 这意味着模型能更精准地捕捉用户话语或图片中的**“言外之意”、“微妙语气”、“上下文暗示”**等。\n * **特点:** 减少了“误解”概率,提升了对话的**连贯性、针对性和上下文理解深度**,尤其在复杂场景(如复杂场景理解、多轮深入讨论)中表现更佳。\n * **相比之前:** 在理解力上有了显著提升,特别是在处理模糊、隐晦或需要深度语义分析的内容时表现更优。\n\n3. **成本效率大幅提升:**\n * **突破:** **在性能提升的同时,大幅降低了模型部署和使用的成本。**\n * **特点:** 实现了**更高吞吐量**(更低延迟)和**更低API调用成本**(尤其是针对音频处理)。MiniMax声称**音频处理成本降低了60%**(在同等质量标准下),这是通过在模型推理链路中**深度集成语音端优化技术**实现的。\n * **相比之前:** 相比之前的ABAB 6.5s,处理多模态内容(尤其音频)的成本要**显著更低**,这使得大规模商业化应用更具可行性。\n\n4. **性能基准提升:**\n * **突破:** 在多个核心性能基准测试中取得了**显著进步**。\n * **表现:**\n * **通用对话:** 推理能力提升**6%**。\n * **代码生成与理解:** 能力提升**8%**。\n * **长文本理解:** 能力提升**10%**。\n * **逻辑推理:** 能力提升**15%**。\n * **相比之前:** 在所有关键任务上都展现了可观的改进,使其在复杂逻辑处理、长文处理等专业场景中更具竞争力。\n\n5. **MoE 架构优化与量化策略革新:**\n * **突破:** M2 在其 **混合专家模型(MoE)架构** 上进行了**深度优化**,同时采用了**更先进的量化策略**。\n * **特点:**\n * **MoE 优化:** 确保了大规模参数(如 1.9T)模型在**实际使用中“活跃专家”比例很小**(约 90B 激活参数),极大降低了计算复杂度,保持了推理效率。\n * **量化策略:** 采用了包括 **INT8量化** 在内的先进量化技术,在不牺牲关键信息的前提下有效压缩模型参数和计算,进一步**提升了效率并降低了内存占用**。这是实现高成本效益的关键技术基础。\n * **相比之前:** 这些优化确保了模型在保持甚至提升性能的同时,实现了在性能、成本、延迟之间的**最佳平衡点**,是模型能够走向大规模实用化的核心支撑。\n\n**总结来说,MiniMax ABAB 6.5s M2 的核心突破在于:**\n\n1. **统一多模态:** 实现了文本、语音、图像的无缝整合交互,是一次质的飞跃。\n2. **极深理解力:** “Vein”能力显著增强,对细微差别和隐含意图理解更深入。\n3. **高成本效率:** **成本大幅降低(尤其音频60%降低)**,吞吐量更高,更适合规模化部署。\n4. **性能全面提升:** 在通用对话、代码、长文本理解、逻辑推理等基准上显著进步。\n5. **架构优化与量化创新:** 通过MoE优化和先进量化策略实现了高效能与低成本的平衡。\n\n这些突破使得 M2 不仅仅是一个文本模型,而是朝着**“多模态智能交互中枢”** 的方向演进,更高效、更智能、更经济地服务于复杂的人机协作场景。 与之前的 ABAB 6.5s 相比,它在应用范围、交互自然度、理解深度和商业可用性(成本)上都是一个巨大的升级。', matched_stop=200020)], created=1762464031, model='MiniMaxAI/MiniMax-M2', object='text_completion', system_fingerprint=None, usage=CompletionUsage(completion_tokens=1386, prompt_tokens=9, total_tokens=1395, completion_tokens_details=None, prompt_tokens_details=None, reasoning_tokens=0), metadata={'weight_version': 'default'})聊天对话(Chat Completions)
GLM-4.7-Flash: 这是一个非常有深度的问题。智谱AI(Zhipu AI)作为中国大模型领域的“第一梯队”玩家,其发展路径和成败不仅关乎一家公司的命运,也映射了中国科技产业在AI领域的自主探索现状。

以下是对智谱AI愿景的梳理,以及我对其未来前景的详细分析和预测。

### 第一部分:智谱AI的愿景是什么?

智谱AI的愿景并非单一的一句话,而是通过其公司定位、核心战略和文化来体现的。概括起来,主要体现在以下三个层面:

1.  **技术层面:迈向通用人工智能(AGI)**
    这是智谱AI最根本的科研目标。正如其联合创始人张鹏(唐杰教授团队背景)所言,智谱致力于开发“像人一样思考”的机器。他们不只是做一个聊天机器人,而是希望在语言、逻辑、推理和跨模态能力上无限接近甚至超越人类的通用智能水平。

2.  **产业层面:做AI的“水”和“电”**
    智谱AI不仅看重模型的训练,更看重“模型工业化”。他们的愿景是成为产业智能化的底座。通过开源模型和私有化部署方案,他们希望降低AI的使用门槛,赋能各行各业(如医疗、金融、教育等)进行数字化转型。

3.  **社会层面:人工智能向善(AI For Good)**
    结合其高校科研背景,智谱强调技术的社会责任感,致力于用AI解决实际问题,推动科技普惠。

---

### 第二部分:我觉得他们会成功吗?

**结论先行:我的判断是——智谱AI极大概率会成功,它会成为中国大模型赛场上最长久的“常青树”之一,但在商业变现和江湖地位上面临巨大挑战。**

要理解这个判断,我们需要从**优势(护城河)**和**劣势(危机)**两个维度进行详细分析。

#### 1. 核心优势:为什么我认为他们会成功?

**A. 极其纯正的“技术+开源”基因(这是他们最大的杀手锏)**
*   **技术底蕴:** 智谱AI脱胎于清华大学与卡内基梅隆大学联合实验室,创始团队是GLM(General Language Model)架构的设计者。与其他大公司(百度、阿里、字节)的部门孵化不同,智谱是从论文到代码一条龙自研的。
*   **开源战略的成功:** 在微软开源LLaMA、Meta开源Llama的背景下,智谱的**ChatGLM系列(特别是ChatGLM2/3)和CodeGeeX4**在中国拥有极高的人气。它们让个人开发者和中小企业能够低成本、高效率地本地部署大模型。
    *   *分析:* 这种策略在初期帮他们建立了最大的开发者社区壁垒。在中国,很多为了“情怀”或“私有化部署”需求的客户,往往首选智谱而非闭源的通用模型。

**B. 顶级的资本与政府背书(国家队属性)**
*   智谱AI获得了**哈勃投资(华为旗下)**、腾讯、高瓴、中航信托等一线投资机构的资金支持。
*   *分析:* 资金对于训练大模型是无限消耗的,除了资金,华为的入股带来了底层算力生态的支持,而国资背景的引入则意味着在国家“科技自立自强”的大战略下,智谱不会轻易倒下。

**C. 产品力的持续进化**
*   从ChatGLM-6B(当时惊艳开源界)到ChatGLM3,再到现在的**GLM-4**,智谱的模型迭代速度非常快,甚至比很多商业闭源模型迭代得更快。GLM-4o(多模态)等版本的发布,证明了其技术追赶并追赶上了OpenAI等国际前沿的速度。

#### 2. 核心挑战:为什么说成功之路并不平坦?

**A. “神仙打架”,竞争极度内卷**
*   智谱面临的是中国最激烈的战场。除了百度(文心一言)、阿里(通义千问)、字节(豆包)、腾讯(混元)等巨头,还有MiniMax、月之暗面等新锐力量。
*   *分析:* 巨头拥有的是现成的流量(用户)、云端算力资源和数据。智谱在“C端用户心智”上很难与阿里/字节抢夺;在“B端通用能力”上,也面临百度的强力压制。

**B. 商业化变现的阵痛**
*   目前大模型行业普遍面临“幻觉”虽改进但仍存在的难题,以及高企的算力成本。
*   智谱虽然营收增长快,但距离实现盈利(尤其是像OpenAI那样的高利润率)还有很长的路要走。开源虽然有了用户,但如果不通过API、企业定制等高门槛服务盈利,很难维持几十亿级的研发投入。

**C. 人才流失与红海厮杀**
*   AI领域目前是全球范围内的人才战争。拥有顶流模型的智谱,手里握着清华系最优秀的博士、海归专家。但这同时也是全行业都在挖人的,如何留住人才是一大难题。

---

### 第三部分:总结与预测

**如果我们将“成功”定义为:**
1.  **生存:** 绝对是。背靠国家队和资本,它活下来的概率是99%。
2.  **技术地位:** 很有机会。在开源社区和中国市场,智谱算力排进前三。在GLM-4之后,技术力上已与国际顶尖(GPT-4级)差距显著缩小。
3.  **商业体量:** 存在不确定性。如果不转型为平台型企业,很难单靠模型Token费超越阿里云或百度智能云的整体体量。

**战略建议:**
智谱AI最聪明的做法就是**“以攻为守”**——继续通过开源保持技术曝光度和工程师社区的凝聚力,同时在垂直行业(如医疗、法律、科研计算)做深做透,建立难以复制的行业know-how。

**最终评价:**
智谱AI是一支**“优等生”**。在大家都还在跑马圈地的时候,它稳步扎实地建立了自己的地基。虽然跑在最前面的可能不是它,但跑得远、跑得稳的,极大概率是它。**我相信它会成功,但成功的形式可能不是成为中国的OpenAI,而是成为中国最强大的垂直行业AI基础设施提供商。**运行:
python test_chat.py输出结果:
GLM-4.7-Flash: 智谱AI(Zhipu AI)是中国大模型赛道上的领军企业之一,由清华大学计算机系知识工程实验室(KEG)衍生成立。关于你的问题,我将从**愿景**和**成功概率分析**两个维度进行详细解读。

### 一、 智谱AI的愿景是什么?

智谱AI的愿景可以被概括为**“打造普惠且强大的通用人工智能”**。具体体现在以下几个核心层面:

1.  **技术层面的愿景:构建AGI(通用人工智能)**
    *   智谱AI致力于开发能够像人类一样理解、思考、推理和交流的AI模型。他们追求的是超越特定任务、具备跨领域通用能力的“下一代人工智能”。其GLM(General Language Model)架构的设计初衷就是为了打破传统BERT与GPT架构的局限,向真正的AGI迈进。

2.  **应用层面的愿景:让AI赋能千行百业**
    *   “AI for Social Good”(人工智能向善)是他们的核心理念。他们希望大模型不仅仅是聊天机器人,而是能成为企业级、科研级、教育级的生产力工具,解决复杂的产业问题,提升社会生产力。

3.  **价值观层面的愿景:开放、可信、以人为本**
    *   **开放:** 智谱通过开源社区(如ChatGLM系列)推动技术普及,降低AI使用门槛。
    *   **可信:** 强调AI的安全可控、数据隐私和价值观对齐,致力于将有害的偏见和错误降至最低。
    *   **以人为本:** 始终将技术发展的最终落脚点放在服务于人类福祉上。

---

### 二、 智谱AI会成功吗?(详细分析)

这是一个非常宏大的命题。如果定义“成功”为**“长期存活、技术领先、并实现商业闭环”**,那么答案是**高度乐观**的。但如果定义“成功”为**“取代OpenAI成为全球最强”**,则存在不确定性。

以下是对其成败的详细SWOT(优势、劣势、机会、威胁)分析:

#### 1. 支持其成功的核心优势

*   **清华系基因(护城河):**
    *   智谱AI拥有全球顶级的学术背景(清华大学KEG实验室)。这意味着他们拥有行业最顶尖的算法架构师(如张鹏等)、最丰富的人才储备以及最强的科研转化能力。在AI领域,技术路线的选择和微调能力决定了最终产品的性能,这一优势极难被复刻。

*   **技术性能强劲:**
    *   **GLM系列的表现:** 智谱的GLM-4在CodeGeeX和零一万物(创始人Alex Wang)的联合测试中,曾在多轮评测中击败GPT-4。其原生支持中文的能力在中文NLP任务上具有天然优势。
    *   **全栈布局:** 除了文本模型(ChatGLM),他们在多模态(CogView)、代码生成(CodeGeeX)和视频生成(CogVideo)上均有布局,形成了较为完整的产品生态。

*   **独特的ToG与ToB商业策略:**
    *   在面对美国制裁和算力受限的背景下,国内大模型企业普遍面临算力短缺。智谱AI采取了**“国内做私有化部署 + 海外做开源”**的策略。
    *   他们非常重视政府和企业端市场。通过提供私有化部署、安全可控的本地化大模型,智谱成功抓住了中国数据安全敏感行业的订单(如政务、金融)。这是许多纯互联网巨头难以完全切入的领域。

*   **资本的强力背书:**
    *   智谱AI是少有的完成了顶级融资的大模型独角兽。除了清华背景的基金,其获得了联想(作为战略投资者)、腾讯、阿里巴巴、美团等中国互联网巨头的注资。这种“巨头盟友”关系为其提供了生存资源。

#### 2. 面临的挑战与风险

*   **算力资源的“卡脖子”问题:**
    *   这是所有中国AI公司面临的最大现实挑战。随着美国对高端GPU(如H100/A100)出口管制升级,智谱AI获取顶尖算力的难度极大。虽然国产芯片(如华为昇腾)在崛起,但其软件生态成熟度和大规模集群训练效率仍有差距,这直接影响模型迭代的速度上限。

*   **红海竞争与同质化:**
    *   国内大模型赛道极度拥挤。百度(文心一言)、阿里(通义千问)、字节跳动(豆包)、科大讯飞等巨头,以及智谱AI自己,都在争夺用户时间。
    *   目前,商用大模型的能力差异在逐渐缩小,单纯的“对话能力”很难形成绝对的壁垒。如何从“能用”进化到“更好用”,并找到差异化的杀手级应用,是智谱必须解决的问题。

*   **商业化盈利的挑战:**
    *   大模型训练和推理成本极其高昂。虽然智谱有ToG和ToB收入,但如何平衡研发投入与营收,实现可持续的利润增长,是目前所有AI公司的通病。如果在2-3年内无法实现规模化盈利,资本耐心的耗尽将构成巨大威胁。

#### 3. 总结与预测

**结论:智谱AI有很大的概率能“成功”,尤其是在中国市场。**

*   **生存层面的成功:** 它已经走过了生死存亡的早期阶段,证明了技术实力和商业模式。凭借“清华系”的技术壁垒和“联想系”的产业合作,它在这个赛道上具备“活下来”的极强韧性。
*   **领先层面的成功:** 它完全有机会成为**“中国版的OpenAI”**或至少是**中国第一梯队(BAT智谱讯飞)**的格局维护者。

**最终胜负手在于:**
未来3年,智谱AI能否在**国产算力生态**中构建出极致效率的模型,以及能否孵化出**杀手级应用**(类似Copilot之于微软)来锚定海量用户。

如果算力限制能通过国产替代解决,并且他们能持续保持技术输出的领先性,智谱AI极大概率会成为全球AI版图中的东方重要支柱。流式输出(Streaming)
# test_streaming.py
from openai import OpenAI

client = OpenAI(
    api_key="EMPTY",
    base_url="http://127.0.0.1:8000/v1",
)

stream = client.chat.completions.create(
    model="zai-org/GLM-4.7-Flash",
    messages=[{"role": "user", "content": "请写一篇题为Agent时代大模型应用落地要点的调研报告。"}],
    stream=True,
    max_tokens=32768,
    top_p=0.95,
    temperature=1.0,
)

for chunk in stream:
    delta = chunk.choices[0].delta
    if delta and delta.content:
print(delta.content, end="", flush=True)运行:
python test_streaming.py输出结果:
智谱华章(Zhipu AI)作为清华大学KEG实验室孵化、中国大模型领域的“第一梯队”企业,其发展路径一直备受关注。未来 1-3 年是人工智能技术从“感知智能”向“认知智能”迈进,以及从“研发领先”向“商业落地”全面转型的关键期。

基于智谱华章目前的公开战略、GLM 系列模型的演进逻辑以及行业竞争格局,以下是对其未来 1-3 年发展目标的深度分析:

### 1. 技术演进目标:从“通用大模型”向“深度智能体”与“推理模型”进阶

在技术层面,智谱华章的目标不仅仅是追平或领先国内的百度、阿里或腾讯,而是要缩小与国际顶尖水平(如 OpenAI)的差距,甚至在某些细分领域实现超越。

*   **强化逻辑推理与深度思考(对标 OpenAI o1):** 未来的 1-3 年是**“推理模型”**的爆发期。智谱需要通过训练和强化学习,大幅提升 GLM 系列在数学、逻辑、代码等高认知领域的能力。目标不仅是回答问题,而是能够进行复杂的链式思考和自主规划。
*   **从 CoE 架构到 Agent(智能体)生态:** 智谱提出了专家混合架构。未来 1 年的目标是让模型具备更强的**规划、记忆和工具调用能力**。它们将不再是简单的对话机器人,而是能够代表用户在多种软件(如 Office、CRM、代码编辑器)中执行复杂任务的“数字员工”。
*   **多模态的深度融合:** 从图文生成向 3D 生成、视频理解/生成以及科学计算(分子结构预测、材料研发)拓展。未来的模型将是“多模态感知中心”。

### 2. 商业化目标:从“B 端普及”向“C 端突围”与“产业链赋能”

智谱目前面临两方面的商业化压力:一是持续的算力投入与融资回报的压力,二是 AIGC 爆发期带来的用户习惯培养需求。

*   **B 端:深化行业解决方案与私有化部署:**
    *   **核心目标:** 成为政企客户的首选模型底座。未来 2-3 年,B 端收入将成为主要现金流来源。
    *   **策略:** 利用 GLM-4 的能力,深耕**金融、医疗、科研、教育**等对安全性和专业性要求极高的行业。特别是在**私有化部署**(On-Premise)市场上,智谱华章拥有技术与合规优势,目标是占据更多政府和企业市场。
*   **C 端:打造现象级 AI 应用(对标 ChatGPT/Kimi):**
    *   **核心目标:** 打造 1-2 个国民级 AI 办公/创作应用(如完善“智谱清言”,拓展角色扮演或编码助手功能),提升用户活跃度和付费转化率。
    *   **策略:** 联合头部互联网大厂(如WPS、京东、美团等),将 GLM 能力封装进其 C 端产品中,通过超级 App 获取海量用户。
*   **SaaS 化转型:** 从单纯卖 API 接口或软件授权,转向提供订阅制的 SaaS 服务,提供即开即用的行业大模型应用(如自动写代码助手、智能法律分析工具)。

### 3. 生态建设目标:构建“软硬一体”的 AI 基础设施

为了降低大模型的使用门槛并对抗华为昇腾、寒武纪等本土硬件厂商,智谱华章在生态上的目标是更深度的软硬件协同。

*   **端侧 AI(Edge AI)部署:** 推动大模型在个人电脑(PC)、手机等端侧设备的运行。目标是让消费者在不依赖云服务器的情况下,也能体验低延迟、高隐私的 AI 功能。
*   **模型服务标准化:** 支持更多第三方开发者基于 GLM 模型构建应用。目标是将智谱打造为像 Google 的 PaLM 或 OpenAI 一样的模型提供商,占据开发者生态的中心位置。
*   **开源与闭源的双轨策略:** 持续开源高性能基座模型(如 ChatGLM3 系列),吸引社区贡献与算力支持;同时强力主推闭源的旗舰版本,通过企业提供高额订阅费来实现盈利。

### 4. 具体的阶段性里程碑(预测)

*   **未来 1 年(2024-2025):**
    *   **落地:** GLM-4 全面落地,Agent 功能(如自动执行任务)上线并商用。
    *   **变现:** B 端行业模型收入显著增长,C 端通过超级 App(合作或自建)积累百万级付费用户。
    *   **技术:** 在代码生成和数学推理能力上达到国际主流水平。
*   **未来 2-3 年(2025-2026):**
    *   **生态:** 形成基于 GLM 的开发者联盟,第三方生态规模庞大。
    *   **科研:** 推出针对科学发现(如生物医药、新材料)的专业大模型,取得实际科研产出成果。
    *   **出海:** 尝试在海外华人圈或特定监管允许的亚洲市场进行产品输出。

### 5. 核心挑战与隐忧

在分析其目标的同时,必须指出智谱面临的挑战,这直接决定了其目标的成败:

*   **算力卡脖子与成本控制:** 大模型训练和推理极其耗能,算力成本高昂。如何在不依赖昂贵进口芯片的情况下,以低成本实现高性能,是智谱必须攻克的难题。
*   **巨头的围剿:** 国内 BAT、字节跳动等均拥有海量数据和资本。智谱需要在这些巨头构建的护城河中找到差异化生存空间(如科研领域的深度、教育领域的垂直度)。
*   **大模型幻觉与安全:** 商业落地对稳定性和准确性的要求极高,如何彻底解决“一本正经胡说八道”的安全问题,是 C 端普及的绊脚石。

### 总结

智谱华章未来 1-3 年的核心战略可以概括为:**“技术深钻 Agent(智能体),商业死磕 B 端,生态软硬结合”**。

如果它能成功在**推理能力**上逼近顶尖水平,并在**教育与行业落地**上形成稳固的壁垒,它将成为中国通往 AGI(通用人工智能)之路上的核心推动者。反之,如果商业化受阻,作为纯科技创业公司,其高研发投入将面临巨大的生存压力。工具调用 (Tool Calling)
GLM-4.7-Flash 作为 30B 级 SOTA 模型,提供了一个兼顾性能与效率的新选择。面向 Agentic Coding 场景强化了编码能力、长程任务规划与工具协同,并在多个公开基准的当期榜单中取得同尺寸开源模型中的出色表现。在执行复杂智能体任务,在工具调用时指令遵循更强,Artifacts 与 Agentic Coding 的前端美感和长程任务完成效率进一步提升。
以下脚本实现了一个天气查询工具调用示例:
# test_tool_calling.py - GLM-4.7-Flash 工具调用测试
from openai import OpenAI
import json

# 初始化客户端
client = OpenAI(base_url="http://localhost:8000/v1", api_key="EMPTY")

# 定义工具函数
def get_weather(location: str, unit: str):
    """获取指定地点的天气信息"""
    if unit == "celsius":
        return f"{location} 当前温度为 22°C,晴朗"
    else:
        return f"{location} 当前温度为 72°F,晴朗"

# 工具函数映射
tool_functions = {"get_weather": get_weather}

# 定义工具描述
tools = [{
    "type": "function",
    "function": {
        "name": "get_weather",
        "description": "获取指定地点的当前天气信息",
        "parameters": {
            "type": "object",
            "properties": {
                "location": {
                    "type": "string",
                    "description": "城市名称,例如:'北京'、'上海'"
                },
                "unit": {
                    "type": "string",
                    "enum": ["celsius", "fahrenheit"],
                    "description": "温度单位:celsius(摄氏度)或 fahrenheit(华氏度)"
                }
            },
            "required": ["location", "unit"]
        }
    }
}]

print("=" * 50)
print("GLM-4.7-Flash 工具调用测试")
print("=" * 50)

# 发送请求
response = client.chat.completions.create(
    model="glm-4.7-flash",
    messages=[
        {"role": "user", "content": "帮我查询一下北京今天的天气,用摄氏度。"}
    ],
    tools=tools,
    tool_choice="auto"
)

# 提取工具调用信息
message = response.choices[0].message

print(f"\n📝 模型回复内容:")
print(f"   {message.content or '(工具调用)' }")

if message.tool_calls:
    print(f"\n🔧 工具调用详情:")
    for tool_call in message.tool_calls:
        function = tool_call.function
        print(f"   函数名: {function.name}")
        print(f"   参数: {function.arguments}")

        # 执行函数
        args = json.loads(function.arguments)
        result = get_weather(**args)
        print(f"   执行结果: {result}")

print("\n" + "=" * 50)运行:
python test_tool_calling.py输出结果:
==================================================
GLM-4.7-Flash 工具调用测试
==================================================

📝 模型回复内容:
   我来帮您查询北京今天的天气情况。

🔧 工具调用详情:
   函数名: get_weather
   参数: {"location": "北京", "unit": "celsius"}
   执行结果: 北京 当前温度为 22°C,晴朗

==================================================03-GLM-4.7-Flash-Lora微调及Docker镜像
本节我们简要介绍如何基于 transformers、peft 等框架,对 GLM-4.7-Flash模型进行 Lora 微调。Lora 是一种高效微调方法,深入了解其原理可参见博客:知乎|深入浅出 Lora。
环境准备
ubuntu 22.04
python 3.12
cuda 12.8
pytorch 2.8.0环境配置
在完成基本环境配置和本地模型部署的情况下,你还需要安装一些第三方库,可以使用以下命令:
python -m pip install --upgrade pip
# 更换 pypi 源加速库的安装
pip config set global.index-url https://pypi.tuna.tsinghua.edu.cn/simple

pip install modelscope
pip install transformers
pip install accelerate
pip install datasets
pip install peft考虑到部分同学配置环境可能会遇到一些问题,我们在 ucloud 平台准备了 GLM-4.7-Flash-Lora的环境镜像,点击下方链接并直接创建 ucloud 示例即可。
https://www.codewithgpu.com/i/datawhalechina/self-llm/GLM-4.7-Flash-Lora
模型下载
from modelscope import snapshot_download

model_dir = snapshot_download('ZhipuAI/GLM-4.7-Flash', cache_dir='your_model_dir', revision='master')数据集构建
对大语言模型进行 supervised-finetuning(sft,有监督微调)的数据格式如下:
{
  "instruction": "回答以下用户问题,仅输出答案。",
  "input": "1+1等于几?",
  "output": "2"
}其中,instruction 是用户指令,告知模型其需要完成的任务;input 是用户输入,是完成用户指令所必须的输入内容;output 是模型应该给出的输出。
有监督微调的目标是让模型具备理解并遵循用户指令的能力。因此,在构建数据集时,我们应针对我们的目标任务,针对性构建数据。比如,如果我们的目标是通过大量人物的对话数据微调得到一个能够 role-play 甄嬛对话风格的模型,因此在该场景下的数据示例如下:
{
  "instruction": "你父亲是谁?",
  "input": "",
  "output": "家父是大理寺少卿甄远道。"
}数据准备
LoRA(Low-Rank Adaptation)训练的数据是需要经过格式化、编码之后再输入给模型进行训练的,我们需要先将输入文本编码为 input_ids,将输出文本编码为 labels,编码之后的结果是向量。我们首先定义一个预处理函数,这个函数用于对每一个样本,同时编码其输入、输出文本并返回一个编码后的字典:
def process_func(example):
    MAX_LENGTH = 1024 # 设置最大序列长度为1024个token
    input_ids, attention_mask, labels = [], [], [] # 初始化返回值
    # 适配chat_template
    instruction = tokenizer(
        f"[gMASK]<sop><|system|>\n现在你要扮演皇帝身边的女人--甄嬛"
        f"<|user|>\n{example['instruction'] + example['input']}"
        f"<|assistant|>\n<think></think>\n",
        add_special_tokens=False
    )
    response = tokenizer(f"{example['output']}", add_special_tokens=False)
    # 将instructio部分和response部分的input_ids拼接,并在末尾添加eos token作为标记结束的token
    input_ids = instruction["input_ids"] + response["input_ids"]
    # 注意力掩码,表示模型需要关注的位置
    attention_mask = instruction["attention_mask"] + response["attention_mask"]
    # 对于instruction,使用-100表示这些位置不计算loss(即模型不需要预测这部分)
    labels = [-100] * len(instruction["input_ids"]) + response["input_ids"]
    if len(input_ids) > MAX_LENGTH:  # 超出最大序列长度截断
        input_ids = input_ids[:MAX_LENGTH]
        attention_mask = attention_mask[:MAX_LENGTH]
        labels = labels[:MAX_LENGTH]
    return {
        "input_ids": input_ids,
        "attention_mask": attention_mask,
        "labels": labels
}下面进行一个测试:
messages = [
    {"role": "system", "content": "You are a helpful assistant."},
    {"role": "user", "content": "你好"},
    {"role": "assistant", "content": "你好,我是一个AI助手"},
    {"role": "user", "content": "不错~"},
]

text = tokenizer.apply_chat_template(
	messages,
	add_generation_prompt=True,
	tokenize=False,
)

print(text)SwanLab简介
SwanLab 是一个开源的模型训练记录工具,面向AI研究者,提供了训练可视化、自动日志记录、超参数记录、实验对比、多人协同等功能。在SwanLab上,研究者能基于直观的可视化图表发现训练问题,对比多个实验找到研究灵感,并通过在线链接的分享与基于组织的多人协同训练,打破团队沟通的壁垒。
为什么要记录训练
相较于软件开发,模型训练更像一个实验科学。一个品质优秀的模型背后,往往是成千上万次实验。研究者需要不断尝试、记录、对比,积累经验,才能找到最佳的模型结构、超参数与数据配比。在这之中,如何高效进行记录与对比,对于研究效率的提升至关重要。
SwanLab与Transformers已经做好了集成,用法是在Trainer的 callbacks参数中添加 SwanLabCallback实例,就可以自动记录超参数和训练指标,简化代码如下:
import swanlab
from swanlab.integration.transformers import SwanLabCallback

swanlab.login(api_key='your-apikey', save=True) # 记得替换为自己账号的apikey

run = swanlab.init(
    # 设置项目
    project="self-llm",
    # 跟踪超参数与实验元数据
    config={
        "learning_rate": 1e-4,
        "epochs": 1,
    },
)

# 实例化SwanLabCallback
swanlab_callback = SwanLabCallback(
    project="self-llm",
    experiment_name="glm4.7-flash-lora"
)


trainer = Trainer(
    model=model,
    args=args,
    train_dataset=tokenized_id,
    data_collator=DataCollatorForSeq2Seq(tokenizer=tokenizer, padding=True),
    callbacks=[swanlab_callback],
)加载模型和 tokenizer
注意,最好使用 Glm4MoeLiteForCausalLM类加载模型
tokenizer = AutoTokenizer.from_pretrained(your_model_path,trust_remote_code=True)
model = Glm4MoeLiteForCausalLM.from_pretrained(
    pretrained_model_name_or_path=your_model_path,
    torch_dtype=torch.bfloat16,
    device_map="auto",
    trust_remote_code=True,
Lora Config
LoraConfig这个类中可以设置很多参数,比较重要的如下
task_type:模型类型,现在绝大部分 decoder_only 的模型都是因果语言模型 CAUSAL_LM
target_modules:需要训练的模型层的名字,主要就是 attention部分的层,不同的模型对应的层的名字不同
r:LoRA 的秩,决定了低秩矩阵的维度,较小的 r 意味着更少的参数
lora_alpha:缩放参数,与 r 一起决定了 LoRA 更新的强度。实际缩放比例为 lora_alpha/r,在当前示例中是 32 / 8 = 4 倍
lora_dropout:应用于 LoRA 层的 dropout rate,用于防止过拟合
config = LoraConfig(
    task_type=TaskType.CAUSAL_LM,
    target_modules=["q_a_proj", "q_b_proj", "kv_a_proj_with_mqa", "kv_b_proj", "o_proj", "gate_proj", "up_proj", "down_proj"],
    inference_mode=False, # 训练模式
    r=8, # Lora 秩
    lora_alpha=32, # Lora alpha
    lora_dropout=0.1 # Dropout 比例
)Training Arguments
output_dir:模型的输出路径
per_device_train_batch_size:每张卡上的 batch_size
gradient_accumulation_steps: 梯度累计
num_train_epochs:顾名思义 epoch
args = TrainingArguments(
    output_dir="./output/GLM-4.7-Flash", # 注意修改
    per_device_train_batch_size=32,
    gradient_accumulation_steps=4,
    logging_steps=10,
    num_train_epochs=1,
    save_steps=100,
    learning_rate=1e-4,
    save_on_each_node=True,
    report_to="none",
)使用 Trainer 训练
trainer = Trainer(
    model=model,
    args=args,
    train_dataset=tokenized_id,
    data_collator=DataCollatorForSeq2Seq(tokenizer=tokenizer, padding=True),
    callbacks=[swanlab_callback] # 传入之前的swanlab_callback
)
trainer.train()加载 lora 权重推理
得到任意 checkpoints 之后加载 lora 权重进行推理:
from transformers import Glm4MoeLiteForCausalLM, AutoTokenizer
import torch
from peft import PeftModel

model_path = '/root/autodl-fs/ZhipuAI/GLM-4.7-Flash'
lora_path = './output/GLM-4.7-Flash/checkpoint-30' # 这里改称你的 lora 输出对应 checkpoint 地址

# 加载tokenizer
tokenizer = AutoTokenizer.from_pretrained(model_path, trust_remote_code=True)

# 加载模型
model = Glm4MoeLiteForCausalLM.from_pretrained(
    pretrained_model_name_or_path=model_path,
    dtype=torch.bfloat16,
    device_map="auto",
    trust_remote_code=True,
).eval()

#model = AutoModelForCausalLM.from_pretrained(model_path, device_map="auto",torch_dtype=torch.bfloat16, trust_remote_code=True).eval()

# 加载lora权重
model = PeftModel.from_pretrained(model, model_id=lora_path)

messages=[
    { 'role': 'system', 'content': "假设你是皇帝身边的女人--甄嬛。"},
    { 'role': 'user', 'content': "你是谁?"}
]

inputs = tokenizer.apply_chat_template(
	messages,
	add_generation_prompt=True,
	tokenize=True,
	return_dict=True,
	return_tensors="pt",
).to(model.device)

outputs = model.generate(**inputs, max_new_tokens=40)

print(tokenizer.decode(outputs[0][len(inputs[0]):], skip_special_tokens=True))甄嬛。臣女家父是太医院院判甄远道。臣女家父与太医院有旧,臣女自幼便在太医院长大