Qwen3 模型结构解析 Blog
Qwen3 模型结构详解
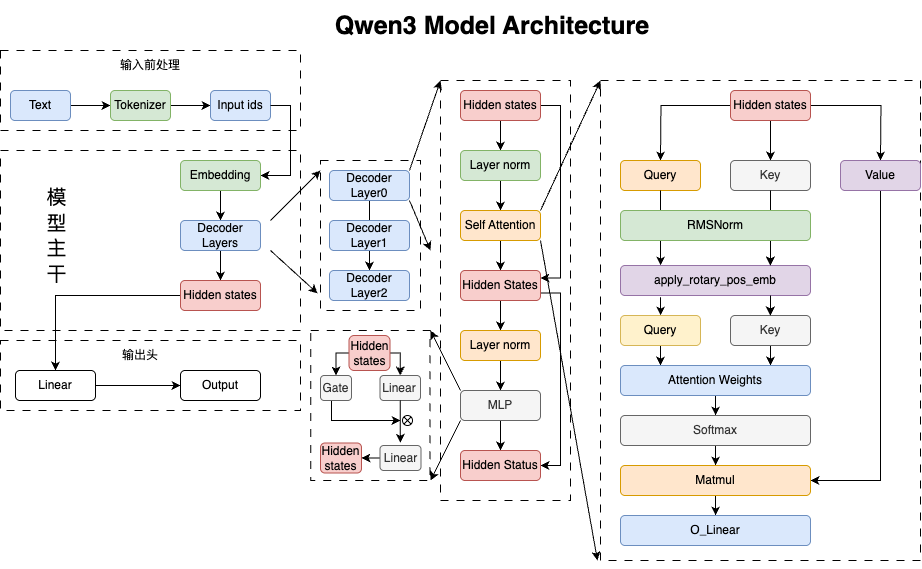
主干网络
与Qwen2 对比分析
Qwen3Attention相较于Qwen2Attention增加了对q和k的标准化, 在计算q、k矩阵后进行RMSNorm。有助于消除不同token之间可能存在的尺度差异,使得注意力机制更加专注于token之间的相对关系而非绝对幅值,从而提升模型的稳定性与泛化能力。相较于LayerNorm而言,该处理既保持了归一化的好处,又降低了计算成本,更适合部署于高效模型中。
# Qwen2Attention
query_states = self.q_proj(hidden_states).view(hidden_shape).transpose(1, 2)
key_states = self.k_proj(hidden_states).view(hidden_shape).transpose(1, 2)

# Qwen3Attention
self.q_norm = Qwen3RMSNorm(self.head_dim, eps=config.rms_norm_eps)
self.k_norm = Qwen3RMSNorm(self.head_dim, eps=config.rms_norm_eps)
# 推理时,在计算完q、k矩阵后进行RMSNorm
query_states = self.q_norm(self.q_proj(hidden_states).view(hidden_shape)).transpose(1, 2)
key_states = self.k_norm(self.k_proj(hidden_states).view(hidden_shape)).transpose(1, 2)Qwen3 MoE 结构详解
MoE机制
MoE(Mixture of Experts)是一种用于提高模型泛化能力的技术。它的基本思想是将模型的计算任务分解成多个独立的专家(Experts),每个专家负责处理特定的任务,然后通过一个门控机制(Gate)来选择哪些专家来处理当前的输入。在LLM中,MoE通常应用于Attention之后的MLP层。
MLP层被分为若干个专家,每个专家是一个Qwen3MoeMLP实例
class Qwen3MoeMLP(nn.Module):
    def __init__(self, config, intermediate_size=None):
        super().__init__()
        self.config = config
        self.hidden_size = config.hidden_size
        self.intermediate_size = intermediate_size if intermediate_size is not None else config.intermediate_size
        self.gate_proj = nn.Linear(self.hidden_size, self.intermediate_size, bias=False)
        self.up_proj = nn.Linear(self.hidden_size, self.intermediate_size, bias=False)
        self.down_proj = nn.Linear(self.intermediate_size, self.hidden_size, bias=False)
        self.act_fn = ACT2FN[config.hidden_act]

    def forward(self, x):
        down_proj = self.down_proj(self.act_fn(self.gate_proj(x)) * self.up_proj(x))
return down_proj在MoeMLP中,每个专家都有一个gate_proj和up_proj,而不是单纯的一个线性层(和非MoE模型的MLP层一样)。
Qwen3MoeSparseMoeBlock就是用于替换原始MLP层的模块,它包含多个Qwen3MoeMLP实例,每个实例对应一个专家。
self.gate = nn.Linear(config.hidden_size, config.num_experts, bias=False)
"""
定义gate,用于选择哪些专家来处理当前的输入。
gate的输出是一个形状为(batch_size, seq_len, num_experts)的张量,
其中每个元素表示对应位置的输入应该分配给哪个专家。
"""
self.experts = nn.ModuleList(
    [Qwen3MoeMLP(config, intermediate_size=config.moe_intermediate_size) for _ in range(self.num_experts)]
)
"""
定义experts,是一个ModuleList,包含多个Qwen3MoeMLP实例。
每个Qwen3MoeMLP实例对应一个专家,负责处理特定的任务。
"""Hidden States经过线性层后输出到Gate,Gate的输出是一个形状为(batch_size, seq_len, num_experts)的张量,其中每个元素表示对应位置的输入应该分配给哪个专家的概率。在每个专家计算完成后,将结果加权求和得到最终的输出。
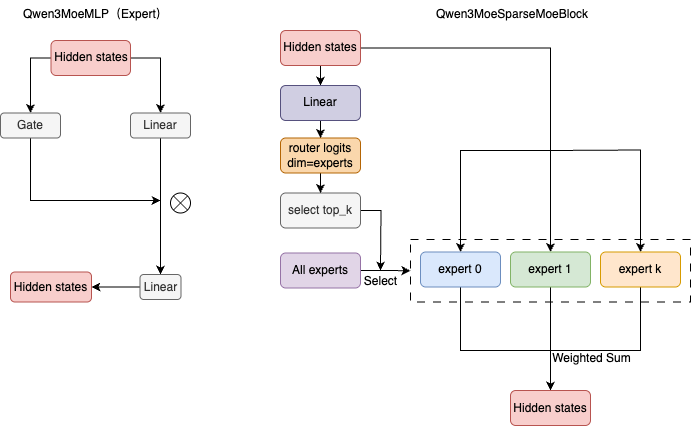
MoE计算过程代码解读:
router_logits = self.gate(hidden_states)  # 计算选中的专家的logits
routing_weights = F.softmax(router_logits, dim=1, dtype=torch.float)  # 归一化权重

# 遍历每个expert。(为什么不是遍历tokens?因为有很多tokens,为每个token都要分配若干的experts,所以几乎每个expert都会被用到。且由于expert数量往往小于token数量,这样可以增大并行性)
for expert_idx in range(self.num_experts):
    expert_layer = self.experts[expert_idx]
    idx, top_x = torch.where(expert_mask[expert_idx])  # 返回当前expert被选中的tokens的索引和排名

    current_state = hidden_states[None, top_x].reshape(-1, hidden_dim)
    current_hidden_states = expert_layer(current_state) * routing_weights[top_x, idx, None]

final_hidden_states.index_add_(0, top_x, current_hidden_states.to(hidden_states.dtype))MoeAttention改进
SparseMoeBlock
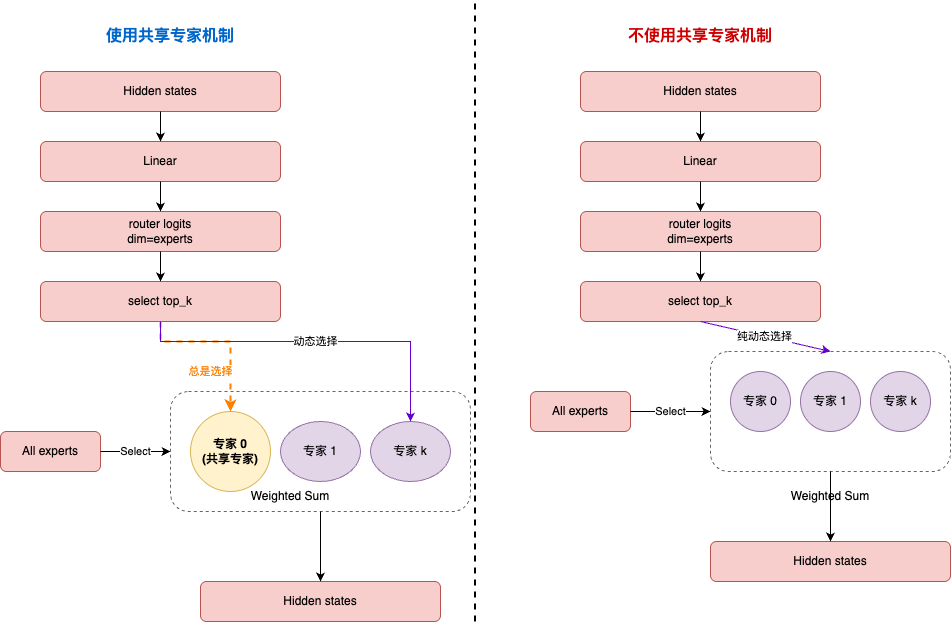
在 Qwen3MoeSparseMoeBlock 中,去除了 Qwen2MoeSparseMoeBlock 中的共享专家机制,简化了模型的结构。在 Qwen2 中,每次都使用一个共享的专家网络来处理输入,增加了计算的复杂性和额外的参数。而在 Qwen3 中,去除了共享专家部分,模型只依赖于通过门控机制选择的专家进行计算,从而减少了不必要的计算步骤和资源消耗。Qwen3 的计算更加高效,避免了不必要的冗余操作,可以提升整体的性能和速度。
代码解释:
# Qwen2MoeSparseMoeBlock中,将选中的专家和共享专家一起使用;Qwen3MoeSparseMoeBlock中,只使用了选中的专家
final_hidden_states = final_hidden_states + shared_expert_output02-Qwen3-8B vLLM 部署调用
vLLM 简介
vLLM 框架是一个高效的大语言模型推理和部署服务系统,具备以下特性:
高效的内存管理:通过 PagedAttention 算法,vLLM 实现了对 KV 缓存的高效管理,减少了内存浪费,优化了模型的运行效率。
高吞吐量:vLLM 支持异步处理和连续批处理请求,显著提高了模型推理的吞吐量,加速了文本生成和处理速度。
易用性:vLLM 与 HuggingFace 模型无缝集成,支持多种流行的大型语言模型,简化了模型部署和推理的过程。兼容 OpenAI 的 API 服务器。
分布式推理:框架支持在多 GPU 环境中进行分布式推理,通过模型并行策略和高效的数据通信,提升了处理大型模型的能力。
开源共享:vLLM 由于其开源的属性,拥有活跃的社区支持,这也便于开发者贡献和改进,共同推动技术发展。
环境准备
本文基础环境如下:
----------------
ubuntu 22.04
python 3.12
cuda 12.4
pytorch 2.5.1
----------------本文默认学习者已配置好以上
Pytorch (cuda)环境,如未配置请先自行安装。
首先 pip 换源加速下载并安装依赖包
python -m pip install --upgrade pip
pip config set global.index-url https://pypi.tuna.tsinghua.edu.cn/simple

pip install modelscope
pip install vllm考虑到部分同学配置环境可能会遇到一些问题,我们在 AutoDL 平台准备了 Qwen3 的环境镜像,点击下方链接并直接创建 Autodl 示例即可。 https://www.codewithgpu.com/i/datawhalechina/self-llm/Qwen3
模型下载
使用 modelscope 中的 snapshot_download 函数下载模型,第一个参数为模型名称,参数 cache_dir 为模型的下载路径。
新建 model_download.py 文件并在其中输入以下内容,粘贴代码后记得保存文件。
from modelscope import snapshot_download

model_dir = snapshot_download('Qwen/Qwen3-8B', cache_dir='/root/autodl-tmp', revision='master')然后在终端中输入 python model_download.py 执行下载,这里需要耐心等待一段时间直到模型下载完成。
注意:记得修改
cache_dir为你的模型下载路径哦~
代码准备
Python 脚本
新建 vllm_model.py 文件并在其中输入以下内容,粘贴代码后请及时保存文件。下面的代码有很详细的注释,如有不理解的地方,欢迎大家提 issue。
首先从 vLLM 库中导入 LLM 和 SamplingParams 类。LLM 类是使用 vLLM 引擎运行离线推理的主要类。SamplingParams 类指定采样过程的参数,用于控制和调整生成文本的随机性和多样性。
vLLM 提供了非常方便的封装,我们直接传入模型名称或模型路径即可,不必手动初始化模型和分词器。
然后,通过使用分词器的 apply_chat_template 函数,将我们的 prompt(提示词)格式化为模型所需的输入格式。
默认情况下,Qwen3 启用了思考能力,类似于 QwQ-32B。这意味着该模型将利用其推理能力来提升生成回答的质量。例如,当在 tokenizer.apply_chat_template 中显式设置 enable_thinking=True 或保留其默认值时,模型将进入思考模式。
我们可以通过这个代码示例熟悉下 vLLM 引擎的使用方式。被注释的部分内容可以丰富模型的能力,但不是必要的,大家可以按需选择,自己多多动手尝试 ~
from vllm import LLM, SamplingParams
from transformers import AutoTokenizer
import os
import json

# 自动下载模型时,指定使用modelscope; 否则,会从HuggingFace下载
os.environ['VLLM_USE_MODELSCOPE']='True'

def get_completion(prompts, model, tokenizer=None, temperature=0.6, top_p=0.95, top_k=20, min_p=0, max_tokens=4096, max_model_len=8192):
    stop_token_ids = [151645, 151643]
    # 创建采样参数。temperature 控制生成文本的多样性,top_p 控制核心采样的概率,top_k 通过限制候选词的数量来控制生成文本的质量和多样性, min_p 通过设置概率阈值来筛选候选词,从而在保证文本质量的同时增加多样性
    sampling_params = SamplingParams(temperature=temperature, top_p=top_p, top_k=top_k, min_p=min_p, max_tokens=max_tokens, stop_token_ids=stop_token_ids)  # max_tokens 用于限制模型在推理过程中生成的最大输出长度
    # 初始化 vLLM 推理引擎
    llm = LLM(model=model, tokenizer=tokenizer, max_model_len=max_model_len,trust_remote_code=True)  # max_model_len 用于限制模型在推理过程中可以处理的最大输入和输出长度之和。
    outputs = llm.generate(prompts, sampling_params)
    return outputs


if __name__ == "__main__":
    # 初始化 vLLM 推理引擎
    model='/root/autodl-tmp/Qwen/Qwen3-8B' # 指定模型路径
    tokenizer = AutoTokenizer.from_pretrained(model, use_fast=False) # 加载分词器

    prompt = "给我一个关于大模型的简短介绍。"
    messages = [
        {"role": "user", "content": prompt}
    ]
    text = tokenizer.apply_chat_template(
        messages,
        tokenize=False,
        add_generation_prompt=True,
        enable_thinking=True  # 是否开启思考模式,默认为 True
    )

    outputs = get_completion(text, model, tokenizer=None, temperature=0.6, top_p = 0.95, top_k=20, min_p=0)  # 对于思考模式,官方建议使用以下参数:temperature = 0.6,TopP = 0.95,TopK = 20,MinP = 0。

    # 输出是一个包含 prompt、生成文本和其他信息的 RequestOutput 对象列表。
    # 打印输出。
    for output in outputs:
        prompt = output.prompt
        generated_text = output.outputs[0].text
print(f"Prompt: {prompt!r}, \nResponse: {generated_text!r}")运行代码
python vllm_model.py结果如下:
Prompt: '<|im_start|>user\n给我一个关于大模型的简短介绍。<|im_end|>\n<|im_start|>assistant\n',
Response: '<think>\n好的,用户让我给他一个关于大模型的简短介绍。首先,我需要确定“大模型”指的是什么。通常来说,大模型指的是大规模预训练模型,比如像GPT、BERT这样的深度学习模型。用户可能对AI领域不太熟悉,所以需要解释清楚基本概念。\n\n接下来,我要考虑用户的需求。他们可能是在寻找一个简短的概述,不需要太技术性的术语,但又要涵盖关键点。可能需要包括定义、特点、应用领域以及优势。不过用户要求的是简短,所以不能太冗长。\n\n然后,我需要检查是否有遗漏的重要信息。比如,大模型的规模通常以参数量衡量,比如百亿或千亿参数。此外,它们通常使用Transformer架构,这可能需要提到。另外,应用场景如自然语言处理、图像识别、语音处理等也是重点。\n\n还要注意用户可能的背景。如果是普通用户,可能需要更通俗的解释,避免使用太多专业术语。但如果是技术人员,可能需要更详细的技术细节。不过用户没有说明,所以保持中立,简明扼要。\n\n另外,用户可能想知道大模型的优势,比如强大的泛化能力、多任务处理能力,以及在不同领域的应用实例。同时,可能存在的挑战,比如计算资源需求高、训练成本大,这些是否需要提及?但用户要的是简短介绍,可能不需要深入讨论缺点。\n\n最后,确保语言简洁,结构清晰,分点或分段说明。可能需要用一两句话概括定义,接着说明特点,然后应用领域,最后总结优势。这样用户能快速抓住重点。\n</think>\n\n大模型(Large Language Models, LLMs)是基于深度学习的先进人工智能技术,通过海量文本数据训练,具备强大的语言理解和生成能力。它们通常拥有数十亿至数千亿参数,能够完成文本生成、问答、翻译、编程等复杂任务,广泛应用于智能助手、内容创作、数据分析等领域,显著提升了人机交互的效率与智能化水平。'模型的 response 由两部分组成,一部分是思考过程,用\和\包裹住,另一部分是最终答案,在\标识符之后。
如果不需要开启思考模式,只需要将参数 ensure_thinking 设置为 False。例如:
from vllm import LLM, SamplingParams
from transformers import AutoTokenizer
import os
import json

# 自动下载模型时,指定使用modelscope; 否则,会从HuggingFace下载
os.environ['VLLM_USE_MODELSCOPE']='True'

def get_completion(prompts, model, tokenizer=None, temperature=0.6, top_p=0.95, top_k=20, min_p=0, max_tokens=4096, max_model_len=8192):
    stop_token_ids = [151645, 151643]
    # 创建采样参数。
    sampling_params = SamplingParams(temperature=temperature, top_p=top_p, top_k=top_k, min_p=min_p, max_tokens=max_tokens, stop_token_ids=stop_token_ids)
    # 初始化 vLLM 推理引擎
    llm = LLM(model=model, tokenizer=tokenizer, max_model_len=max_model_len,trust_remote_code=True)
    outputs = llm.generate(prompts, sampling_params)
    return outputs


if __name__ == "__main__":
    # 初始化 vLLM 推理引擎
    model='/root/autodl-tmp/Qwen/Qwen3-8B' # 指定模型路径
    tokenizer = AutoTokenizer.from_pretrained(model, use_fast=False) # 加载分词器

    prompt = "你是谁?"
    messages = [
        {"role": "user", "content": prompt}
    ]
    text = tokenizer.apply_chat_template(
        messages,
        tokenize=False,
        add_generation_prompt=True,
        enable_thinking=False  # 是否开启思考模式,默认为 True
    )

    outputs = get_completion(text, model, tokenizer=None, temperature=0.7, top_p = 0.8, top_k=20, min_p=0)  # 对于非思考模式,官方建议使用以下参数:temperature = 0.7,TopP = 0.8,TopK = 20,MinP = 0。

    # 输出是一个包含 prompt、生成文本和其他信息的 RequestOutput 对象列表。
    # 打印输出。
    for output in outputs:
        prompt = output.prompt
        generated_text = output.outputs[0].text
print(f"Prompt: {prompt!r},Response: {generated_text!r}")结果如下:
Prompt: '<|im_start|>user\n你是谁?<|im_end|>\n<|im_start|>assistant\n<think>\n\n</think>\n\n',
Response: '我是通义千问,由通义实验室研发的超大规模语言模型。我能够回答各种问题、创作文字,比如写故事、写邮件、写剧本,还能进行逻辑推理、多语言理解、代码编写等。我旨在成为你最得力的助手,帮助你解决各种问题。有什么我可以帮你的吗?'创建兼容 OpenAI API 接口的服务器
Qwen3-8B 兼容 OpenAI API 协议,所以我们可以直接使用 vLLM 创建 OpenAI API 服务器。vLLM 部署实现 OpenAI API 协议的服务器非常方便。默认会在 http://localhost:8000 启动服务器。服务器当前一次托管一个模型,并实现列表模型、completions 和 chat completions 端口。
completions:是基本的文本生成任务,模型会在给定的提示后生成一段文本。这种类型的任务通常用于生成文章、故事、邮件等。
chat completions:是面向对话的任务,模型需要理解和生成对话。这种类型的任务通常用于构建聊天机器人或者对话系统。
在创建服务器时,我们可以指定模型名称、模型路径、聊天模板等参数。
--host 和 --port 参数指定地址。
--model 参数指定模型名称。
--chat-template 参数指定聊天模板。
--served-model-name 指定服务模型的名称。
--max-model-len 指定模型的最大长度。
--enable-reasoning 开启思考模式
--reasoning-parser 指定如何解析模型生成的推理内容。设置 --enable-reasoning 参数时,--reasoning-parser 是必需的。推理模型会在输出中包含一个额外的 reasoning_content 字段,该字段包含导致最终结论的推理步骤。通过指定合适的解析器,可以正确提取和格式化这些推理内容。例如 deepseek_r1 解析器适用于 DeepSeek R1 系列模型,能够解析 ... 格式的内容
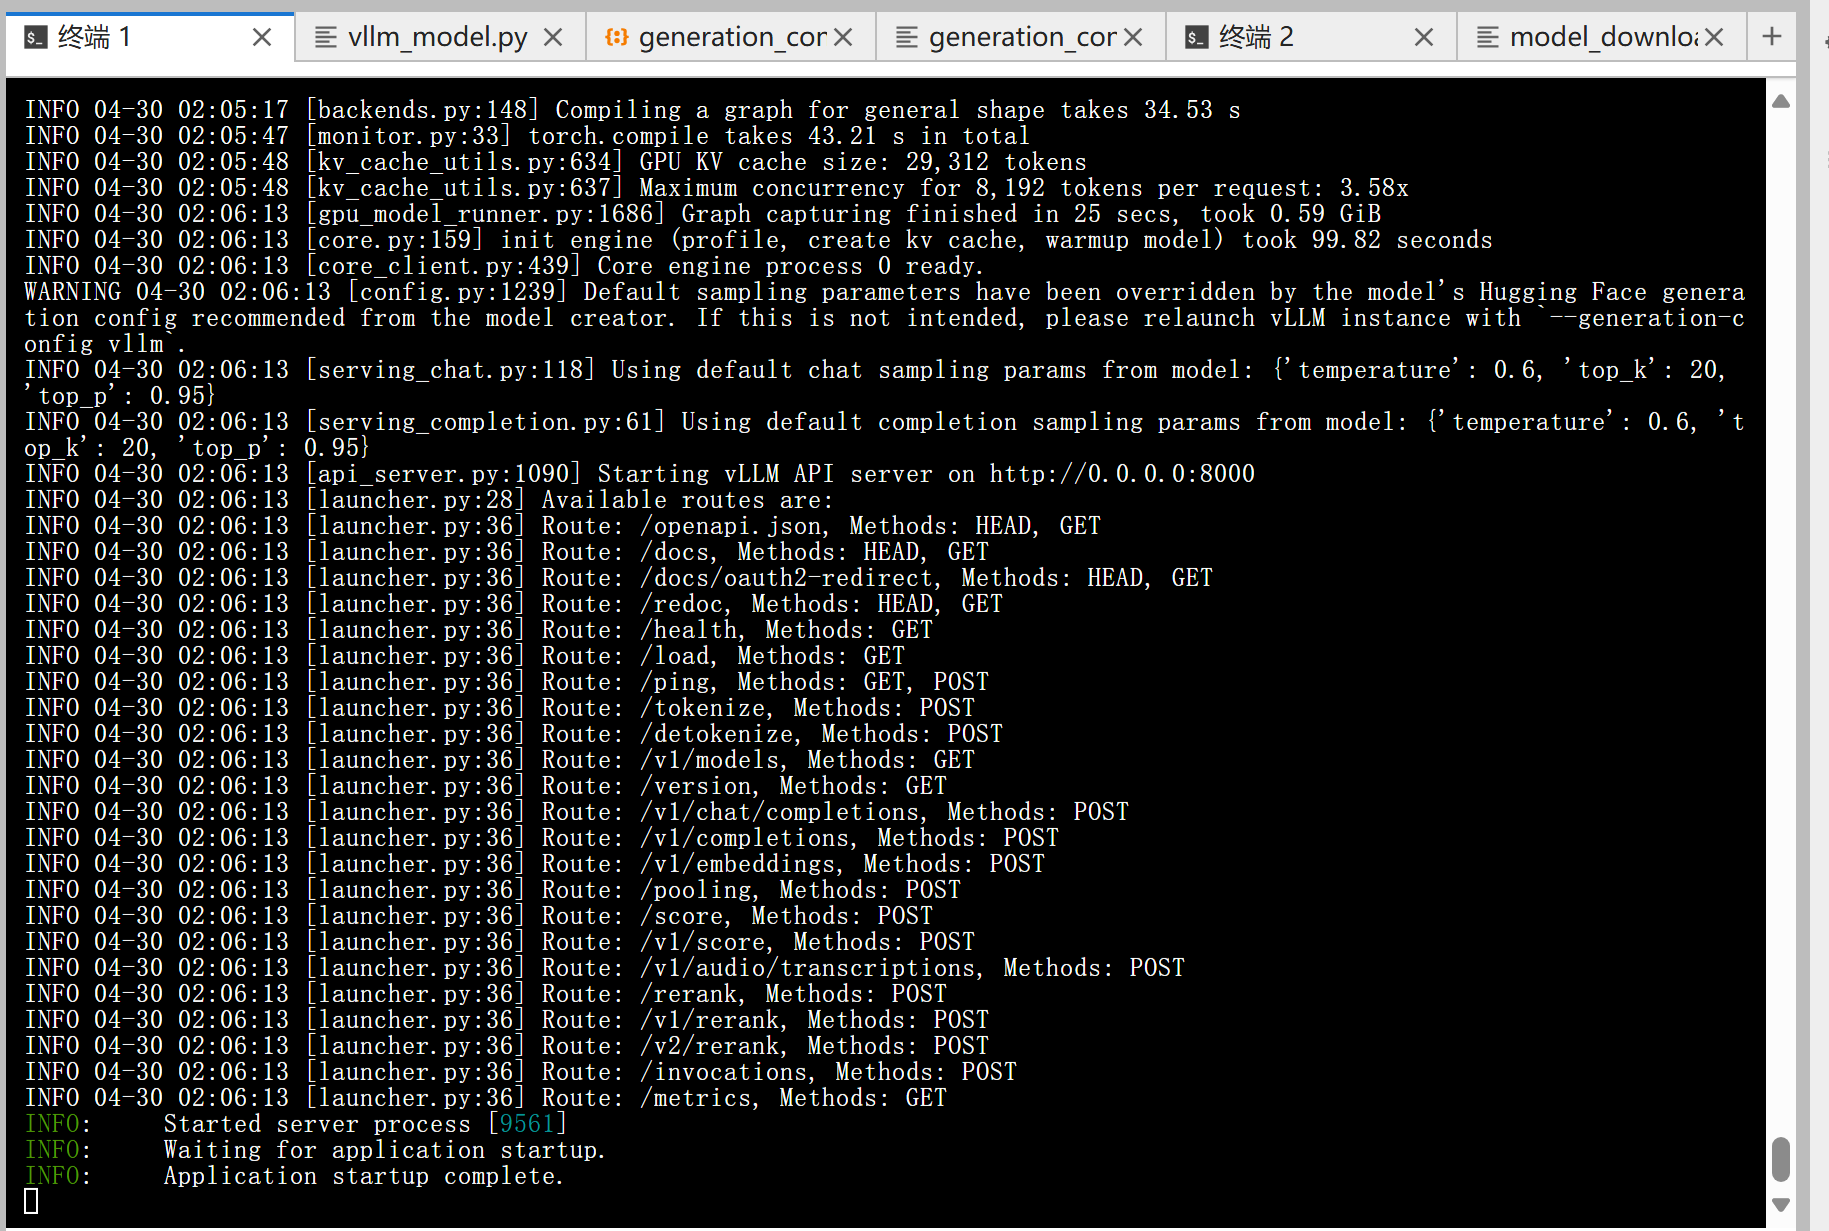
我们复制以下命令到终端上,就可以成功启动 Qwen3-8 B 模型的 API 接口
VLLM_USE_MODELSCOPE=true vllm serve /root/autodl-tmp/Qwen/Qwen3-8B --served-model-name Qwen3-8B --max_model_len 8192 --enable-reasoning --reasoning-parser deepseek_r1加载完毕后出现如下信息说明服务成功启动
通过 curl 命令查看当前的模型列表
curl http://localhost:8000/v1/models 得到的返回值如下所示
{
  "object": "list",
  "data": [
    {
      "id": "Qwen3-8B",
      "object": "model",
      "created": 1745950421,
      "owned_by": "vllm",
      "root": "/root/autodl-tmp/Qwen/Qwen3-8B",
      "parent": null,
      "max_model_len": 8192,
      "permission": [
        {
          "id": "modelperm-3f20f566536d445cbfbf5a9ddb115204",
          "object": "model_permission",
          "created": 1745950421,
          "allow_create_engine": false,
          "allow_sampling": true,
          "allow_logprobs": true,
          "allow_search_indices": false,
          "allow_view": true,
          "allow_fine_tuning": false,
          "organization": "*",
          "group": null,
          "is_blocking": false
        }
      ]
    }
  ]
}使用 curl 命令测试 OpenAI Completions API
curl http://localhost:8000/v1/completions \
    -H "Content-Type: application/json" \
    -d '{
        "model": "Qwen3-8B",
        "prompt": "我想问你,5的阶乘是多少?<think>\n",
        "max_tokens": 1024,
        "temperature": 0
}' 得到的返回值如下所示
{
  "id": "cmpl-fb7fa8e981164942b1e126afe43b2acf",
  "object": "text_completion",
  "created": 1745950506,
  "model": "Qwen3-8B",
  "choices": [
    {
      "index": 0,
      "text": "嗯,好的,我现在要算5的阶乘是多少。首先,我得回忆一下阶乘的定义。阶乘就是从1乘到那个数本身,对吧?比如n的阶乘就是n×(n-1)×(n-2)×…×1。那这样的话,5的阶乘应该是5×4×3×2×1。不过,我是不是应该再仔细确认一下这个定义有没有错误?\n\n让我再想想,比如3的阶乘是3×2×1=6,对吧?那4的阶乘就是4×3×2×1=24,对吗?那5的阶乘应该就是5×4×3×2×1。那这样的话,先算5×4=20,然后20×3=60,接着60×2=120,最后120×1=120。所以结果应该是120?\n\n不过,有没有可能我哪里算错了?比如,是不是有时候阶乘的定义是从0开始?比如0的阶乘是1?不过题目是问5的阶乘,所以应该没问题。那再检查一下每一步的乘法是否正确。\n\n首先,5×4=20,没错。然后20×3=60,对的。接下来60×2=120,没错。最后乘以1的话,结果还是120。所以应该是对的。\n\n或者有没有可能我漏掉了某个步骤?比如,是不是应该包括更多的数?比如,5的阶乘是不是应该包括5×4×3×2×1,而没有其他数?是的,没错。所以结果应该是120。\n\n不过,为了确保万无一失,我可以换一种方式计算。比如,先算4的阶乘是24,然后5的阶乘就是5×24=120。这样是不是更快捷?是的,这样算的话,结果也是一样的。所以两种方法都得到120,应该没错。\n\n或者,我可以使用计算器来验证一下,不过现在假设没有计算器的话,手动计算应该没问题。再试一次:5×4=20,20×3=60,60×2=120,120×1=120。没错,结果一致。\n\n所以,我觉得5的阶乘应该是120。不过,有没有可能我记错了阶乘的定义?比如,是不是有时候阶乘是从0开始的?比如,0! =1,1! =1,2! =2,3! =6,4! =24,5! =120。是的,这样看来是对的。所以答案应该是120。\n\n或者,有没有可能题目中的阶乘有其他定义?比如,某些特殊情况下有不同的定义?不过一般来说,阶乘的标准定义就是n! =n×(n-1)×…×1,所以应该没问题。\n\n总之,经过多次验证,我觉得5的阶乘是120。\n</think>\n\n5的阶乘(记作5!)是通过将从1到5的所有正整数相乘得到的。具体计算过程如下:\n\n$$\n5! = 5 \\times 4 \\times 3 \\times 2 \\times 1\n$$\n\n分步计算:\n1. $5 \\times 4 = 20$\n2. $20 \\times 3 = 60$\n3. $60 \\times 2 = 120$\n4. $120 \\times 1 = 120$\n\n因此,**5的阶乘是120**。\n\n**答案:120**",
      "logprobs": null,
      "finish_reason": "stop",
      "stop_reason": null,
      "prompt_logprobs": null
    }
  ],
  "usage": {
    "prompt_tokens": 12,
    "total_tokens": 797,
    "completion_tokens": 785,
    "prompt_tokens_details": null
  }
}用 Python 脚本请求 OpenAI Completions API
# vllm_openai_completions.py
from openai import OpenAI
client = OpenAI(
    base_url="http://localhost:8000/v1",
    api_key="sk-xxx", # 随便填写,只是为了通过接口参数校验
)

completion = client.chat.completions.create(
  model="Qwen3-8B",
  messages=[
    {"role": "user", "content": "我想问你,5的阶乘是多少?<think>\n"}
  ]
)

print(completion.choices[0].message)python vllm_openai_completions.py 得到的返回值如下所示
ChatCompletionMessage(content='\n\n5的阶乘(记作5!)是将1到5的所有正整数相乘的结果。计算过程如下:\n\n$$\n5! = 5 \\times 4 \\times 3 \\times 2 \\times 1 = 120\n$$\n\n**答案:** 5的阶乘是 **120**。', refusal=None, role='assistant', annotations=None, audio=None, function_call=None, tool_calls=[], reasoning_content='\n嗯,用户问的是5的阶乘是多少。首先,我得确认阶乘的定义。阶乘就是从1乘到那个数,对吧?比如n的阶乘是n×(n-1)×...×1。那5的阶乘就是5×4×3×2×1。\n\n不过,我得仔细检查一下,别搞错了。有时候可能会有计算错误,比如把某个数漏掉或者乘错。比如,5×4是20,然后20×3是60,接着60×2是120,最后120×1还是120。所以结果应该是120。\n\n但用户可能是个刚开始学数学的学生,或者对阶乘不太熟悉,所以需要确认是否理解正确。或者他们可能在做作业,需要快速得到答案。也有可能他们想确认自己计算的正确性,所以给出详细的步骤会更好。\n\n另外,有没有可能用户问的是其他类型的阶乘?比如递归定义或者其他变种?不过一般来说,阶乘都是指标准的n!,所以应该没问题。再想想,有没有可能用户输入有误?比如是不是5的阶乘还是别的数?不过问题明确说是5,所以应该没问题。\n\n再检查一遍计算过程:5×4=20,20×3=60,60×2=120,120×1=120。没错,结果确实是120。所以答案应该是120。不过为了确保万无一失,可以再用另一种方式计算,比如分步计算或者用计算器验证。但作为思考过程,这里已经足够详细了。\n')用 curl 命令测试 OpenAI Chat Completions API
curl http://localhost:8000/v1/chat/completions \
    -H "Content-Type: application/json" \
    -d '{
        "model": "Qwen3-8B",
        "messages": [
            {"role": "user", "content": "我想问你,5的阶乘是多少?<think>\n"}
        ]
}'得到的返回值如下所示
{
  "id": "chatcmpl-ebe5eb4e638449dc83d628175e540365",
  "object": "chat.completion",
  "created": 1745950682,
  "model": "Qwen3-8B",
  "choices": [
    {
      "index": 0,
      "message": {
        "role": "assistant",
        "reasoning_content": "\n嗯,用户问的是5的阶乘是多少。首先,我得确认阶乘的定义。阶乘就是从1乘到那个数,对吧?比如n的阶乘是n×(n-1)×...×1。所以5的阶乘应该是5×4×3×2×1。让我算一下,5乘4是20,然后20乘3是60,接着60乘2是120,最后120乘1还是120。所以答案应该是120。不过,我得再检查一遍,确保没有算错。或者有没有可能用户问的是别的什么?比如有时候可能会有其他数学概念混淆,但阶乘通常就是这个意思。再想想,有没有可能用户输入的时候有错别字?比如“阶乘”是不是别的词?不过看起来没问题。再确认一下计算步骤,5×4=20,没错;20×3=60,对的;60×2=120,没错;120×1=120。没错,应该是对的。或者有没有可能用户需要更详细的解释?比如阶乘的定义或者应用场景?不过问题直接问的是数值,所以直接回答结果应该就可以了。不过有时候用户可能不太清楚阶乘的概念,可能需要简单说明一下。不过根据问题,用户可能已经知道阶乘是什么,只是需要数值。所以直接给出答案120应该没问题。再想想有没有其他可能的错误,比如计算顺序或者乘法错误?比如有没有可能把5×4×3×2×1算成别的?比如5×4=20,20×3=60,60×2=120,120×1=120,没错。或者有没有可能用户问的是5的幂次?比如5的5次方是3125,但那是不同的概念。不过用户明确说是阶乘,所以应该没问题。总之,答案应该是120。\n",
        "content": "\n\n5的阶乘(记作5!)是5×4×3×2×1,计算结果为:\n\n**5! = 5 × 4 × 3 × 2 × 1 = 120**\n\n所以,5的阶乘是 **120**。",
        "tool_calls": []
      },
      "logprobs": null,
      "finish_reason": "stop",
      "stop_reason": null
    }
  ],
  "usage": {
    "prompt_tokens": 20,
    "total_tokens": 511,
    "completion_tokens": 491,
    "prompt_tokens_details": null
  },
  "prompt_logprobs": null
}用 Python 脚本请求 OpenAI Chat Completions API
# vllm_openai_chat_completions.py
from openai import OpenAI
openai_api_key = "sk-xxx" # 随便填写,只是为了通过接口参数校验
openai_api_base = "http://localhost:8000/v1"

client = OpenAI(
    api_key=openai_api_key,
    base_url=openai_api_base,
)

chat_outputs = client.chat.completions.create(
    model="Qwen3-8B",
    messages=[
        {"role": "user", "content": "什么是深度学习?"},
    ]
)
print(chat_outputs)python vllm_openai_chat_completions.py得到的返回值如下所示
ChatCompletion(id='chatcmpl-301a933793e44f1abc01483a52a076a4', choices=[Choice(finish_reason='stop', index=0, logprobs=None, message=ChatCompletionMessage(content='\n\n深度学习(Deep Learning)是**机器学习**的一个子领域,专注于通过模拟人脑神经网络的结构和功能来实现对复杂模式的识别和学习。它的核心思想是使用**多层神经网络**(即“深度”)来自动从数据中提取特征并进行决策,从而解决传统机器学习难以处理的问题。\n\n---\n\n### **核心概念**\n1. **神经网络(Neural Network)** \n 深度学习的基础是**人工神经网络**(Artificial Neural Network, ANN),它由大量相互连接的节点(神经元)组成,分为输入层、隐藏层和输出层。每一层通过非线性变换将数据从低级特征逐步抽象到高级特征。\n\n2. **深度(Depth)** \n “深度”指的是网络中**隐藏层的数量**。传统神经网络可能只有1-2层,而深度学习通常使用**多层(如10层以上)**的网络,从而能捕捉更复杂的模式。\n\n3. **自动特征提取** \n 与传统机器学习(如SVM、决策树)需要人工设计特征不同,深度学习通过多层网络**自动学习特征**。例如,识别图像中的猫时,网络会自动从像素中学习边缘、纹理、形状等特征,最终识别出猫。\n\n---\n\n### **关键特点**\n- **非线性建模**:通过激活函数(如ReLU、Sigmoid)实现复杂非线性关系的建模。\n- **端到端学习**:从原始数据直接到最终输出,无需人工干预中间步骤。\n- **大规模数据依赖**:需要大量数据训练,但通过数据增强和迁移学习可缓解这一问题。\n- **可解释性差**:模型内部的决策过程难以直观理解(“黑箱”问题)。\n\n---\n\n### **典型应用场景**\n1. **计算机视觉** \n - 图像分类(如ResNet、VGG)\n - 目标检测(如YOLO、Faster R-CNN)\n - 图像生成(如GAN、StyleGAN)\n\n2. **自然语言处理(NLP)** \n - 机器翻译(如Transformer、BERT)\n - 文本生成(如GPT、T5)\n - 情感分析\n\n3. **语音识别与合成** \n - 语音转文字(如DeepSpeech)\n - 语音合成(如Tacotron)\n\n4. **推荐系统** \n - 基于用户行为数据的个性化推荐(如Netflix、Amazon)\n\n5. **强化学习** \n - 游戏AI(如AlphaGo、AlphaStar)\n - 自动驾驶(如Waymo)\n\n---\n\n### **优势与挑战**\n- **优势** \n - 能处理高维、非结构化数据(如图像、文本、语音)。 \n - 在复杂任务中表现优于传统方法(如人脸识别、医学影像分析)。 \n - 通过迁移学习可减少对数据量的依赖。\n\n- **挑战** \n - 需要大量计算资源(GPU/TPU)和数据。 \n - 模型训练时间长,调试复杂。 \n - 可解释性差,可能带来伦理和安全风险(如算法偏见)。\n\n---\n\n### **与传统机器学习的区别**\n| 特性 | 传统机器学习 | 深度学习 |\n|---------------------|---------------------------|---------------------------|\n| 特征工程 | 需要人工设计特征 | 自动学习特征 |\n| 模型复杂度 | 简单(如SVM、决策树) | 复杂(多层神经网络) |\n| 数据需求 | 小规模数据即可 | 需要大量数据 |\n| 可解释性 | 较高 | 较低(黑箱模型) |\n| 适用场景 | 结构化数据(如表格) | 非结构化数据(如图像、文本) |\n\n---\n\n### **总结**\n深度学习通过模拟人脑的神经网络结构,实现了对复杂数据的高效建模和决策。它在图像识别、自然语言处理等领域取得了突破性进展,但也面临计算成本高、可解释性差等挑战。随着技术的发展,深度学习正逐步渗透到更多领域,成为人工智能的核心技术之一。', refusal=None, role='assistant', annotations=None, audio=None, function_call=None, tool_calls=[], reasoning_content='\n嗯,用户问的是“什么是深度学习?”。首先,我需要确定用户对深度学习的了解程度。可能他们刚开始接触这个概念,或者只是听说过但不太清楚具体含义。我应该从基础讲起,但也要保持简洁,避免过于技术化。\n\n首先,深度学习属于机器学习的一个子领域,这点很重要。要解释清楚机器学习和深度学习的关系,可能用户知道机器学习,但不知道深度学习的具体区别。需要提到神经网络,尤其是多层结构,这是深度学习的核心。\n\n然后,可能需要解释为什么叫“深度”,也就是多层网络,这和传统机器学习方法的不同之处。比如,传统方法可能需要手动设计特征,而深度学习自动学习特征,这点可能用户感兴趣,因为自动化的特征提取是深度学习的优势之一。\n\n接下来,应用场景是关键。用户可能想知道深度学习能用来做什么,比如图像识别、自然语言处理、语音识别等。举一些常见的例子,比如人脸识别、推荐系统,这样更具体,容易理解。\n\n还要提到深度学习的优缺点。优点比如处理复杂模式的能力,但缺点可能包括需要大量数据和计算资源,以及模型的可解释性差。用户可能关心实际应用中的挑战,比如数据需求和计算成本。\n\n另外,可能需要区分深度学习和其他机器学习方法,比如支持向量机、决策树等,说明深度学习在处理高维数据和非线性问题上的优势。但也要指出适用场景,不是所有问题都适合用深度学习。\n\n用户可能没有说出来的需求是,他们可能想了解深度学习的现状、发展趋势,或者如何入门。虽然问题只是定义,但可以简要提到这些方面,比如深度学习的广泛应用和当前研究热点,如生成对抗网络、Transformer模型等。\n\n还要注意避免使用太多术语,或者如果使用术语要解释清楚。比如“神经网络”、“激活函数”、“损失函数”等,可能需要简单带过,或者用更通俗的语言描述。\n\n最后,确保回答结构清晰,分点说明,让用户容易理解。可能需要先定义,再讲结构、特点、应用、优缺点,最后总结。这样逻辑清晰,用户能一步步理解。\n'), stop_reason=None)], created=1745950745, model='Qwen3-8B', object='chat.completion', service_tier=None, system_fingerprint=None, usage=CompletionUsage(completion_tokens=1390, prompt_tokens=12, total_tokens=1402, completion_tokens_details=None, prompt_tokens_details=None), prompt_logprobs=None)另外,在以上所有的在请求处理过程中, API 后端都会打印相对应的日志和统计信息:
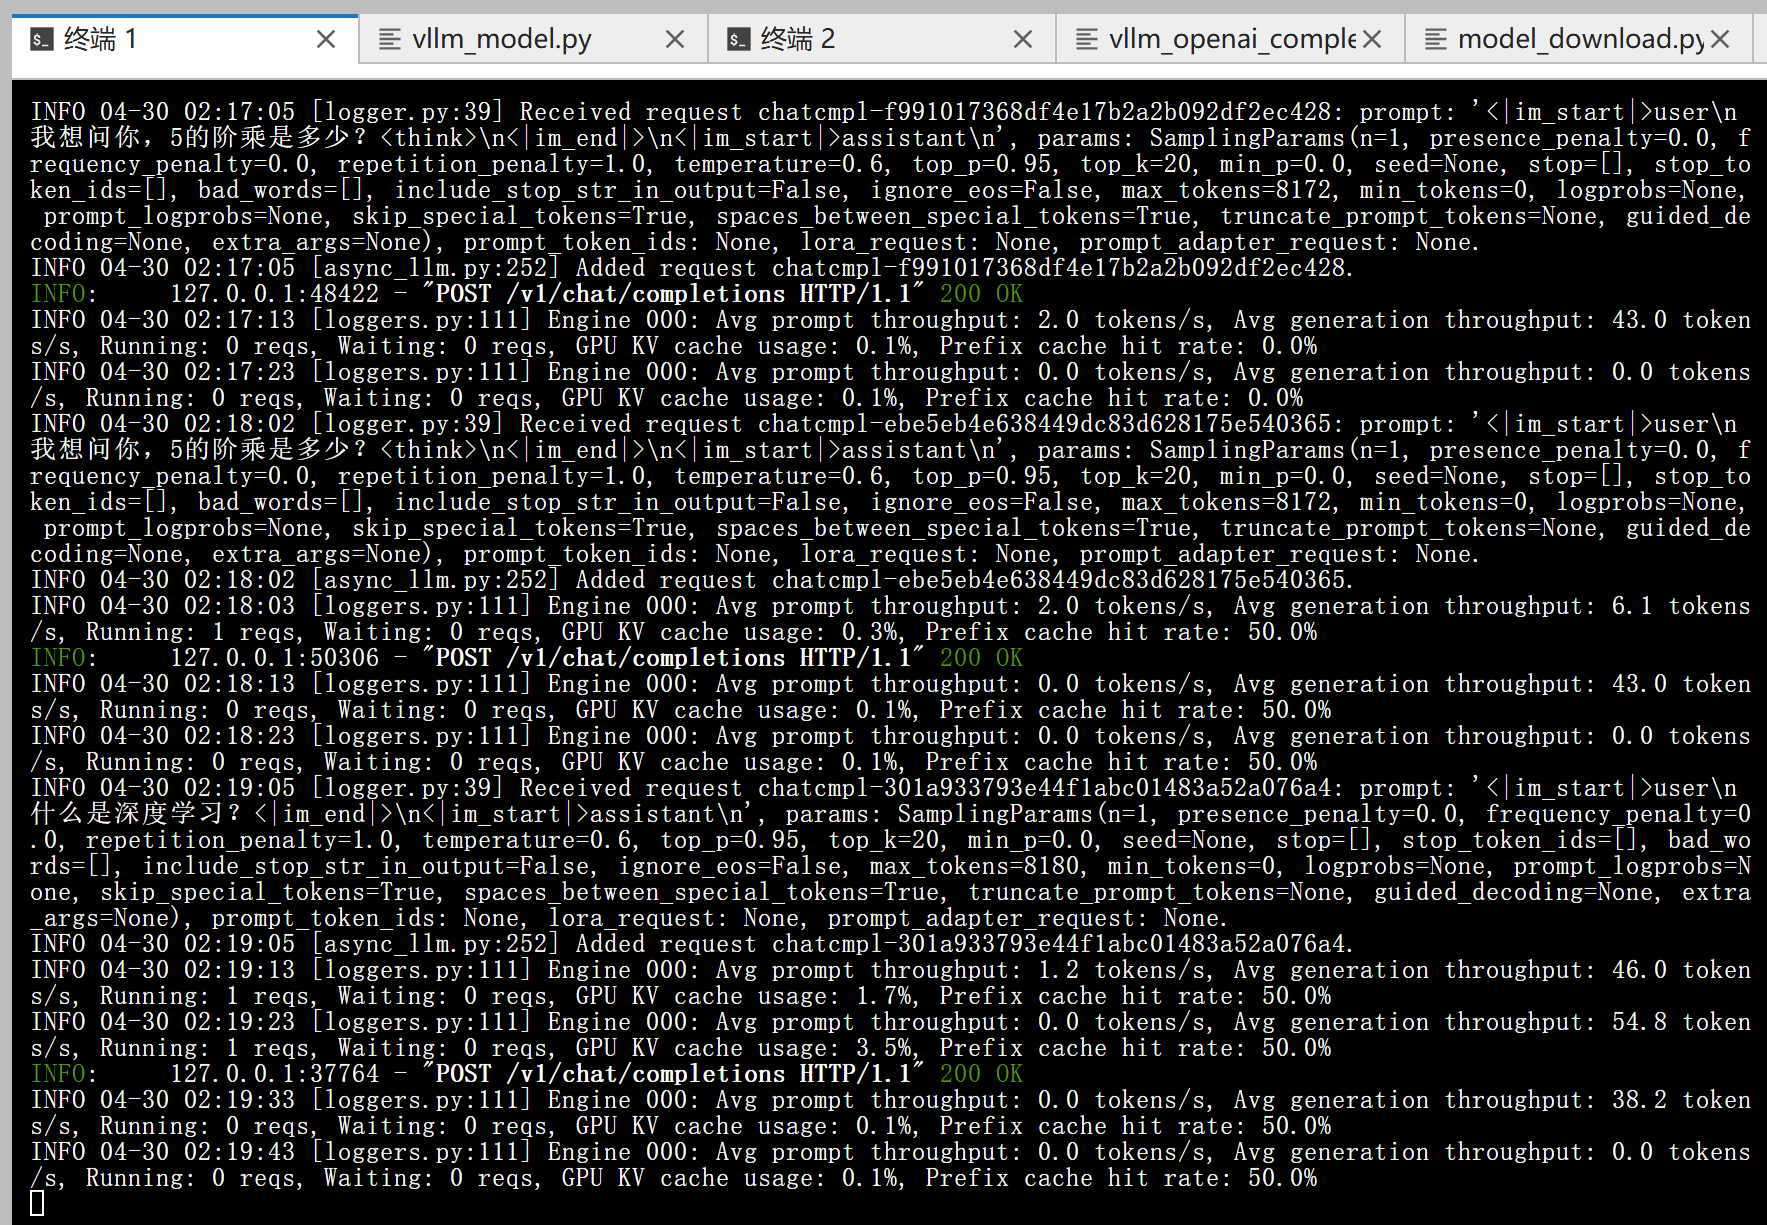
Qwen3-7B-Instruct Windows LMStudio 部署
1.引言
在本地运行大型语言模型(LLMs)已成为许多开发者和爱好者的热门选择,它提供了隐私性、定制化和离线使用的可能性。虽然像 Ollama 这样的工具提供了强大的命令行界面来管理和运行本地模型,但 LM Studio 则为寻求更图形化、更直观交互体验的用户提供了一个极具吸引力的替代方案。
相比于 Ollama,LM Studio 拥有更加丰富的用户界面,同样强大的模型生态系统支持,以及更易于上手的交互体验。其突出的优势之一在于它非常适合在无网络环境下部署和使用大模型,使其成为一个出色的本地 LLM 应用产品。
本教程将带您一步步了解如何开始使用 LM Studio。我们将涵盖:
下载与安装:快速获取并安装 LM Studio 应用程序。
模型下载(在线):学习如何在 LM Studio 界面内搜索、选择(根据硬件推荐)并下载模型,以 Qwen3-8B 为例。
模型安装(离线):针对网络不佳或希望手动管理模型文件的用户,展示如何从魔搭社区等来源下载模型文件,并将其正确放置到 LM Studio 的模型库中。
模型测试:通过 LM Studio 内建的聊天界面与下载好的 Qwen3-8B 模型进行交互。
本地 API 调用:设置 LM Studio 的本地服务器,并使用 Python 和 OpenAI 库通过 API 调用已加载的 Qwen3-8B 模型,实现程序化交互。
无论您是想探索本地 LLM 的新手,还是在寻找一个界面友好、支持离线运行的工具,本指南都将帮助您轻松上手 LM Studio,并成功部署和调用 Qwen3-8B 这样强大的模型。让我们开始吧!
- LM Studio启动
相比于ollama,LM Studio拥有更加丰富的界面,一样强大的模型生态,更易用的交互体验。在无网路环境是一个很好的本地部署大模型应用产品。
2.1 下载LM Studio
进入LM Studio官网https://lmstudio.ai/,点击download即可。
安装只需按照步骤点击下一步即可~
2.2 下载模型
这里我们以Qwen3-8B为例,安装并使用。
打开左下角这个放大镜,查找模型。
输入deepseek,找到Qwen3-8B版本,选择绿色小火箭模型即可。(简单介绍一下,LM Studio会根据你电脑配置推荐模型,如果是绿色火箭用起来体验会非常丝滑,没有火箭体验就比较缓慢,如果是红色说明完全没法运行)
选择好后点击右下角下载即可
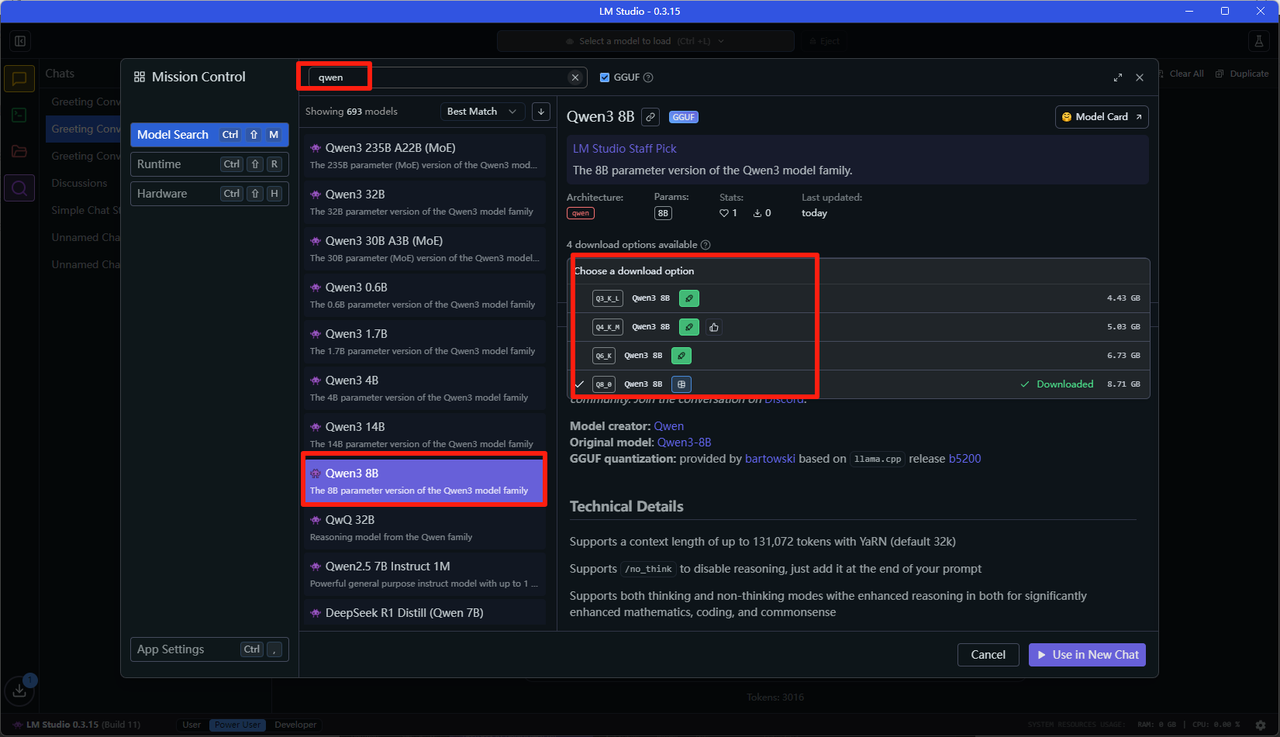
2.3 离线安装
有些小伙伴网络不佳,下载速度较慢。我们可以考虑使用魔搭社区的对应版本。
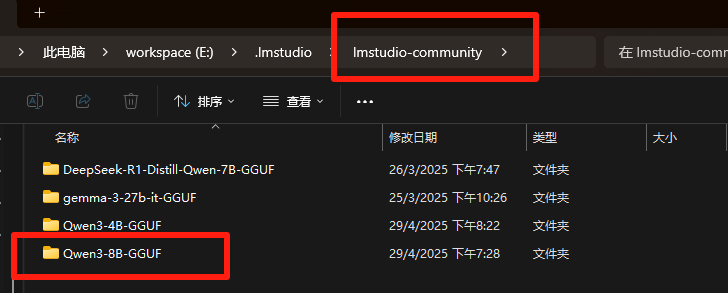
按下图找到LM Studio的模型存储地址
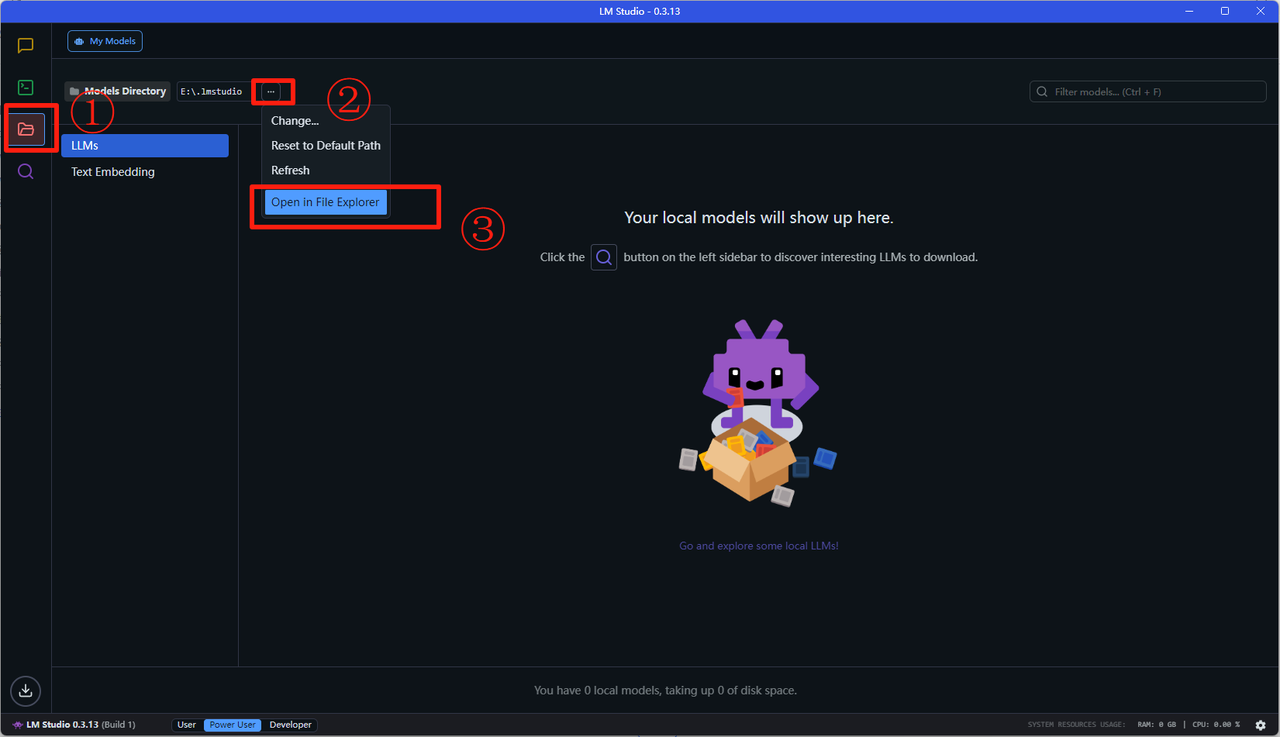
在\lmstudio-community目录下创建Qwen3-8B-GGUF文件夹
进入魔搭社区下载对应的模型文件,下面是跳转链接:
https://www.modelscope.cn/models/unsloth/Qwen3-8B-GGUF/files
因为我电脑是4070ti可以运行所有模型,我选择Q8量化的对应文件:Qwen3-8B-Q8_0.gguf,大家如果是8G显存推荐使用Q4(Qwen3-8B-Q4_K_M.gguf)或Q3(Qwen3-8B-Q3_K_M.gguf)对应的模型。
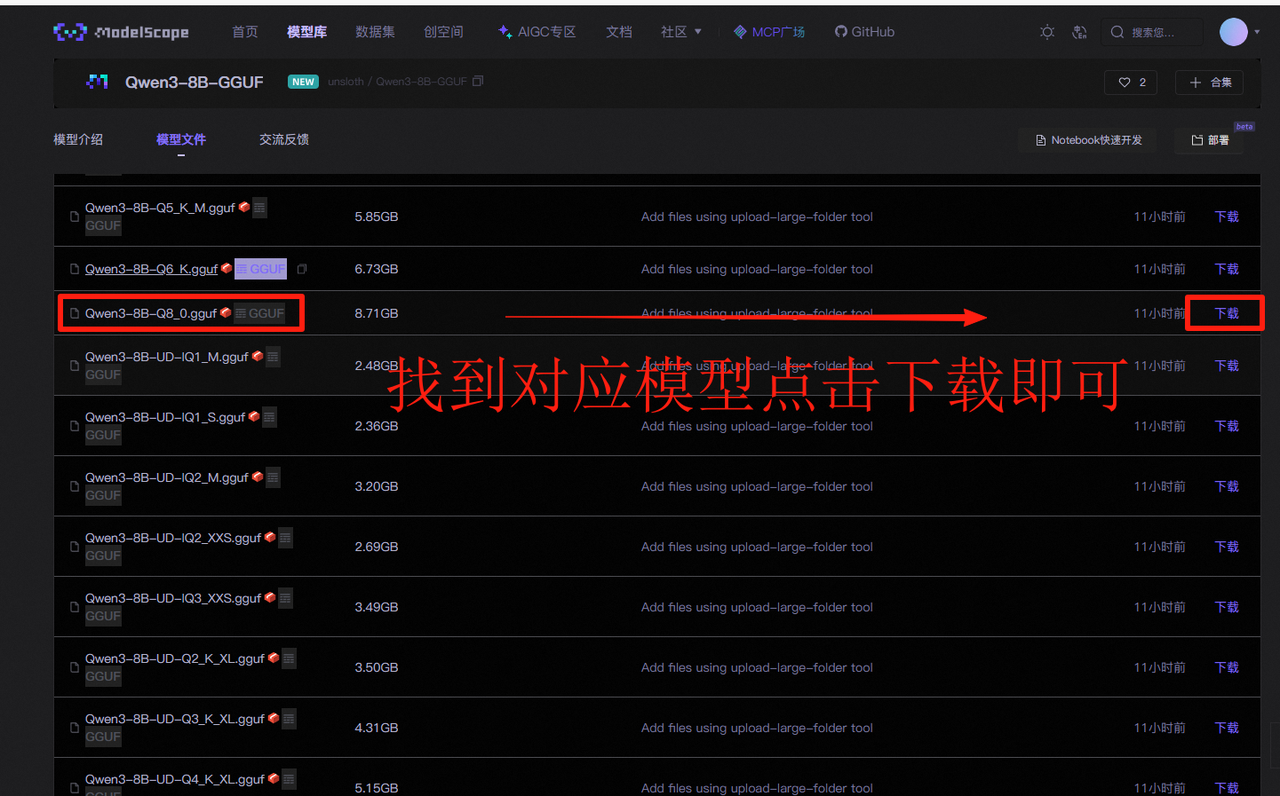
下载文件并存入Qwen3-8B-GGUF文件夹之下
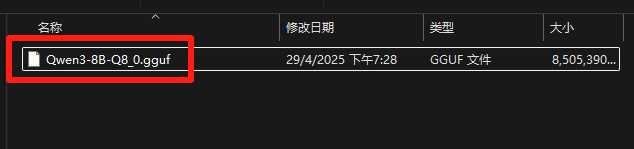
打开刚才的LM Studio界面能看到模型已经成功上传
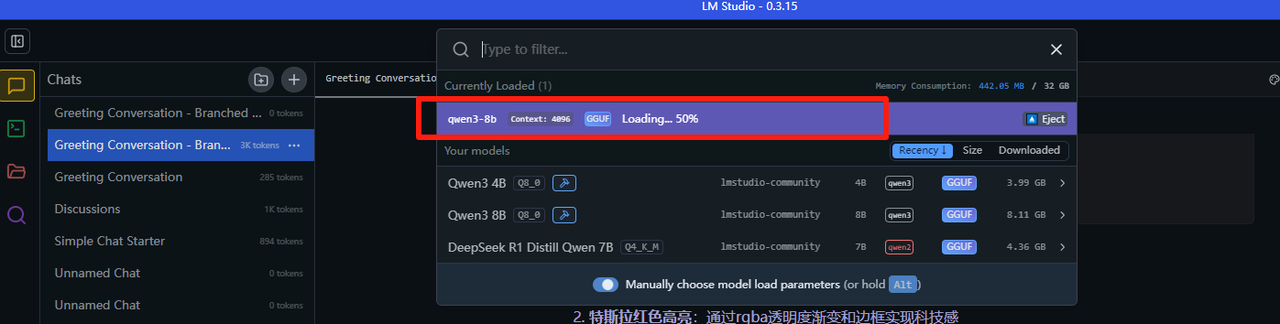
2.4 模型测试
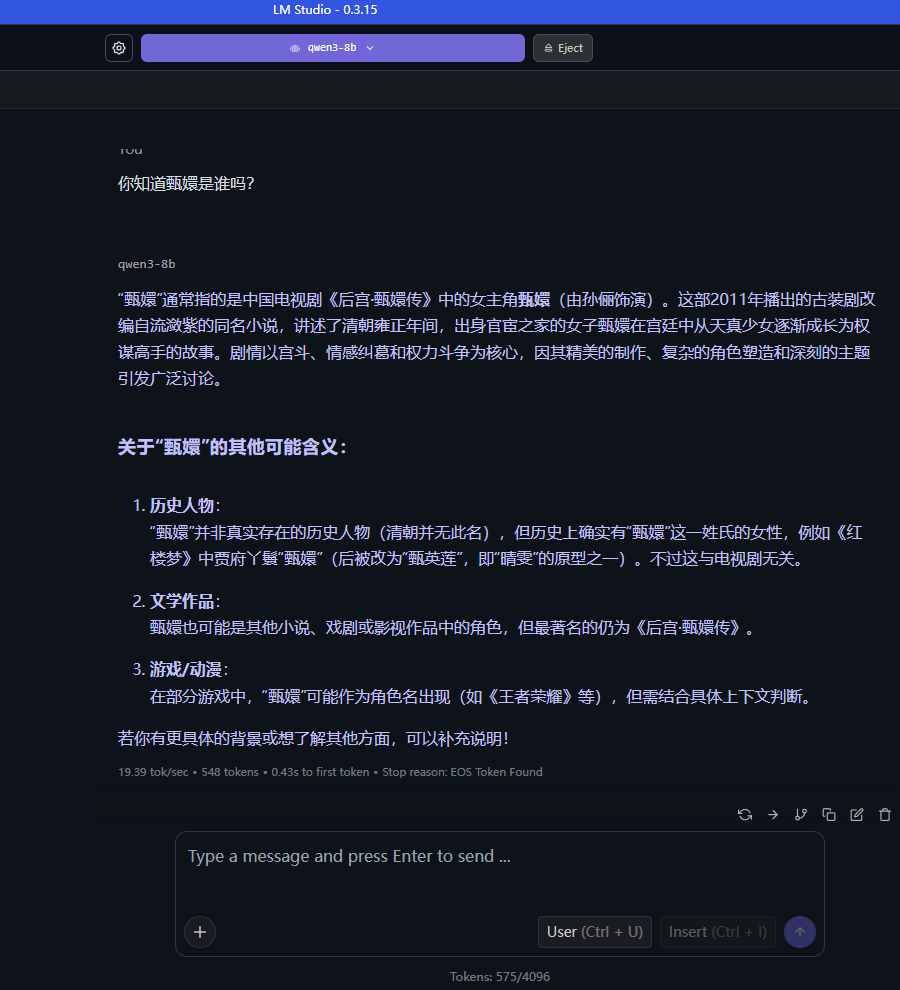
先点击黄色对话标签,然后点击“Select a model to load”(选择一个模型启动),下拉使用Qwen3-8b。
当然你可以通过这样对话的方式快速使用Qwen3模型啦~
- 调用本地Qwen3 api
3.1 首先准备好python环境及 Openai环境
保证python版本大于3.7及安装openai库
python>=3.7 pip install Openai
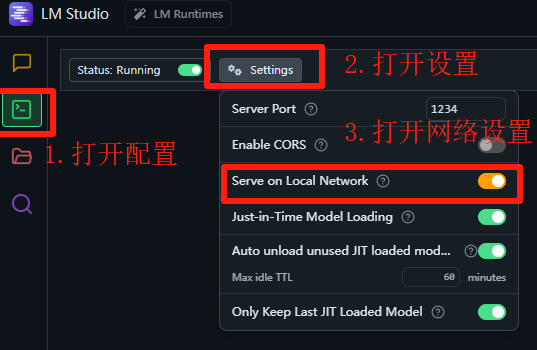
3.2 配置lmstudio
打开绿色的terminal模块,然后点击Setting开始设置,打开Serve on Local Network即可。
然后选择并启动模型。
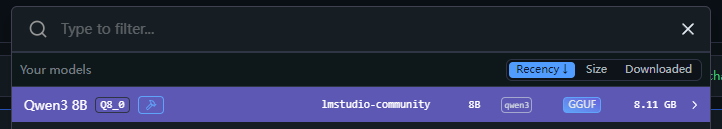
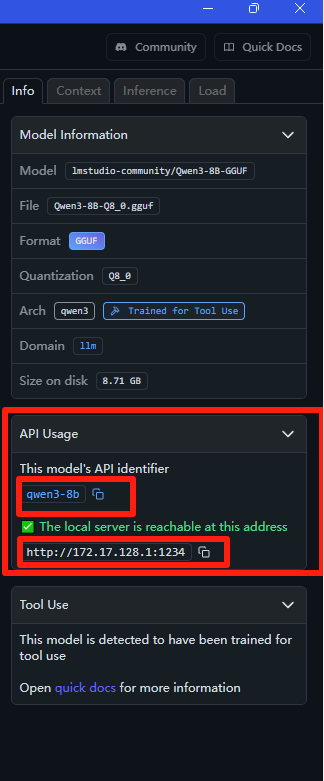
查看右侧区域中,可以看到当前的模型名称和地址,划重点等会要用哦~
3.3 打开python代码编辑器测试qwen3 api调用
from openai import OpenAI

# Point to the local server
client = OpenAI(base_url="http://localhost:1234/v1", api_key="lm-studio")

completion = client.chat.completions.create(
  model="qwen3-8b",
  messages=[
    {"role": "system", "content": "你是一个回答我日常问题的ai辅助机器人"},
    {"role": "user", "content": "如何做宫保鸡丁。"}
  ],
  temperature=0.7,
)

print(completion.choices[0].message.content)上面是代码内容,我们主要模型使用qwen3-8b,接着lmstudio的部署在刚才的地址里。由于是本机部署可以是localhost中,如果是局域网的小伙伴们可以使用局域网ip即可,也就是刚才的ip~
运行结果如下~到这里我们就完成了目前的Qwen3本地部署及调用的任务啦~
<think>

好的,用户问的是“如何做宫保鸡丁”。首先,我需要确认用户的需求是什么。可能他们想尝试在家做这道菜,或者对烹饪感兴趣。 接下来,我要考虑用户的背景,可能是初学者,所以步骤要详细易懂。

然后,我会回忆宫保鸡丁的基本材料和做法。记得主要食材是鸡肉、花生、辣椒等,调料有花椒、酱油、醋等。需要分步骤说明, 比如准备食材、腌制鸡肉、炒制过程等。

还要注意用户可能的疑问点,比如火候控制、调味比例,或者是否有替代食材。例如,有些人可能对花生过敏,或者没有花椒,是 否可以用其他香料代替。不过用户的问题比较直接,可能不需要涉及太多变通建议。

另外,要确保步骤清晰,避免专业术语过多,让初学者也能理解。同时提醒一些常见问题,比如鸡肉容易过老,需要控制火候;辣 椒和花椒的用量根据口味调整等。最后,可以加上小贴士,比如使用鸡腿肉更嫩,或者用淀粉腌制增加口感。

检查是否有遗漏的步骤或材料,确保所有必要的信息都包含在内。还要注意语言简洁明了,结构清晰,分点列出方便用户操作。最 后,确认回答是否符合用户的期望,是否需要进一步的帮助,比如视频教程链接或其他资源。

</think>

以下是制作宫保鸡丁的详细步骤:

\---

### **【材料准备】**

- 鸡胸肉/鸡腿肉 300g
- 花生米(或腰果)50g
- 干辣椒 8-10个(根据口味调整)
- 芹菜/青椒 适量(可选)
- 大蒜 3瓣
- 生姜 少许
- 花椒 1小把(约10粒)
- 酱油 2勺
- 醋 1勺
- 糖 1勺
- 料酒 1勺
- 淀粉 1勺(腌制鸡肉用)
- 盐、食用油 适量

\---

### **【步骤详解】**

#### **1. 处理食材**

- **鸡肉**:切丁,加入料酒、盐、淀粉抓匀腌制10分钟。
- **花生米**:提前用油炸至金黄酥脆(或水煮后晾干),备用。
- **辣椒**:剪成小段,去籽(若喜欢辣味可保留)。
- **蒜姜**:切片或末;芹菜/青椒切丁。

#### **2. 调制酱汁**

将以下调料混合成酱汁:

- 酱油 2勺
- 醋 1勺
- 糖 1勺
- 料酒 1勺
- 淀粉 1勺(增加浓稠度)
- 少许盐调味。

#### **3. 炒制过程**

1. **热锅凉油**:放入花椒,小火煸出香味后捞出(或保留)。
2. **炒鸡丁**:加入腌好的鸡肉快速翻炒至变色,盛出备用。
3. **炒配料**:用余油爆香蒜姜、干辣椒,加入芹菜/青椒炒软。
4. **混合食材**:倒入鸡丁、花生米,翻炒均匀。
5. **淋酱汁**:将调好的酱汁倒入锅中,快速翻炒收汁。
6. **出锅装盘**:最后撒上葱花或香菜点缀。

\---

### **【小贴士】**

1. **鸡肉选择**:鸡腿肉更嫩滑,鸡胸肉需切薄片避免柴。
2. **火候控制**:炒鸡丁时用大火快炒,避免过老。
3. **辣度调整**:干辣椒可换成小米椒或青椒,根据个人口味增减。
4. **酱汁比例**:糖和醋的比例为1:1,酸甜平衡是关键。

\---

### **【成品特点】**

- 鸡丁鲜嫩,花生酥脆,酱汁浓郁微辣,口感层次丰富。

如果你需要视频教程或替代食材建议(如素食版),可以告诉我哦! 😊04-Qwen3-8B EvalScope 智商情商评测
大模型评测是什么
大语言模型评测是指对大语言模型(LLM)在多种任务和场景下的性能进行全面评估的过程。评测的目的是衡量模型的通用能力、特定领域表现、效率、鲁棒性、安全性等多方面性能,以便优化模型设计、指导技术选型和推动模型在实际应用中的部署。
评测的主要内容包括以下几个方面:
通用能力:评估模型在语言理解、生成、推理等方面的基础能力。
特定领域表现:针对特定任务(如数学推理、代码生成、情感分析等)的性能评估。
效率与资源消耗:包括模型的训练和推理时间、计算资源需求等。
鲁棒性与可靠性:评估模型在面对噪声、对抗攻击或输入扰动时的稳定性。
伦理与安全性:检测模型是否会产生有害内容、是否存在偏见或歧视。
EvalScope 是魔搭社区官方推出的模型评测与性能基准测试框架,内置多个常用测试基准和评测指标,如 MMLU、CMMLU、C-Eval、GSM8K、ARC、HellaSwag、TruthfulQA、MATH 和 HumanEval 等;支持多种类型的模型评测,包括 LLM、多模态 LLM、embedding 模型和 reranker 模型。EvalScope 还适用于多种评测场景,如端到端 RAG 评测、竞技场模式和模型推理性能压测等。此外,通过 ms-swift 训练框架的无缝集成,可一键发起评测,实现了模型训练到评测的全链路支持。 官网地址:https://evalscope.readthedocs.io/zh-cn/latest/get_started
环境准备
本文基础环境如下:
----------------
ubuntu 22.04
python 3.12
Cuda  12.4
PyTorch  2.5.1
----------------pip 安装 EvalScope:
pip install evalscope                # 安装 Native backend (默认)
# 额外选项
pip install evalscope[opencompass]   # 安装 OpenCompass backend
pip install evalscope[vlmeval]       # 安装 VLMEvalKit backend
pip install evalscope[rag]           # 安装 RAGEval backend
pip install evalscope[perf]          # 安装 模型压测模块 依赖
pip install evalscope[all] # 安装所有 backends (Native, OpenCompass, VLMEvalKit, RAGEval)考虑到部分同学配置环境可能会遇到一些问题,我们在 AutoDL 平台准备了 Qwen3 的环境镜像,点击下方链接并直接创建 Autodl 示例即可。 https://www.codewithgpu.com/i/datawhalechina/self-llm/Qwen3
模型评测方法
关于 Qwen3 模型的评测,EvalScope 官方给了一个实践教程供我们参考:https://evalscope.readthedocs.io/zh-cn/latest/best_practice/qwen3.html
下面我们以智商情商评测为例,对 Qwen3-8 模型进行评测。
我们将使用 EvalScope 模型评测框架,在 IQuiz 数据集上进行评测,这个数据集中收集了 40 道 IQ 测试和 80 道 EQ 测试选择题,其中包括一些经典问题:
数字 9.8 和 9.11 哪个大?
单词 strawberry 和 blueberry 中一共有多少个 r ?
刘雨正在休假,突然被要求开车送领导去机场,他正为休假计划的泡汤而懊恼,因此在送领导时,刹车踩得比较用力。在车上,领导突然说:“小刘啊,这不愧是有着悠久历史的西安,我这坐车有一种回到古代坐马车的感觉。” 领导是什么意思?
步骤一: 创建 vLLM 服务器
这里我们参照第 2 节教程内容(02-Qwen3-8B-vLLM 部署调用),使用 vLLM 创建兼容 OpenAI API 接口的服务器,然后使用 EvalScope 进行评测。当然接入其他的 api 也是可以的。
在终端输入以下命令,即可用 vLLM 部署 Qwen3-8B 模型到一个兼容 OpenAI API 接口的服务器上。
VLLM_USE_MODELSCOPE=true vllm serve /root/autodl-tmp/Qwen/Qwen3-8B --served-model-name Qwen3-8B --max_model_len 8192 --enable-reasoning --reasoning-parser deepseek_r1步骤二: 执行评测
我们可以使用 EvalScope 命令进行评测,直接在终端输入以下命令:
evalscope eval \
  --model Qwen3-8B \
  --api-url http://localhost:8000/v1 \
  --api-key EMPTY \
  --eval-type service \
  --eval-batch-size 16 \
  --datasets iquiz \
--work-dir outputs/Qwen3-8B也可以使用 Python 命令进行评测:
新建 eval_api.py 文件,并输入以下代码:
# 导入执行任务的函数和任务配置类
from evalscope.run import run_task
from evalscope.config import TaskConfig

"""
以下为多个AI服务的API端点地址,用于配置任务:
- siliconflow: https://api.siliconflow.cn/v1/chat/completions
- dashscope: https://dashscope.aliyuncs.com/compatible-mode/v1/chat/completions
- modelscope: https://api-inference.modelscope.cn/v1/chat/completions
- xunfei: https://maas-api.cn-huabei-1.xf-yun.com/v1/chat/completions
"""

# 配置任务参数
task_cfg = TaskConfig(
    model='Qwen3-8B',  # 指定使用的模型
    api_url='http://localhost:8000/v1/chat/completions',  # 指定API端点,这里使用的是ollama默认的api接口
    api_key='sk-xxxxxxx',  # API密钥(需替换为实际密钥,ollama 的api_key)
    eval_type='service',  # 指定评估类型为服务模式
    datasets=['iquiz'],  # 指定使用的数据集(这个测试集可以快速测试模型的智商和情商)
    generation_config={  # 文本生成配置
        'max_tokens': 4096,  # 最大令牌数
        'max_new_tokens': 4096,  # 最大新生成令牌数
        'temperature': 1.0,  # 温度参数,这里设置为1.0,模型的输出随机性较大,所以可能会有些实验误差
    },
    work_dir='outputs/Qwen3-8b',  # 输出目录
)

# 执行任务
run_task(task_cfg=task_cfg)新建一个 bash 窗口,也就是终端中执行。 控制台运行python eval_api.py命令即可。
等待 3 分钟左右评测就完成啦,控制台输出的结果如下图所示:
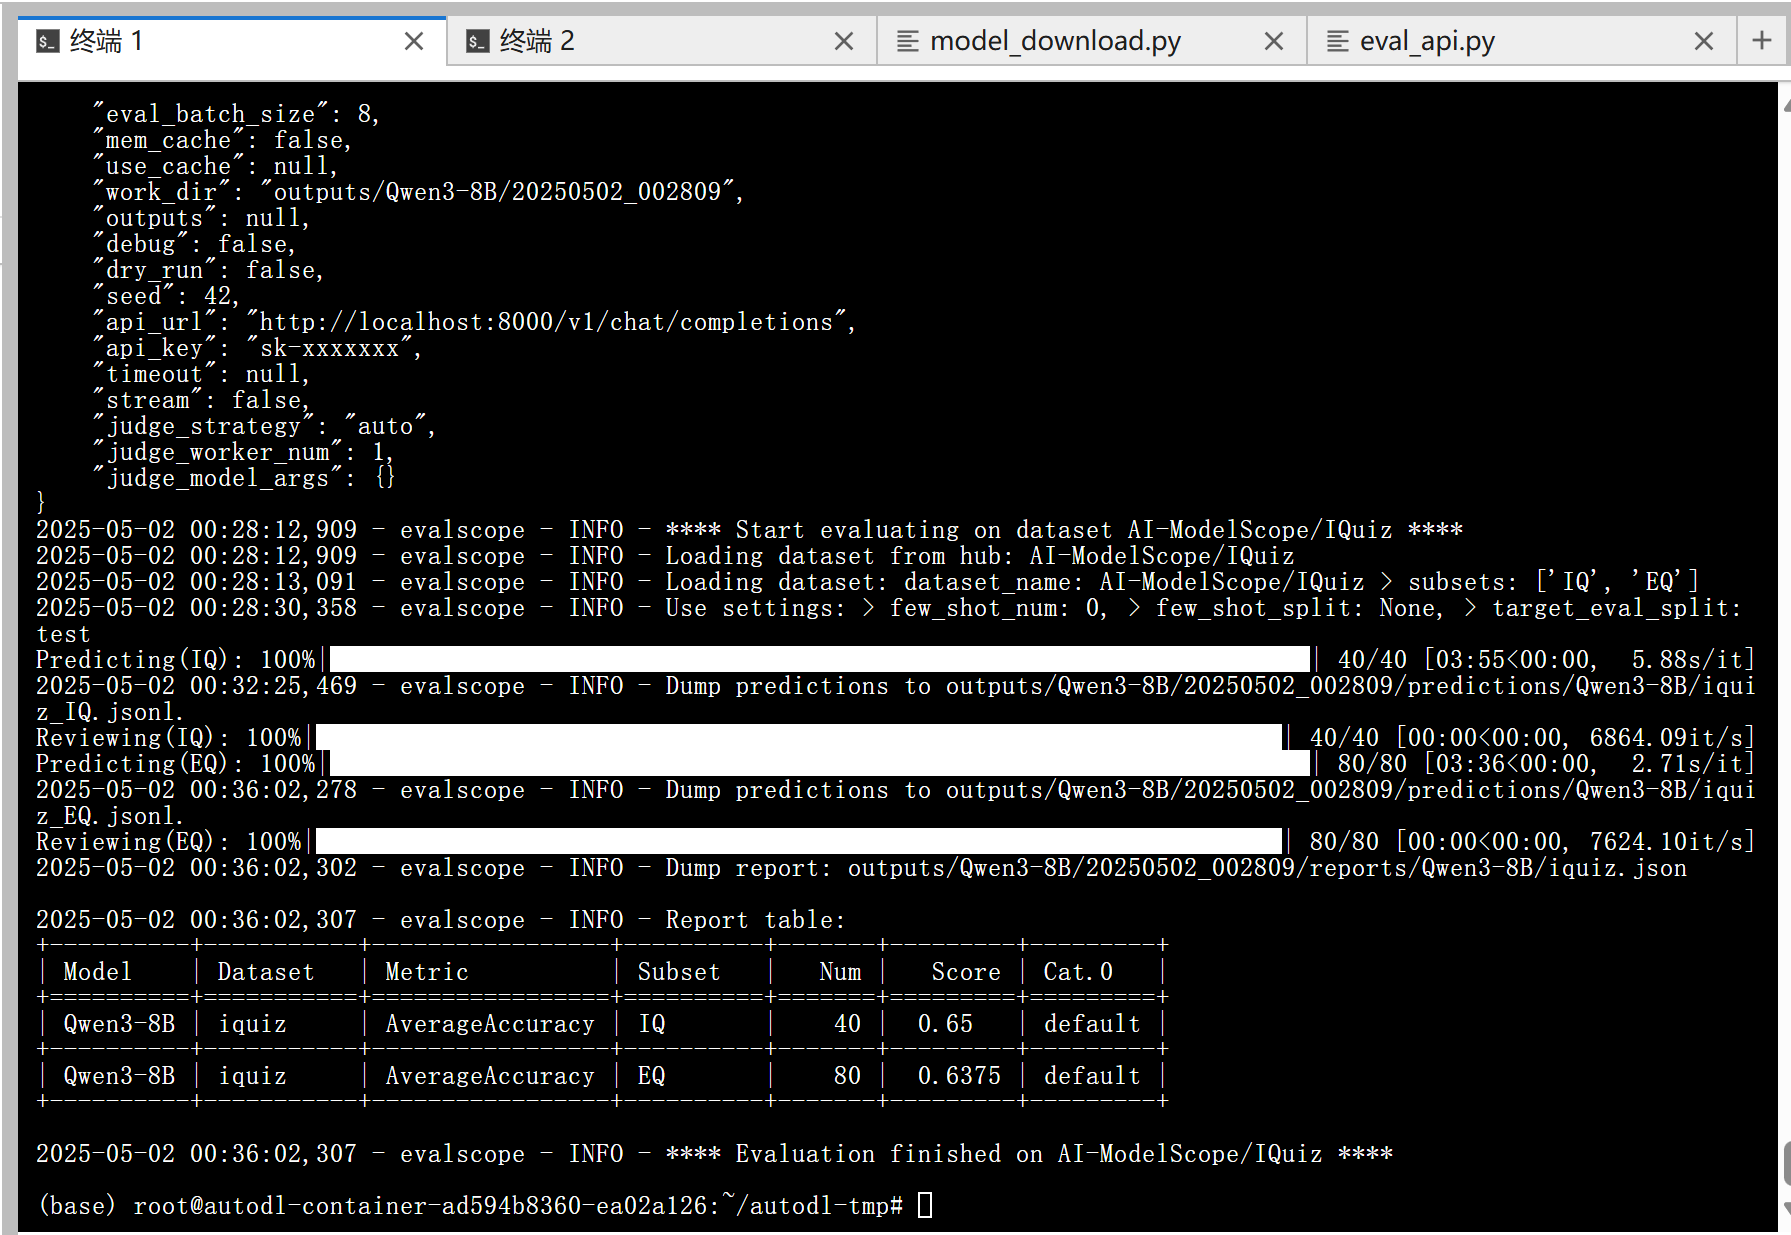
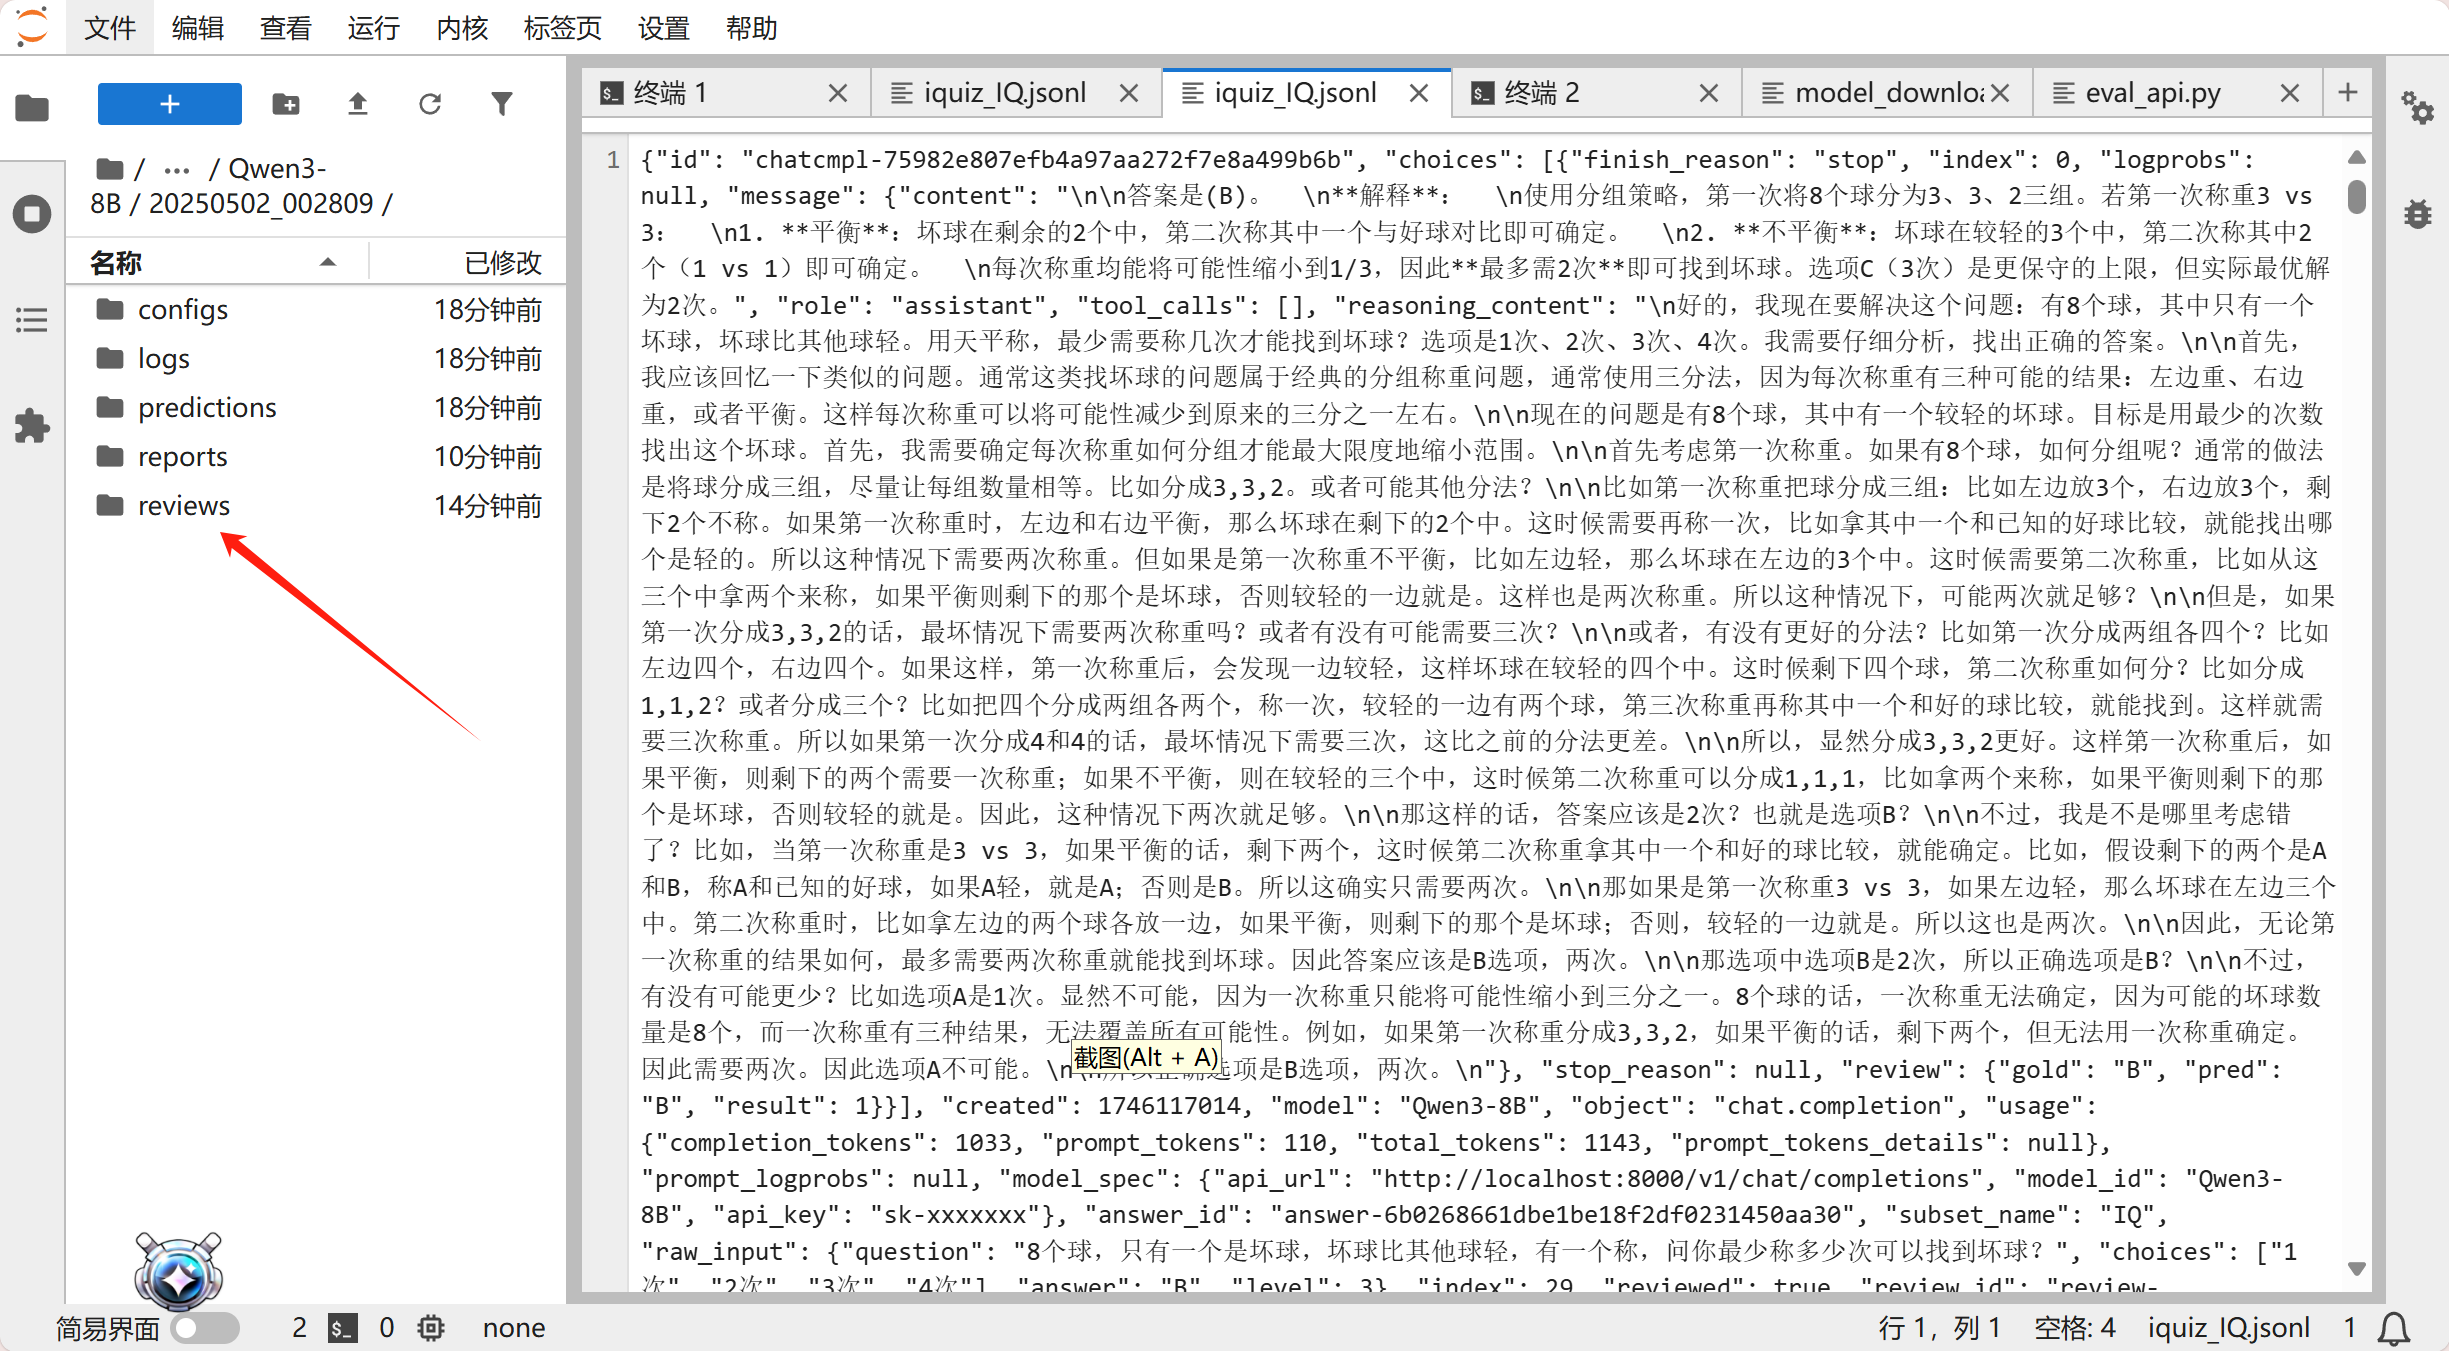
实验结果可能有误差,因为在评测任务配置中我们把 temperature 调到了 1.0,如果调小一些,可能会得到更精确的结果。 可以看到模型的得分还是不错的,模型评测的文件保存在/root/autodl-tmp/outputs/Qwen3-8B/20250502_002809/reviews/Qwen3-8B目录下。
EvalScope 简介:
EvalScope 支持多种模型评测 backend,包括 OpenAI API、OpenCompass、VLMEvalKit、RAGEval 等。
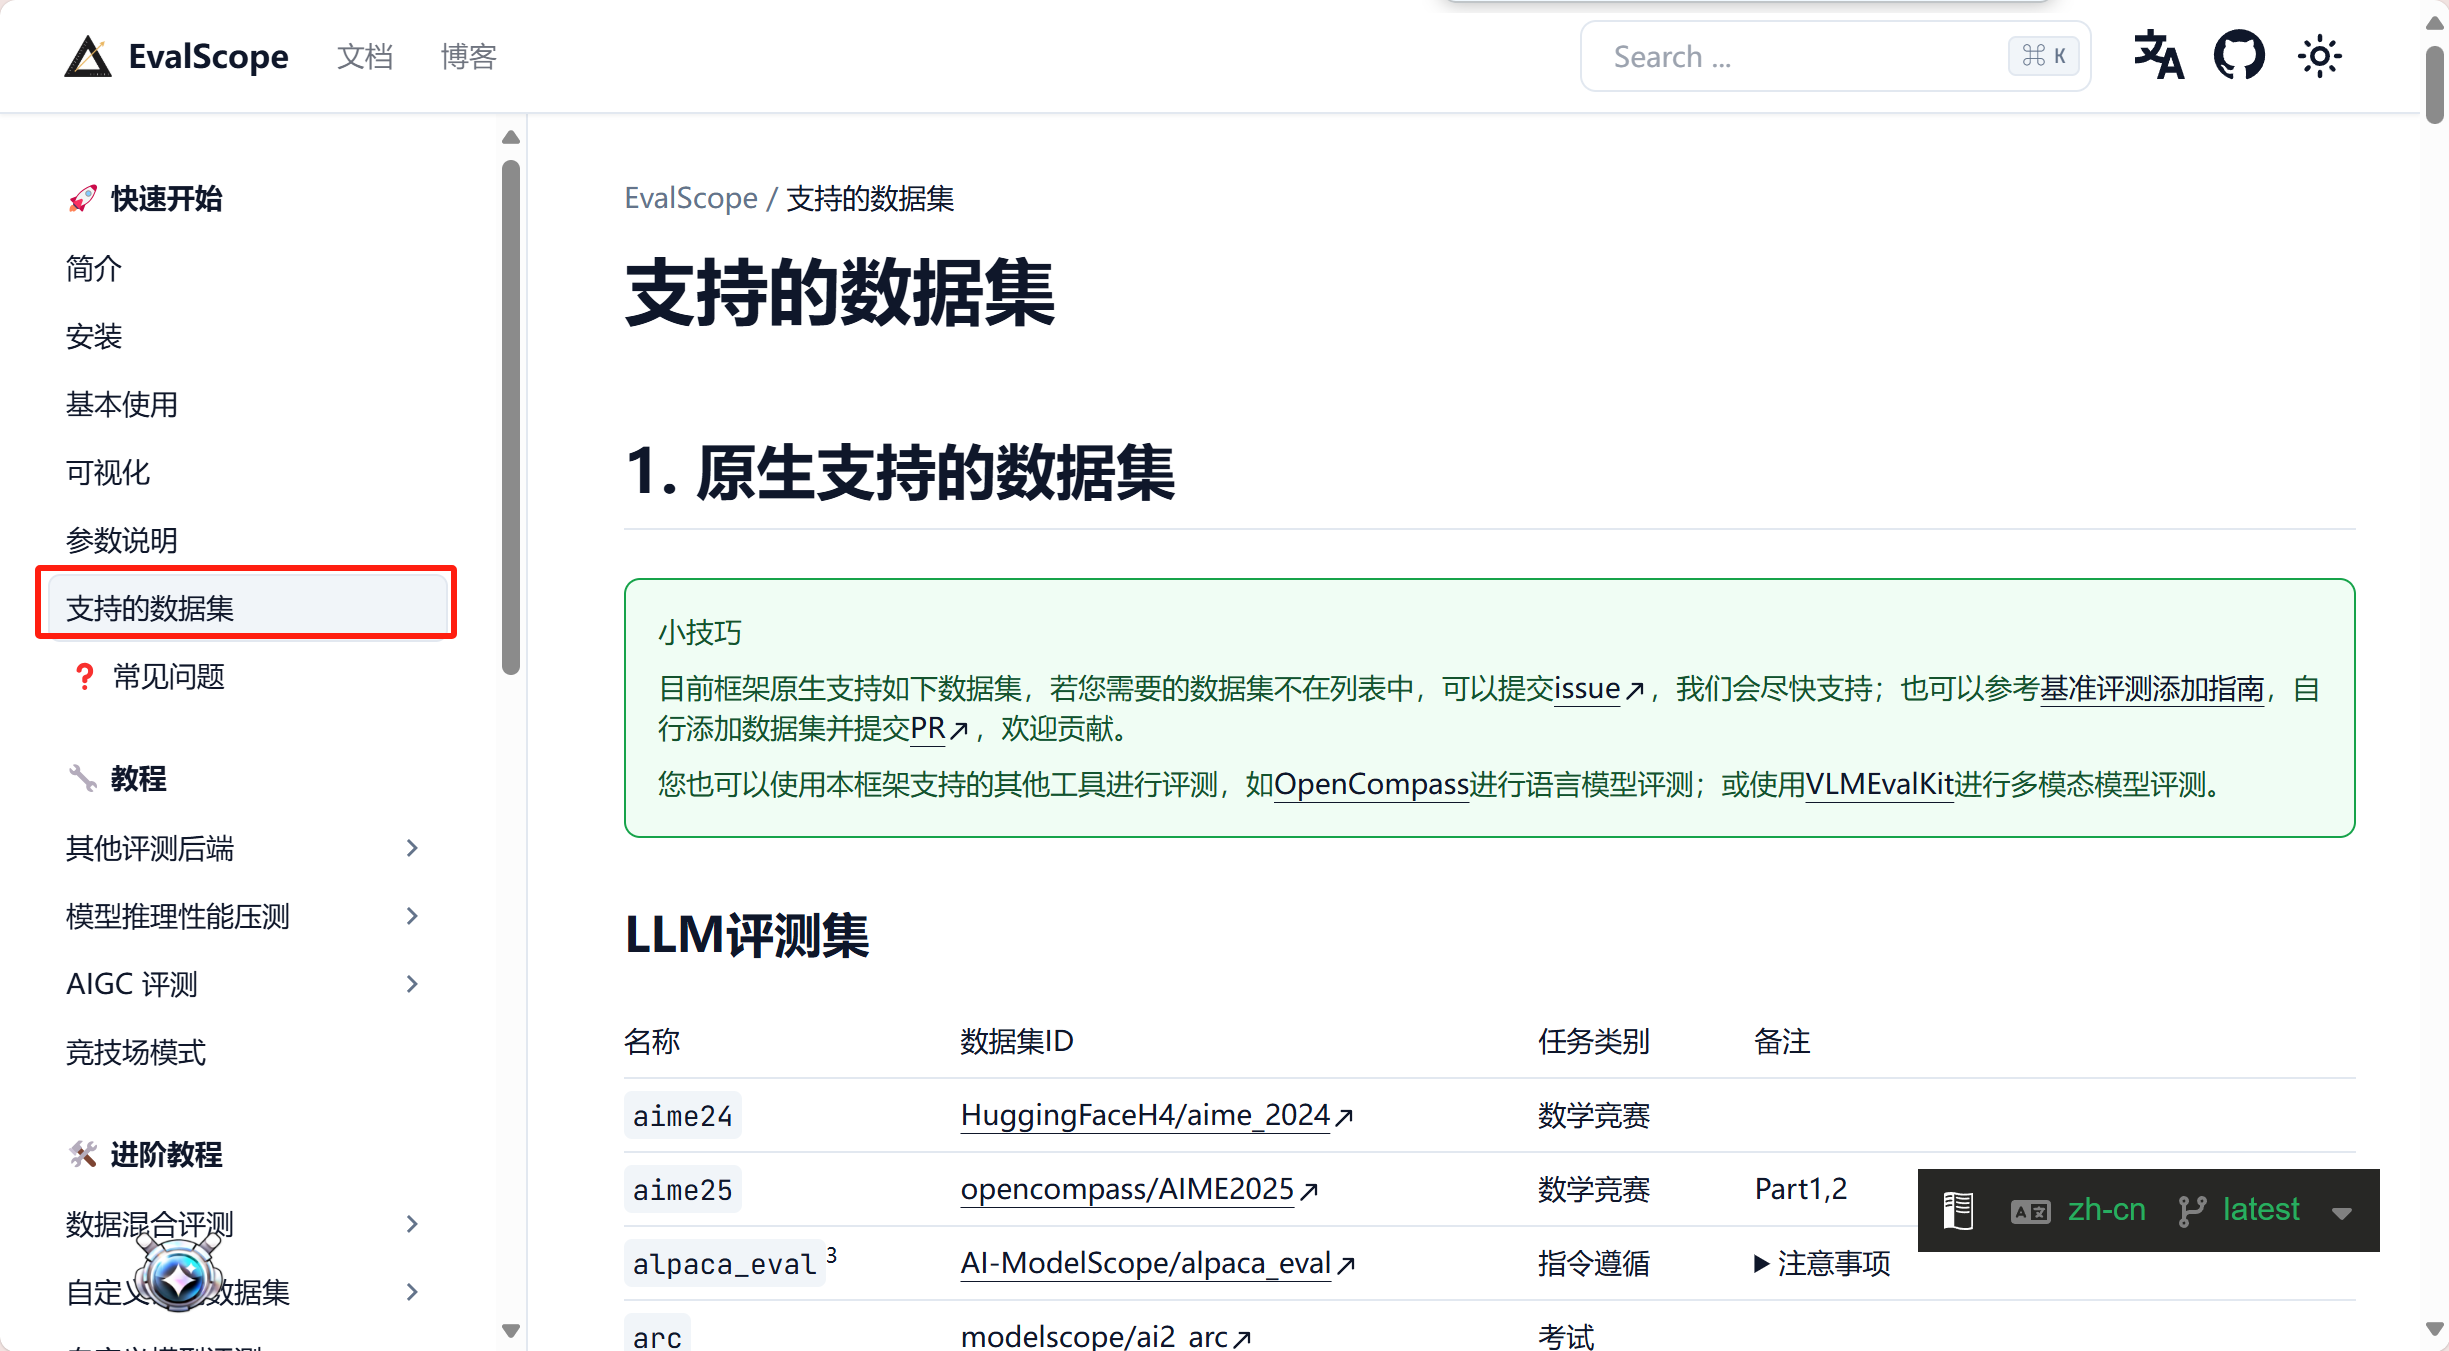
EvalScope 也支持自定义评测任务和数据集,支持多种评测指标。
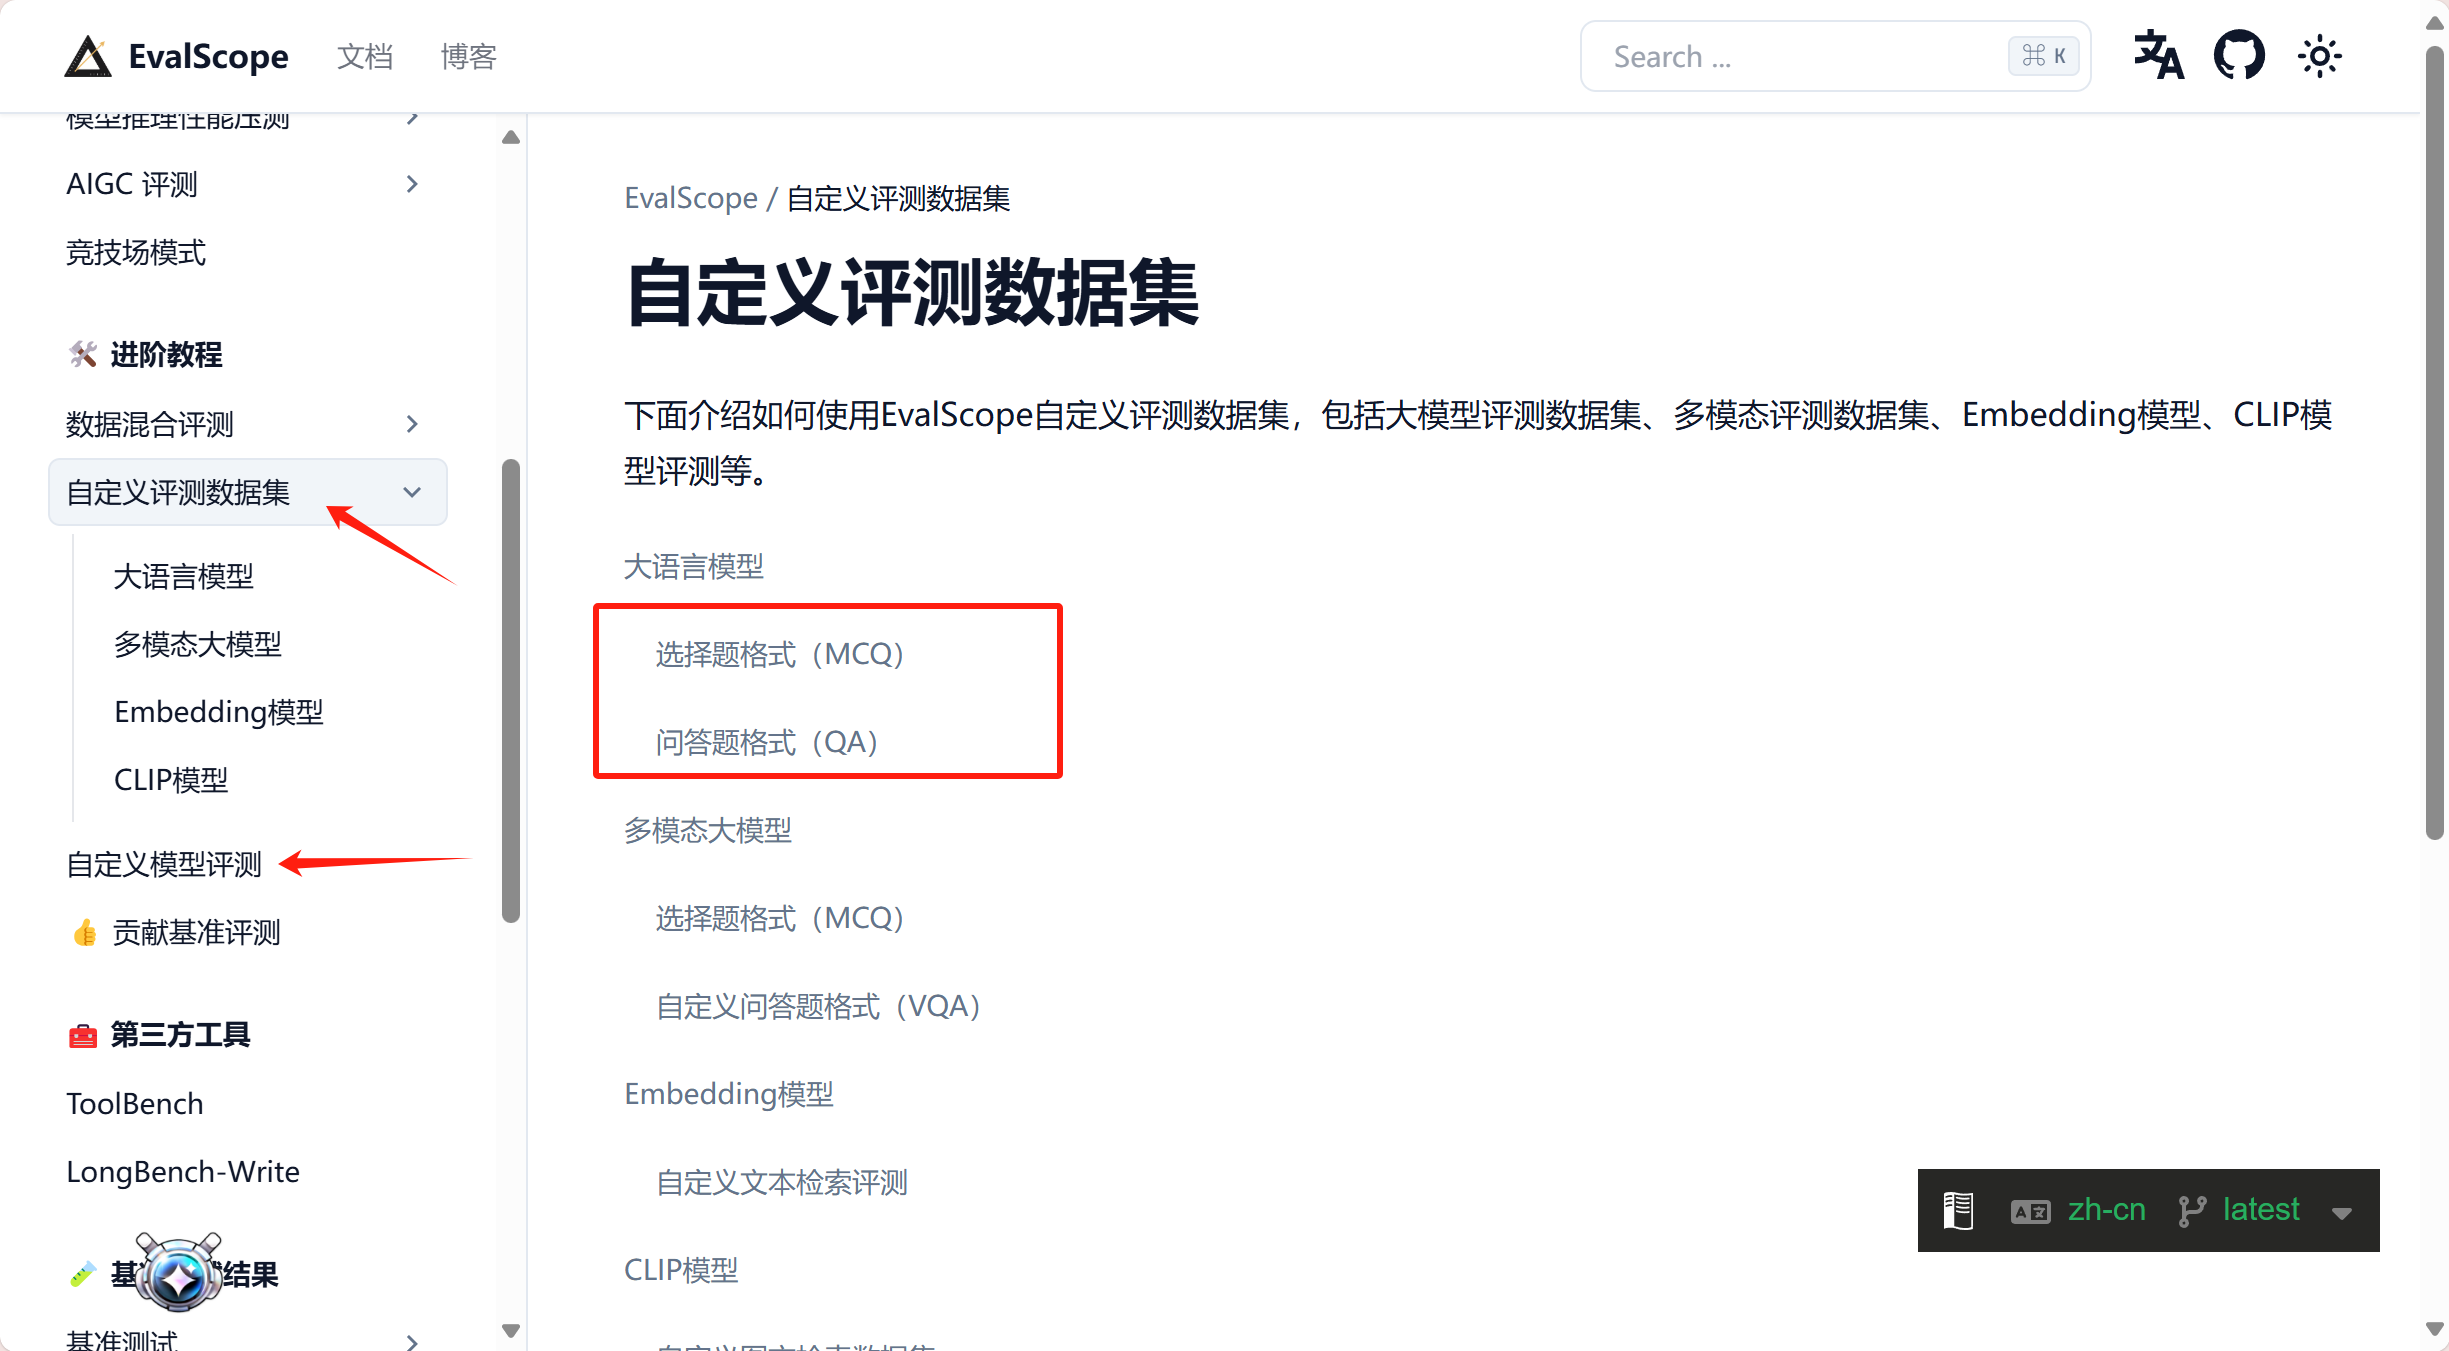
模型评测对于验证和优化大模型至关重要。通过评测,我们可以全面了解模型的性能、能力边界及潜在问题,确保其在实际应用中的表现符合预期,并推动持续改进。此外,评测还能检测模型的公平性和安全性,提升用户体验,并为不同模型间的对比分析提供客观依据。最终,评测结果为后续版本迭代提供了关键数据支持,保障模型在实际场景中的可靠性和有效性。
Qwen3-8B-LoRA 及 SwanLab 可视化记录
环境配置
# 换清华镜像源
pip config set global.index-url https://pypi.tuna.tsinghua.edu.cn/simple

pip install modelscope==1.25.0
pip install transformers==4.51.3
pip install accelerate==1.6.0
pip install datasets==3.5.1
pip install peft==0.15.2
pip install swanlab==0.5.7考虑到部分同学配置环境可能会遇到一些问题,我们在 AutoDL 平台准备了 Qwen3 的环境镜像,点击下方链接并直接创建 Autodl 示例即可。 https://www.codewithgpu.com/i/datawhalechina/self-llm/Qwen3
模型下载
# model_download.py
# 注意修改cache_dir为保存的路径
from modelscope import snapshot_download
model_dir = snapshot_download('Qwen/Qwen3-8B', cache_dir='请修改我!!!', revision='master')

print(f"模型下载完成,保存路径为:{model_dir}")数据集构建
对大语言模型进行 supervised-finetuning(sft,有监督微调)的数据格式如下:
{
  "instruction": "回答以下用户问题,仅输出答案。",
  "input": "1+1等于几?",
  "output": "2"
}其中,instruction 是用户指令,告知模型其需要完成的任务;input 是用户输入,是完成用户指令所必须的输入内容;output 是模型应该给出的输出。
有监督微调的目标是让模型具备理解并遵循用户指令的能力。因此,在构建数据集时,我们应针对我们的目标任务,针对性构建数据。比如,如果我们的目标是通过大量人物的对话数据微调得到一个能够 role-play 甄嬛对话风格的模型,因此在该场景下的数据示例如下:
{
  "instruction": "你父亲是谁?",
  "input": "",
  "output": "家父是大理寺少卿甄远道。"
}数据准备
LoRA(Low-Rank Adaptation)训练的数据是需要经过格式化、编码之后再输入给模型进行训练的,我们需要先将输入文本编码为 input_ids,将输出文本编码为 labels,编码之后的结果是向量。我们首先定义一个预处理函数,这个函数用于对每一个样本,同时编码其输入、输出文本并返回一个编码后的字典:
def process_func(example):
    MAX_LENGTH = 1024 # 设置最大序列长度为1024个token
    input_ids, attention_mask, labels = [], [], [] # 初始化返回值
    # 适配chat_template
    instruction = tokenizer(
        f"<s><|im_start|>system\n现在你要扮演皇帝身边的女人--甄嬛<|im_end|>\n"
        f"<|im_start|>user\n{example['instruction'] + example['input']}<|im_end|>\n"
        f"<|im_start|>assistant\n<think>\n\n</think>\n\n",
        add_special_tokens=False
    )
    response = tokenizer(f"{example['output']}", add_special_tokens=False)
    # 将instructio部分和response部分的input_ids拼接,并在末尾添加eos token作为标记结束的token
    input_ids = instruction["input_ids"] + response["input_ids"] + [tokenizer.pad_token_id]
    # 注意力掩码,表示模型需要关注的位置
    attention_mask = instruction["attention_mask"] + response["attention_mask"] + [1]
    # 对于instruction,使用-100表示这些位置不计算loss(即模型不需要预测这部分)
    labels = [-100] * len(instruction["input_ids"]) + response["input_ids"] + [tokenizer.pad_token_id]
    if len(input_ids) > MAX_LENGTH:  # 超出最大序列长度截断
        input_ids = input_ids[:MAX_LENGTH]
        attention_mask = attention_mask[:MAX_LENGTH]
        labels = labels[:MAX_LENGTH]
    return {
        "input_ids": input_ids,
        "attention_mask": attention_mask,
        "labels": labels
}Qwen3 采用的 Chat Template格式如下:
由于 Qwen3 是混合推理模型,因此可以手动选择开启思考模式
不开启 thinking mode
messages = [
    {"role": "system", "content": "===system_message_test==="},
    {"role": "user", "content": "===user_message_test==="},
    {"role": "assistant", "content": "===assistant_message_test==="},
]

text = tokenizer.apply_chat_template(
    messages,
    tokenize=False,
    add_generation_prompt=True,
    enable_thinking=False
)
print(text)<|im_start|>system
===system_message_test===<|im_end|>
<|im_start|>user
===user_message_test===<|im_end|>
<|im_start|>assistant
<think>
</think>
===assistant_message_test===<|im_end|>
<|im_start|>assistant
<think>
</think>开启 thinking mode
messages = [
    {"role": "system", "content": "===system_message_test==="},
    {"role": "user", "content": "===user_message_test==="},
    {"role": "assistant", "content": "===assistant_message_test==="},
]

text = tokenizer.apply_chat_template(
    messages,
    tokenize=False,
    add_generation_prompt=True,
    enable_thinking=True
)
print(text)<|im_start|>system
===system_message_test===<|im_end|>
<|im_start|>user
===user_message_test===<|im_end|>
<|im_start|>assistant
<think>
</think>
===assistant_message_test===<|im_end|>
<|im_start|>assistant加载模型和 tokenizer
tokenizer = AutoTokenizer.from_pretrained('请修改我!!!/Qwen/Qwen3-8B')

model = AutoModelForCausalLM.from_pretrained('请修改我!!!/Qwen/Qwen3-8B', device_map="auto", torch_dtype=torch.bfloat16)Lora Config
LoraConfig这个类中可以设置很多参数,比较重要的如下
task_type:模型类型,现在绝大部分 decoder_only 的模型都是因果语言模型 CAUSAL_LM
target_modules:需要训练的模型层的名字,主要就是 attention部分的层,不同的模型对应的层的名字不同
r:LoRA 的秩,决定了低秩矩阵的维度,较小的 r 意味着更少的参数
lora_alpha:缩放参数,与 r 一起决定了 LoRA 更新的强度。实际缩放比例为lora_alpha/r,在当前示例中是 32 / 8 = 4 倍
lora_dropout:应用于 LoRA 层的 dropout rate,用于防止过拟合
config = LoraConfig(
    task_type=TaskType.CAUSAL_LM,
    target_modules=["q_proj", "k_proj", "v_proj", "o_proj", "gate_proj", "up_proj", "down_proj"],
    inference_mode=False, # 训练模式
    r=8, # Lora 秩
    lora_alpha=32, # Lora alpha
    lora_dropout=0.1 # Dropout 比例
)Training Arguments
output_dir:模型的输出路径
per_device_train_batch_size:每张卡上的 batch_size
gradient_accumulation_steps: 梯度累计
num_train_epochs:顾名思义 epoch
args = TrainingArguments(
    output_dir="./output/Qwen3_8B_LoRA", # 注意修改
    per_device_train_batch_size=4,
    gradient_accumulation_steps=4,
    logging_steps=10,
    num_train_epochs=3,
    save_steps=100,
    learning_rate=1e-4,
    save_on_each_node=True,
    gradient_checkpointing=True,
    report_to="none",
)SwanLab 简介
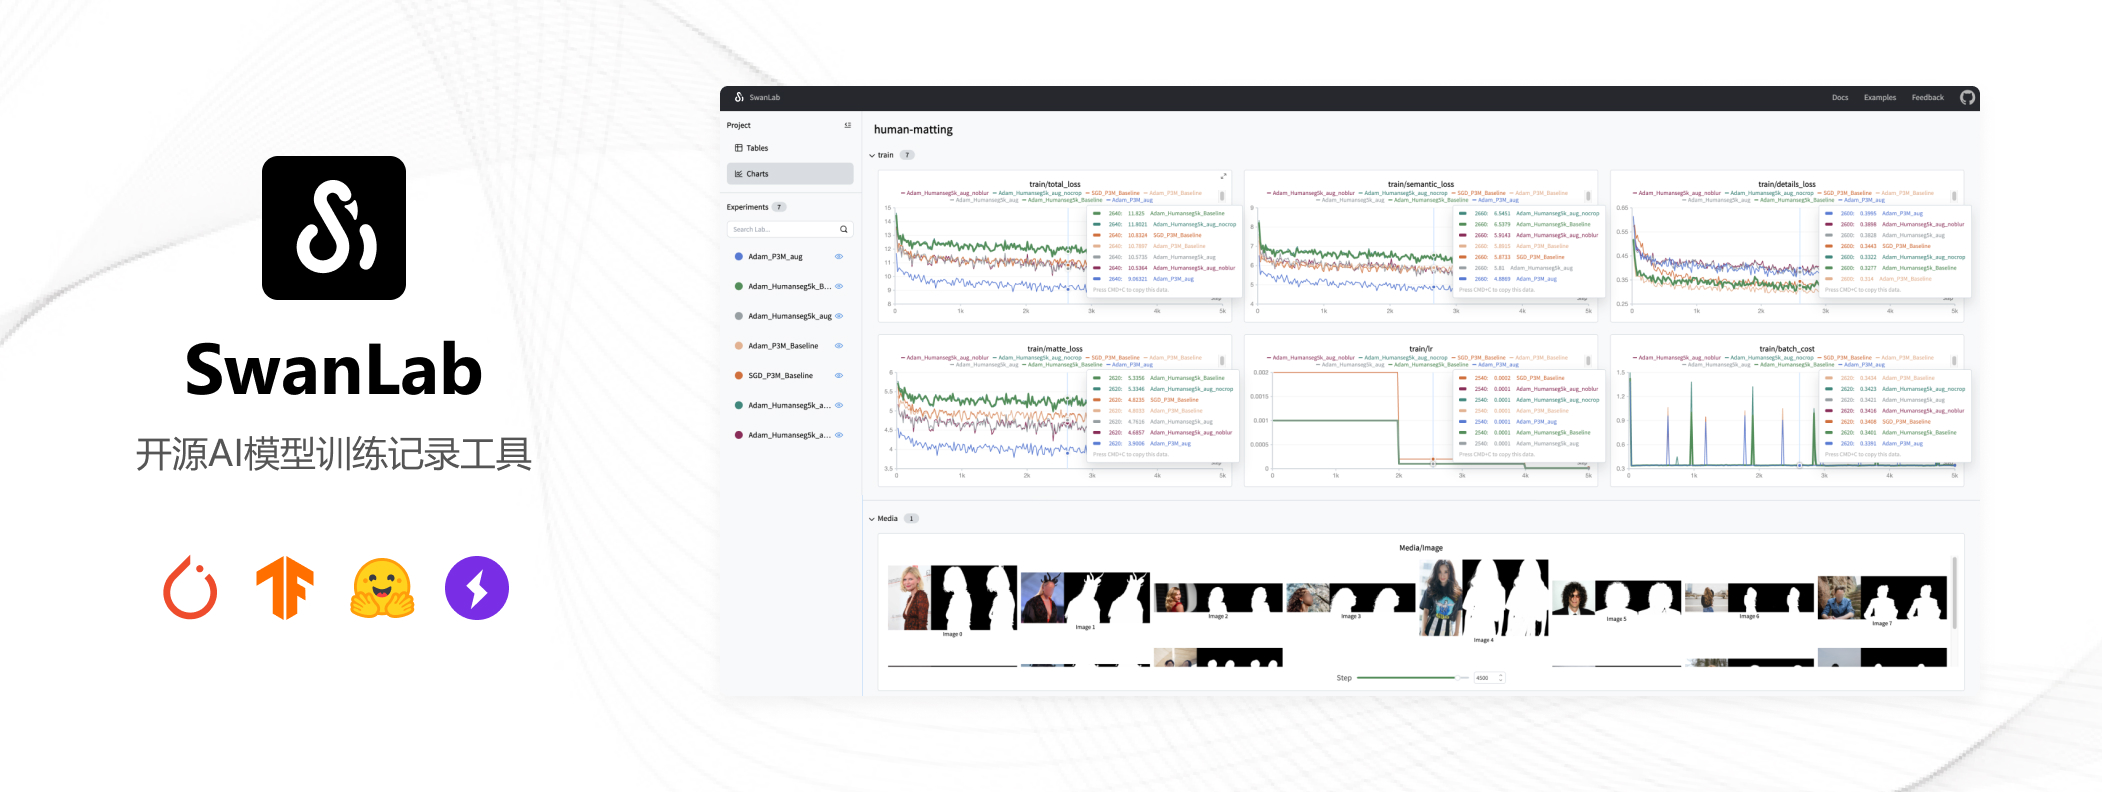
SwanLab 是一个开源的模型训练记录工具,面向 AI 研究者,提供了训练可视化、自动日志记录、超参数记录、实验对比、多人协同等功能。在 SwanLab 上,研究者能基于直观的可视化图表发现训练问题,对比多个实验找到研究灵感,并通过在线链接的分享与基于组织的多人协同训练,打破团队沟通的壁垒。
为什么要记录训练
相较于软件开发,模型训练更像一个实验科学。一个品质优秀的模型背后,往往是成千上万次实验。研究者需要不断尝试、记录、对比,积累经验,才能找到最佳的模型结构、超参数与数据配比。在这之中,如何高效进行记录与对比,对于研究效率的提升至关重要。
实例化 SwanLabCallback
(2) Use an existing SwanLab account 并使用 private API Key 登录
import swanlab
from swanlab.integration.transformers import SwanLabCallback

# 实例化SwanLabCallback
swanlab_callback = SwanLabCallback(
    project="Qwen3-Lora",  # 注意修改
    experiment_name="Qwen3-8B-LoRA-experiment"  # 注意修改
)使用 Trainer 训练
trainer = Trainer(
    model=model,
    args=args,
    train_dataset=tokenized_id,
    data_collator=DataCollatorForSeq2Seq(tokenizer=tokenizer, padding=True),
    callbacks=[swanlab_callback] # 传入之前的swanlab_callback
)
trainer.train()TrainOutput(global_step=699, training_loss=2.6425710331557988, metrics={'train_runtime': 879.9696, 'train_samples_per_second': 12.713, 'train_steps_per_second': 0.794, 'total_flos': 5.190619083415757e+16, 'train_loss': 2.6425710331557988, 'epoch': 2.990353697749196})训练完成后,打开 SwanLab ,可以查看训练过程中记录的参数和可视化的训练 loss 曲线:
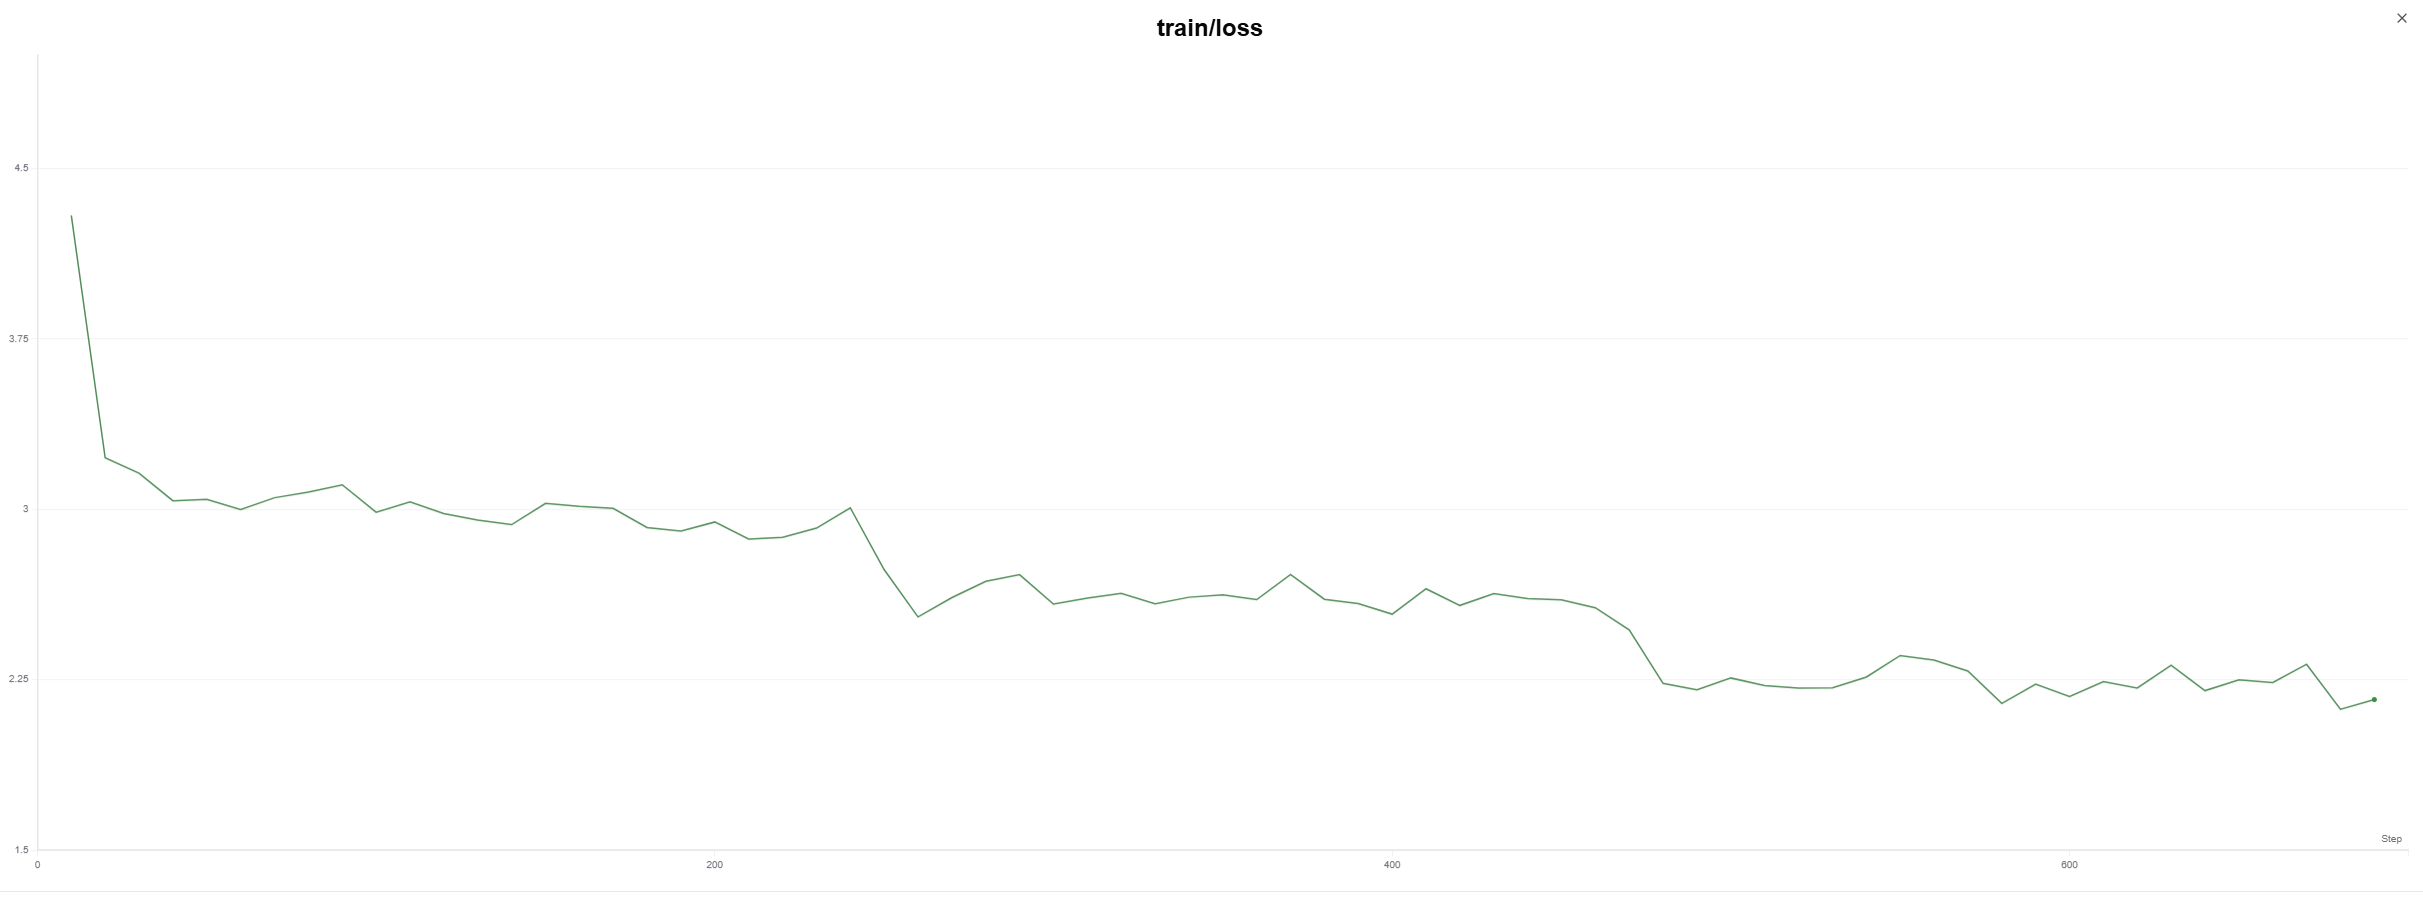
示例的训练记录公开链接如下,供参考
加载 lora 权重推理
得到任意 checkpoints 之后加载 lora 权重进行推理:
from transformers import AutoModelForCausalLM, AutoTokenizer
import torch
from peft import PeftModel

mode_path = '请修改我!!!/Qwen/Qwen3-8B'  # 注意修改
lora_path = './output/Qwen3_8B_lora/checkpoint-699' # 注意修改

# 加载tokenizer
tokenizer = AutoTokenizer.from_pretrained(mode_path)

# 加载Qwen3 base model
model = AutoModelForCausalLM.from_pretrained(mode_path, device_map="auto",torch_dtype=torch.bfloat16, trust_remote_code=True)

# 加载lora权重
model = PeftModel.from_pretrained(model, model_id=lora_path)

prompt = "你是谁?"
inputs = tokenizer.apply_chat_template(
                                    [{"role": "user", "content": "假设你是皇帝身边的女人--甄嬛。"},{"role": "user", "content": prompt}],
                                    add_generation_prompt=True,
                                    tokenize=True,
                                    return_tensors="pt",
                                    return_dict=True,
                                    enable_thinking=False
                                )

# 采样参数设置
gen_kwargs = {"max_length": 2500, "do_sample": True, "top_k": 1}
with torch.no_grad():
    outputs = model.generate(**inputs, **gen_kwargs)
    outputs = outputs[:, inputs['input_ids'].shape[1]:]
print(tokenizer.decode(outputs[0], skip_special_tokens=True))我是甄嬛,家父是大理寺少卿甄远道。06-Qwen3-30B-A3B 微调及 SwanLab 可视化记录
本节我们简要介绍如何基于 transformers、peft 等框架,使用由笔者合作开源的 Chat-甄嬛 项目中的嬛嬛数据集作为微调数据集,对 Qwen3-30B-A3B 模型进行 LoRA 微调, 以构建一个能够模拟甄嬛对话风格的个性化 LLM , 数据集路径为../../dataset/huanhuan.json。同时使用 SwanLab 监控训练过程与评估模型效果。
代码:文本的完整微调代码部分,或本目录下的 06-Qwen3-30B-A3B 微调及 SwanLab 可视化记录.ipynb
可视化训练过程:KMnO4-zx/Qwen3-8B/Qwen3-30B-A3B-LoRA
模型:Qwen3-30B-A3B
数据集:huanhuan
显存需求:约 85GB,如显存不足,请调低 per_device_train_batch_size。(模型本身占 60GB 左右,对显存要求较高,笔者采用一张 H20 进行训练)
目录
06-Qwen3-30B-A3B 微调及 SwanLab 可视化记录
目录
1. 环境配置
2. 模型下载
3. 指令集构建
4. 数据格式化
5. 加载 tokenizer 和半精度模型 (model)
6. 定义 LoraConfig
7. 自定义 TrainingArguments 参数
8. SwanLab 可视化
SwanLab 简介
实例化 SwanLabCallback
9. 使用 Trainer 训练
10. 训练结果演示
11. 加载 LoRA 权重推理
- 环境配置
实验所依赖的基础开发环境如下:
----------------
ubuntu 22.04
Python 3.12.3
cuda 12.4
pytorch 2.5.1
----------------本文默认学习者已安装好以上 Pytorch(cuda) 环境,如未安装请自行安装。
首先 pip 换源加速下载并安装依赖包:
# 升级pip
python -m pip install --upgrade pip
# 更换 pypi 源加速库的安装
pip config set global.index-url https://pypi.tuna.tsinghua.edu.cn/**simple**

pip install modelscope==1.25.0 # 用于模型下载和管理
pip install transformers==4.51.3 # Hugging Face 的模型库,用于加载和训练模型
pip install accelerate==1.6.0 # 用于分布式训练和混合精度训练
pip install datasets==3.5.1 # 用于加载和处理数据集
pip install peft==0.15.2 # 用于 LoRA 微调
pip install swanlab==0.5.7 # 用于监控训练过程与评估模型效果考虑到部分同学配置环境可能会遇到一些问题,我们在 AutoDL 平台准备了 Qwen3 的环境镜像,点击下方链接并直接创建 Autodl 示例即可。 https://www.codewithgpu.com/i/datawhalechina/self-llm/Qwen3
- 模型下载
modelscope 是一个模型管理和下载工具,支持从魔搭 (Modelscope) 等平台快速下载模型。
这里使用 modelscope 中的 snapshot_download 函数下载模型,第一个参数 model_name_or_path 为模型名称或者本地路径,第二个参数 cache_dir 为模型的下载路径,第三个参数 revision 为模型的版本号。
在 /root/autodl-tmp 路径下新建 model_download.py 文件并在其中粘贴以下代码,并保存文件。
from modelscope import snapshot_download

model_dir = snapshot_download('/data/Qwen/Qwen3-30B-A3B', cache_dir='./', revision='master')注意:记得修改 cache_dir 为你的模型下载路径哦~
在终端运行 python /root/autodl-tmp/model_download.py 执行下载,模型大小为 57GB 左右,下载时间较久。
- 指令集构建
LLM 的微调一般指指令微调过程。所谓指令微调,是说我们使用的微调数据形如:
{
  "instruction": "回答以下用户问题,仅输出答案。",
  "input": "1+1等于几?",
  "output": "2"
}其中,instruction 是用户指令,告知模型其需要完成的任务;input 是用户输入,是完成用户指令所必须的输入内容;output 是模型应该给出的输出。
即我们的核心训练目标是让模型具有理解并遵循用户指令的能力。因此,在指令集构建时,我们应针对我们的目标任务,针对性构建任务指令集。
{
  "instruction": "你是谁?",
  "input": "",
  "output": "家父是大理寺少卿甄远道。"
}我们所构造的全部指令数据集会被保存在根目录下。
- 数据格式化
LoRA 训练的数据是需要经过格式化、编码之后再输入给模型进行训练的,如果是熟悉 Pytorch 模型训练流程的同学会知道,我们一般需要将输入文本编码为 input_ids,将输出文本编码为 labels,编码之后的结果都是多维的向量。
为了得到 Qwen3-30B-A3B 的 Prompt Template,使用 tokenizer 构建 messages 并打印, 查看 chat_template 的输出格式
由于 Qwen3 是混合推理模型,因此可以手动选择开启思考模式
不开启 thinking mode
messages = [
            {"role": "system", "content": "You are a helpful assistant."},
            {"role": "user", "content": '你好呀'},
            {"role": "assistant", "content": '有什么可以帮你的?'}
            ]
# 使用chat_template将messages格式化并打印
text = tokenizer.apply_chat_template(
    messages,
    tokenize=False,
    add_generation_prompt=True,
    enable_thinking=False
)

print(text)得到输出结果如下
<|im_start|>system
You are a helpful assistant.<|im_end|>
<|im_start|>user
你好,你是谁?<|im_end|>
<|im_start|>assistant
<think>

</think>

我是一个AI助手,旨在帮助你解决问题<|im_end|>
<|im_start|>assistant
<think>

</think>开启 thinking mode
text = tokenizer.apply_chat_template(
    messages,
    tokenize=False,
    add_generation_prompt=True,
    enable_thinking=True
)

print(text)输出如下
<|im_start|>system
You are a helpful assistant.<|im_end|>
<|im_start|>user
你好,你是谁?<|im_end|>
<|im_start|>assistant
<think>

</think>

我是一个AI助手,旨在帮助你解决问题<|im_end|>
<|im_start|>assistant然后我们就可以定义预处理函数 process_func,这个函数用于对每一个样本,编码其输入、输出文本并返回一个编码后的字典,方便模型使用:
system_prompt = '现在你要扮演皇帝身边的女人--甄嬛'

def process_func(example):
    MAX_LENGTH = 384    # 分词器会将一个中文字切分为多个token,因此需要放开一些最大长度,保证数据的完整性
    input_ids, attention_mask, labels = [], [], []
    # 构建指令部分的输入, 可参考上面的输出格式进行调整和补充
    instruction = tokenizer(
        f"<s><|im_start|>system\n现在你要扮演皇帝身边的女人--甄嬛<|im_end|>\n"
        f"<|im_start|>user\n{example['instruction'] + example['input']}<|im_end|>\n"
        f"<|im_start|>assistant\n<think>\n\n</think>\n\n",
        add_special_tokens=False
    )
    response = tokenizer(f"{example['output']}", add_special_tokens=False)
    # 拼接指令和回复部分的 input_ids
    input_ids = instruction["input_ids"] + response["input_ids"] + [tokenizer.pad_token_id]
    attention_mask = instruction["attention_mask"] + response["attention_mask"] + [1]  # 因为eos token咱们也是要关注的所以 补充为1
    # 构建标签
    # 对于指令部分,使用 -100 忽略其损失计算;对于回复部分,保留其 input_ids 作为标签
    labels = [-100] * len(instruction["input_ids"]) + response["input_ids"] + [tokenizer.pad_token_id]
    # 如果总长度超过最大长度,进行截断
    if len(input_ids) > MAX_LENGTH:
        input_ids = input_ids[:MAX_LENGTH]
        attention_mask = attention_mask[:MAX_LENGTH]
        labels = labels[:MAX_LENGTH]
    return {
        "input_ids": input_ids,
        "attention_mask": attention_mask,
        "labels": labels
    }
- 加载 tokenizer 和半精度模型 (model)
tokenizer 是将文本转换为模型 (model) 能理解的数字的工具,model 是根据这些数字生成文本的核心部分。
以半精度形式加载 model, 如果你的显卡比较新的话,可以用 torch.bfolat 形式加载。对于自定义模型,必须指定 trust_remote_code=True ,以确保加载自定义代码时不会报错。
model_path = 'Qwen/Qwen3-30B-A3B'

tokenizer = AutoTokenizer.from_pretrained(model_path, use_fast=False, trust_remote_code=True)

model = AutoModelForCausalLM.from_pretrained(model_path, device_map="auto",
                                             torch_dtype=torch.bfloat16,
trust_remote_code=True)注意:此处要记得修改为自己的模型路径哦~
如果想要查看模型结构,可以打印模型:
print(model)输出结果如下
Qwen3MoeForCausalLM(
  (model): Qwen3MoeModel(
    (embed_tokens): Embedding(151936, 2048)
    (layers): ModuleList(
      (0-47): 48 x Qwen3MoeDecoderLayer(
        (self_attn): Qwen3MoeAttention(
          (q_proj): Linear(in_features=2048, out_features=4096, bias=False)
          (k_proj): Linear(in_features=2048, out_features=512, bias=False)
          (v_proj): Linear(in_features=2048, out_features=512, bias=False)
          (o_proj): Linear(in_features=4096, out_features=2048, bias=False)
          (q_norm): Qwen3MoeRMSNorm((128,), eps=1e-06)
          (k_norm): Qwen3MoeRMSNorm((128,), eps=1e-06)
        )
        (mlp): Qwen3MoeSparseMoeBlock(
          (gate): Linear(in_features=2048, out_features=128, bias=False)
          (experts): ModuleList(
            (0-127): 128 x Qwen3MoeMLP(
              (gate_proj): Linear(in_features=2048, out_features=768, bias=False)
              (up_proj): Linear(in_features=2048, out_features=768, bias=False)
              (down_proj): Linear(in_features=768, out_features=2048, bias=False)
              (act_fn): SiLU()
            )
          )
        )
        (input_layernorm): Qwen3MoeRMSNorm((2048,), eps=1e-06)
        (post_attention_layernorm): Qwen3MoeRMSNorm((2048,), eps=1e-06)
      )
    )
    (norm): Qwen3MoeRMSNorm((2048,), eps=1e-06)
    (rotary_emb): Qwen3MoeRotaryEmbedding()
  )
  (lm_head): Linear(in_features=2048, out_features=151936, bias=False)
)上面打印了 Qwen3MoeForCausalLM 的模型结构, 可以看到里面的 self_attn 和 mlp 是两个主要的模块, 因此可以考虑将这两个模块作为 LoRA 微调 的 target_modules , 包括 q_proj, k_proj, v_proj, o_proj 以及 gate_proj、up_proj 和 down_proj 。
通常我们只对 self_attn 模块中的 q_proj, k_proj, v_proj, o_proj进行微调, 本教程里我们也将对这四个模块进行微调演示, 感兴趣的同学可以自行尝试添加对 mlp 中的三个 proj 模块进行微调。
- 定义 LoraConfig
LoraConfig类用于设置 LoRA 微调参数,虽然可以设置很多参数,但主要的参数没多少,简单讲一讲,感兴趣的同学可以直接看源码。
task_type:模型类型
target_modules:需要训练的模型层的名字,主要就是 attention部分的层,不同的模型对应的层的名字不同,可以传入数组,也可以字符串,也可以正则表达式。
r:LoRA的秩,具体可以看 LoRA原理。
lora_alpha:LoRA alaph ,具体作用参见 LoRA 原理。
lora_dropout: LoRA 层的 Dropout 比例,用于防止过拟合,具体作用参见 LoRA 原理。
LoRA的缩放是啥嘞?当然不是 r(秩),这个缩放就是 lora_alpha/r, 在这个 LoraConfig中缩放就是 4 倍。
from peft import LoraConfig, TaskType, get_peft_model

config = LoraConfig(
    task_type=TaskType.CAUSAL_LM,
    target_modules=["q_proj", "k_proj", "v_proj", "o_proj", "gate_proj", "up_proj", "down_proj"], # 可以自行添加更多微调的target_modules
    inference_mode=False,     # 训练模式
    r=8,                      # LoRA 秩
    lora_alpha=32,            # LoRA alaph,具体作用参见 LoRA 原理
    lora_dropout=0.1          # Dropout 比例
)
- 自定义 TrainingArguments 参数
TrainingArguments类用于设置微调训练过程中的配置参数,这个类的源码也介绍了每个参数的具体作用,当然大家可以来自行探索,这里就简单说几个常用的。
output_dir:模型的输出路径
per_device_train_batch_size:顾名思义 batch_size,批量大小
gradient_accumulation_steps: 梯度累加,如果你的显存比较小,那可以把 batch_size 设置小一点,梯度累加增大一些。
logging_steps:多少步,输出一次 log
num_train_epochs:顾名思义 epoch,训练轮次
gradient_checkpointing:梯度检查,这个一旦开启,模型就必须执行 model.enable_input_require_grads(),这个原理大家可以自行探索,这里就不细说了。
args = TrainingArguments(
    output_dir="./output/Qwen3_30B_A3B_lora",
    per_device_train_batch_size=16,
    gradient_accumulation_steps=1,
    logging_steps=10,
    num_train_epochs=1,
    save_steps=100,
    learning_rate=1e-4,
    save_on_each_node=True,
    gradient_checkpointing=True,
    report_to="none",
)
- SwanLab 可视化
SwanLab 简介
SwanLab 是一个开源的模型训练记录工具,面向 AI 研究者,提供了训练可视化、自动日志记录、超参数记录、实验对比、多人协同等功能。在 SwanLab 上,研究者能基于直观的可视化图表发现训练问题,对比多个实验找到研究灵感,并通过在线链接的分享与基于组织的多人协同训练,打破团队沟通的壁垒。
为什么要记录训练
相较于软件开发,模型训练更像一个实验科学。一个品质优秀的模型背后,往往是成千上万次实验。研究者需要不断尝试、记录、对比,积累经验,才能找到最佳的模型结构、超参数与数据配比。在这之中,如何高效进行记录与对比,对于研究效率的提升至关重要。
实例化 SwanLabCallback
(2) Use an existing SwanLab account 并使用 private API Key 登录
SwanLab 与 Transformers 已经做好了集成,用法是在 Trainer 的 callbacks 参数中添加 SwanLabCallback 实例,就可以自动记录超参数和训练指标,简化代码如下:
import swanlab
from swanlab.integration.transformers import SwanLabCallback

swanlab_callback = SwanLabCallback(
    project="Qwen3-8B",
    experiment_name="Qwen3-30B-A3B-Lora"
)
- 使用 Trainer 训练
我们使用 Trainer 类来管理训练过程。TrainingArguments 用于设置训练参数,Trainer 则负责实际的训练逻辑。
trainer = Trainer(
    model=model,                 # 要训练的模型
    args=args,                   # 训练参数
    train_dataset=tokenized_id,  # 训练数据集
    data_collator=DataCollatorForSeq2Seq(tokenizer=tokenizer, padding=True),
    callbacks=[swanlab_callback]
    # 数据整理器
)
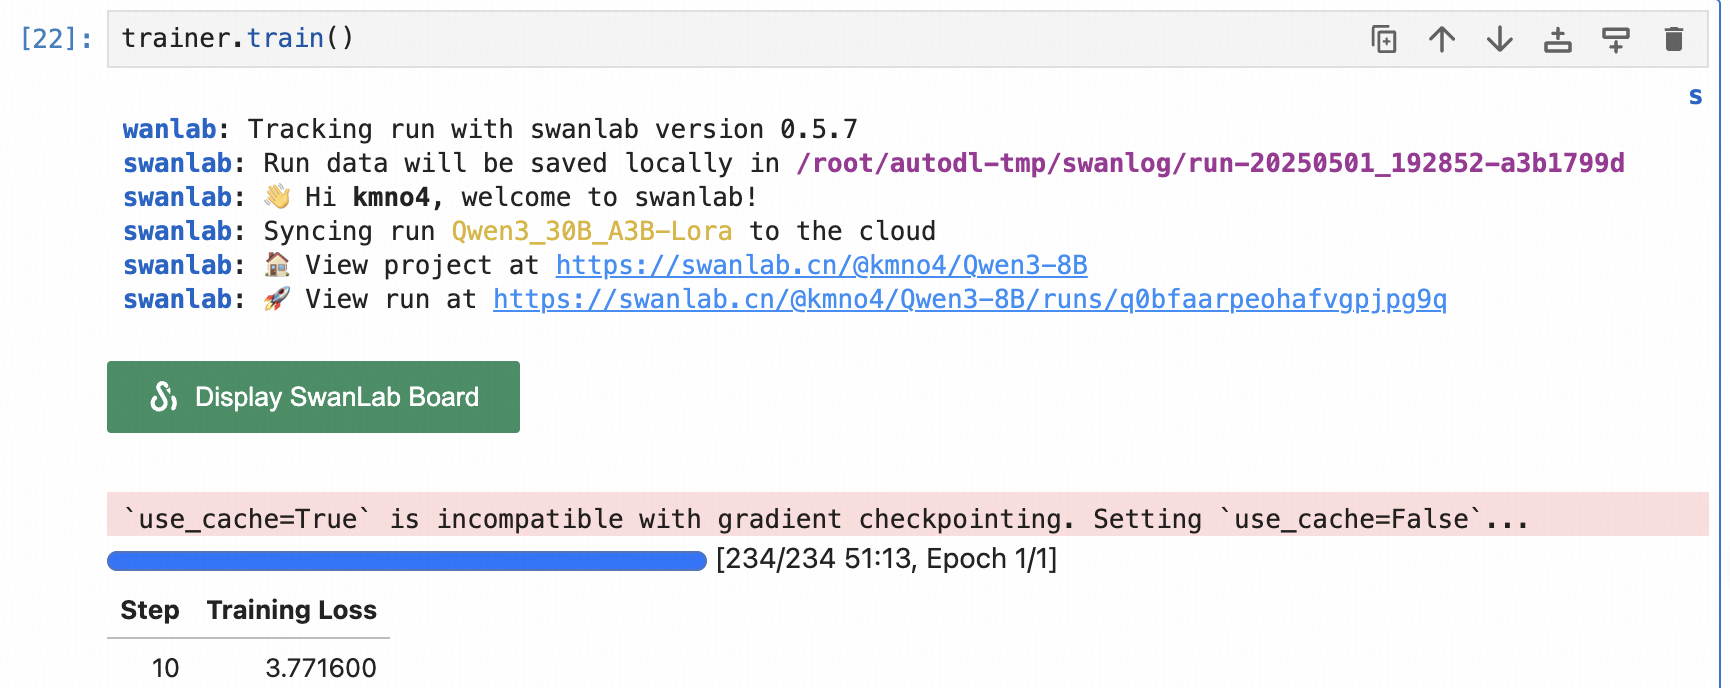
trainer.train() # 开始训练看到下面的进度条即代表训练开始:
- 训练结果演示
在 SwanLab 上查看最终的训练结果:
可以看到在 1 个 epoch 之后,微调后的 Qwen3-30B-A3B 的 loss 降低到了不错的水平。
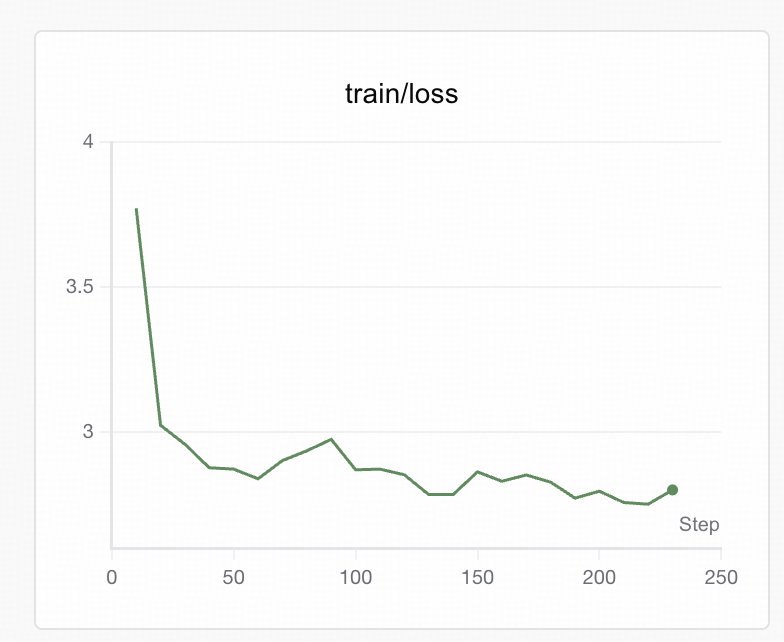
至此,你已经完成了 Qwen3-30B-A3B Lora 微调的训练!如果需要加强微调效果,可以尝试增加训练的数据量。
- 加载 LoRA 权重推理
训练好了之后可以使用如下方式加载 LoRA权重进行推理:
from transformers import AutoModelForCausalLM, AutoTokenizer
import torch
from peft import PeftModel

model_path = 'Qwen/Qwen3-30B-A3B'
lora_path = 'output/Qwen3_30B_A3B_lora/checkpoint-234' # 这里改称你的 lora 输出对应 checkpoint 地址

# 加载tokenizer
tokenizer = AutoTokenizer.from_pretrained(model_path, trust_remote_code=True)


# 加载模型
model = AutoModelForCausalLM.from_pretrained(model_path,
                                            device_map="auto",
                                            torch_dtype=torch.bfloat16,
                                            trust_remote_code=True).eval()

# 加载lora权重
model = PeftModel.from_pretrained(model, model_id=lora_path)
prompt = "你是谁?"
system_prompt = "现在你要扮演皇帝身边的女人--甄嬛"
print("prompt: ", prompt)
print("system_prompt: ", system_prompt)

inputs = tokenizer.apply_chat_template([{"role": "system", "content": system_prompt},
                                        {"role": "user", "content": prompt}],
                                       add_generation_prompt=True,
                                       tokenize=True,
                                       return_tensors="pt",
                                       return_dict=True
                                       ).to(model.device)  # 将 inputs 移动到模型所在的设备,确保设备一致性


gen_kwargs = {"max_length": 2500, "do_sample": True, "top_k": 1}
with torch.no_grad():
    outputs = model.generate(**inputs, **gen_kwargs)
    outputs = outputs[:, inputs['input_ids'].shape[1]:]
print(tokenizer.decode(outputs[0], skip_special_tokens=True))prompt: 你是谁?
system_prompt: 现在你要扮演皇帝身边的女人--甄嬛
我是甄嬛,家父是大理寺少卿甄远道。注意修改为自己的模型路径哦~
如果显示
Some parameters are on the meta device because they were offloaded to the cpu.的报错,需要将实例关机,重启后单独运行本条代码。
Qwen3 Think 解密
在本次 Qwen3 的更新中,支持多种思考模式可谓是核心亮点之一。Qwen3 既可以在思考模式下深思熟虑,也可以在非思考模式中提供快速的响应。更重要的是,这两种模式的结合增强了 Qwen3 实现稳定且高效的“思考预算”控制能力。如下图所示,随着思考预算分配的提升,模型在评测集上的得分也逐渐提升。这样一来,用户可以根据不同的任务难度分配不同的预算,从而在速度与性能之间实现更优的平衡。
那么,思考预算和思考模式切换都是如何实现的呢?
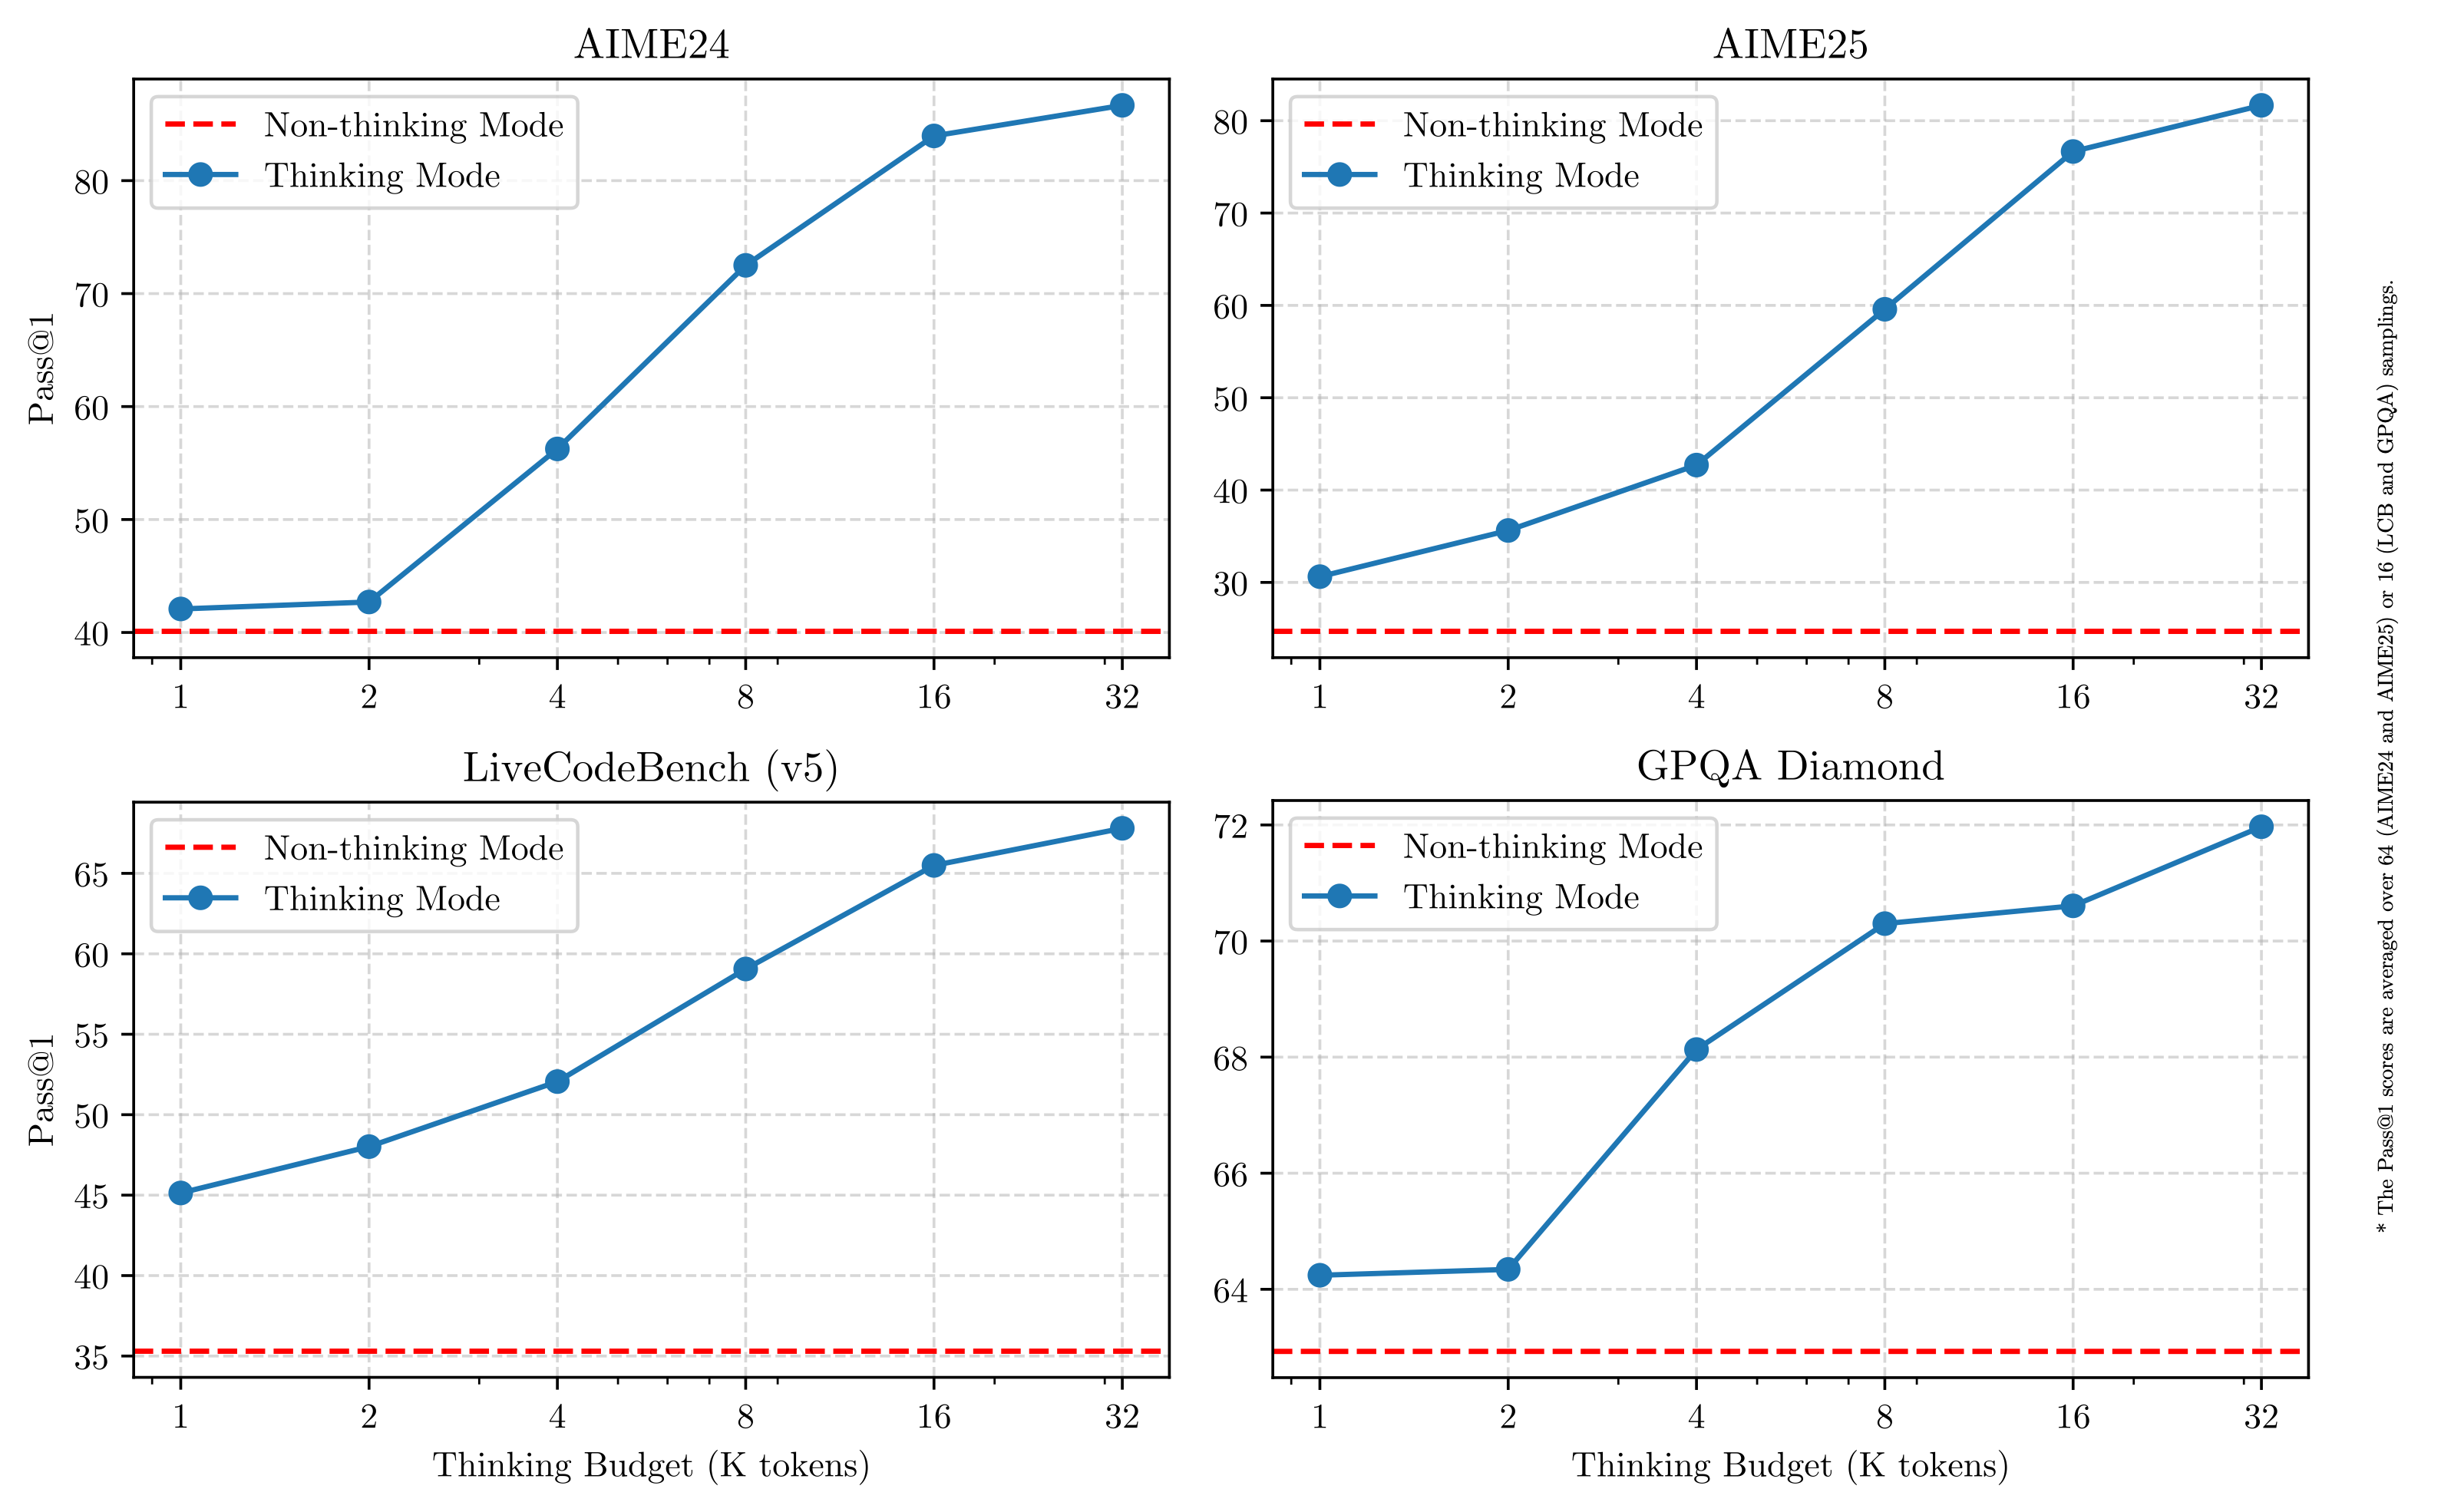
思考预算原理
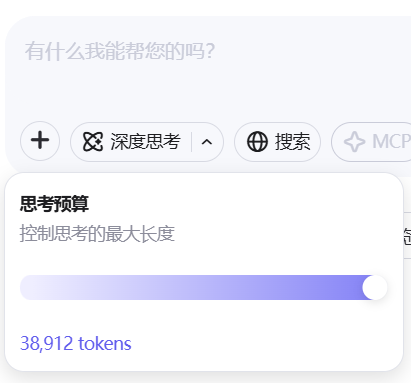
在 Qwen Chat 网页版 chat.qwen.ai 上,深度思考的思考预算是可调节的,粒度为 1024 tokens,最大可达 38912 tokens,也就是 38 * 1024 tokens,如下图所示。
那么,在解密思考预算调整的原理之前,我们先来看一个例子。下图展示了 Qwen3-235B-A22B 在 1024 tokens 的思考预算下回答问题的情况。(为了能让 Qwen3 可以思考到 1024 tokens 或者更多,这里使用了一个马尔科夫链的相关问题)
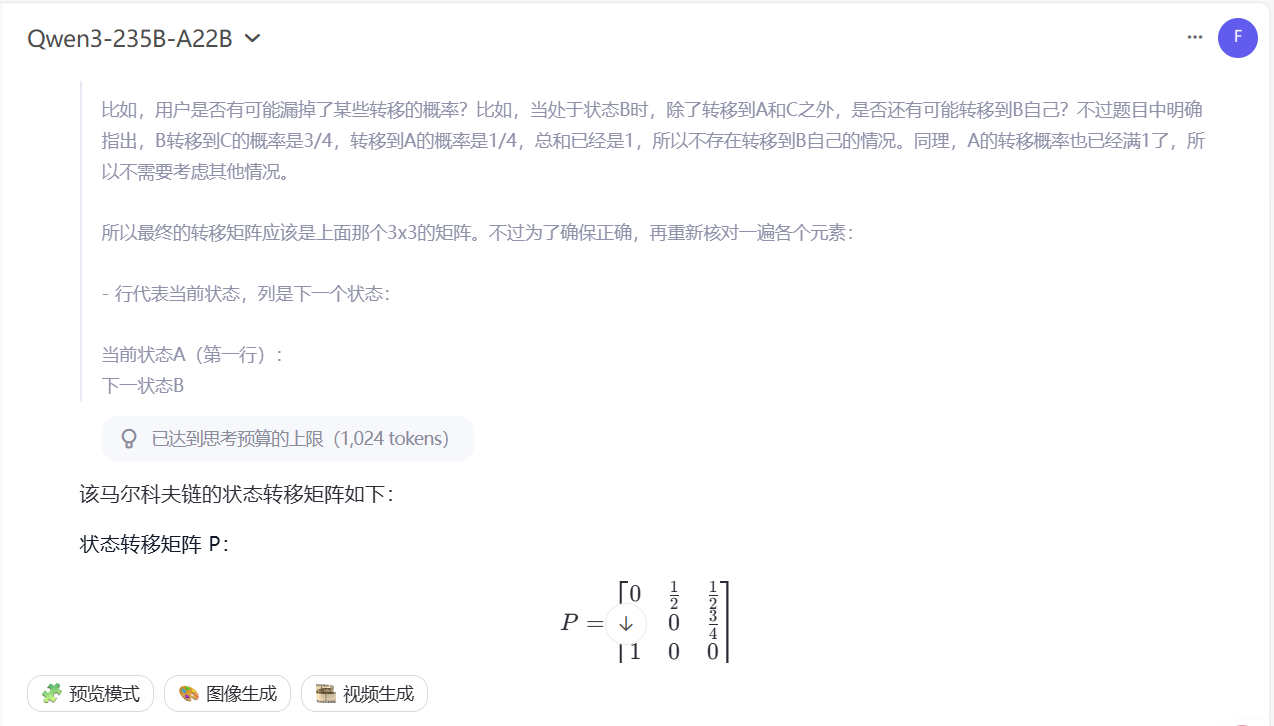
从上图中可以看到,Qwen3 在达到思考预算上限时,思考过程就戛然而止了。所以很难不让人相信,思考预算的实现原理就是,统计思考过程中的(\ 后) tokens 数量,达到思考预算上限时,立刻停止思考(强行截断停止),并补上 \,以进入输出阶段。
思考模式切换
最后是 Qwen3 思考模式切换的原理。这部分原理相对透明,可以在 Qwen3 的 tokenizer_config.json 中的 chat_template 中看到。下面展示了 Jinja 格式的 Qwen3 对话模板。
Jinja 格式 Qwen3 对话模板完整版
{%- if tools %}
    {{- '<|im_start|>system\n' }}
    {%- if messages[0].role == 'system' %}
        {{- messages[0].content + '\n\n' }}
    {%- endif %}
    {{- "# Tools\n\nYou may call one or more functions to assist with the user query.\n\nYou are provided with function signatures within <tools></tools> XML tags:\n<tools>" }}
    {%- for tool in tools %}
        {{- "\n" }}
        {{- tool | tojson }}
    {%- endfor %}
    {{- "\n</tools>\n\nFor each function call, return a json object with function name and arguments within <tool_call></tool_call> XML tags:\n<tool_call>\n{\"name\": <function-name>, \"arguments\": <args-json-object>}\n</tool_call><|im_end|>\n" }}
{%- else %}
    {%- if messages[0].role == 'system' %}
        {{- '<|im_start|>system\n' + messages[0].content + '<|im_end|>\n' }}
    {%- endif %}
{%- endif %}
{%- set ns = namespace(multi_step_tool=true, last_query_index=messages|length - 1) %}
{%- for message in messages[::-1] %}
    {%- set index = (messages|length - 1) - loop.index0 %}
    {%- if ns.multi_step_tool and message.role == "user" and not(message.content.startswith('<tool_response>') and message.content.endswith('</tool_response>')) %}
        {%- set ns.multi_step_tool = false %}
        {%- set ns.last_query_index = index %}
    {%- endif %}
{%- endfor %}
{%- for message in messages %}
    {%- if (message.role == "user") or (message.role == "system" and not loop.first) %}
        {{- '<|im_start|>' + message.role + '\n' + message.content + '<|im_end|>' + '\n' }}
    {%- elif message.role == "assistant" %}
        {%- set content = message.content %}
        {%- set reasoning_content = '' %}
        {%- if message.reasoning_content is defined and message.reasoning_content is not none %}
            {%- set reasoning_content = message.reasoning_content %}
        {%- else %}
            {%- if '</think>' in message.content %}
                {%- set content = message.content.split('</think>')[-1].lstrip('\n') %}
                {%- set reasoning_content = message.content.split('</think>')[0].rstrip('\n').split('<think>')[-1].lstrip('\n') %}
            {%- endif %}
        {%- endif %}
        {%- if loop.index0 > ns.last_query_index %}
            {%- if loop.last or (not loop.last and reasoning_content) %}
                {{- '<|im_start|>' + message.role + '\n<think>\n' + reasoning_content.strip('\n') + '\n</think>\n\n' + content.lstrip('\n') }}
            {%- else %}
                {{- '<|im_start|>' + message.role + '\n' + content }}
            {%- endif %}
        {%- else %}
            {{- '<|im_start|>' + message.role + '\n' + content }}
        {%- endif %}
        {%- if message.tool_calls %}
            {%- for tool_call in message.tool_calls %}
                {%- if (loop.first and content) or (not loop.first) %}
                    {{- '\n' }}
                {%- endif %}
                {%- if tool_call.function %}
                    {%- set tool_call = tool_call.function %}
                {%- endif %}
                {{- '<tool_call>\n{"name": "' }}
                {{- tool_call.name }}
                {{- '", "arguments": ' }}
                {%- if tool_call.arguments is string %}
                    {{- tool_call.arguments }}
                {%- else %}
                    {{- tool_call.arguments | tojson }}
                {%- endif %}
                {{- '}\n</tool_call>' }}
            {%- endfor %}
        {%- endif %}
        {{- '<|im_end|>\n' }}
    {%- elif message.role == "tool" %}
        {%- if loop.first or (messages[loop.index0 - 1].role != "tool") %}
            {{- '<|im_start|>user' }}
        {%- endif %}
        {{- '\n<tool_response>\n' }}
        {{- message.content }}
        {{- '\n</tool_response>' }}
        {%- if loop.last or (messages[loop.index0 + 1].role != "tool") %}
            {{- '<|im_end|>\n' }}
        {%- endif %}
    {%- endif %}
{%- endfor %}
{%- if add_generation_prompt %}
    {{- '<|im_start|>assistant\n' }}
    {%- if enable_thinking is defined and enable_thinking is false %}
        {{- '<think>\n\n</think>\n\n' }}
    {%- endif %}
{%- endif %}我们直接来看最后几行,也就是 add_generation_prompt 部分。
{%- if add_generation_prompt %}
    {{- '<|im_start|>assistant\n' }}
    {%- if enable_thinking is defined and enable_thinking is false %}
        {{- '<think>\n\n</think>\n\n' }}
    {%- endif %}
{%- endif %}上面就是 add_generation_prompt 部分的代码。可以看到,如果传入了 enable_thinking 并且为 false 的情况下,模型就会在 assistant\n 的后面再补上 \n\n\n\n 以让模型结束思考,直接进入输出阶段。
让我们再来看 QwQ 在 add_generation_prompt 时的行为,来更好地理解 Qwen3 的思考模式切换逻辑。
{%- if add_generation_prompt %}
    {{- '<|im_start|>assistant\n<think>\n\n' }}
{%- endif %}可以看到 QwQ 通过补上额外的 \ 来让模型强制进入思考阶段。而Qwen3 通过补上 \n\n\n\n 的方式告诉模型,思考阶段什么都没有,但是思考阶段已经结束了,需要进入最终输出阶段了,从而实现了思考模式切换。
大模型都这么厉害了,还需要微调吗?0.6B的小模型还有什么意义吗?
大家在日常使用Deepseek-R1或者是阿里新发布的Qwen3模型,他们的模型都是能力很强,所提供的API服也都可以满足大家的日常或者是公司开发所需。但大家也可以想一个简单的问题几个简单的问题,如下:
公司的数据是够敏感,是否需要保密?
日常使用大模型的任务是否很困难,对推理链是否刚需?
任务调用的大模型API并发量是多少?每日资金消耗有多少?
对于问题1,如果公司数据敏感,那我建议不要调用供应商提供的大模型API。就算供应商保证不会拿你们数据做训练,但你们的数据还是泄漏了(会有不必要的风险),建议本地部署大模型。
对于问题2,如果使用大模型的场景问题很困难并且刚需推理链,那可以使用供应商的API,这样可以保证推理链的上下文不会爆显存。如果问题很简单,没有刚需推理链,那建议本地部署小模型即可。
对于问题3,如果任务很简单,且调用的大模型API并发量很高,那我建议微调一个特定任务的小模型,本地部署。这样可以满足高并发,并且可以减少资金消耗。(本地部署,默认硬件环境单卡4090)
看到这里,想必大家已经思考完了以上三个问题,心中有了答案。那我给出一个小小的案例。
微调模型的需求性
假如你的公司有一个从投诉的文本中抽取用户信息的任务。比如,你需要从以下文本中抽取用户姓名、住址、邮箱、投诉的问题等等。
这只是一个小小的案例,数据也是我用大模型批量制造的。真正的投诉数据不会这么“干净、整洁”。
INPUT:
龙琳,宁夏回族自治区璐市城东林街g座 955491,邮箱 nafan@example.com。小区垃圾堆积成山,晚上噪音扰人清梦,停车难上加难,简直无法忍受!OUTPUT:
{
    "name": "龙琳",
    "address": "宁夏回族自治区璐市城东林街g座 955491",
    "email": "nafan@example.com",
    "question": "小区垃圾堆积成山,晚上噪音扰人清梦,停车难上加难,简直无法忍受!"
}那你当然可以调用 Deepseek最强大的模型R1,也可以调用阿里最新发布最强大的模型 Qwen3-235B-A22B等等,这些模型的信息抽取效果也很非常的棒。
但有个问题,如果你有几百万条这样的数据要处理,全部调用最新的,最好的大模型可能需要消耗几万块钱。并且,如果这些投诉数据,比如电信投诉数据,电网投诉数据,这些数据是敏感的不可以直接放到外网的。
所以,综合数据敏感,和资金消耗。最好的选择就是微调一个小模型(如Qwen3-0.6B),既可以保证高并发,可以保证数据不泄漏,保证模型抽取的效果,还可以省钱!!!
那下面,用一个小案例带大家实操一下,微调Qwen3-0.6B小模型完成文本信息抽取任务。
配置环境 下载数据
Colab 文件地址:https://colab.research.google.com/drive/18ByY11KVhIy6zWx1uKUjSzqeHTme-TtU?usp=drive_link
!pip install datasets swanlab -q!wget --no-check-certificate 'https://docs.google.com/uc?export=download&id=1a0sf5C209CLW5824TJkUM4olMy0zZWpg' -O fake_sft.json处理数据
from datasets import Dataset
import pandas as pd
from transformers import AutoTokenizer, AutoModelForCausalLM, DataCollatorForSeq2Seq, TrainingArguments, Trainer, GenerationConfig
from peft import LoraConfig, TaskType, get_peft_model
import torch# 将JSON文件转换为CSV文件
df = pd.read_json('fake_sft.json')
ds = Dataset.from_pandas(df)
ds[:3]model_id = "Qwen/Qwen3-0.6B"tokenizer = AutoTokenizer.from_pretrained(model_id, use_fast=False)
tokenizer对大语言模型进行 supervised-finetuning(sft,有监督微调)的数据格式如下:
{
  "instruction": "回答以下用户问题,仅输出答案。",
  "input": "1+1等于几?",
  "output": "2"
}其中,instruction 是用户指令,告知模型其需要完成的任务;input 是用户输入,是完成用户指令所必须的输入内容;output 是模型应该给出的输出。
有监督微调的目标是让模型具备理解并遵循用户指令的能力。因此,在构建数据集时,我们应针对我们的目标任务,针对性构建数据。比如,如果我们的目标是通过大量人物的对话数据微调得到一个能够 role-play 甄嬛对话风格的模型,因此在该场景下的数据示例如下:
{
  "instruction": "你父亲是谁?",
  "input": "",
  "output": "家父是大理寺少卿甄远道。"
}Qwen3 采用的 Chat Template格式如下:
由于 Qwen3 是混合推理模型,因此可以手动选择开启思考模式
不开启 thinking mode
messages = [
    {"role": "system", "content": "You are a helpful AI"},
    {"role": "user", "content": "How are you?"},
    {"role": "assistant", "content": "I'm fine, think you. and you?"},
]

text = tokenizer.apply_chat_template(
    messages,
    tokenize=False,
    add_generation_prompt=True,
    enable_thinking=False
)
print(text)<|im_start|>system
You are a helpful AI<|im_end|>
<|im_start|>user
How are you?<|im_end|>
<|im_start|>assistant
<think>
</think>
I'm fine, think you. and you?<|im_end|>
<|im_start|>assistant
<think>
</think>LoRA(Low-Rank Adaptation)训练的数据是需要经过格式化、编码之后再输入给模型进行训练的,我们需要先将输入文本编码为 input_ids,将输出文本编码为 labels,编码之后的结果是向量。我们首先定义一个预处理函数,这个函数用于对每一个样本,同时编码其输入、输出文本并返回一个编码后的字典:
def process_func(example):
    MAX_LENGTH = 1024 # 设置最大序列长度为1024个token
    input_ids, attention_mask, labels = [], [], [] # 初始化返回值
    # 适配chat_template
    instruction = tokenizer(
        f"<s><|im_start|>system\n{example['system']}<|im_end|>\n"
        f"<|im_start|>user\n{example['instruction'] + example['input']}<|im_end|>\n"
        f"<|im_start|>assistant\n<think>\n\n</think>\n\n",
        add_special_tokens=False
    )
    response = tokenizer(f"{example['output']}", add_special_tokens=False)
    # 将instructio部分和response部分的input_ids拼接,并在末尾添加eos token作为标记结束的token
    input_ids = instruction["input_ids"] + response["input_ids"] + [tokenizer.pad_token_id]
    # 注意力掩码,表示模型需要关注的位置
    attention_mask = instruction["attention_mask"] + response["attention_mask"] + [1]
    # 对于instruction,使用-100表示这些位置不计算loss(即模型不需要预测这部分)
    labels = [-100] * len(instruction["input_ids"]) + response["input_ids"] + [tokenizer.pad_token_id]
    if len(input_ids) > MAX_LENGTH:  # 超出最大序列长度截断
        input_ids = input_ids[:MAX_LENGTH]
        attention_mask = attention_mask[:MAX_LENGTH]
        labels = labels[:MAX_LENGTH]
    return {
        "input_ids": input_ids,
        "attention_mask": attention_mask,
        "labels": labels
}tokenized_id = ds.map(process_func, remove_columns=ds.column_names)
tokenized_idtokenizer.decode(tokenized_id[0]['input_ids'])tokenizer.decode(list(filter(lambda x: x != -100, tokenized_id[1]["labels"])))加载模型
加载模型并配置LoraConfig
model = AutoModelForCausalLM.from_pretrained(model_id, device_map="auto",torch_dtype=torch.bfloat16)
modelQwen3ForCausalLM(
(model): Qwen3Model(
(embed_tokens): Embedding(151936, 1024)
(layers): ModuleList(
(0-27): 28 x Qwen3DecoderLayer(
(self_attn): Qwen3Attention(
(q_proj): Linear(in_features=1024, out_features=2048, bias=False)
(k_proj): Linear(in_features=1024, out_features=1024, bias=False)
(v_proj): Linear(in_features=1024, out_features=1024, bias=False)
(o_proj): Linear(in_features=2048, out_features=1024, bias=False)
(q_norm): Qwen3RMSNorm((128,), eps=1e-06)
(k_norm): Qwen3RMSNorm((128,), eps=1e-06)
)
(mlp): Qwen3MLP(
(gate_proj): Linear(in_features=1024, out_features=3072, bias=False)
(up_proj): Linear(in_features=1024, out_features=3072, bias=False)
(down_proj): Linear(in_features=3072, out_features=1024, bias=False)
(act_fn): SiLU()
)
(input_layernorm): Qwen3RMSNorm((1024,), eps=1e-06)
(post_attention_layernorm): Qwen3RMSNorm((1024,), eps=1e-06)
)
)
(norm): Qwen3RMSNorm((1024,), eps=1e-06)
(rotary_emb): Qwen3RotaryEmbedding()
)
(lm_head): Linear(in_features=1024, out_features=151936, bias=False)
)model.enable_input_require_grads() # 开启梯度检查点时,要执行该方法Lora Config
LoraConfig这个类中可以设置很多参数,比较重要的如下
task_type:模型类型,现在绝大部分 decoder_only 的模型都是因果语言模型 CAUSAL_LM
target_modules:需要训练的模型层的名字,主要就是 attention部分的层,不同的模型对应的层的名字不同
r:LoRA 的秩,决定了低秩矩阵的维度,较小的 r 意味着更少的参数
lora_alpha:缩放参数,与 r 一起决定了 LoRA 更新的强度。实际缩放比例为lora_alpha/r,在当前示例中是 32 / 8 = 4 倍
lora_dropout:应用于 LoRA 层的 dropout rate,用于防止过拟合
from peft import LoraConfig, TaskType, get_peft_model

config = LoraConfig(
    task_type=TaskType.CAUSAL_LM,
    target_modules=["q_proj", "k_proj", "v_proj", "o_proj", "gate_proj", "up_proj", "down_proj"],
    inference_mode=False, # 训练模式
    r=8, # Lora 秩
    lora_alpha=32, # Lora alaph,具体作用参见 Lora 原理
    lora_dropout=0.1# Dropout 比例
)
configmodel = get_peft_model(model, config)
configmodel.print_trainable_parameters() # 模型参数训练量只有0.8395%trainable params: 5,046,272 || all params: 601,096,192 || trainable%: 0.8395
Training Arguments
output_dir:模型的输出路径
per_device_train_batch_size:每张卡上的 batch_size
gradient_accumulation_steps: 梯度累计
num_train_epochs:顾名思义 epoch
args = TrainingArguments(
    output_dir="Qwen3_instruct_lora",
    per_device_train_batch_size=4,
    gradient_accumulation_steps=4,
    logging_steps=1,
    num_train_epochs=3,
    save_steps=50,
    learning_rate=1e-4,
    save_on_each_node=True,
    gradient_checkpointing=True,
    report_to="none",
)SwanLab 简介
SwanLab 是一个开源的模型训练记录工具,面向 AI 研究者,提供了训练可视化、自动日志记录、超参数记录、实验对比、多人协同等功能。在 SwanLab 上,研究者能基于直观的可视化图表发现训练问题,对比多个实验找到研究灵感,并通过在线链接的分享与基于组织的多人协同训练,打破团队沟通的壁垒。
为什么要记录训练
相较于软件开发,模型训练更像一个实验科学。一个品质优秀的模型背后,往往是成千上万次实验。研究者需要不断尝试、记录、对比,积累经验,才能找到最佳的模型结构、超参数与数据配比。在这之中,如何高效进行记录与对比,对于研究效率的提升至关重要。
(2) Use an existing SwanLab account 并使用 private API Key 登录
import swanlab
from swanlab.integration.transformers import SwanLabCallback

# 实例化SwanLabCallback
swanlab_callback = SwanLabCallback(
    project="Qwen3-Lora",  # 注意修改
    experiment_name="Qwen3-8B-LoRA-experiment"  # 注意修改
)import swanlab
from swanlab.integration.transformers import SwanLabCallback
# 实例化SwanLabCallback
swanlab_callback = SwanLabCallback(
project="Qwen3-Lora",
experiment_name="Qwen3-0.6B-extarct-lora-2"
)trainer = Trainer(
model=model,
args=args,
train_dataset=tokenized_id,
data_collator=DataCollatorForSeq2Seq(tokenizer=tokenizer, padding=True),
callbacks=[swanlab_callback]
)trainer.train()测试文本
prompt = "龙琳   ,宁夏回族自治区璐市城东林街g座 955491,nafan@example.com。小区垃圾堆积成山,晚上噪音扰人清梦,停车难上加难,简直无法忍受!太插件了阿萨德看见啊啥的健康仨都会撒娇看到撒谎的、"

messages = [
    {"role": "system", "content": "将文本中的name、address、email、question提取出来,以json格式输出,字段为name、address、email、question,值为文本中提取出来的内容。"},
    {"role": "user", "content": prompt}
]

inputs = tokenizer.apply_chat_template(messages,
                                       add_generation_prompt=True,
                                       tokenize=True,
                                       return_tensors="pt",
                                       return_dict=True,
                                       enable_thinking=False).to('cuda')

gen_kwargs = {"max_length": 2500, "do_sample": True, "top_k": 1}
with torch.no_grad():
    outputs = model.generate(**inputs, **gen_kwargs)
    outputs = outputs[:, inputs['input_ids'].shape[1]:]
print(tokenizer.decode(outputs[0], skip_special_tokens=True)){
"name": "龙琳",
"address": "宁夏回族自治区璐市城东林街g座 955491",
"email": "nafan@example.com",
"question": "小区垃圾堆积成山,晚上噪音扰人清梦,停车难上加难,简直无法忍受!太插件了阿萨德看见啊啥的健康仨都会撒娇看到撒谎的、"
}09-Qwen3-1.7B-医学推理式对话微调 及 SwanLab 可视化记录
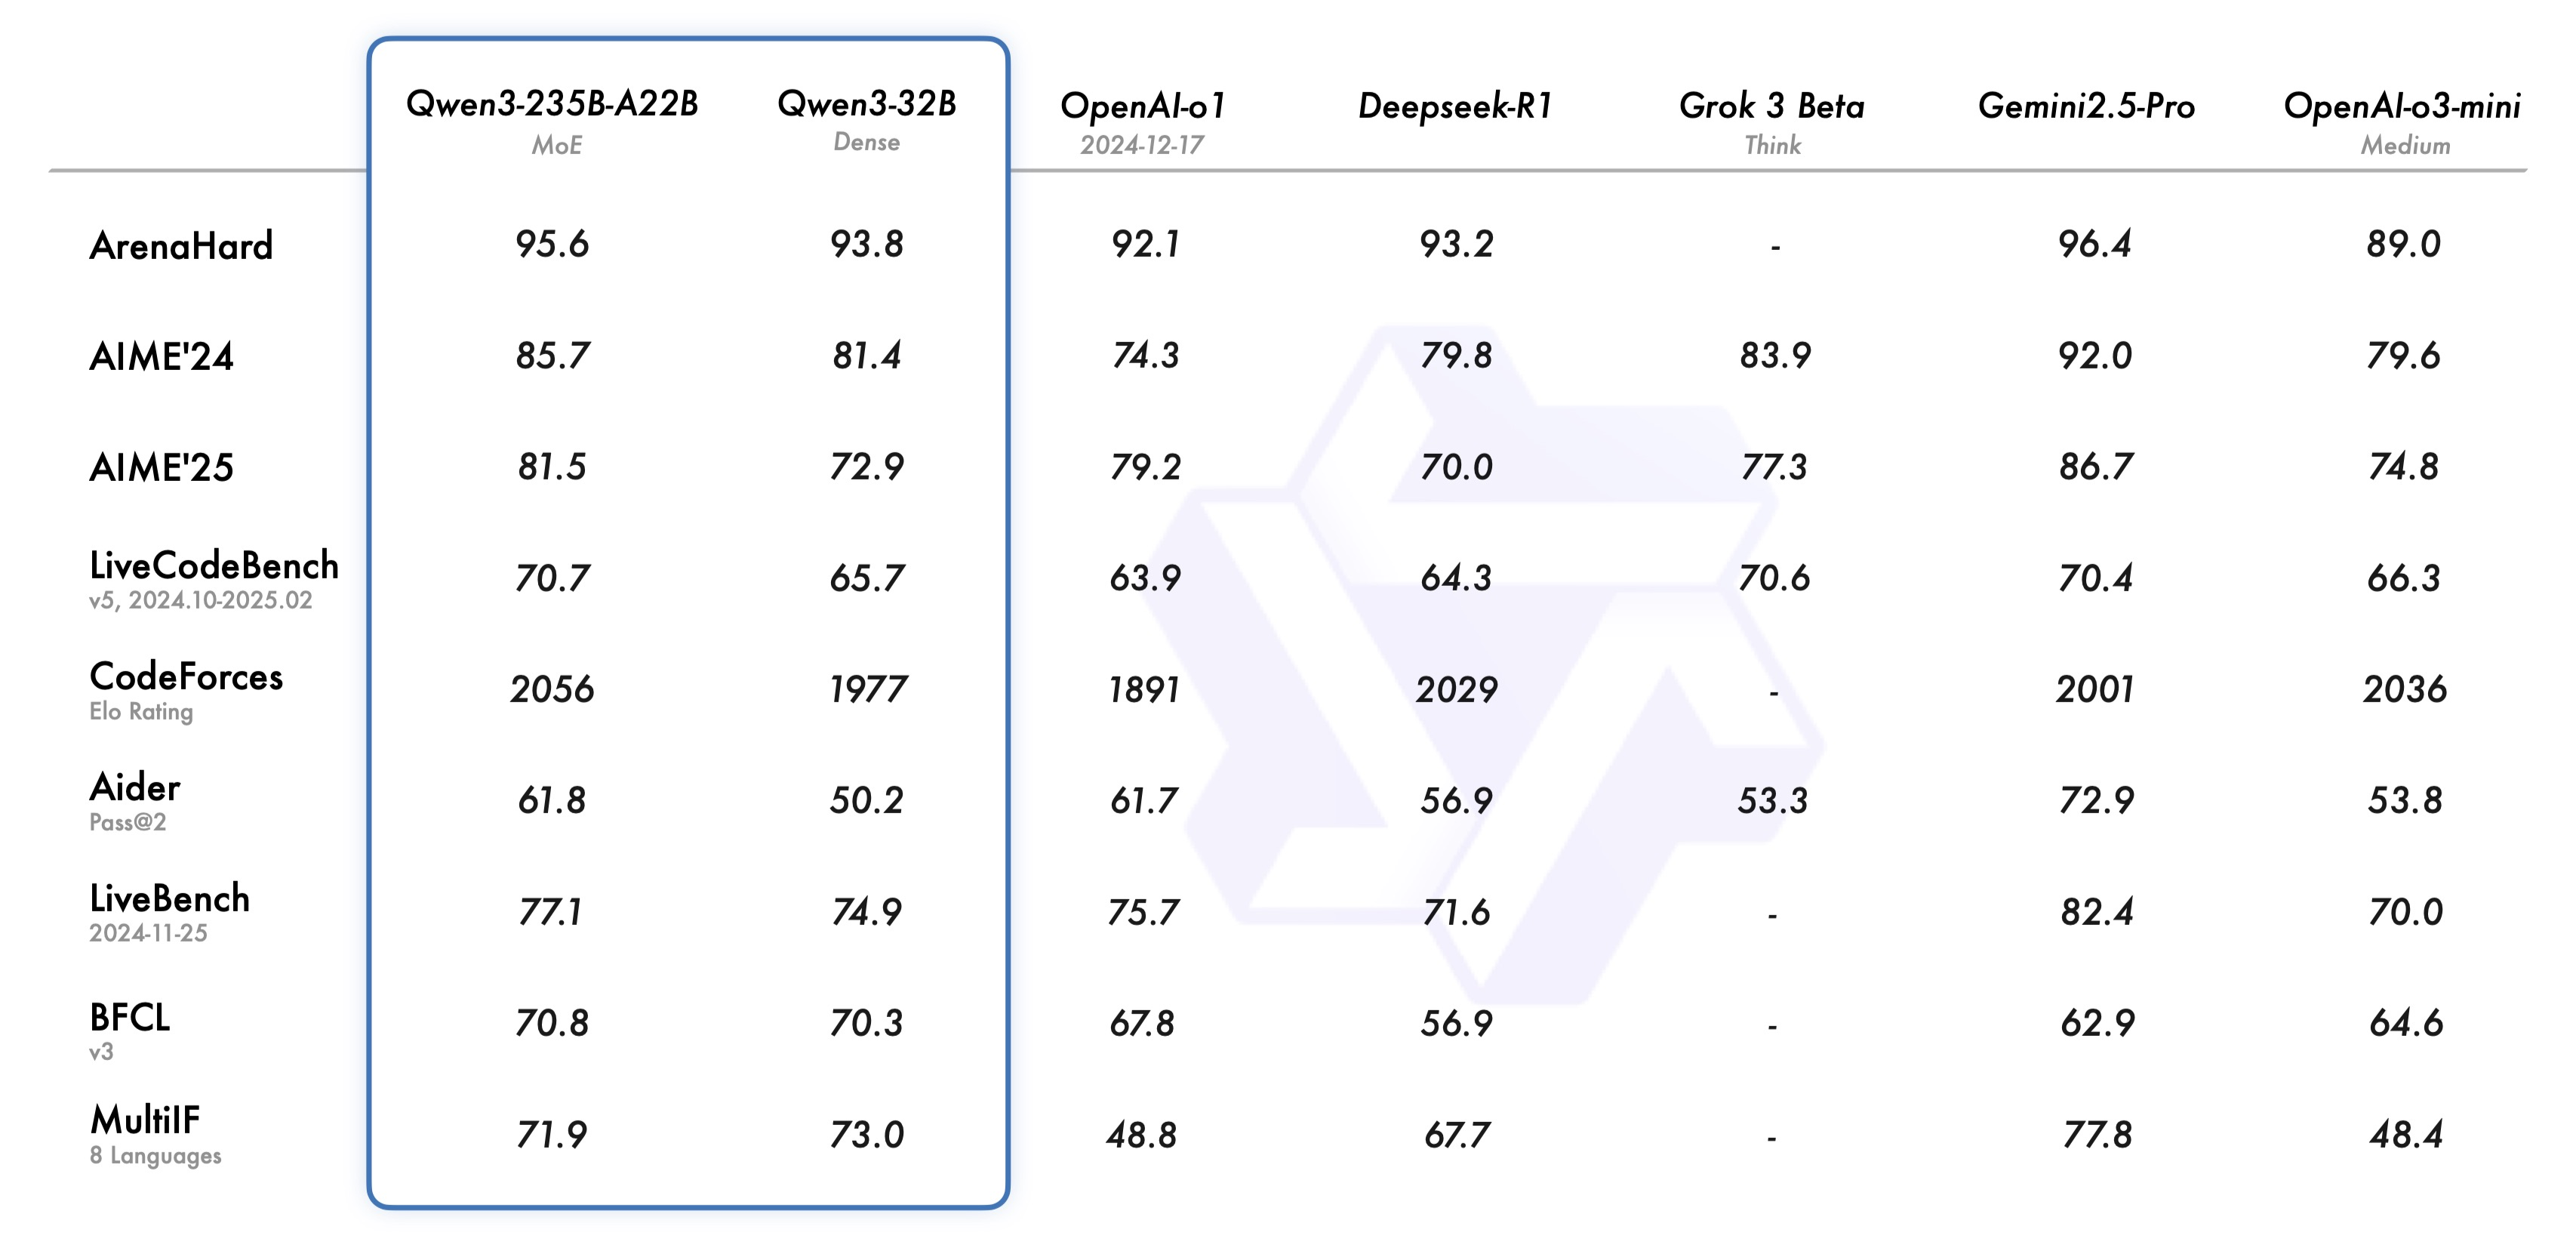
可以说,不论是进行研究学习,还是应用落地,Qwen已经逐渐成为开发者的最优选项之一。
那么,以Qwen3作为基座大模型,通过全参数微调的方式,实现垂直专业领域聊天,甚至支持DeepSeek R1 / QwQ式的带推理过程的对话,是学习LLM微调的入门任务。
在本文中,我们会使用 Qwen3-1.7b 模型在 delicate_medical_r1_data 数据集上做全参数微调训练,实现让微调后的Qwen3支持对医学问题进行DeepSeek R1式的推理回复。训练中用到了transformers、datasets等工具,同时使用SwanLab监控训练过程、评估模型效果。
全参数微调需要大约32GB显存,如果你的显存大小不足,可以使用Qwen3-0.6b,或Lora微调。
代码:完整代码直接看本文第5节
实验日志过程:qwen3-1.7B-linear - SwanLab,或 SwanLab基线社区 搜索“qwen3-sft-medical”
模型:Modelscope
数据集:delicate_medical_r1_data
SwanLab:https://swanlab.cn
知识点:什么是全参数微调?
大模型全参数微调是指对预训练大模型的所有参数进行更新和优化,区别于部分参数微调和LoRA微调。
这种方法通过将整个模型权重(包括底层词嵌入、中间特征提取层和顶层任务适配层)在下游任务数据上进行梯度反向传播,使模型整体适应新任务的需求。相比仅微调部分参数,全参数微调能更充分地利用预训练模型的泛化能力,并针对特定任务进行深度适配,通常在数据差异较大或任务复杂度较高的场景下表现更优。
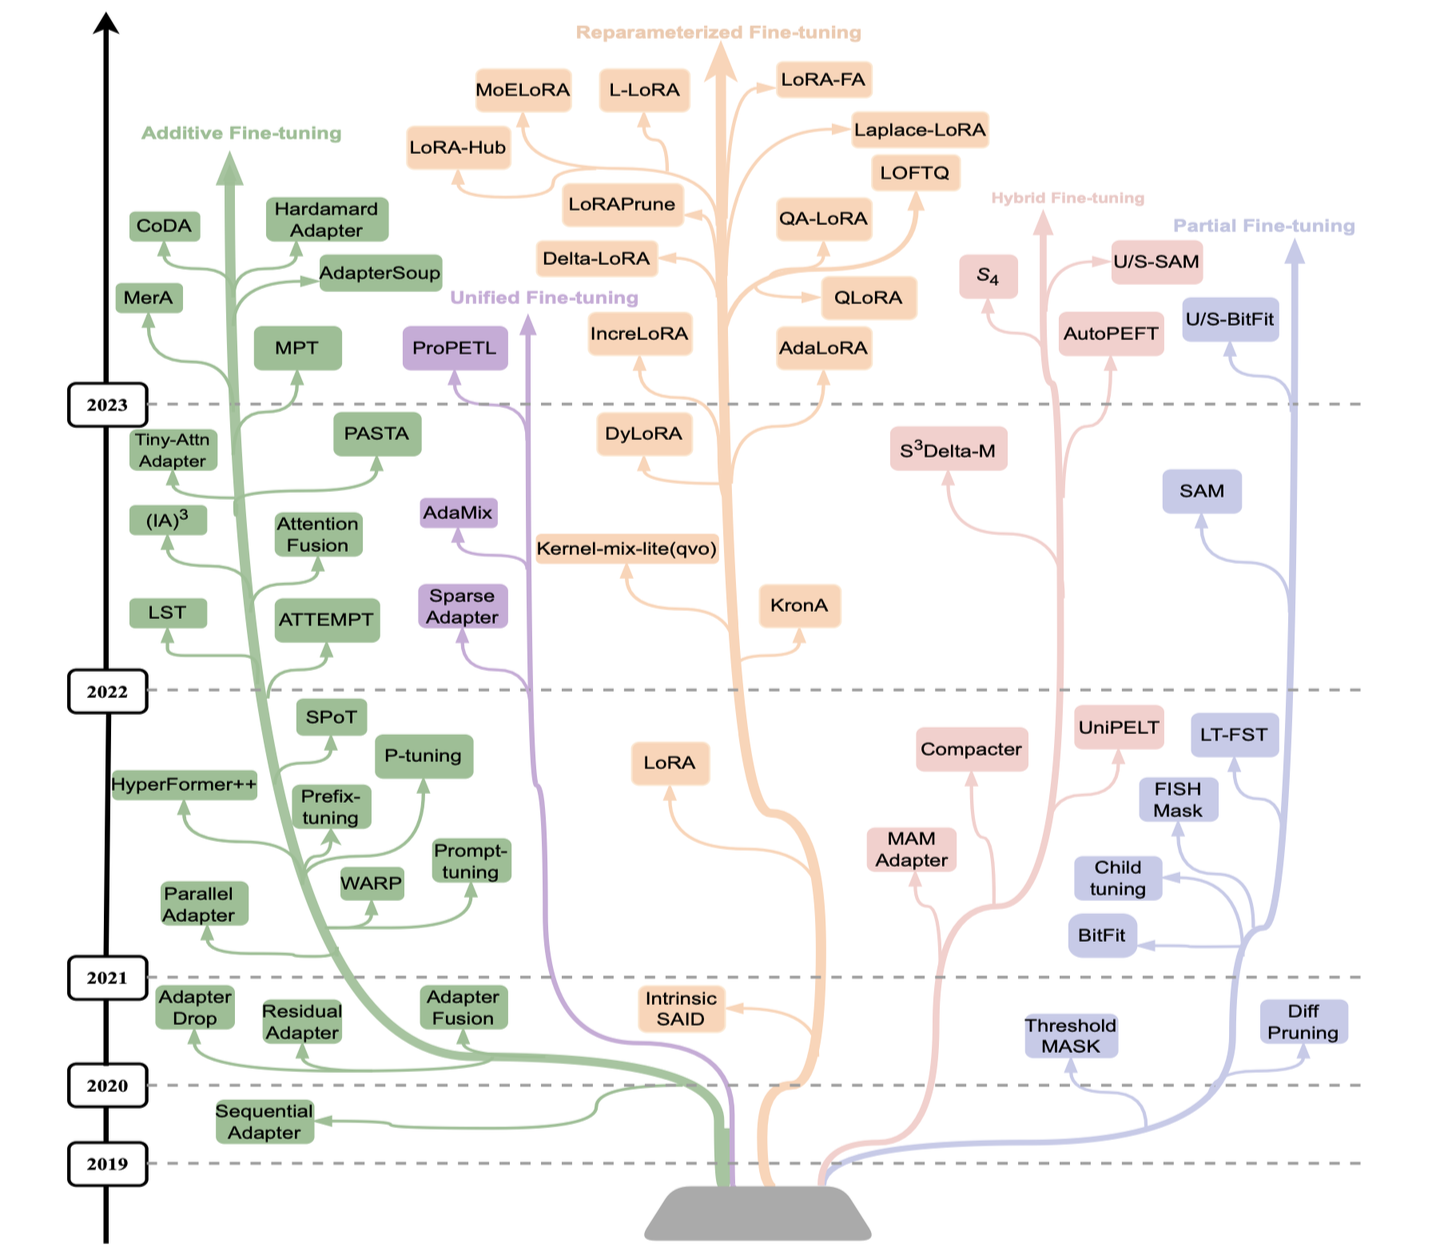
不过,全参数微调往往需要更高的计算资源和存储开销,且存在过拟合风险(尤其在小数据集上)。实际应用中常结合学习率调整、参数分组优化或正则化技术来缓解这些问题。
全参数微调多用于对模型表现性能要求较高的场景,例如专业领域知识问答或高精度文本生成。
更多微调技术可参考:https://zhuanlan.zhihu.com/p/682082440
下面是实战正片:
- 环境安装
本案例基于Python>=3.8,请在您的计算机上安装好Python;
另外,您的计算机上至少要有一张英伟达/昇腾显卡(显存要求大概32GB左右可以跑)。
我们需要安装以下这几个Python库,在这之前,请确保你的环境内已安装了pytorch以及CUDA:
swanlab
modelscope==1.22.0
transformers>=4.50.0
datasets==3.2.0
accelerate
pandas
addict一键安装命令:
pip install swanlab modelscope==1.22.0 "transformers>=4.50.0" datasets==3.2.0 accelerate pandas addict本案例测试于modelscope==1.22.0、transformers==4.51.3、datasets==3.2.0、peft==0.11.1、accelerate==1.6.0、swanlab==0.5.7
- 准备数据集
该数据集由2000多条数据组成,每条数据包含Instruction、question、think、answer、metrics六列:

这里我们只取question、think、answer这三列:
question:用户提出的问题,即模型的输入
think:模型的思考过程。大家如果用过DeepSeek R1的话,回复中最开始的思考过程就是这个。
answer:模型思考完成后,回复的内容。
我们的训练任务,便是希望微调后的大模型,能够根据question,给用户一个think+answer的组合回复,并且think和answer直接在网页展示上是有区分的。
理清需求后,我们设计这样一个数据集样例:
{
"question": "我父亲刚刚被诊断为活动性出血,医生说需要立即处理,我们该怎么做?",
"think": "嗯,用户的问题是关于病人出现活动性出血时应采取哪些一般处理措施,...",
"answer": "首先,您父亲需要卧床休息,活动性出血期间暂时不要进食。为了...",
}在训练代码执行时,会将think和answer按下面这样的格式组合成一条完整回复:
<think>
嗯,用户的问题是关于病人出现活动性出血时应采取哪些一般处理措施,...
</think>

首先,您父亲需要卧床休息,活动性出血期间暂时不要进食。为了...接下来我们来下载数据集,并进行必要的格式转换。
这个流程非常简单,执行下面的代码即可:
from modelscope.msdatasets import MsDataset
import json
import random

random.seed(42)

ds = MsDataset.load('krisfu/delicate_medical_r1_data', subset_name='default', split='train')
data_list = list(ds)
random.shuffle(data_list)

split_idx = int(len(data_list) * 0.9)

train_data = data_list[:split_idx]
val_data = data_list[split_idx:]

with open('train.jsonl', 'w', encoding='utf-8') as f:
    for item in train_data:
        json.dump(item, f, ensure_ascii=False)
        f.write('\n')

with open('val.jsonl', 'w', encoding='utf-8') as f:
    for item in val_data:
        json.dump(item, f, ensure_ascii=False)
        f.write('\n')

print(f"The dataset has been split successfully.")
print(f"Train Set Size:{len(train_data)}")
print(f"Val Set Size:{len(val_data)}")完成后,你的代码目录下会出现训练集train.jsonl和验证集val.jsonl文件。
至此,数据集部分完成。
- 加载模型
这里我们使用modelscope下载Qwen3-1.7B模型(modelscope在国内,所以下载不用担心速度和稳定性问题),然后把它加载到Transformers中进行训练:
from modelscope import snapshot_download, AutoTokenizer
from transformers import AutoModelForCausalLM, TrainingArguments, Trainer, DataCollatorForSeq2Seq

# 在modelscope上下载Qwen模型到本地目录下
model_dir = snapshot_download("Qwen/Qwen3-1.7B", cache_dir="./", revision="master")

# Transformers加载模型权重
tokenizer = AutoTokenizer.from_pretrained("./Qwen/Qwen3-1.7B", use_fast=False, trust_remote_code=True)
model = AutoModelForCausalLM.from_pretrained("./Qwen/Qwen3-1.7B", device_map="auto", torch_dtype=torch.bfloat16)
- 配置训练可视化工具
我们使用SwanLab来监控整个训练过程,并评估最终的模型效果。
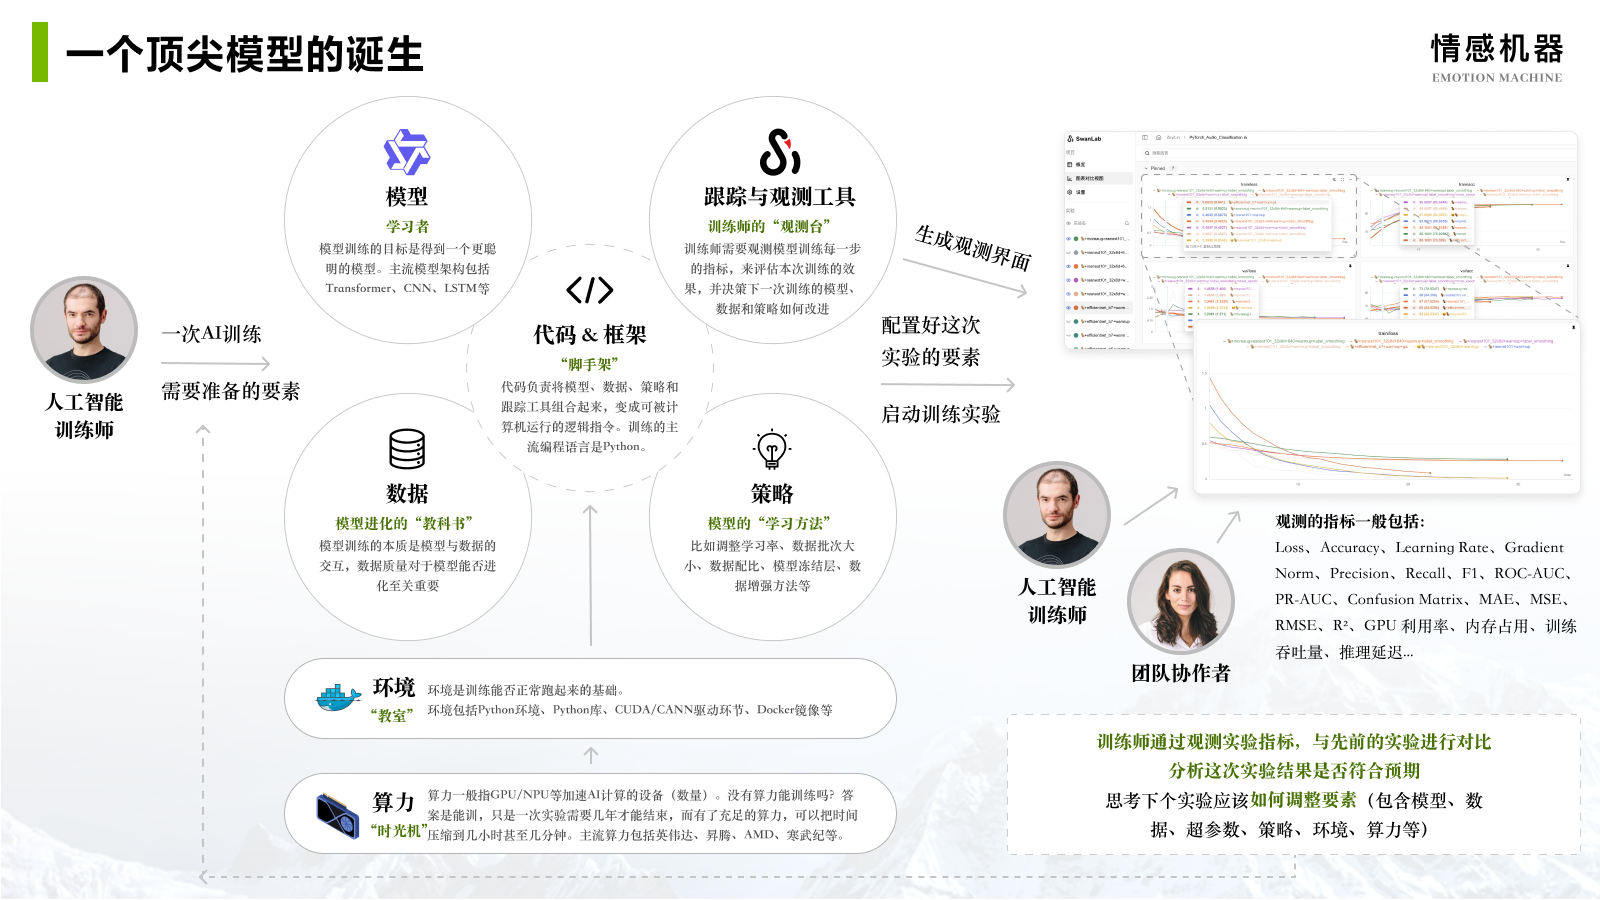
SwanLab 是一款开源、轻量的 AI 模型训练跟踪与可视化工具,面向人工智能与深度学习开发者,提供了一个跟踪、记录、比较、和协作实验的平台,常被称为"中国版 Weights & Biases + Tensorboard"。SwanLab同时支持云端和离线使用,并适配了从PyTorch、Transformers、Lightning再到LLaMA Factory、veRL等30+ AI训练框架。
from transformers import TrainingArguments, Trainer

args = TrainingArguments(
    ...,
    report_to="swanlab",
    run_name="qwen3-1.7B",
)

trainer = Trainer(..., args=args)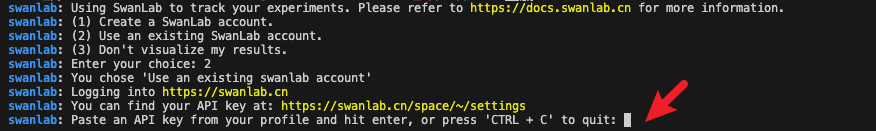
- 完整代码
开始训练时的目录结构:
|--- train.py
|--- train.jsonl
|--- val.jsonltrain.py:
import json
import pandas as pd
import torch
from datasets import Dataset
from modelscope import snapshot_download, AutoTokenizer
from transformers import AutoModelForCausalLM, TrainingArguments, Trainer, DataCollatorForSeq2Seq
import os
import swanlab

os.environ["SWANLAB_PROJECT"]="qwen3-sft-medical"
PROMPT = "你是一个医学专家,你需要根据用户的问题,给出带有思考的回答。"
MAX_LENGTH = 2048

swanlab.config.update({
    "model": "Qwen/Qwen3-1.7B",
    "prompt": PROMPT,
    "data_max_length": MAX_LENGTH,
    })

def dataset_jsonl_transfer(origin_path, new_path):
    """
    将原始数据集转换为大模型微调所需数据格式的新数据集
    """
    messages = []

    # 读取旧的JSONL文件
    with open(origin_path, "r") as file:
        for line in file:
            # 解析每一行的json数据
            data = json.loads(line)
            input = data["question"]
            output = f"<think>{data["think"]}</think> \n {data["answer"]}"
            message = {
                "instruction": PROMPT,
                "input": f"{input}",
                "output": output,
            }
            messages.append(message)

    # 保存重构后的JSONL文件
    with open(new_path, "w", encoding="utf-8") as file:
        for message in messages:
            file.write(json.dumps(message, ensure_ascii=False) + "\n")

def process_func(example):
    """
    将数据集进行预处理
    """
    input_ids, attention_mask, labels = [], [], []
    instruction = tokenizer(
        f"<|im_start|>system\n{PROMPT}<|im_end|>\n<|im_start|>user\n{example['input']}<|im_end|>\n<|im_start|>assistant\n",
        add_special_tokens=False,
    )
    response = tokenizer(f"{example['output']}", add_special_tokens=False)
    input_ids = instruction["input_ids"] + response["input_ids"] + [tokenizer.pad_token_id]
    attention_mask = (
        instruction["attention_mask"] + response["attention_mask"] + [1]
    )
    labels = [-100] * len(instruction["input_ids"]) + response["input_ids"] + [tokenizer.pad_token_id]
    if len(input_ids) > MAX_LENGTH:  # 做一个截断
        input_ids = input_ids[:MAX_LENGTH]
        attention_mask = attention_mask[:MAX_LENGTH]
        labels = labels[:MAX_LENGTH]
    return {"input_ids": input_ids, "attention_mask": attention_mask, "labels": labels}

def predict(messages, model, tokenizer):
    device = "cuda"
    text = tokenizer.apply_chat_template(
        messages,
        tokenize=False,
        add_generation_prompt=True
    )
    model_inputs = tokenizer([text], return_tensors="pt").to(device)

    generated_ids = model.generate(
        model_inputs.input_ids,
        max_new_tokens=MAX_LENGTH,
    )
    generated_ids = [
        output_ids[len(input_ids):] for input_ids, output_ids in zip(model_inputs.input_ids, generated_ids)
    ]

    response = tokenizer.batch_decode(generated_ids, skip_special_tokens=True)[0]

    return response

# 在modelscope上下载Qwen模型到本地目录下
model_dir = snapshot_download("Qwen/Qwen3-1.7B", cache_dir="/root/autodl-tmp/", revision="master")

# Transformers加载模型权重
tokenizer = AutoTokenizer.from_pretrained("/root/autodl-tmp/Qwen/Qwen3-1.7B", use_fast=False, trust_remote_code=True)
model = AutoModelForCausalLM.from_pretrained("/root/autodl-tmp/Qwen/Qwen3-1.7B", device_map="auto", torch_dtype=torch.bfloat16)
model.enable_input_require_grads()  # 开启梯度检查点时,要执行该方法

# 加载、处理数据集和测试集
train_dataset_path = "train.jsonl"
test_dataset_path = "val.jsonl"

train_jsonl_new_path = "train_format.jsonl"
test_jsonl_new_path = "val_format.jsonl"

if not os.path.exists(train_jsonl_new_path):
    dataset_jsonl_transfer(train_dataset_path, train_jsonl_new_path)
if not os.path.exists(test_jsonl_new_path):
    dataset_jsonl_transfer(test_dataset_path, test_jsonl_new_path)

# 得到训练集
train_df = pd.read_json(train_jsonl_new_path, lines=True)
train_ds = Dataset.from_pandas(train_df)
train_dataset = train_ds.map(process_func, remove_columns=train_ds.column_names)

# 得到验证集
eval_df = pd.read_json(test_jsonl_new_path, lines=True)
eval_ds = Dataset.from_pandas(eval_df)
eval_dataset = eval_ds.map(process_func, remove_columns=eval_ds.column_names)

args = TrainingArguments(
    output_dir="/root/autodl-tmp/output/Qwen3-1.7B",
    per_device_train_batch_size=1,
    per_device_eval_batch_size=1,
    gradient_accumulation_steps=4,
    eval_strategy="steps",
    eval_steps=100,
    logging_steps=10,
    num_train_epochs=2,
    save_steps=400,
    learning_rate=1e-4,
    save_on_each_node=True,
    gradient_checkpointing=True,
    report_to="swanlab",
    run_name="qwen3-1.7B",
)

trainer = Trainer(
    model=model,
    args=args,
    train_dataset=train_dataset,
    eval_dataset=eval_dataset,
    data_collator=DataCollatorForSeq2Seq(tokenizer=tokenizer, padding=True),
)

trainer.train()

# 用测试集的前3条,主观看模型
test_df = pd.read_json(test_jsonl_new_path, lines=True)[:3]

test_text_list = []

for index, row in test_df.iterrows():
    instruction = row['instruction']
    input_value = row['input']

    messages = [
        {"role": "system", "content": f"{instruction}"},
        {"role": "user", "content": f"{input_value}"}
    ]

    response = predict(messages, model, tokenizer)

    response_text = f"""
    Question: {input_value}

    LLM:{response}
    """

    test_text_list.append(swanlab.Text(response_text))
    print(response_text)

swanlab.log({"Prediction": test_text_list})

swanlab.finish()看到下面的进度条即代表训练开始:
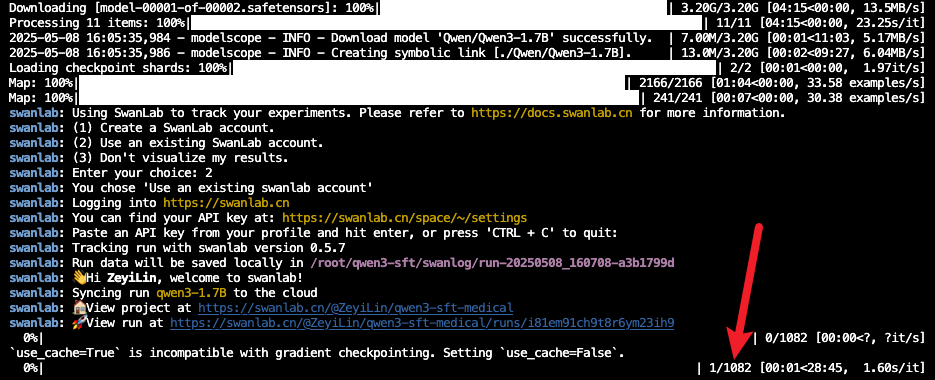
- 训练结果演示
在SwanLab上查看最终的训练结果:
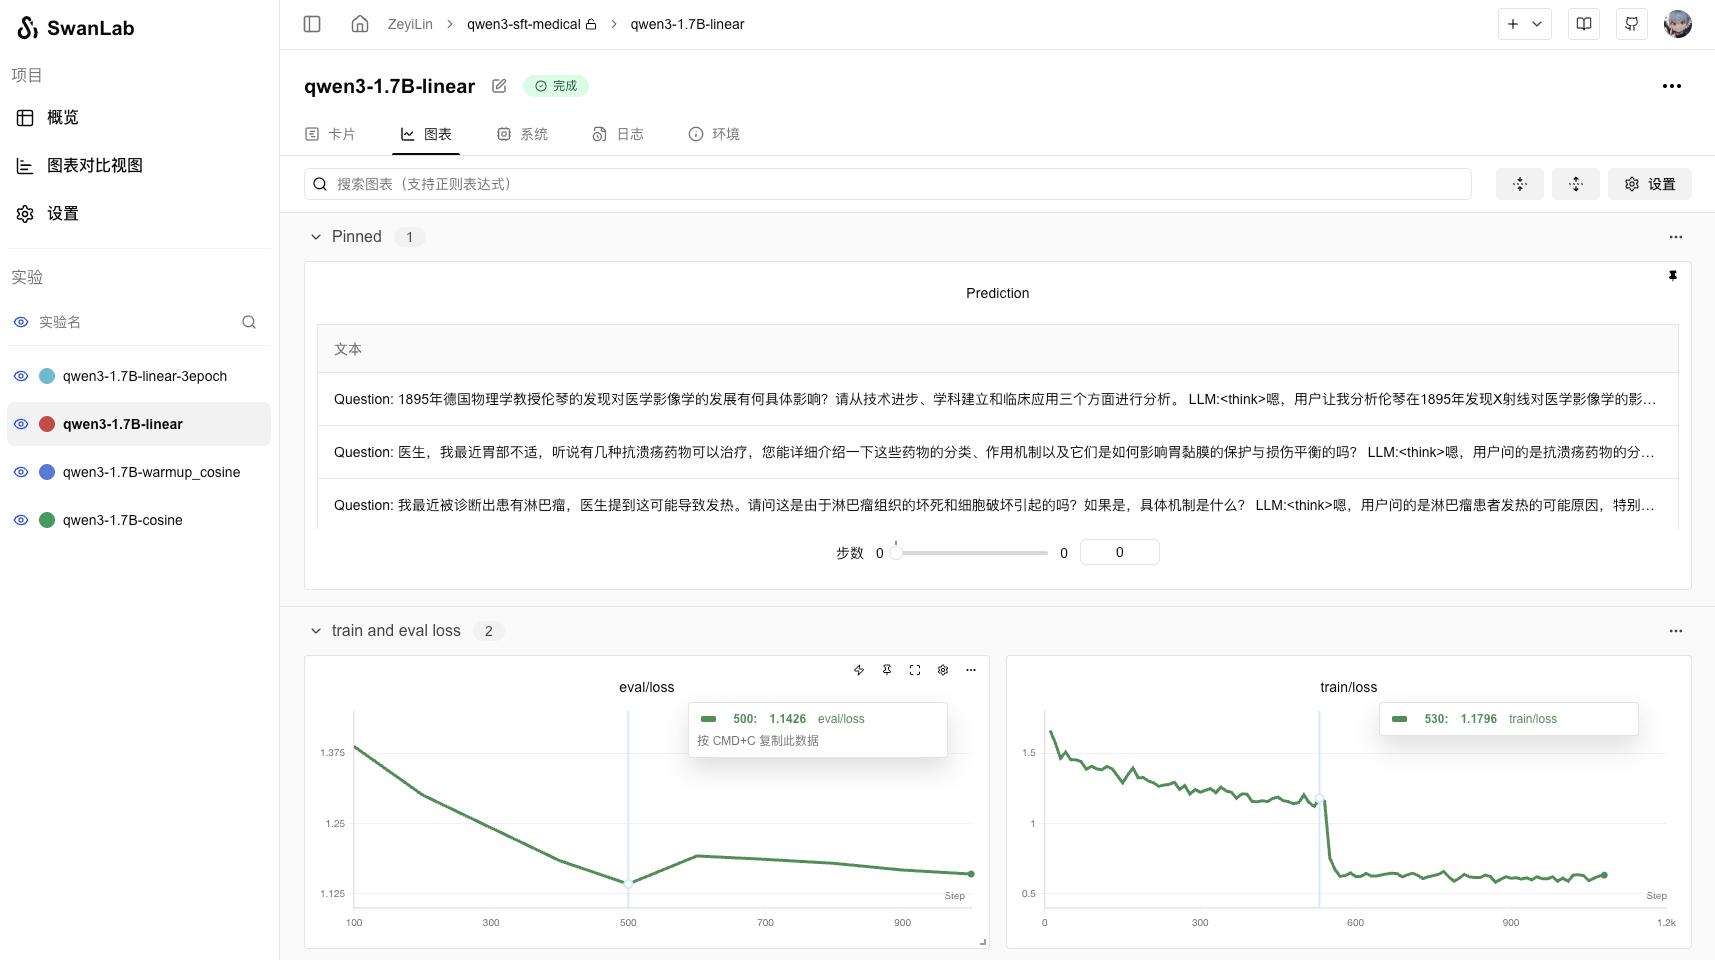
可以看到核心要关注的指标有train loss和eval loss,同时还有在训练完成时记录的3条LLM生成测试结果。
让我们分析一下吧!使用「创建折线图」功能,把train loss和eval loss放到一张图上:
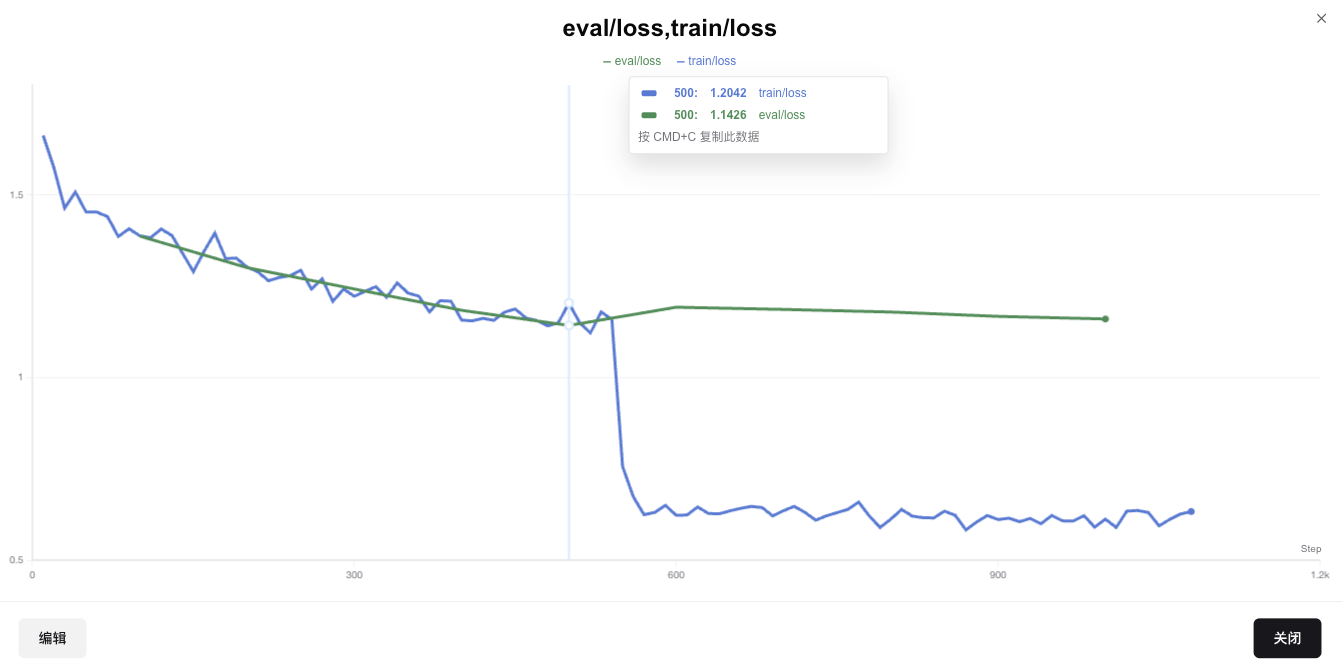
蓝色的是train loss,绿色的式eval loss,可以看到发生了经典的过拟合现象:train loss会在epoch的交替阶段,阶梯式下降;而val loss在第1轮epoch是下降的,但是第二轮反而上升了,符合机器学习中经典过拟合的定义。
这也说明,在2000条数据这个量级,全参微调做1个epoch就可以了,往后反而效果越来越差。
那我们接下来看看模型生成的效果:
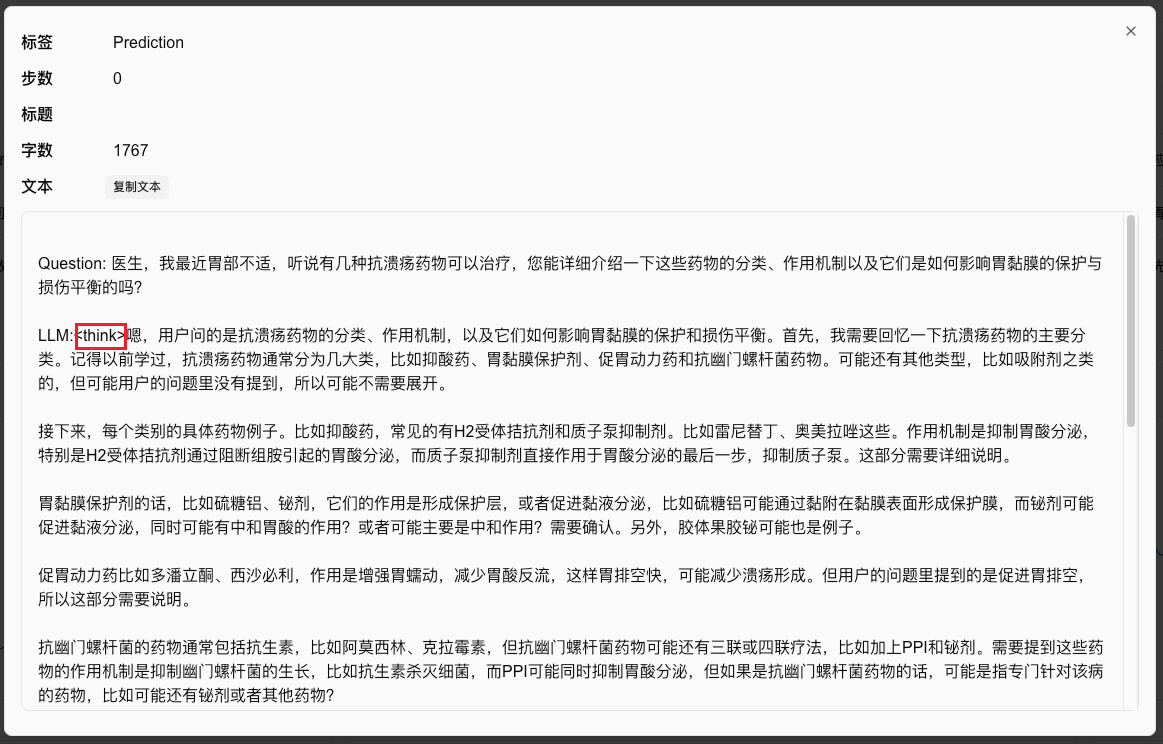
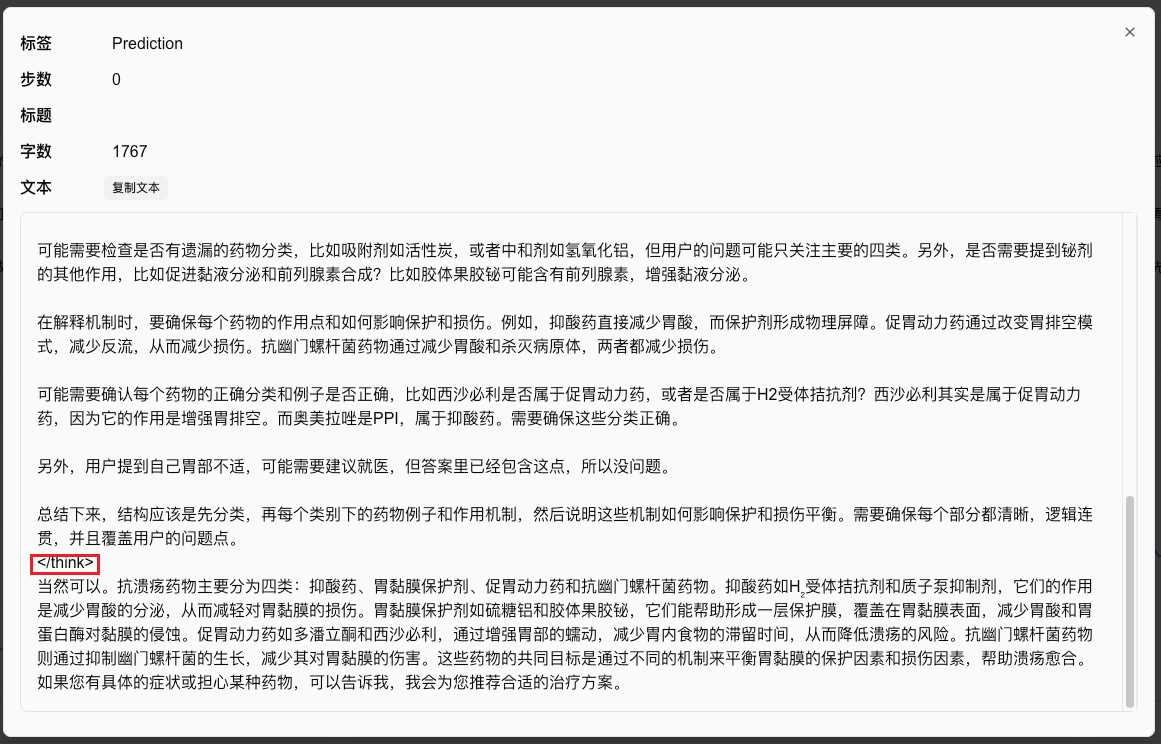
可以看到,微调后的模型明确地有了思考过程,并且在思考过程的前后增加了think标签。
回答的质量也挺不错,不过我对医学不太了解,也希望如果有学医的同学可以一起看看!
一个example:
Question: 医生,我最近胃部不适,听说有几种抗溃疡药物可以治疗,您能详细介绍一下这些药物的分类、作用机制以及它们是如何影响胃黏膜的保护与损伤平衡的吗?

LLM:<think>嗯,用户问的是抗溃疡药物的分类、作用机制,以及它们如何影响胃黏膜的保护和损伤平衡。首先,我需要回忆一下抗溃疡药物的主要分类。记得以前学过,抗溃疡药物通常分为几大类,比如抑酸药、胃黏膜保护剂、促胃动力药和抗幽门螺杆菌药物。可能还有其他类型,比如吸附剂之类的,但可能用户的问题里没有提到,所以可能不需要展开。

接下来,每个类别的具体药物例子。比如抑酸药,常见的有H2受体拮抗剂和质子泵抑制剂。比如雷尼替丁、奥美拉唑这些。作用机制是抑制胃酸分泌,特别是H2受体拮抗剂通过阻断组胺引起的胃酸分泌,而质子泵抑制剂直接作用于胃酸分泌的最后一步,抑制质子泵。这部分需要详细说明。

胃黏膜保护剂的话,比如硫糖铝、铋剂,它们的作用是形成保护层,或者促进黏液分泌,比如硫糖铝可能通过黏附在黏膜表面形成保护膜,而铋剂可能促进黏液分泌,同时可能有中和胃酸的作用?或者可能主要是中和作用?需要确认。另外,胶体果胶铋可能也是例子。

促胃动力药比如多潘立酮、西沙必利,作用是增强胃蠕动,减少胃酸反流,这样胃排空快,可能减少溃疡形成。但用户的问题里提到的是促进胃排空,所以这部分需要说明。

抗幽门螺杆菌的药物通常包括抗生素,比如阿莫西林、克拉霉素,但抗幽门螺杆菌药物可能还有三联或四联疗法,比如加上PPI和铋剂。需要提到这些药物的作用机制是抑制幽门螺杆菌的生长,比如抗生素杀灭细菌,而PPI可能同时抑制胃酸分泌,但如果是抗幽门螺杆菌药物的话,可能是指专门针对该病的药物,比如可能还有铋剂或者其他药物?

不过用户的问题里提到抗幽门螺杆菌药物,可能需要明确是单独针对幽门螺杆菌,还是包括抗生素和PPI。可能需要指出,抗幽门螺杆菌药物通常包括抗生素和PPI,而PPI本身是抑酸药。所以可能需要说明这些药物如何通过抑制胃酸分泌和杀灭细菌来减少溃疡。

然后,关于作用机制如何影响胃黏膜的保护和损伤平衡。比如,抑酸药减少胃酸,从而减少对黏膜的侵蚀,同时保护剂形成保护层,促进黏液分泌,增强黏膜屏障。促胃动力药通过增加胃蠕动,减少胃酸反流,从而保护黏膜。而抗幽门螺杆菌药物通过减少胃酸分泌和杀灭细菌,减少损伤因素。

可能需要检查是否有遗漏的药物分类,比如吸附剂如活性炭,或者中和剂如氢氧化铝,但用户的问题可能只关注主要的四类。另外,是否需要提到铋剂的其他作用,比如促进黏液分泌和前列腺素合成?比如胶体果胶铋可能含有前列腺素,增强黏液分泌。

在解释机制时,要确保每个药物的作用点和如何影响保护和损伤。例如,抑酸药直接减少胃酸,而保护剂形成物理屏障。促胃动力药通过改变胃排空模式,减少反流,从而减少损伤。抗幽门螺杆菌药物通过减少胃酸和杀灭病原体,两者都减少损伤。

可能需要确认每个药物的正确分类和例子是否正确,比如西沙必利是否属于促胃动力药,或者是否属于H2受体拮抗剂?西沙必利其实是属于促胃动力药,因为它的作用是增强胃排空。而奥美拉唑是PPI,属于抑酸药。需要确保这些分类正确。

另外,用户提到自己胃部不适,可能需要建议就医,但答案里已经包含这点,所以没问题。

总结下来,结构应该是先分类,再每个类别下的药物例子和作用机制,然后说明这些机制如何影响保护和损伤平衡。需要确保每个部分都清晰,逻辑连贯,并且覆盖用户的问题点。

</think>

当然可以。抗溃疡药物主要分为四类:抑酸药、胃黏膜保护剂、促胃动力药和抗幽门螺杆菌药物。抑酸药如H₂受体拮抗剂和质子泵抑制剂,它们的作用是减少胃酸的分泌,从而减轻对胃黏膜的损伤。胃黏膜保护剂如硫糖铝和胶体果胶铋,它们能帮助形成一层保护膜,覆盖在胃黏膜表面,减少胃酸和胃蛋白酶对黏膜的侵蚀。促胃动力药如多潘立酮和西沙必利,通过增强胃部的蠕动,减少胃内食物的滞留时间,从而降低溃疡的风险。抗幽门螺杆菌药物则通过抑制幽门螺杆菌的生长,减少其对胃黏膜的伤害。这些药物的共同目标是通过不同的机制来平衡胃黏膜的保护因素和损伤因素,帮助溃疡愈合。如果您有具体的症状或担心某种药物,可以告诉我,我会为您推荐合适的治疗方案。至此,你已经完成了qwen3微调!
- 推理训练好的模型
训好的模型默认被保存在./output/Qwen3文件夹下。
推理模型的代码如下:
import torch
from transformers import AutoModelForCausalLM, AutoTokenizer

def predict(messages, model, tokenizer):
    device = "cuda"

    text = tokenizer.apply_chat_template(messages, tokenize=False, add_generation_prompt=True)
    model_inputs = tokenizer([text], return_tensors="pt").to(device)

    generated_ids = model.generate(model_inputs.input_ids, max_new_tokens=2048)
    generated_ids = [output_ids[len(input_ids):] for input_ids, output_ids in zip(model_inputs.input_ids, generated_ids)]
    response = tokenizer.batch_decode(generated_ids, skip_special_tokens=True)[0]

    return response

# 加载原下载路径的tokenizer和model
tokenizer = AutoTokenizer.from_pretrained("./output/Qwen3-1.7B/checkpoint-1000", use_fast=False, trust_remote_code=True)
model = AutoModelForCausalLM.from_pretrained("./output/Qwen3-1.7B/checkpoint-1000", device_map="auto", torch_dtype=torch.bfloat16)

test_texts = {
    'instruction': "你是一个医学专家,你需要根据用户的问题,给出带有思考的回答。",
    'input': "医生,我最近被诊断为糖尿病,听说碳水化合物的选择很重要,我应该选择什么样的碳水化合物呢?"
}

instruction = test_texts['instruction']
input_value = test_texts['input']

messages = [
    {"role": "system", "content": f"{instruction}"},
    {"role": "user", "content": f"{input_value}"}
]

response = predict(messages, model, tokenizer)
print(response)相关链接
代码:完整代码直接看本文第5节 或 Github
实验日志过程:qwen3-1.7B-linear - SwanLab,或 SwanLab基线社区 搜索“qwen3-sft-medical”
模型:Modelscope
数据集:delicate_medical_r1_data
SwanLab:https://swanlab.cn
Qwen3-8B GRPO微调及通过swanlab可视化
半小时学会使用 GRPO 通过 Unsloth 训练自己的类 DeepSeek-R1 推理模型。
相信大家和我一样,刚刚接触RL会觉得很难且没有必要,为什么只做SFT不可以呢? 不妨想象一下,我们不是直接告诉机器“遇到A情况就做B”,而是让机器自己去“探索”,在不断“尝试”和“吸取教训”中学会如何做出最好的决策,就像我们人类学习新技能一样,往往可以收获意想不到的效果,让模型能够完成更加复杂的社会场景,贴近于人类理想中的“AI”,这就是强化学习的魅力所在。
为什么要做RL?
简单来说,强化学习致力于解决“序贯决策(Sequential Decision Making)”问题,也就是如何在一系列连续的步骤中做出最优决策,以达成一个长远的目标。
解决复杂未知环境下的决策问题:
在很多现实场景中,我们可能无法预先知道所有规则,或者环境本身就非常复杂多变。比如,让机器人学会在崎岖不平的地面上行走,我们很难手动编程所有可能遇到的情况和应对策略。强化学习允许机器在与环境的互动中自主学习,最近比较火的宇树科技和智元机器人,就大幅应用了强化学习算法。
再比如,下围棋(AlphaGo 就是一个经典例子)。棋盘状态千变万化,不可能穷举所有情况。RL可以让智能体通过自我对弈来学习高超的棋艺。
实现真正的“AI”:
传统的监督学习(SFT)需要大量的“标注数据”,往往这个量级至少是三位数起步,告诉模型“输入X对应输出Y”。但在很多任务中,获取这样的完美标注数据成本极高,甚至不可能(比如,如何标注一个“完美”的机器人行走姿态序列?标注琳琅满目的商品信息?)。
强化学习更接近人类学习的方式——通过试错(Trial and Error)。做得好就给“奖励”,做得不好就给“惩罚”(或者不给奖励),智能体在与环境的互动中,通过最大化累积奖励来学习最佳策略。
延迟奖励问题:很多时候,一个行为的好坏并不能立刻显现出来。比如,在游戏中,你现在走的一步棋,可能要到几十步之后才能看出是好是坏。强化学习的算法能够将最终的奖励/惩罚回溯分配给导致这一结果的一系列行为,从而学会长远规划。
广泛的应用前景:
游戏AI:比如TEG和天美对王者荣耀联合开发的NPC、网易的永劫无间语音队友,都应用了强化学习算法
机器人控制:机器人行走-宇树科技和智元机器人、无人机飞行算法-DJI。
自动驾驶:主要体现在决策系统,目前主流的自动驾驶厂商如momenta也在尝试RL算法。
推荐系统**:如何给用户推荐一系列内容,小红书、快手、字节都在这上面投入巨大。
RL的核心思想是什么?
强化学习的核心思想可以概括为:智能体(Agent)通过与环境(Environment)的互动,根据环境反馈的奖励(Reward)或惩罚(Punishment),学习一个最优策略(Policy),以最大化其长期累积奖励。 听起来有点抽象?我们把它拆解开来看:
智能体 (Agent) 🤖:
这就是我们要训练的学习者和决策者。它可以是一个机器人、游戏中的角色、自动驾驶系统等。
智能体的目标是学习一个策略 (Policy)。
环境 (Environment) 🌳:
智能体所处的外部世界,它会响应智能体的行为并给出反馈。
环境有其自身的状态 (State)。
状态 (State, S) 📊:
对当前环境的一个描述。比如,在机器人行走任务中,状态可以是机器人各个关节的角度、速度;在游戏中,状态可以是当前的游戏画面。
智能体根据当前状态来决定下一步的行动。
动作 (Action, A) 🏃:
智能体在某个状态下可以执行的操作。比如,机器人可以控制某个关节转动,游戏角色可以向前走、跳跃、攻击。
奖励 (Reward, R) 🏆 / 惩罚 💔:
当智能体在某个状态 S 执行了某个动作 A,转移到新的状态 S′ 后,环境会给出一个标量信号——奖励(或惩罚)。
这个奖励信号是指导智能体学习的关键。正奖励表示这个动作是好的,负奖励(惩罚)表示这个动作是坏的。
重要:智能体的目标不是最大化瞬时奖励,而是最大化未来的累积奖励 (Cumulative Reward)。比如,吃糖果(瞬时奖励)很开心,但如果因此导致蛀牙(未来惩罚),那可能就不是一个好策略。
策略 (Policy, π) 🗺️:
这是智能体学习的核心!策略定义了智能体在给定状态下应该采取什么动作。
它可以是确定性的(在状态 s,总是执行动作 a),也可以是随机性的(在状态 s,以一定概率执行动作 a1,以一定概率执行动作 a2 等)。
数学上通常表示为 π(a∣s)=P(At=a∣St=s),即在状态 St 时采取动作 a 的概率。
价值函数 (Value Function, V(s) 或 Q(s,a)) 💰:
除了策略,智能体通常还会学习一个价值函数。
状态价值函数 Vπ(s):表示从状态 s 开始,按照策略 π 继续下去,能够获得的期望累积奖励。它衡量了当前状态有多好。
状态-动作价值函数 Qπ(s,a):表示在状态 s 执行动作 a 后,再按照策略 π 继续下去,能够获得的期望累积奖励。它衡量了在当前状态下执行某个特定动作有多好。这个 Q 函数(Q-value)在很多算法中非常关键。
总结来说,强化学习的核心思想就是通过与环境的互动和试错,学习一个从状态到动作的映射(策略),以最大化智能体获得的长期累积奖励。它提供了一个强大的框架,让机器能够像人类一样从经验中学习如何在复杂世界中做出明智的决策。
GRPO相较于其他RL方法的优势是什么?
常见的强化学习方法包括:PPO(最早的)、DPO(最简单的)、GRPO(随着deepseek爆火的)等
PPO (Proximal Policy Optimization, 近端策略优化)
核心思想: PPO 是一种经典的强化学习算法,属于Actor-Critic架构。
DPO (Direct Preference Optimization, 直接偏好优化)
核心思想: DPO 提出了一种更简洁的方法来进行基于人类偏好的 LLM 对齐。它巧妙地发现,RLHF 中的奖励最大化目标可以被转化为一个直接基于偏好数据的分类问题。 它不再需要显式地训练一个奖励模型,也不需要复杂的 Actor-Critic 循环和在线采样。
GRPO (Group Relative Policy Optimization, 组相对策略优化)
核心思想: GRPO 可以看作是 PPO 的一种变体或改进,旨在提高训练效率和稳定性,特别是在大型模型上。DeepSeek的工作使这个方法受到关注。 它的一个核心特点是尝试省去或简化价值模型 (Critic),并通过一种“组内相对比较”的方式来估计动作的优势 (Advantage)。
工作方式:
SFT 和奖励模型:通常仍然需要 SFT 模型作为基础,并且需要一个(可能是预训练好的,或者正在优化的)奖励模型来评估生成内容的质量。
组采样和相对优势估计:
对于一个给定的输入 (prompt),模型会生成一组 (group) 多个候选输出。
奖励模型对这一组中的所有输出进行打分。
GRPO 利用这些组内的打分信息来估计每个输出的相对优势。例如,可以将组内所有输出的平均奖励作为基线 (baseline),高于平均奖励的输出被认为具有正优势,低于平均奖励的则具有负优势。
策略更新:基于这种相对优势估计来更新策略网络 (Actor)。
关键在于它可能不需要一个独立的、需要迭代训练的价值网络 (Critic) 来估计状态价值或状态-动作价值,从而降低了复杂性和计算量。
优点:
效率提升:通过省去或简化价值模型,可以减少内存占用和计算开销,这对于非常大的模型尤其有利。
稳定性可能更好:组内相对比较可能提供更稳定的学习信号。
与奖励模型的训练方式更契合:奖励模型通常也是通过比较成对输出来训练的,GRPO 的组内比较方式与此类似。
GRPO的核心思想是什么?
那么你可能会注意到RL往往是在SFT之后作为一种post-traning的方法,那么直接RL可不可以呢?
DeepSeek 的研究人员在使用纯强化学习 (RL) 训练 R1-Zero 时,发现了一个“顿悟时刻”。该模型学会了通过重新评估其初始方法,延长其思考时间,而无需任何人工指导或预先定义的指令。
一个完整的GRPO流程往往如下:
模型生成多组响应
每个响应都根据正确性或由某些设定的奖励函数(而不是 LLM 奖励模型)创建的其他指标进行评分
计算该组的平均分数
每个回答的分数都会与小组平均分数进行比较
模型得到强化,有利于获得更高得分的回应
最初,人们必须收集大量数据来填充推理过程/思维链。但 GRPO(DeepSeek 使用的算法)或其他强化学习算法可以引导模型自动展现推理能力并创建推理轨迹。相反,我们需要创建良好的奖励函数或验证器。例如,如果它得到了正确的答案,就给它 1 分。如果某些单词拼写错误,就减 0.1 分。等等!我们可以提供很多函数来奖励这个过程,也就代替了传统的LLM奖励模型,节约了大量的训练成本和资源消耗!
常见的RL框架都有什么?
TRL、VeRL、Unsloth等
TRL(Transformer Reinforcement Learning) 是由 Hugging Face 开发的一套基于强化学习(Reinforcement Learning, RL)的训练工具,专门用于优化和微调大规模语言模型(如 GPT、LLaMA 等)。它结合了 PPO(Proximal Policy Optimization) 等强化学习算法,使开发者能够高效地对预训练语言模型进行 RL 微调,以优化特定目标(如人类偏好对齐、任务性能提升等)。 VeRL是字节跳动在TRL的基础之上针对大规模分布式(ray)训练场景优化的强化学习框架,TRL能干的VeRL都能干,目前很多公司的强化学习框架都是基于VeRl改的。
不过这都不是本教程的主角,本教程的主角是Unsloth,为什么选择这个框架呢?我将其总结成了以下几点:
VeRL优化的是分布式场景,也就是卡的数量>=2用起来才会比较顺手,这不符合项目的初衷
ray的学习成本对于小白来讲过高
unsloth在单卡场景下即可对8b模型进行RL资源占用极低
RL原理可以利用极小的学习成本掌握,这不是好事成双嘛,接下来就一起看看Unsloth吧!
Unsloth - 0基础学习最佳框架!
官方文档: https://docs.unsloth.ai/ Github: https://github.com/unslothai/unsloth Unsloth 是一个极其强调资源节省的框架,把所有的资源节省做到了极致,具体来讲Unsloth能够将 Llama-3、Mistral、Phi-4 和 Gemma 等大型语言模型的微调速度提升 2 倍,内存占用减少 70%,并且准确率没有任何下降! 官方文档非常全面,详细指导了如何训练自己的定制模型。其中涵盖了安装和更新 Unsloth、创建数据集、运行和部署模型等基本要素。 Unsloth 让大家在本地或在 Google Colab 和 Kaggle 等平台上训练像 Llama 3 这样的模型变得极其简单。Unsloth简化了整个训练工作流程,包括模型加载、量化、训练、评估、运行、保存、导出,以及与 Ollama、llama.cpp 和 vLLM 等推理引擎的集成。 Unsloth定期与 Hugging Face、Google 和 Meta 的团队合作,以修复 LLM 训练和模型中的错误。因此,当使用 Unsloth 进行训练或使用模型时,可以期待获得最准确的结果。 Unsloth 具有高度可定制性,允许更改聊天模板或数据集格式等内容。Unsloth还为视觉、文本转语音 (TTS)、BERT、强化学习 (RL) 等提供了预构建的脚本!此外,Unsloth支持所有训练方法和所有基于 Transformer 的模型。
咳咳,有点啰嗦了,下面开始步入正题
本文使用的测试环境为单张A100,显存80GB,可根据需求切换不同参数量的模型,实测4B 24G显存 is enough! unsloth使Qwen3(8B)微调速度提高2倍,VRAM使用减少70%,并且比所有使用Flash Attention 2的环境支持长8倍的上下文长度。使用unsloth,Qwen3–30B-A3B模型可以舒适地在仅17.5GB VRAM的环境中运行。 unsloth为Qwen3提供了Dynamic 2.0量化方法,在5-shot MMLU和KL散度基准测试中提供最佳性能。这意味着可以运行和微调量化后的Qwen3 LLM,同时保持最小的精度损失。unsloth还上传了支持原生128K上下文长度的Qwen3版本。
Qwen3_8b_GRPO.ipynb
安装软件包
pip install unsloth==2025.3.19 vllm==0.8.2准备模型,设置参数
from unsloth import FastLanguageModel
import torch

max_seq_length = 2048  # 最大序列长度,可以增加以支持更长的推理轨迹
lora_rank = 32         # LoRA 的秩,秩越大模型可能越智能,但训练和推理速度会变慢

# 从预训练模型加载模型和分词器
model, tokenizer = FastLanguageModel.from_pretrained(
    model_name="Qwen/Qwen3-8B",  # 要加载的预训练模型名称(官网版本/离线版本/unsloth版本均可)
    max_seq_length=max_seq_length,        # 设置模型的最大序列长度
    load_in_4bit=False,                   # 是否以4位加载模型,对于LoRA 16位训练,设置为False
    fast_inference=True,                  # 是否启用 vLLM 快速推理
    max_lora_rank=lora_rank,              # 设置 LoRA 的最大秩
    gpu_memory_utilization=0.7,           # GPU显存使用率,如果显存不足 (OOM),可以降低此值
)

# 为模型添加 PEFT (Parameter-Efficient Fine-Tuning) 配置,这里使用 LoRA
model = FastLanguageModel.get_peft_model(
    model,
    r=lora_rank,  # LoRA 的秩 (r),选择任何大于0的数字!建议值为 8, 16, 32, 64, 128
    target_modules=[  # 需要应用LoRA的模块名称列表
        "q_proj", "k_proj", "v_proj", "o_proj",  # 注意力机制中的查询、键、值、输出投影
        "gate_proj", "up_proj", "down_proj",     # 前馈网络中的门控、上行和下行投影
    ],
    lora_alpha=lora_rank * 2,  # LoRA 的 alpha 参数,设置为秩的2倍可以加速训练
    use_gradient_checkpointing="unsloth",  # 是否使用梯度检查点技术,"unsloth" 表示使用其优化版本以减少显存使用
    random_state=3407,                   # 随机种子,用于确保结果的可复现性
)
设置CoT思考模版【让模型具备思考能力的必经之路】
# 定义用于标记模型推理过程和最终解的字符串标记
reasoning_start = "<start_working_out>"     # 用于包裹模型的“思考过程”开始部分
reasoning_end   = "<end_working_out>"       # 用于包裹模型的“思考过程”结束部分
solution_start  = "<SOLUTION>"              # 用于包裹最终解答开始部分
solution_end    = "</SOLUTION>"             # 用于包裹最终解答结束部分

# 定义系统提示词,告诉模型应该如何组织回答:先推理,再给出答案
system_prompt = \
f"""You are given a problem.
Think about the problem and provide your working out.
Place it between {reasoning_start} and {reasoning_end}.
Then, provide your solution between {solution_start}{solution_end}"""

# 构建chat_template模板,控制如何拼接prompt
chat_template = \
    "{% if messages[0]['role'] == 'system' %}"\
        "{{ messages[0]['content'] + eos_token }}"\  # 如果第一条是system提示,拼接它并添加eos标记
        "{% set loop_messages = messages[1:] %}"\     # 剩下的消息设为循环体
    "{% else %}"\
        "{{ '{system_prompt}' + eos_token }}"\        # 否则,插入默认system_prompt并添加eos
        "{% set loop_messages = messages %}"\
    "{% endif %}"\
    "{% for message in loop_messages %}"\             # 遍历所有对话消息
        "{% if message['role'] == 'user' %}"\
            "{{ message['content'] }}"\               # 用户消息直接添加
        "{% elif message['role'] == 'assistant' %}"\
            "{{ message['content'] + eos_token }}"\   # assistant消息后加eos
        "{% endif %}"\
    "{% endfor %}"\
    "{% if add_generation_prompt %}{{ '{reasoning_start}' }}"\  # 如果需要生成提示,添加开始思考标记
    "{% endif %}"

# 将模板中作为字符串存在的变量替换为实际变量值(避免模板中引号包住变量名)
chat_template = chat_template\
    .replace("'{system_prompt}'",   f"'{system_prompt}'")\
    .replace("'{reasoning_start}'", f"'{reasoning_start}'")

# 将chat_template应用到tokenizer(假设这是一个支持chat_template的tokenizer)
tokenizer.chat_template = chat_template

# 模拟一次tokenizer应用chat_template的过程(不进行tokenize,只展示结果)
tokenizer.apply_chat_template([
    {"role" : "user", "content" : "What is 1+1?"},
    {"role" : "assistant", "content" : f"{reasoning_start}I think it's 2.{reasoning_end}{solution_start}2{solution_end}"},
    {"role" : "user", "content" : "What is 2+2?"},
], tokenize = False, add_generation_prompt = True)加载数据集【这里使用一个数学推理的数据集】
from datasets import load_dataset
import pandas as pd
import numpy as np

dataset = load_dataset("unsloth/OpenMathReasoning-mini", split = "cot")
dataset = dataset.to_pandas()[
    ["expected_answer", "problem", "generated_solution"]
]

is_number = pd.to_numeric(pd.Series(dataset["expected_answer"]), errors = "coerce").notnull()
dataset = dataset.iloc[np.where(is_number)[0]]

dataset处理数据集的格式(SFT的老生常谈)
def format_dataset(x):
    # 从输入数据中提取期望答案和问题内容
    expected_answer = x["expected_answer"]
    problem = x["problem"]

    # 获取模型生成的推理内容,并移除旧格式标签 <think> 和 </think>
    thoughts = x["generated_solution"]
    thoughts = thoughts.replace("<think>", "").replace("</think>", "")

    # 去除推理内容左右两端的换行符和空格
    thoughts = thoughts.strip()

    # 按照自定义格式拼接推理部分和答案部分,插入标记标签
    final_prompt = (
        reasoning_start + thoughts + reasoning_end +
        solution_start + expected_answer + solution_end
    )

    # 构造格式化后的多轮对话列表,用于微调或测试对话模型
    return [
        {"role": "system",    "content": system_prompt},  # 系统提示词,指导模型输出格式
        {"role": "user",      "content": problem},        # 用户输入的问题
        {"role": "assistant", "content": final_prompt},   # 模型的回复,包含推理过程和答案
    ]

# 将整个数据集按行应用格式化函数,生成 Messages 字段,适用于对话类微调
dataset["Messages"] = dataset.apply(format_dataset, axis=1)

tokenizer.apply_chat_template(dataset["Messages"][0], tokenize = False)

dataset["N"] = dataset["Messages"].apply(lambda x: len(tokenizer.apply_chat_template(x)))

dataset = dataset.loc[dataset["N"] <= max_seq_length/2].copy()
dataset.shape

from datasets import Dataset

dataset["text"] = tokenizer.apply_chat_template(dataset["Messages"].values.tolist(), tokenize = False)
dataset = Dataset.from_pandas(dataset)
dataset先做SFT
from trl import SFTTrainer, SFTConfig

# 创建一个有监督微调的训练器实例
trainer = SFTTrainer(
    model = model,                 # 预训练模型(如 LLaMA、Qwen、Mistral 等)
    tokenizer = tokenizer,         # 与模型匹配的 tokenizer,需支持 chat_template
    train_dataset = dataset,       # 用于训练的数据集,要求包含"text"字段

    # 训练参数配置
    args = SFTConfig(
        dataset_text_field = "text",               # 数据集中用于训练输入的字段名(通常为"text")
        per_device_train_batch_size = 1,           # 每张 GPU 上的 batch size
        gradient_accumulation_steps = 1,           # 梯度累积步数(总有效 batch_size = 上两者相乘)

        warmup_steps = 5,                          # 学习率预热步数,避免初始过快下降
        num_train_epochs = 2,                      # 训练轮数

        learning_rate = 2e-4,                      # 初始学习率(建议长期训练用 2e-5 ~ 5e-5)
        logging_steps = 5,                         # 每 5 步打印一次日志(loss 等)

        optim = "adamw_8bit",                      # 使用 8-bit AdamW 优化器(需要 bitsandbytes 支持)
        weight_decay = 0.01,                       # 权重衰减,防止过拟合
        lr_scheduler_type = "linear",              # 线性学习率衰减策略

        seed = 3407,                               # 固定随机种子,确保实验可重复

        report_to = "none",                        # 不将训练日志报告到 WandB 等工具(如需开启改为"wandb")
    ),
)

trainer.train()SFT阶段输出
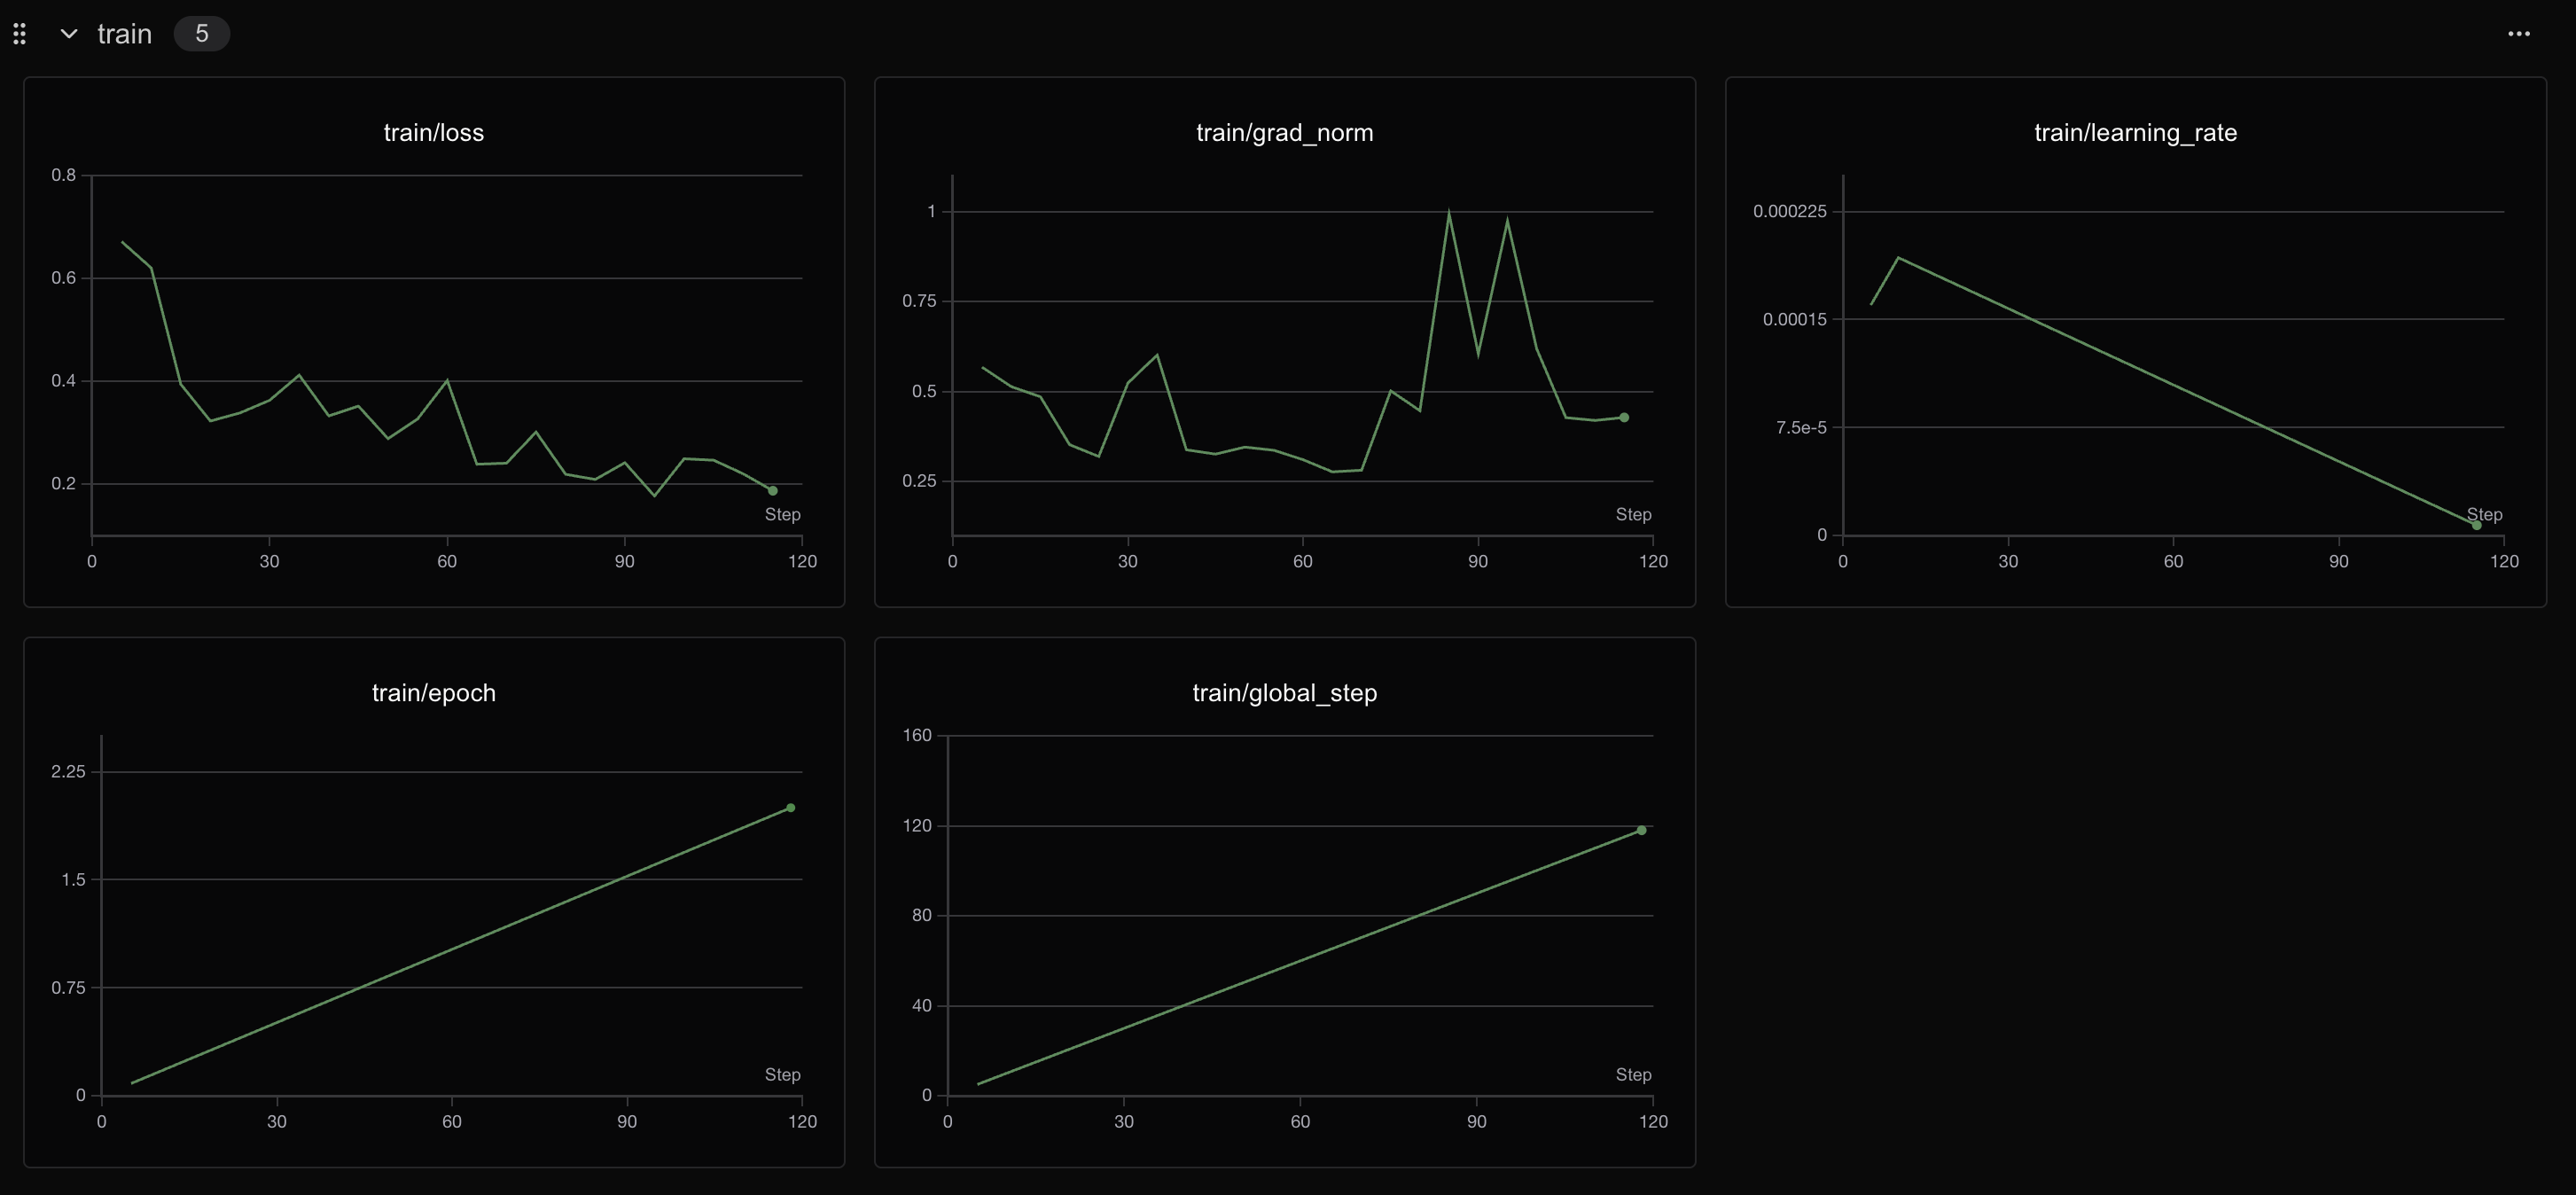
# 构建输入 prompt,选取前两条消息(通常为 system + user)
text = tokenizer.apply_chat_template(
    dataset[0]["Messages"][:2],       # 输入前两条消息:system 和 user 组成的 prompt
    tokenize = False,                 # 不进行 token 化,返回纯文本字符串
    add_generation_prompt = True,     # 在结尾添加推理开始标记(如 <start_working_out>)
)

# 使用 transformers 的流式输出工具 TextStreamer 实时打印生成内容
from transformers import TextStreamer
_ = model.generate(
    **tokenizer(text, return_tensors = "pt").to("cuda"),   # 编码文本并移动到 GPU
    temperature = 0,                # 使用贪婪解码(temperature 趋近于 0)
    max_new_tokens = 1024,         # 限制生成 token 数量
    streamer = TextStreamer(tokenizer, skip_prompt = False),  # 实时打印生成结果
)

# 清理内存,防止显存泄露
del dataset
torch.cuda.empty_cache()
import gc
gc.collect()

# 加载一个数学微调数据集(HuggingFace hub 上的 DAPO-Math-17k)
from datasets import load_dataset
dataset = load_dataset("open-r1/DAPO-Math-17k-Processed", "en", split = "train")
dataset

# 查看一个样本的 prompt 和 solution 字段
dataset[0]["prompt"]
dataset[0]["solution"]

# 抽取解答函数(可定制,此处暂时原样返回)
def extract_hash_answer(text):
    # 可启用以下代码用于处理带有 "####" 分隔的答案
    # if "####" not in text: return None
    # return text.split("####")[1].strip()
    return text
extract_hash_answer(dataset[0]["solution"])

# 将原始数据格式转为 messages 格式,适配 SFTTrainer 所需格式
dataset = dataset.map(lambda x: {
    "prompt": [  # 将系统提示和用户输入转为消息格式
        {"role": "system", "content": system_prompt},
        {"role": "user",   "content": x["prompt"]},
    ],
    "answer": extract_hash_answer(x["solution"]),  # 答案部分处理
})
dataset[0]

# ========================
# 提取生成文本中答案部分的正则表达式匹配器
# ========================

import re

# 构造匹配结束标签 "</SOLUTION>" 和可选的 eos_token(例如 <|endoftext|>)
solution_end_regex = r"</SOLUTION>[\s]{0,}" + \
    "(?:" + re.escape(tokenizer.eos_token) + ")?"

# 构造完整的匹配模板,用于提取推理结果中的答案部分
match_format = re.compile(
    rf"{reasoning_end}.*?"\                   # 匹配推理结束标签以及其后的内容(非贪婪)
    rf"{solution_start}(.+?){solution_end_regex}"\  # 提取 <SOLUTION> 与 </SOLUTION> 之间的内容
    rf"[\s]{{0,}}$",                          # 匹配末尾的空白
    flags = re.MULTILINE | re.DOTALL         # 多行匹配 + 点号匹配换行符
)

# 示例:验证格式匹配是否能正确提取解答部分
match_format.findall(
    "<start_working_out>Let me think!<end_working_out>"\
    f"<SOLUTION>  2  </SOLUTION>\n\n",
)
# 输出应为:["2"]
奖励函数部分
def match_format_exactly(completions, **kwargs):
    scores = []  # 用于保存每个 completion 的得分

    for completion in completions:
        score = 0
        response = completion[0]["content"]  # 获取模型输出内容(假设为 messages 列表中的第一个 assistant 回复)

        # 如果输出内容能成功匹配指定格式(即包含完整 <start_working_out>...<SOLUTION>... 标签结构)
        if match_format.search(response) is not None:
            score += 3.0  # 匹配成功得 3 分(用于奖励格式正确的输出)

        scores.append(score)  # 保存该条 completion 的得分

return scores # 返回所有 completion 的格式匹配得分列表def match_format_approximately(completions, **kwargs):
scores = [] # 存储每个 completion 的近似格式匹配得分
for completion in completions:
score = 0
response = completion[0]["content"] # 获取该条生成结果的文本内容
# 本函数不是精确匹配整段模板,而是检查关键标签是否恰好出现一次
# 评分标准如下(每个关键标签出现一次加 0.5 分,出现多次或漏掉则减 1 分):
# <start_working_out> 不需要判断,因为一般在 prompt 中已加,无需重复奖励
score += 0.5 if response.count(reasoning_end) == 1 else -1.0 # 检查 <end_working_out>
score += 0.5 if response.count(solution_start) == 1 else -1.0 # 检查 <SOLUTION>
score += 0.5 if response.count(solution_end) == 1 else -1.0 # 检查 </SOLUTION>
scores.append(score) # 保存该条 completion 的评分结果
return scores # 返回所有样本的评分结果列表def check_answer(prompts, completions, answer, **kwargs):
# 获取原始问题(一般为 prompts 中最后一个 user 消息的内容)
question = prompts[0][-1]["content"]
# 提取每个 completion 的生成结果(假设为 assistant 的第一条回复)
responses = [completion[0]["content"] for completion in completions]
# 从每个 response 中提取 <SOLUTION> 标签内的答案(使用正则匹配)
extracted_responses = [
guess.group(1) # 如果匹配成功,取出括号中的 group(1)
if (guess := match_format.search(r)) is not None else None # 否则为 None
for r in responses
]
scores = [] # 存储每个样本的评分结果
for guess, true_answer in zip(extracted_responses, answer):
score = 0
if guess is None:
scores.append(-2.0) # 若未成功提取答案,直接扣分
continue
# 正确答案完全一致,奖励 5 分
if guess == true_answer:
score += 5.0
# 若去除空格后匹配成功,奖励略少(3.5 分)
elif guess.strip() == true_answer.strip():
score += 3.5
# 否则,尝试进行“近似数值”匹配
else:
try:
ratio = float(guess) / float(true_answer) # 转换为 float 并计算比值
if ratio >= 0.9 and ratio <= 1.1:
score += 2.0 # 误差在 ±10% 内
elif ratio >= 0.8 and ratio <= 1.2:
score += 1.5 # 误差在 ±20% 内
else:
score -= 2.5 # 偏差太大,扣分
except:
score -= 4.5 # 无法转为数值(如包含文本、单位等),严重扣分
scores.append(score) # 记录当前样本的得分
return scores # 返回每个 completion 的分数match_numbers = re.compile(
solution_start + r".*?[\s]{0,}([-]?[\d\.\,]{1,})",
flags = re.MULTILINE | re.DOTALL
)
print(match_numbers.findall("<SOLUTION> 0.34 </SOLUTION>"))
print(match_numbers.findall("<SOLUTION> 123,456 </SOLUTION>"))
print(match_numbers.findall("<SOLUTION> -0.234 </SOLUTION>"))
print(match_numbers.findall("<SOLUTION>17</SOLUTION>"))# 全局打印控制变量,每 N 步打印一次日志(用于调试时查看部分输出)
global PRINTED_TIMES
PRINTED_TIMES = 0 # 当前已打印次数
global PRINT_EVERY_STEPS
PRINT_EVERY_STEPS = 5 # 每间隔多少步打印一次
# 数值匹配函数:从生成结果中提取数字,并与正确答案进行比较
def check_numbers(prompts, completions, answer, **kwargs):
# 获取问题文本(通常为 prompts 中最后一个 user 消息)
question = prompts[0][-1]["content"]
# 提取模型生成的文本内容(假设每个 completion 是一个消息列表,取第一条)
responses = [completion[0]["content"] for completion in completions]
# 使用正则表达式 match_numbers 提取数字
extracted_responses = [
guess.group(1)
if (guess := match_numbers.search(r)) is not None else None \
for r in responses
]
scores = [] # 存储得分结果
# 控制打印调试信息(每隔 N 次打印一次,用于查看 sample 匹配结果)
global PRINTED_TIMES
global PRINT_EVERY_STEPS
if PRINTED_TIMES % PRINT_EVERY_STEPS == 0:
print(
'*'*20 + f"Question:\n{question}", # 打印问题
f"\nAnswer:\n{answer[0]}", # 打印参考答案
f"\nResponse:\n{responses[0]}", # 打印模型生成
f"\nExtracted:\n{extracted_responses[0]}" # 打印提取结果
)
PRINTED_TIMES += 1 # 打印次数增加
# 核心评分逻辑
for guess, true_answer in zip(extracted_responses, answer):
if guess is None:
scores.append(-2.5) # 没提取出数字,直接扣分
continue
try:
# 去除空格,转换为 float;guess 先去掉千位分隔符(例如 123,456)
true_answer = float(true_answer.strip())
guess = float(guess.strip().replace(",", ""))
# 如果完全数值一致,得分 3.5;否则扣分
scores.append(3.5 if guess == true_answer else -1.5)
except:
scores.append(0) # 解析失败不给分也不扣分
continue
return scores # 返回所有样本的得分列表# 对数据集中的每条样本,应用 tokenizer 的 chat 模板并进行分词
tokenized = dataset.map(
lambda x: {
"tokens": tokenizer.apply_chat_template(
x["prompt"], # 输入为 prompt 字段,即消息列表 [{"role": ..., "content": ...}, ...]
add_generation_prompt=True, # 添加生成提示符(如 <start_working_out>),用于 instruct-style 生成任务
tokenize=True # 返回 token id 列表,而非字符串
)
},
batched=True, # 启用批处理,提高 map 的效率
)
# 打印第一个样本的解码结果(从 token id 转换回字符串),用于验证模板和 tokenization 是否正确
print(tokenizer.decode(tokenized[0]["tokens"]))
# 为每条样本添加 token 序列长度字段 "L",便于后续长度分布分析
tokenized = tokenized.map(lambda x: {"L": len(x["tokens"])})
import numpy as np
# 计算 token 长度的 90% 分位数,作为训练时的最大 token 限制(防止极端长样本导致 OOM)
maximum_length = int(np.quantile(tokenized["L"], 0.9))
print("Max Length = ", maximum_length)
# 过滤掉 token 长度超过最大长度阈值的样本,仅保留较短的 90% 样本
dataset = dataset.select(
np.where(np.array(tokenized["L"]) <= maximum_length)[0]
)
# 删除中间变量 tokenized,释放内存
del tokenizedGRPO部分
# 计算提示长度上限(加1是保险措施,防止边界问题)
max_prompt_length = maximum_length + 1  # +1 是为了避免 max_length 截断时误伤
max_completion_length = max_seq_length - max_prompt_length  # 剩余 token 用于生成

# 配置 vLLM 的采样参数(用于生成训练样本)
from vllm import SamplingParams
vllm_sampling_params = SamplingParams(
    min_p = 0.1,                    # nucleus sampling 的截断下界
    top_p = 1.0,                    # nucleus sampling 的上限(top-p sampling)
    top_k = -1,                     # 不启用 top-k 截断(-1 表示关闭)
    seed = 3407,                    # 固定随机种子,保证生成结果可复现
    stop = [tokenizer.eos_token],   # 生成停止标志(通常是 <|endoftext|>)
    include_stop_str_in_output = True,  # 是否将 stop token 也包含在输出中
)
# 配置 GRPO(Generalized Reinforcement Preference Optimization)训练参数
from trl import GRPOConfig, GRPOTrainer
training_args = GRPOConfig(
    vllm_sampling_params = vllm_sampling_params,  # 用于生成 completion 的采样策略
    temperature = 1.0,               # 生成的多样性控制(通常设为 0.7 ~ 1.0)
    learning_rate = 5e-6,            # 训练的学习率(较小以保证稳定收敛)
    weight_decay = 0.01,             # 权重衰减,用于防止过拟合
    warmup_ratio = 0.1,              # warmup 步数占总训练步数的比例(通常为 0.05 ~ 0.1)
    lr_scheduler_type = "linear",    # 学习率调度方式为线性下降
    optim = "adamw_8bit",            # 使用 bitsandbytes 的 8bit AdamW 优化器(省显存)

    logging_steps = 1,               # 每一步打印一次日志(适合 debug)
    per_device_train_batch_size = 1, # 每张 GPU 的 batch size
    gradient_accumulation_steps = 1, # 梯度累积步数(设为 4 可等效 batch size=4)

    num_generations = 4,             # 每个 prompt 生成多少个 response(越多越好,但显存消耗更大)
    max_prompt_length = max_prompt_length,         # 提示 token 最大长度(前面计算得出)
    max_completion_length = max_completion_length, # 回答 token 最大长度(确保总长不超过模型限制)

    # num_train_epochs = 1,          # 可选参数:训练轮次,设置后可按 epoch 控制训练终止
    max_steps = 100,                 # 最大训练步数(适合调试用,正式训练时可加大)
    save_steps = 100,                # 每 100 步保存一次模型(训练短时可以不存)

    report_to = "none",              # 不上传训练日志(可设置为 "wandb" 使用可视化工具)
output_dir = "outputs", # 模型输出路径# 创建 GRPOTrainer 实例,用于执行强化学习式偏好优化训练(Generalized RPO)
trainer = GRPOTrainer(
model = model, # 需要训练的语言模型(必须支持 causal LM 格式,如 GPT、LLaMA 等)
processing_class = tokenizer, # 用于生成 prompt、解码 response 的 tokenizer(需支持 chat_template)
reward_funcs = [ # 自定义奖励函数列表,用于计算每条样本的得分
match_format_exactly, # 检查是否严格符合 <start_working_out>...<SOLUTION> 格式,匹配得分高
match_format_approximately, # 检查是否大致有格式标签,宽松评分
check_answer, # 与参考答案对比,进行精确匹配、模糊匹配、近似数值匹配
check_numbers, # 提取数值进行比较(用于数学题)
],
args = training_args, # 训练参数配置(使用前面定义好的 GRPOConfig 对象)
train_dataset = dataset, # 实际用于训练的数据集
# 可选:如启用训练 + 验证评估,可替换为如下配置
# train_dataset = new_dataset["train"],
# eval_dataset = new_dataset["test"],
)
训练完毕后调用模型
# Step 1: 构造初始输入并生成输出(不加载 LoRA)
text = "What is the sqrt of 101?"

from vllm import SamplingParams

# 设置生成参数(适度随机,限制长度)
sampling_params = SamplingParams(
    temperature = 1.0,
    top_k = 50,
    max_tokens = 1024,
)

# 使用基础模型进行快速推理(未加载 LoRA)
output = model.fast_generate(
    [text],  # 输入为单条文本
    sampling_params=sampling_params,
    lora_request=None,  # 不加载任何 LoRA 权重
)[0].outputs[0].text

print("Original model output:\n", output)

# Step 2: 保存 GRPO 微调得到的 LoRA 权重
model.save_lora("grpo_saved_lora")

# Step 3: 检查保存的 safetensors 权重不为全零
from safetensors import safe_open

with safe_open("grpo_saved_lora/adapter_model.safetensors", framework="pt") as f:
    for key in f.keys():
        tensor = f.get_tensor(key)
        n_zeros = (tensor == 0).sum() / tensor.numel()
        assert n_zeros.item() != 1.0, f"Tensor {key} is entirely zero!"

print("LoRA weights saved and verified.")

# Step 4: 构造消息格式输入并应用 tokenizer 的 chat_template
messages = [
    {"role": "system", "content": system_prompt},
    {"role": "user", "content": "What is the sqrt of 101?"},
]

# 构造对话式文本输入,用于 instruct-style 推理
text = tokenizer.apply_chat_template(
    messages,
    add_generation_prompt=True,  # 添加推理起始标记
    tokenize=False               # 返回字符串而非 token ids
)

# Step 5: 加载微调后的 LoRA 并生成输出
sampling_params = SamplingParams(
    temperature=1.0,
    top_k=50,
    max_tokens=2048,
)

# 加载 LoRA 并进行推理
output = model.fast_generate(
    text,
    sampling_params=sampling_params,
    lora_request=model.load_lora("grpo_saved_lora"),  # 加载 GRPO 微调权重
)[0].outputs[0].text

print("GRPO-tuned model output:\n", output)保存模型
# 合并为 16bit 权重并保存本地(适用于全精度部署)
if False:
    model.save_pretrained_merged("model", tokenizer, save_method="merged_16bit")
# 合并为 16bit 权重并上传至 HuggingFace Hub(需填写 token)
if False:
    model.push_to_hub_merged("hf/model", tokenizer, save_method="merged_16bit", token="")
# 合并为 4bit 量化权重并保存本地(适用于节省显存的部署场景,如 QLoRA 推理)
if False:
    model.save_pretrained_merged("model", tokenizer, save_method="merged_4bit")
# 合并为 4bit 量化权重并上传至 HuggingFace Hub(需填写 token)
if False:
    model.push_to_hub_merged("hf/model", tokenizer, save_method="merged_4bit", token="")
# 仅保存 LoRA Adapter 参数(适用于只上传微调部分以节省空间或用于 PEFT 加载)
if False:
    model.save_pretrained_merged("model", tokenizer, save_method="lora")
# 仅上传 LoRA Adapter 参数至 HuggingFace Hub(需填写 token)
if False:
model.push_to_hub_merged("hf/model", tokenizer, save_method="lora", token="")# 保存为 8bit Q8_0 GGUF 格式(适用于 GGUF 量化模型推理,如 llama.cpp)
if False:
model.save_pretrained_gguf("model", tokenizer)
# 上传 Q8_0 量化模型到 HuggingFace Hub
# 请前往 https://huggingface.co/settings/tokens 获取访问令牌(token)
# 并将 "hf" 替换为你的用户名
if False:
model.push_to_hub_gguf("hf/model", tokenizer, token="")
# 保存为 16bit GGUF 格式(即未量化版本,保留完整精度,适用于精度敏感任务)
if False:
model.save_pretrained_gguf("model", tokenizer, quantization_method="f16")
# 上传 16bit GGUF 模型到 HuggingFace Hub
if False:
model.push_to_hub_gguf("hf/model", tokenizer, quantization_method="f16", token="")
# 保存为 q4_k_m(4bit K-type)GGUF 格式,适用于推理效率与精度之间的平衡
if False:
model.save_pretrained_gguf("model", tokenizer, quantization_method="q4_k_m")
# 上传 q4_k_m 模型到 HuggingFace Hub
if False:
model.push_to_hub_gguf("hf/model", tokenizer, quantization_method="q4_k_m", token="")
# 一次性上传多个 GGUF 格式版本,速度更快(适合部署多个精度版本)
if False:
model.push_to_hub_gguf(
"hf/model", # 替换 "hf" 为你的 HuggingFace 用户名
tokenizer,
quantization_method=["q4_k_m", "q8_0", "q5_k_m"], # 可根据需要调整格式
token=""
)Swanlab

++SwanLab++ 是一个开源的模型训练记录工具,面向 AI 研究者,提供了训练可视化、自动日志记录、超参数记录、实验对比、多人协同等功能。在
SwanLab上,研究者能基于直观的可视化图表发现训练问题,对比多个实验找到研究灵感,并通过在线链接的分享与基于组织的多人协同训练,打破团队沟通的壁垒。
为什么要记录训练?
相较于软件开发,模型训练更像一个实验科学。一个品质优秀的模型背后,往往是成千上万次实验。研究者需要不断尝试、记录、对比,积累经验,才能找到最佳的模型结构、超参数与数据配比。在这之中,如何高效进行记录与对比,对于研究效率的提升至关重要。
在哪里用?
from trl import SFTTrainer, SFTConfig
trainer = SFTTrainer(
    model = model,
    tokenizer = tokenizer,
    train_dataset = dataset,
    args = SFTConfig(
        dataset_text_field = "text",
        per_device_train_batch_size = 1,
        gradient_accumulation_steps = 1,
        warmup_steps = 5,
        num_train_epochs = 2,
        learning_rate = 2e-4,
        logging_steps = 5,
        optim = "adamw_8bit",
        weight_decay = 0.01,
        lr_scheduler_type = "linear",
        seed = 3407,
        report_to = "swanlab", # 这里改成swanlab
    ),
)max_prompt_length = maximum_length + 1
max_completion_length = max_seq_length - max_prompt_length
from vllm import SamplingParams
vllm_sampling_params = SamplingParams(
min_p = 0.1,
top_p = 1.0,
top_k = -1,
seed = 3407,
stop = [tokenizer.eos_token],
include_stop_str_in_output = True,
)
from trl import GRPOConfig, GRPOTrainer
training_args = GRPOConfig(
vllm_sampling_params = vllm_sampling_params,
temperature = 1.0,
learning_rate = 5e-6,
weight_decay = 0.01,
warmup_ratio = 0.1,
lr_scheduler_type = "linear",
optim = "adamw_8bit",
logging_steps = 1,
per_device_train_batch_size = 1,
gradient_accumulation_steps = 1, # Increase to 4 for smoother training
num_generations = 4, # Decrease if out of memory
max_prompt_length = max_prompt_length,
max_completion_length = max_completion_length,
# num_train_epochs = 1, # Set to 1 for a full training run
max_steps = 100,
save_steps = 100,
report_to = "swanlab", # 这里改成swanlab
output_dir = "outputs",
# 可以选择训练+评估
# fp16_full_eval = True,
# per_device_eval_batch_size = 4,
# eval_accumulation_steps = 1,
# eval_strategy = "steps",
# eval_steps = 1,
)本试验的试验记录
SFT阶段
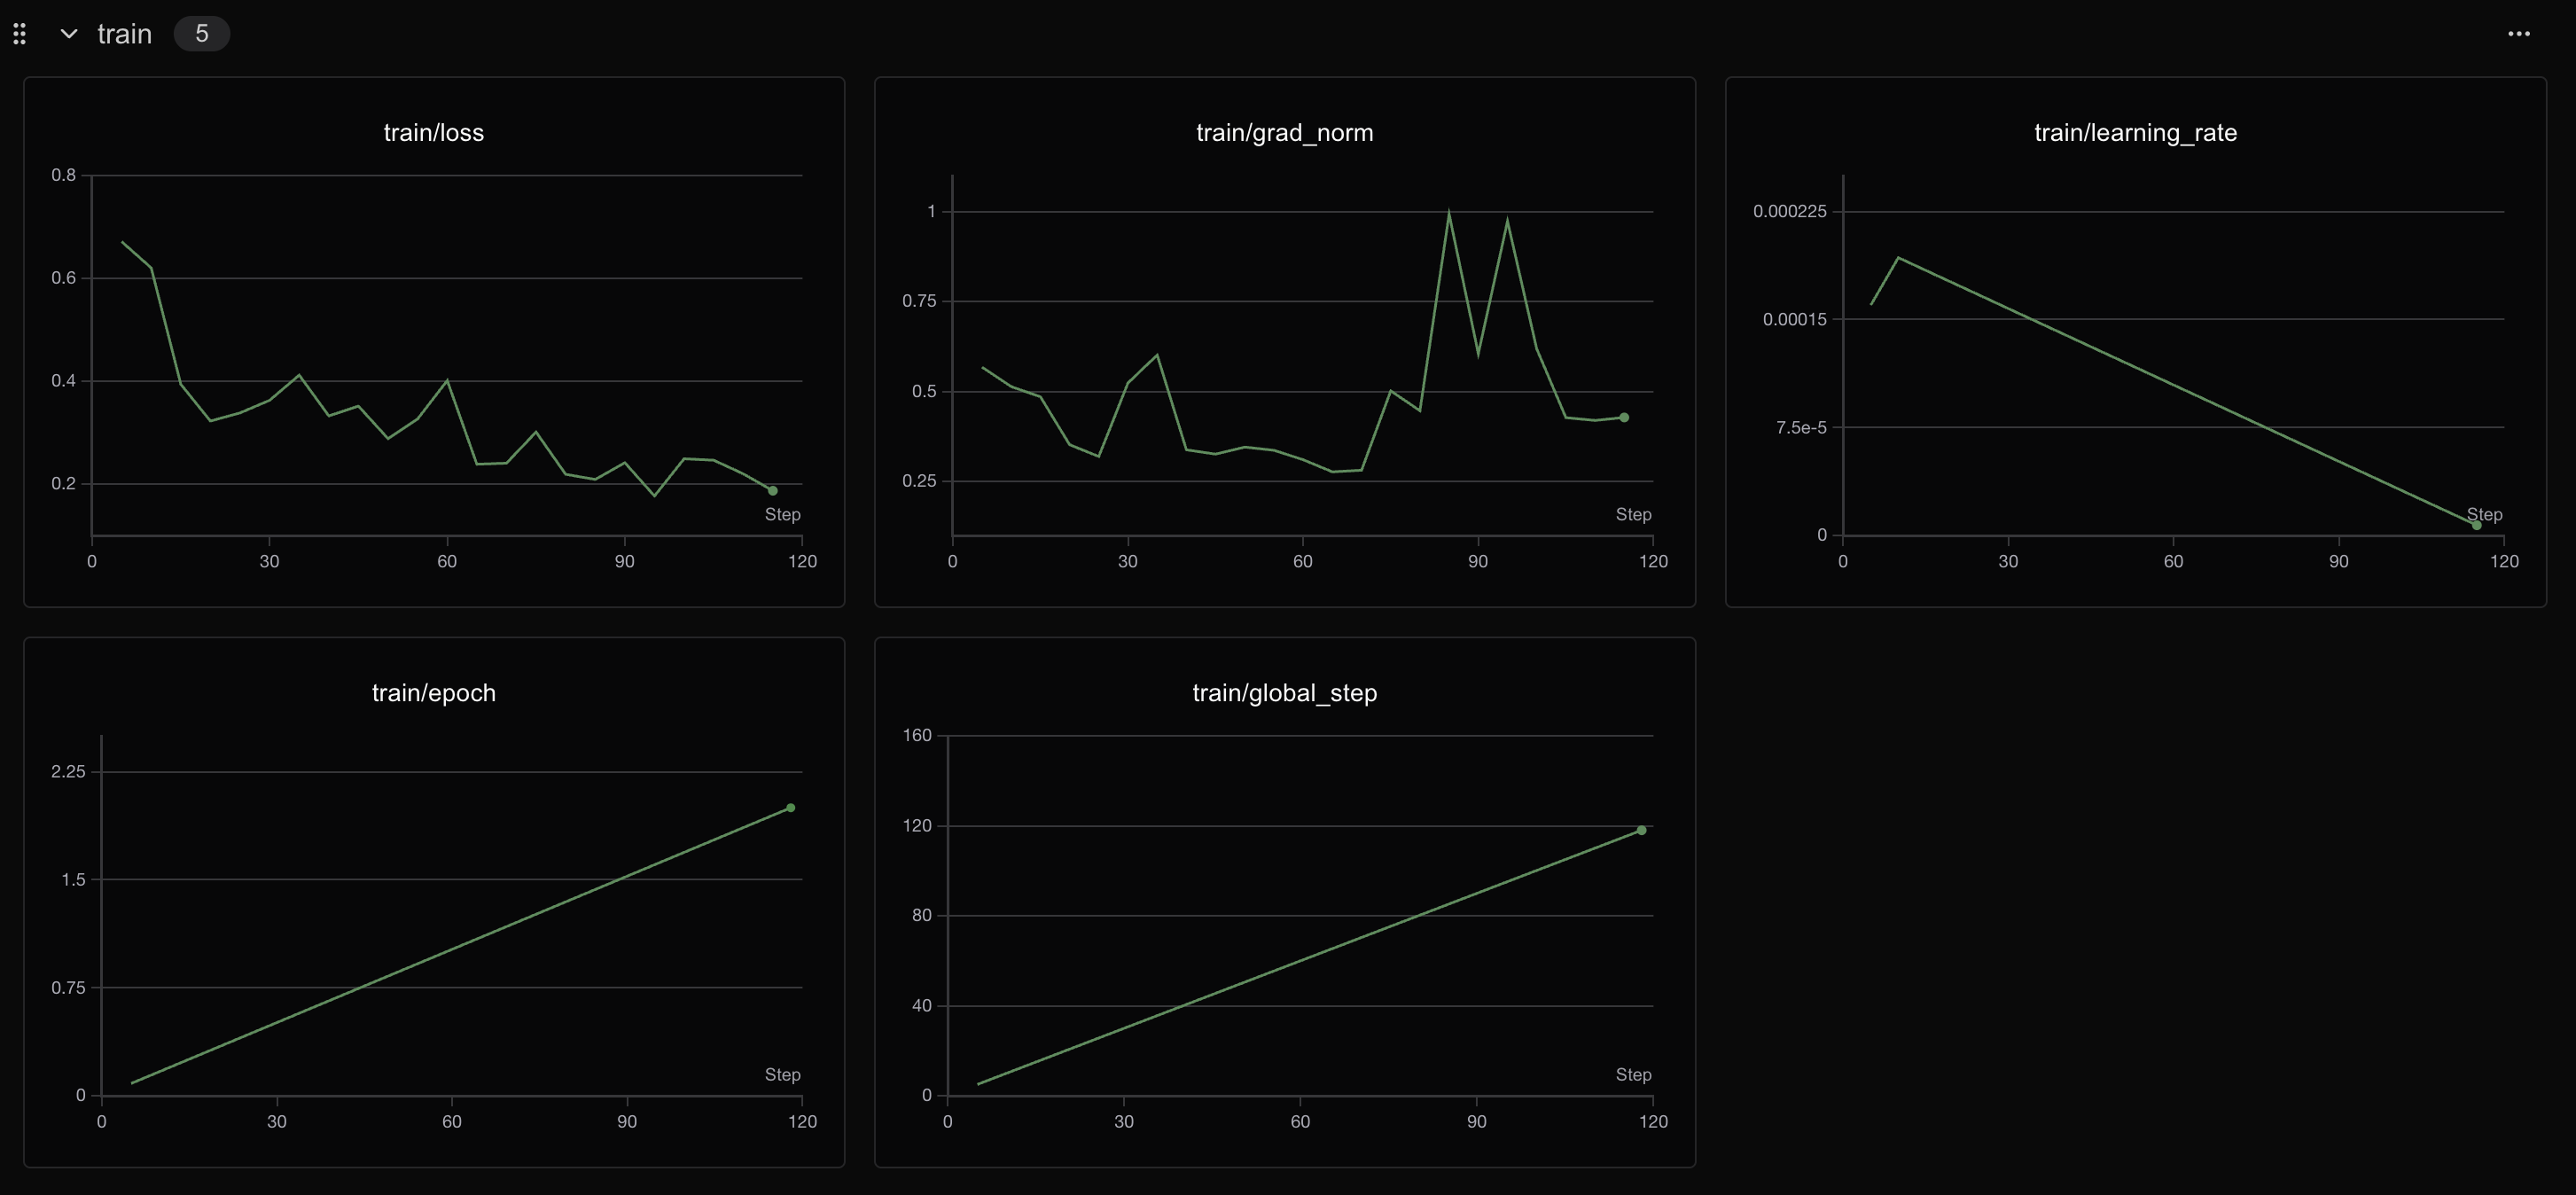
GRPO阶段
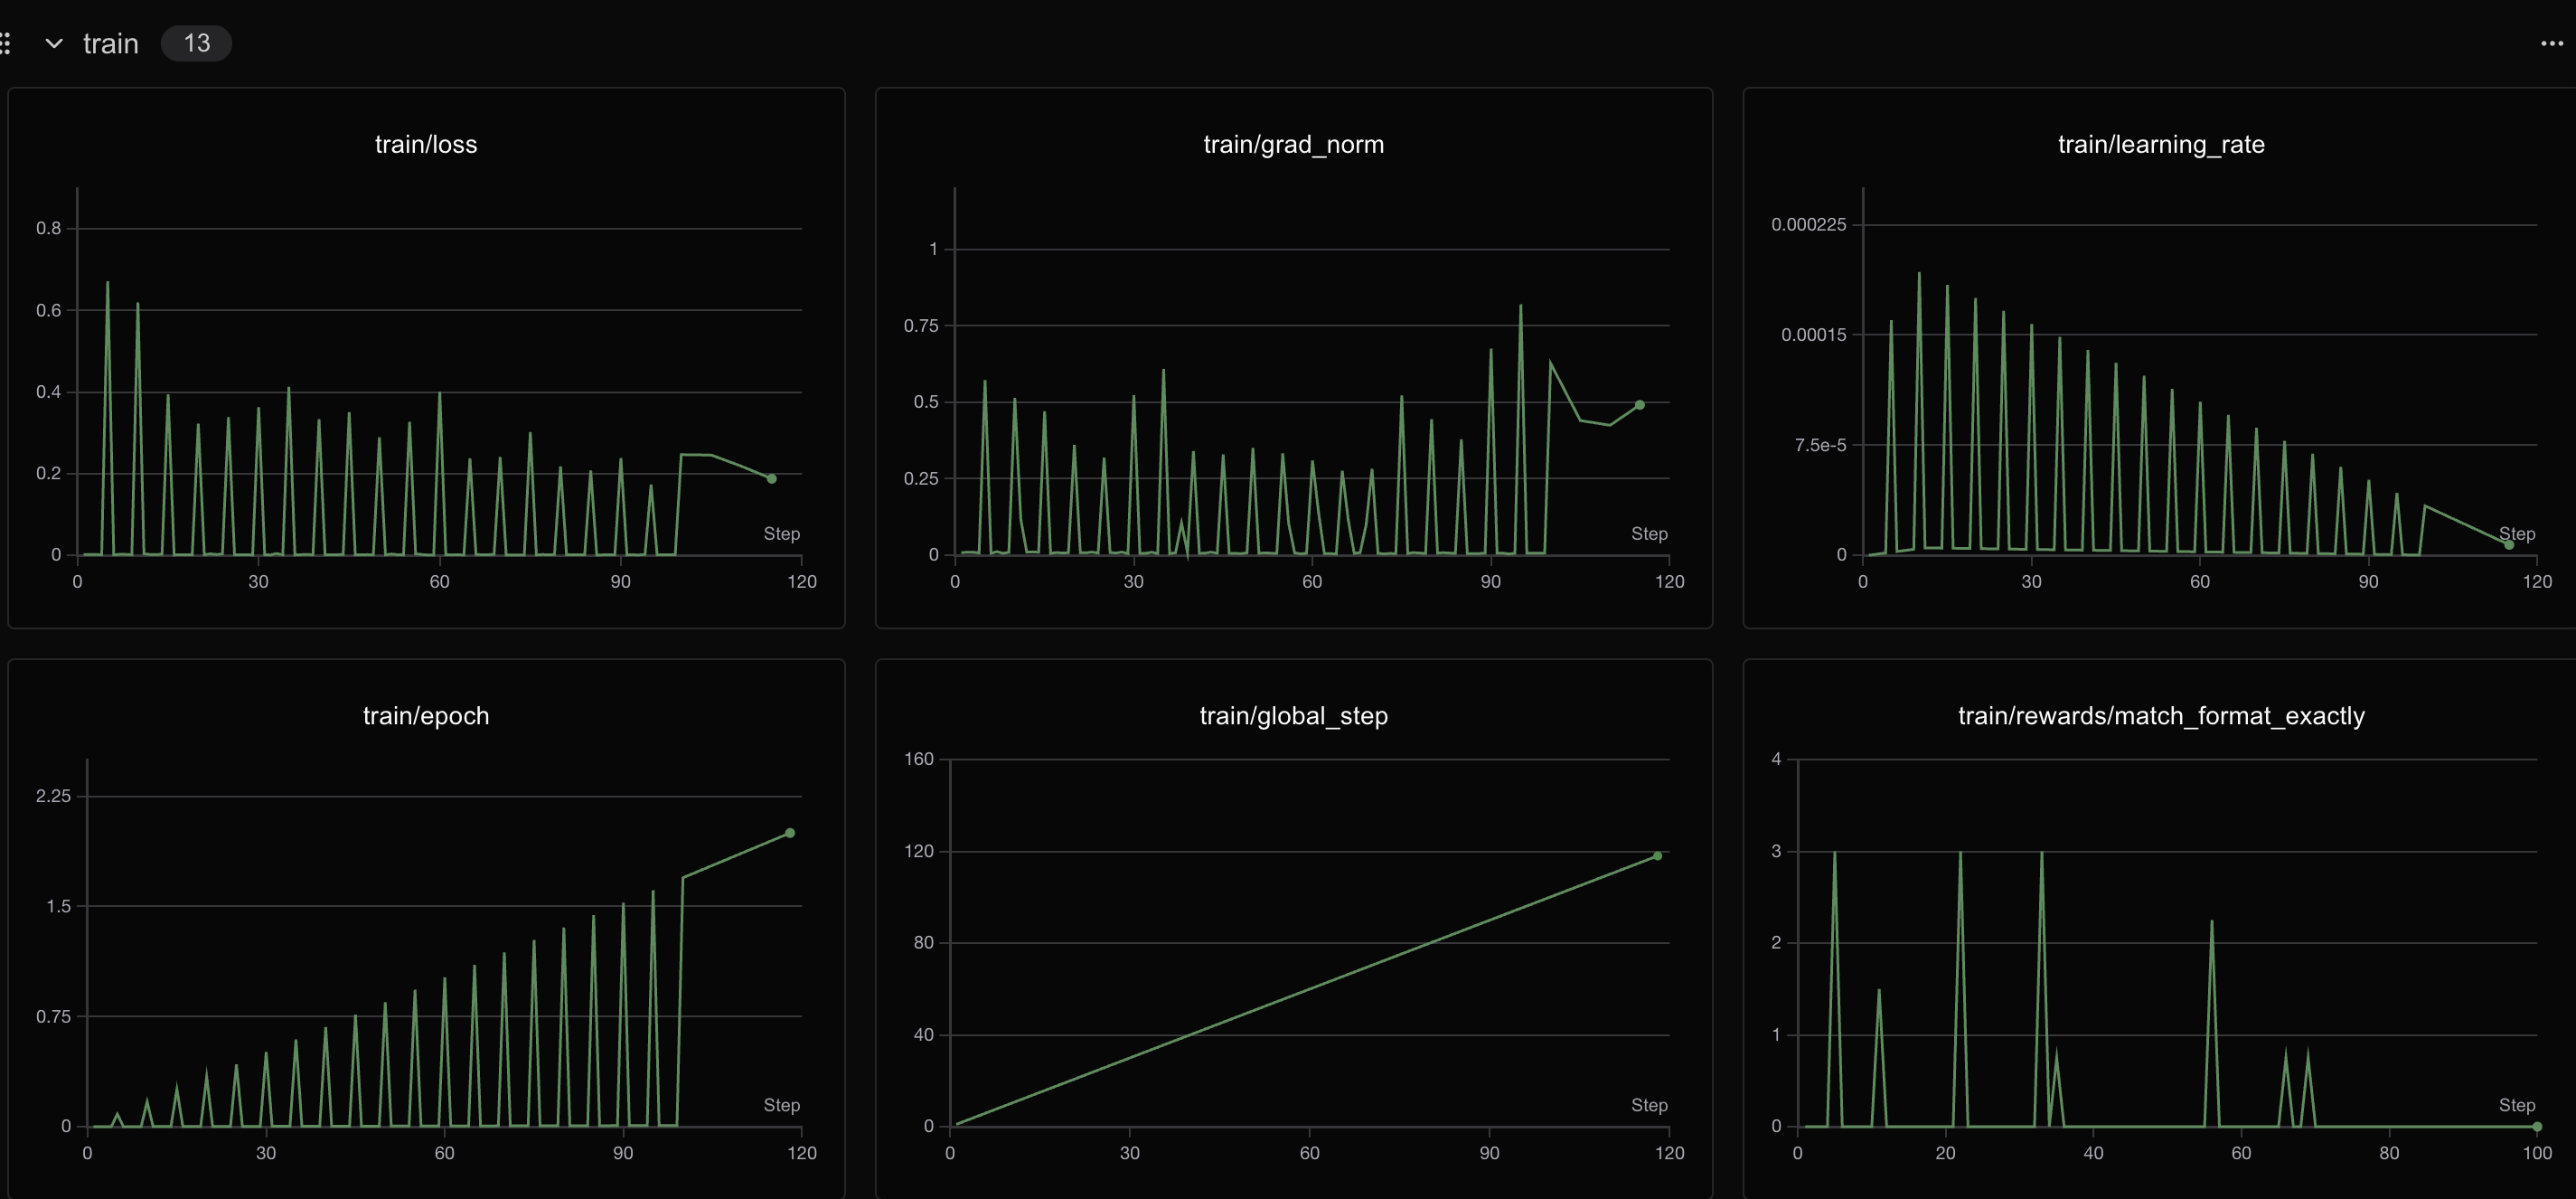
400个step之后loss会有明显变化
Congratulations!看到了这,你已经初步实现了一个简单的RL实战,掌握了使用 Unsloth 对 Qwen3 这类大模型进行 GRPO 微调的具体操作步骤,更能体会到 Unsloth 在大幅提升训练速度、显著降低显存占用方面的强大优势,从而使在有限资源下进行复杂强化学习实验成为可能!如果支持我们的工作希望得到你的star!!这是我们持续更新的最大动力!!!
完整可运行的代码:Github
综述:https://arxiv.org/abs/2001.06921
deepseek-r1:https://arxiv.org/abs/2501.12948
数学原理:https://blog.csdn.net/weixin_38991876/article/details/146474767
Unsloth:https://docs.unsloth.ai/
Qwen3-8B 模型lemonade SDK 部署调用
基础环境准备
本文基础环境如下:
----------------
Windows11
CPU AI 395
内存 128G
----------------请确定AMD芯片的版本,目前支持AI 395和 AI 370
下载 lemonade-server 进行安装

NPU 需要配备 AMD Ryzen AI 300 系列的 Windows 11 电脑及驱动安装。请先下载并安装 NPU 驱动程序,再继续操作
首先 pip 换源加速下载并安装依赖包
# 升级pip
python -m pip install --upgrade pip
# 更换 pypi 源加速库的安装
pip config set global.index-url https://pypi.tuna.tsinghua.edu.cn/simple

pip install -U huggingface_hub
pip install lemonade-sdk[dev]模型下载
在 Windows Powershell 下输入以下配置镜像站
$env:HF_ENDPOINT = "https://hf-mirror.com"
使用 huggingface_hub 中的 snapshot_download 函数下载模型,第一个参数为模型名称,参数 cache_dir 为模型的下载路径。
新建 model_download.py 文件并在其中输入以下内容,粘贴代码后请及时保存文件,如下图所示。并运行 python download_model.py amd/Qwen3-8B-awq-quant-onnx-hybrid "C:\Users\aup\.cache\huggingface\hub\models--amd--Qwen3-8B-awq-quant-onnx-hybrid" 执行下载。
#!/usr/bin/env python
"""
使用 Python API 下载 Hugging Face 模型
"""
import os
from huggingface_hub import snapshot_download

def download_model(repo_id: str, local_dir: str = None, resume_download: bool = True):
    """
    下载 Hugging Face 模型

    Args:
        repo_id: 模型仓库ID,例如 "amd/Qwen3-8B-awq-quant-onnx-hybrid"
        local_dir: 本地保存目录,如果为None则使用默认缓存目录
        resume_download: 是否支持断点续传
    """
    print(f"开始下载模型: {repo_id}")
    print(f"保存位置: {local_dir if local_dir else '默认缓存目录'}")

    try:
        # 如果指定了本地目录,使用它;否则使用默认缓存
        if local_dir:
            cache_dir = os.path.dirname(local_dir) if os.path.dirname(local_dir) else None
            local_dir_use = local_dir
        else:
            cache_dir = None
            local_dir_use = None

        # 下载模型
        downloaded_path = snapshot_download(
            repo_id=repo_id,
            local_dir=local_dir_use,
            cache_dir=cache_dir,
            resume_download=resume_download,
            local_files_only=False
        )

        print(f"\n✓ 模型下载完成!")
        print(f"保存路径: {downloaded_path}")
        return downloaded_path

    except Exception as e:
        print(f"\n✗ 下载失败: {str(e)}")
        raise

if __name__ == "__main__":
    import sys

    # 默认下载的模型
    repo_id = "amd/Qwen3-8B-awq-quant-onnx-hybrid"

    # 如果提供了命令行参数,使用它作为模型ID
    if len(sys.argv) > 1:
        repo_id = sys.argv[1]

    # 可选:指定本地保存目录
    local_dir = None
    if len(sys.argv) > 2:
        local_dir = sys.argv[2]

download_model(repo_id, local_dir)启动服务
在菜单栏里输入 Lemonade Server 启动,点击菜单里中对应的图标
然后选中对应的模型即可启动,可以对外输出兼容OpenAI的服务接口
服务测试
新建 test.py 文件并在其中输入以下内容,粘贴代码后请及时保存文件。以下代码有很详细的注释,大家如有不理解的地方,欢迎提出 issue 。
#!/usr/bin/env python
"""
简洁版本的 API 测试脚本
完全模仿 curl 请求
"""
import requests

# 发送 POST 请求(完全对应 curl 命令)
response = requests.post(
    "http://localhost:8000/api/v1/chat/completions",
    headers={"Content-Type": "application/json"},
    json={
        "model": "Qwen3-8B-Hybrid",
        "messages": [{"role": "user", "content": "Hello!"}]
    }
)

# 打印响应
print(f"Status: {response.status_code}")
print(f"Response: {response.json()}")返回结果如下
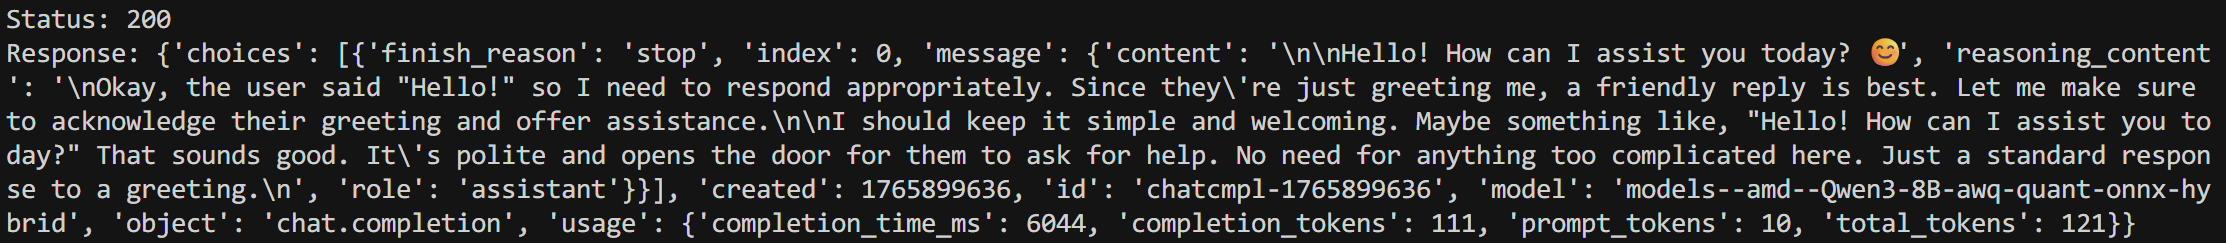
代码准备
我们可也可以使用Lemonade API 构建API服务给其他应用调用服务,新建 api.py 文件并在其中输入以下内容,粘贴代码后请及时保存文件。以下代码有很详细的注释,大家如有不理解的地方,欢迎提出 issue 。
from fastapi import FastAPI, Request
from contextlib import asynccontextmanager
from threading import Thread, Event
from transformers import StoppingCriteriaList
from lemonade.tools.server.serve import StopOnEvent
from lemonade.api import from_pretrained
from lemonade.tools.oga.utils import OrtGenaiStreamer
import uvicorn
import json
import datetime
import logging
import queue
import uuid
import asyncio

# 配置日志
logging.basicConfig(level=logging.INFO)
logger = logging.getLogger(__name__)

# 全局模型变量
model = None
tokenizer = None

# 任务队列和结果字典
task_queue = queue.Queue()
result_dict = {}
worker_thread = None
worker_running = False

# --- 模型加载逻辑 ---
def load_models():
    global model, tokenizer
    try:
        logger.info("正在加载模型...")
        model, tokenizer = from_pretrained(
            "amd/Qwen3-8B-awq-quant-onnx-hybrid",
            recipe="oga-hybrid",
        )
        logger.info("模型加载完成")
    except Exception as e:
        logger.error(f"模型加载失败: {str(e)}")
        raise

# --- 工作线程函数 ---
def worker_thread_func():
    """长期运行的工作线程,从队列中获取任务并处理"""
    global model, tokenizer, task_queue, result_dict, worker_running

    logger.info("工作线程已启动")
    worker_running = True

    while worker_running:
        try:
            # 从队列中获取任务(阻塞等待)
            task = task_queue.get(timeout=1.0)

            if task is None:  # 收到停止信号
                break

            task_id, prompt_text, max_new_tokens = task

            try:
                # 使用 chat.py 中的推理方式
                input_ids = tokenizer(prompt_text, return_tensors="pt").input_ids

                # 使用流式生成器收集完整响应
                streamer = OrtGenaiStreamer(tokenizer)
                stop_event = Event()
                stopping_criteria = StoppingCriteriaList([StopOnEvent(stop_event)])

                generation_kwargs = {
                    "input_ids": input_ids,
                    "streamer": streamer,
                    "max_new_tokens": max_new_tokens,
                    "stopping_criteria": stopping_criteria,
                }

                # 在工作线程中创建子线程来运行 generate
                # streamer 需要在另一个线程中读取,而 generate 在子线程中运行
                generate_thread = Thread(target=model.generate, kwargs=generation_kwargs)
                generate_thread.start()

                # 在工作线程中收集完整响应(从 streamer 读取)
                response = ""
                for new_text in streamer:
                    response += new_text

                # 等待生成线程完成
                generate_thread.join()

                # 将结果存入结果字典
                result_dict[task_id] = {
                    "success": True,
                    "response": response
                }

            except Exception as e:
                logger.error(f"处理任务 {task_id} 时出错: {str(e)}")
                result_dict[task_id] = {
                    "success": False,
                    "error": str(e)
                }

            # 标记任务完成
            task_queue.task_done()

        except queue.Empty:
            # 队列为空,继续循环
            continue
        except Exception as e:
            logger.error(f"工作线程错误: {str(e)}")
            continue

    logger.info("工作线程已停止")

# --- FastAPI应用 ---
@asynccontextmanager
async def lifespan(app: FastAPI):
    global worker_thread, worker_running

    try:
        load_models()

        # 启动工作线程
        worker_thread = Thread(target=worker_thread_func, daemon=True)
        worker_thread.start()
        logger.info("工作线程已启动")

        yield

    except Exception as e:
        logger.error(f"服务初始化失败: {str(e)}")
        raise
    finally:
        # 停止工作线程
        worker_running = False
        if worker_thread and worker_thread.is_alive():
            task_queue.put(None)  # 发送停止信号
            worker_thread.join(timeout=5)
            logger.info("工作线程已停止")

app = FastAPI(lifespan=lifespan)

# 处理POST请求的端点
@app.post("/")
async def create_item(request: Request):
    global task_queue, result_dict  # 声明全局变量

    json_post_raw = await request.json()  # 获取POST请求的JSON数据
    json_post = json.dumps(json_post_raw)  # 将JSON数据转换为字符串
    json_post_list = json.loads(json_post)  # 将字符串转换为Python对象
    prompt = json_post_list.get('prompt')  # 获取请求中的提示
    history = json_post_list.get('history', [])  # 获取请求中的历史记录
    max_new_tokens = json_post_list.get('max_new_tokens', 1024)  # 获取最大token数,默认1024

    # 构建提示文本(处理历史记录)
    if history:
        conversation_text = ""
        for item in history:
            if isinstance(item, list) and len(item) == 2:
                user_msg, assistant_msg = item
                conversation_text += f"User: {user_msg}\nAssistant: {assistant_msg}\n"
        prompt_text = f"{conversation_text}User: {prompt}\nAssistant:"
    else:
        prompt_text = prompt

    try:
        # 生成唯一任务ID
        task_id = str(uuid.uuid4())

        # 将任务放入队列
        task_queue.put((task_id, prompt_text, max_new_tokens))
        logger.info(f"任务 {task_id} 已加入队列")

        # 等待结果(轮询检查结果字典)
        max_wait_time = 300  # 最大等待时间(秒)
        wait_interval = 0.1  # 轮询间隔(秒)
        elapsed_time = 0

        while task_id not in result_dict:
            if elapsed_time >= max_wait_time:
                raise TimeoutError(f"任务 {task_id} 超时")
            await asyncio.sleep(wait_interval)
            elapsed_time += wait_interval

        # 获取结果
        result = result_dict.pop(task_id)

        if result["success"]:
            response = result["response"]
            now = datetime.datetime.now()  # 获取当前时间
            time = now.strftime("%Y-%m-%d %H:%M:%S")  # 格式化时间为字符串
            # 构建响应JSON
            answer = {
                "response": response,
                "status": 200,
                "time": time
            }
            # 构建日志信息
            log = "[" + time + "] " + '", prompt:"' + prompt_text + '", response:"' + repr(response) + '"'
            logger.info(log)  # 打印日志
            return answer  # 返回响应
        else:
            raise Exception(result.get("error", "未知错误"))

    except Exception as e:
        logger.error(f"处理请求时出错: {str(e)}")
        now = datetime.datetime.now()
        time = now.strftime("%Y-%m-%d %H:%M:%S")
        return {
            "response": f"错误: {str(e)}",
            "status": 500,
            "time": time
        }

# 主函数入口
if __name__ == '__main__':
    # 模型加载在 lifespan 中自动完成
    # 启动FastAPI应用
    # 用6006端口可以将autodl的端口映射到本地,从而在本地使用api
    uvicorn.run(app, host='0.0.0.0', port=6006, workers=1)  # 在指定端口和主机上启动应用