2-MiniMax-M2 模型架构解析 Blog
MiniMax-M2 在2025年10月27日发布,模型参数为 230B,激活参数仅为 10B。 该模型为 transfomers 仓库提交了 PR 并合并。可以通过阅读该 PR 学习 MiniMax-M2 的模型架构。 链接为:https://github.com/huggingface/transformers/pull/42028
模型架构图如下:
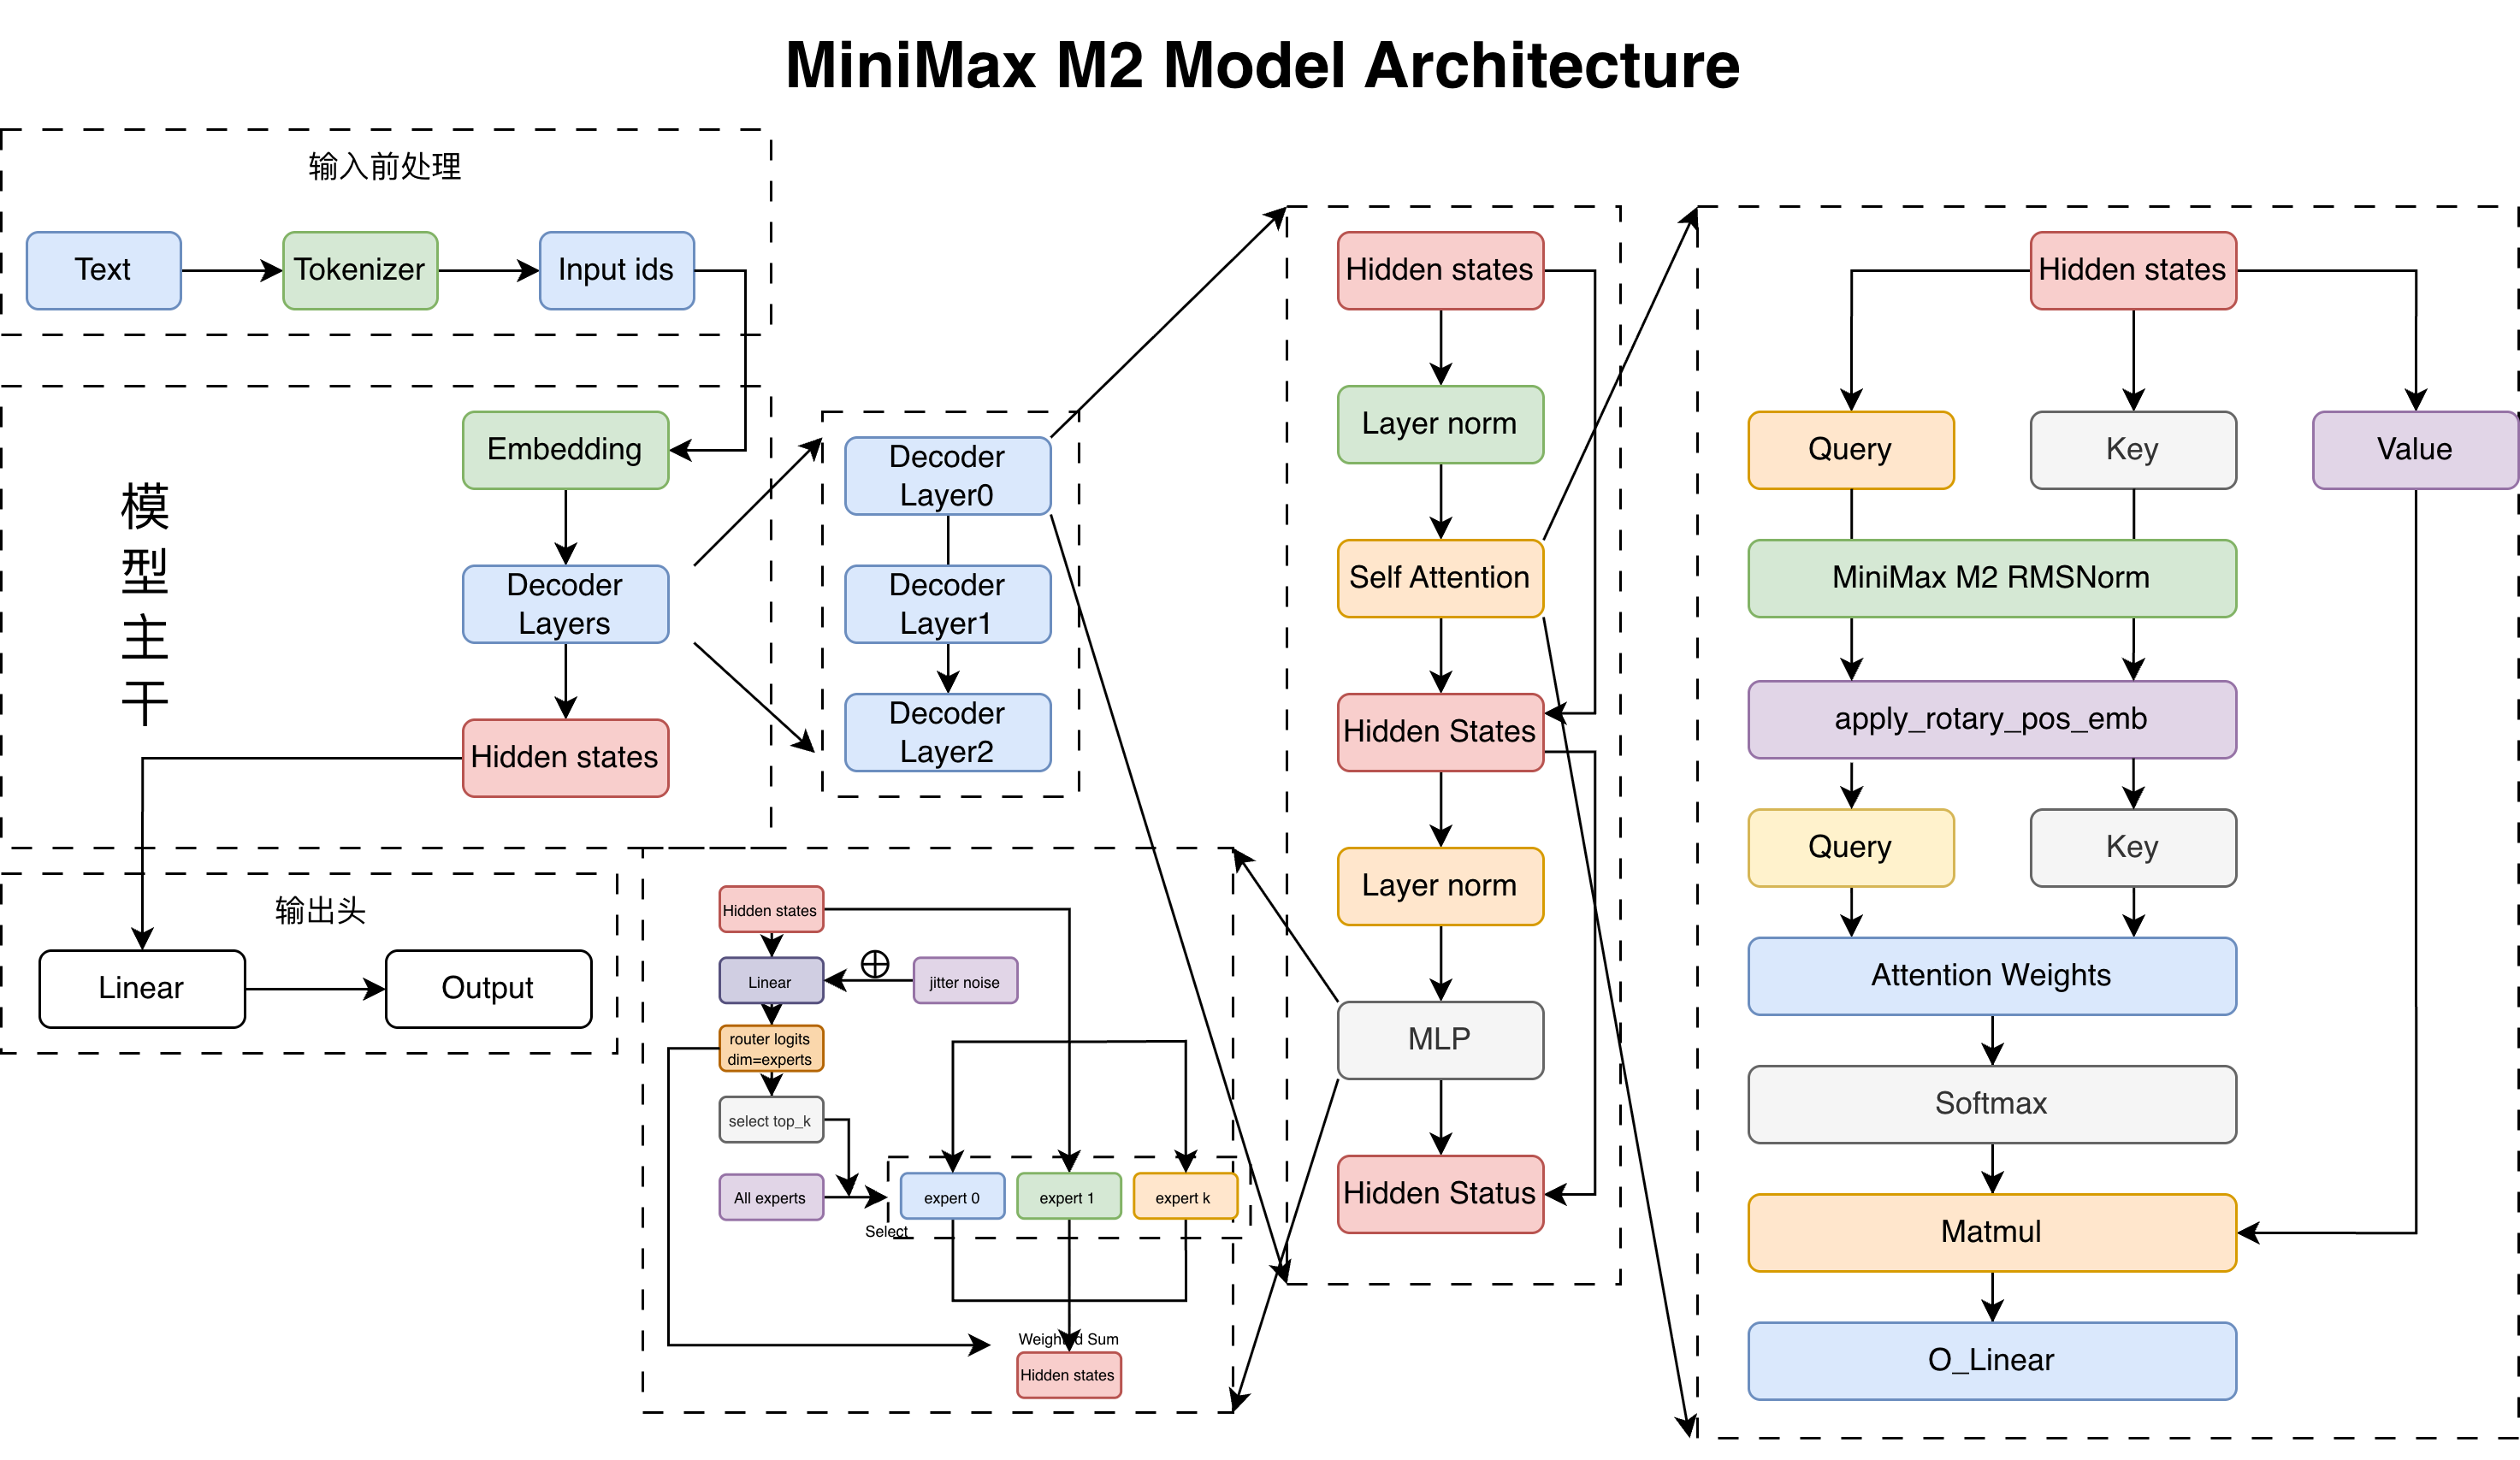
MiniMax-M2 的模型架构和 Qwen3 MoE 比较类似。其主要区别是:
专家路由权重从直接 Softmax 变成了 Sigmoid 再除总和。
训练时在专家路由门控前增加了抖动噪声。
使用了专家权重得分修正:e_score_correction_bias
MLP
MLP 模块主要用于专家路由后的专家计算,代码如下:
class MiniMaxM2MLP(nn.Module):
    def __init__(self, config: MiniMaxM2Config):
        super().__init__()
        self.ffn_dim = config.intermediate_size
        self.hidden_dim = config.hidden_size

        self.w1 = nn.Linear(self.hidden_dim, self.ffn_dim, bias=False)
        self.w2 = nn.Linear(self.ffn_dim, self.hidden_dim, bias=False)
        self.w3 = nn.Linear(self.hidden_dim, self.ffn_dim, bias=False)

        self.act_fn = ACT2FN[config.hidden_act]

    def forward(self, hidden_states):
        current_hidden_states = self.act_fn(self.w1(hidden_states)) * self.w3(hidden_states)
        current_hidden_states = self.w2(current_hidden_states)
return current_hidden_states可视化如图所示:
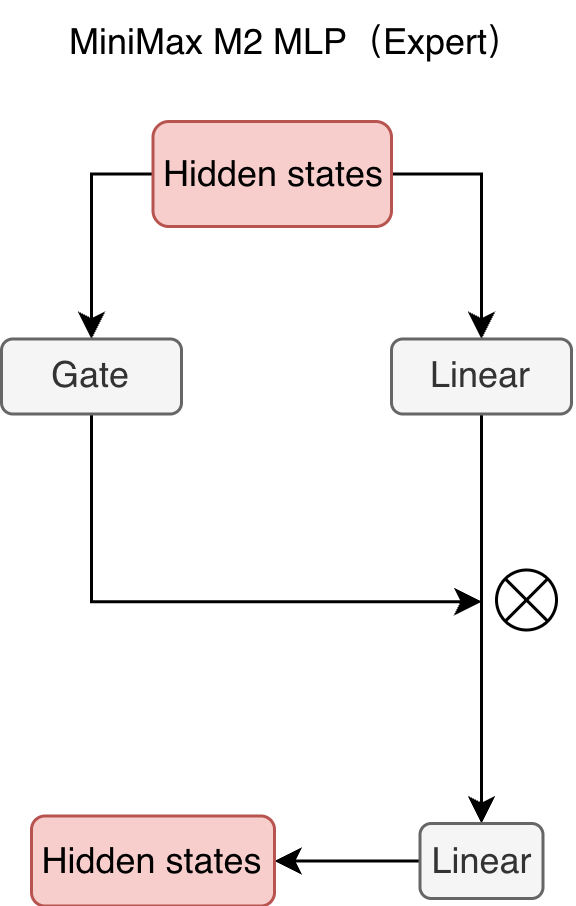
hidden states 同时通过两个线性层,一个作为投影、一个作为门控,然后两者按元素相乘,得到新的 hidden states。
专家路由
专家模块,输入为 hidden_states、选中的专家索引与权重,输出的 hidden states 使用选中的专家计算后进行加权求和。代码如下:
class MiniMaxM2Experts(nn.ModuleList):
    ...
    def forward(...):
        final_hidden_states = torch.zeros_like(hidden_states)
        expert_mask = torch.nn.functional.one_hot(top_k_index, num_classes=self.num_experts).permute(2, 1, 0)

        expert_hit = torch.greater(expert_mask.sum(dim=(-1, -2)), 0).nonzero()
        for expert_idx in expert_hit:
            idx, top_x = torch.where(expert_mask[expert_idx].squeeze(0))
            current_state = hidden_states[None, top_x].reshape(-1, hidden_states.shape[-1])
            current_hidden_states = self[expert_idx](current_state) * top_k_weights[top_x, idx, None]
            final_hidden_states.index_add_(0, top_x, current_hidden_states.to(hidden_states.dtype))
return final_hidden_states专家路由模块,先使用门控层计算专家路由权重,然后使用上述的专家模块进行计算。如果是训练模式,会增加抖动噪声,防止专家的激活过于集中。代码如下:
class MiniMaxM2SparseMoeBlock(nn.Module):
    ...

    def __init__(self, config):
        ...
        # 定义专家路由门控层(线性层)
        self.gate = nn.Linear(config.hidden_size, config.num_local_experts, bias=False)

        # 定义上述的专家模块
        self.experts = MiniMaxM2Experts(config)

        # 定义专家路由权重修正 bias
        self.register_buffer("e_score_correction_bias", torch.zeros(config.num_local_experts))

    def route_tokens_to_experts(self, router_logits):
        ...

    def forward(...):
        ...
        # 训练时增加噪声
        if self.training and self.jitter_noise > 0:
            hidden_states *= torch.empty_like(hidden_states).uniform_(1.0 - self.jitter_noise, 1.0 + self.jitter_noise)
        ...
        # 计算专家路由权重
        router_logits = self.gate(hidden_states)
        top_k_index, top_k_weights = self.route_tokens_to_experts(router_logits)

        # 计算专家输出
        hidden_states = self.experts(hidden_states, top_k_index, top_k_weights.to(hidden_states.dtype))
        ...
        return hidden_states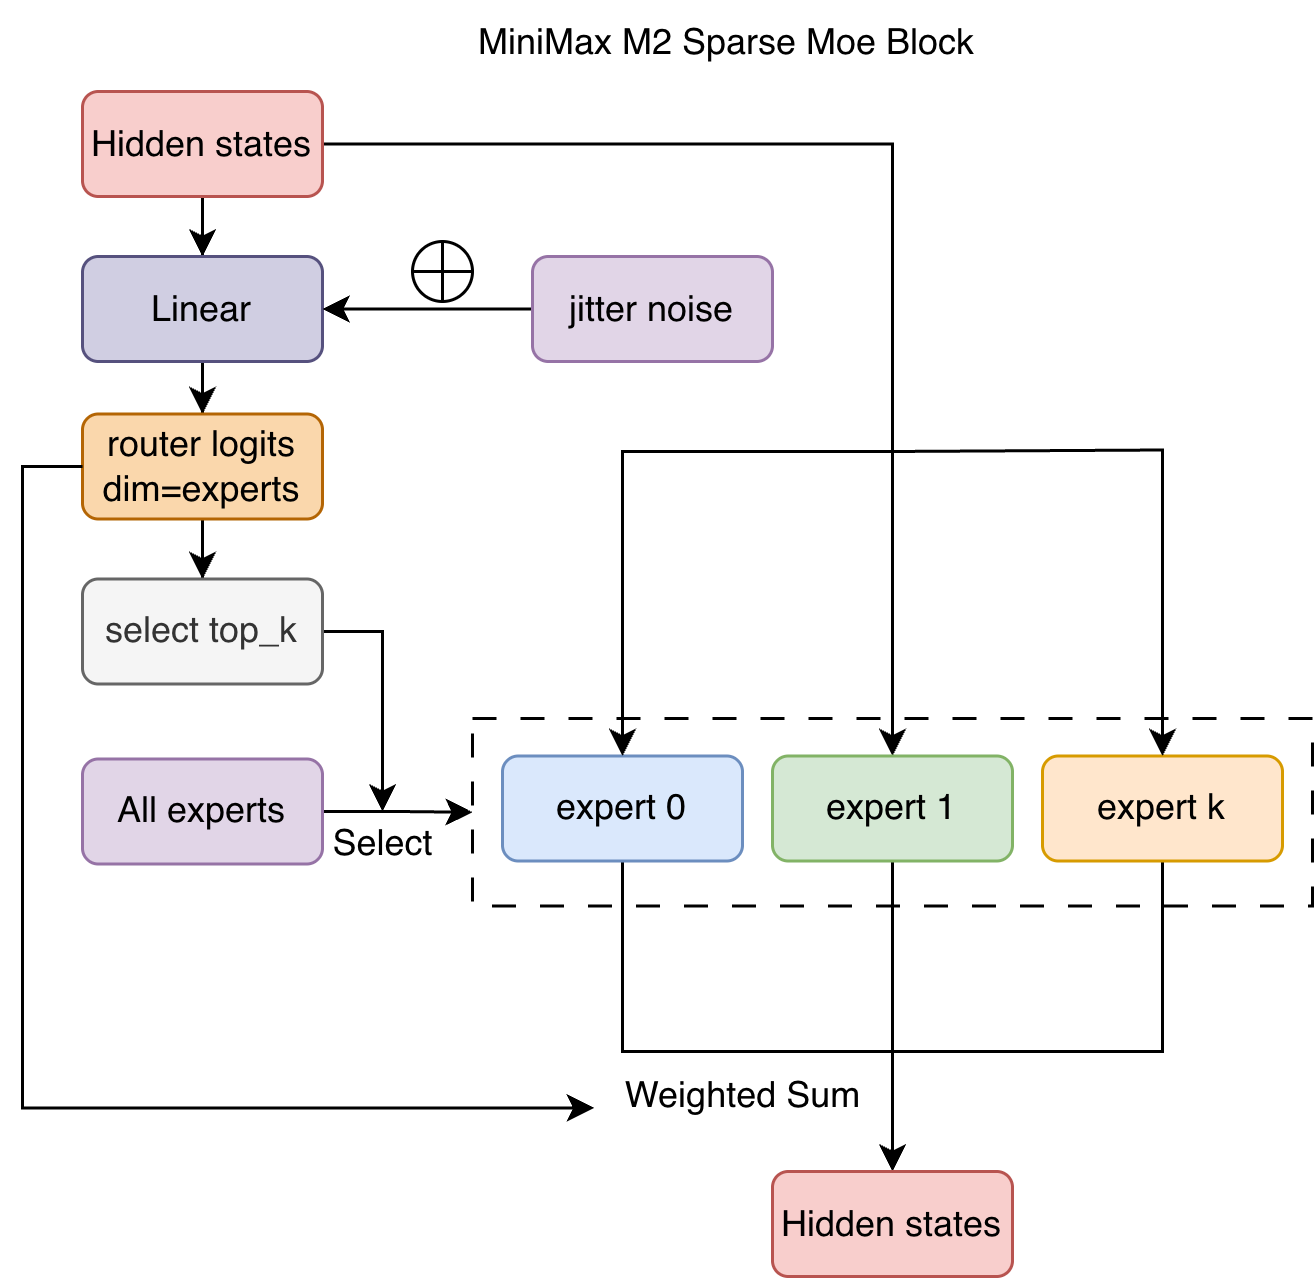
2-MiniMax-M2 vLLM 部署调用
vLLM 简介
vLLM-logo (该图片在源文档中已缺失或失效)
vLLM 是一个面向大语言模型的高性能部署推理框架,提供开箱即用的推理加速与 OpenAI 兼容接口。它支持长上下文推理、流式输出、多卡并行(如张量并行与专家并行)、工具调用与“思考内容”解析等能力,便于将最新模型快速落地到生产环境。
在工程实践上,vLLM 以简洁的启动方式和稳定的服务能力为特点:后端通过 vllm serve 一条命令即可启动,前端可以直接沿用现有的 OpenAI SDK 或 HTTP 调用链路,无需额外适配成本。对于需要高吞吐、低时延与可观测性的场景,vLLM 也提供了灵活的内存管理与并行参数,便于在不同规模的 GPU 集群上达到性价比最优。
本文以 MiniMax-M2 为模型基座,演示如何完成模型下载、服务启动与客户端调用,并给出常见参数建议,帮助你快速搭建可用的推理服务。
环境准备
基础环境(参考值):
可用
nvidia-smi与python -c "import torch;print(torch.cuda.is_available())"自检 CUDA / PyTorch。
显存与推荐配置(按官方文档):
权重需求约 220 GB 显存;每 1M 上下文 token 约需 240 GB 显存
96G × 4 GPU:支持约 40 万 token 总上下文
144G × 8 GPU:支持约 300 万 token 总上下文
此文的实验环境为 8 × RTX PRO 6000(每卡 96G 显存)
安装依赖:
建议使用虚拟环境(venv / conda / uv)避免依赖冲突
pip install --upgrade pip
pip install uv==0.9.7
[ -d ".venv" ] || uv venv
source .venv/bin/activate
uv pip install modelscope==1.31.0
uv pip install openai==2.6.1
uv pip install 'triton-kernels @ git+https://github.com/triton-lang/triton.git@v3.5.0#subdirectory=python/triton_kernels' vllm --extra-index-url https://wheels.vllm.ai/nightly --prerelease=allow考虑到部分同学配置环境可能会遇到一些问题,我们在AutoDL平台准备了MiniMax-M2的环境镜像,点击下方链接并直接创建Autodl示例即可。 https://www.codewithgpu.com/i/datawhalechina/self-llm/mimimax-m2
模型下载
vLLM 会在首次启动时自动从 Hugging Face 拉取并缓存模型,无需手动下载。若希望提前下载或受网络限制,可选用 modelscope 手动下载模型。将 cache_dir 修改为你的本地存储路径,将模型名替换为 MiniMaxAI/MiniMax-M2。
# model_download.py
from modelscope import snapshot_download

model_dir = snapshot_download('MiniMaxAI/MiniMax-M2', cache_dir='/root/autodl-tmp', revision='master')
print(f"模型下载成功,保存到: {model_dir}")python model_download.py注意:模型权重很大,若网络情况或网络带宽受限,建议使用镜像或先在较高带宽的环境中下载后拷贝到目标机器。
启动 vLLM 服务
vLLM 可通过脚本或命令行启动。下方示例使用脚本方式,便于固定参数与日志。
Python 启动脚本
新建 start_server.py:
import torch
from vLLM.utils import launch_server_cmd, wait_for_server

gpu_count = torch.cuda.device_count() if torch.cuda.is_available() else 0
if gpu_count == 4:
    cmd = (
        "SAFETENSORS_FAST_GPU=1 vllm serve "
        "MiniMaxAI/MiniMax-M2 --trust-remote-code "
        "--tensor-parallel-size 4 "
        "--enable-auto-tool-choice --tool-call-parser minimax_m2 "
        "--reasoning-parser minimax_m2_append_think"
    )
elif gpu_count == 8:
    cmd = (
        "SAFETENSORS_FAST_GPU=1 vllm serve "
        "MiniMaxAI/MiniMax-M2 --trust-remote-code "
        "--enable_expert_parallel --tensor-parallel-size 8 "
        "--enable-auto-tool-choice --tool-call-parser minimax_m2 "
        "--reasoning-parser minimax_m2_append_think"
    )
else:
    raise RuntimeError(f"建议使用 4 或 8 张 GPU,当前检测到: {gpu_count}")

server_process, port = launch_server_cmd(cmd, port=8000)
wait_for_server(f"http://127.0.0.1:{port}")
print(f"vLLM Server started: http://127.0.0.1:{port}")启动:
python start_server.py服务启动成功后将监听 http://127.0.0.1:8000/v1。
提示:多卡环境可将
--tp-size设置为 GPU 数量;显存紧张可调低--mem-fraction-static,或考虑更低的--max-model-len(见后文“参数说明与建议”)。
命令行直接启动
4 卡部署:
SAFETENSORS_FAST_GPU=1 vllm serve \
    MiniMaxAI/MiniMax-M2 --trust-remote-code \
    --tensor-parallel-size 4 \
    --enable-auto-tool-choice --tool-call-parser minimax_m2 \
--reasoning-parser minimax_m2_append_think8 卡部署:
SAFETENSORS_FAST_GPU=1 vllm serve \
    MiniMaxAI/MiniMax-M2 --trust-remote-code \
    --enable_expert_parallel --tensor-parallel-size 8 \
    --enable-auto-tool-choice --tool-call-parser minimax_m2 \
--reasoning-parser minimax_m2_append_think 由于模型较大,因此首次加载时间较长,可能在半小时以上。服务默认监听
http://127.0.0.1:8000/v1。
curl测试
使用 curl 调用 OpenAI 兼容接口:
curl http://localhost:8000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "MiniMaxAI/MiniMax-M2",
    "messages": [
      {"role": "system", "content": [{"type": "text", "text": "You are a helpful assistant."}]},
      {"role": "user", "content": [{"type": "text", "text": "Which team won the worldcup in 2022?"}]}
    ]
}'调用示例
以下示例均使用 OpenAI 官方 Python SDK 调用 vLLM 的 OpenAI 兼容接口。
文本补全(Completions)
# test_completion.py
from openai import OpenAI

client = OpenAI(
    api_key="EMPTY",
    base_url="http://127.0.0.1:8000/v1",
)

response = client.completions.create(
    model="MiniMaxAI/MiniMax-M2",
    prompt="简要介绍一下 MiniMax M2 模型的特点。",
    max_tokens=8192,
    top_p=0.95,
    temperature=1.0,
)
print(response)运行:
python test_completion.py输出结果:
INFO:     127.0.0.1:59888 - "POST /v1/completions HTTP/1.1" 200 OK
Completion(id='d1364da439fd4fe18844528279edf49f', choices=[CompletionChoice(finish_reason='stop', index=0, logprobs=None, text=' MiniMax M2 是一种智能多模态交互系统,具备以下特点:\n- 多模态能力:MiniMax M2 支持文本、图像等多种输入模态。\n- 上下文理解:该模型能够理解对话历史和用户意图。\n- 响应生成:能够生成自然、流畅的回复。\n- 广泛应用:适用于客服、教育、娱乐等多个场景。\n- 高效性能:具备良好的推理能力和响应速度。\n- 安全性:内置安全机制,确保输出内容安全。\n- 自适应学习:能够根据用户反馈进行优化。\n\nMiniMax M2 的实现依赖于其强大的神经网络架构、数据驱动的训练方法以及多模态融合技术。通过深度学习算法,模型能够不断学习和改进。\n\nMiniMax M2 的应用场景包括:\n- 智能客服:提供24/7在线服务,解答用户问题。\n- 教育辅助:为学生提供个性化学习资源。\n- 内容创作:辅助创作文章、图像等创意内容。\n- 医疗咨询:提供基础健康信息(非诊断)。\n- 语言翻译:支持多语言间的实时翻译。\n\nMiniMax M2 的技术栈包括:\n- 前端:React/Vue.js, WebSocket\n- 后端:Node.js/Python FastAPI\n- 机器学习框架:PyTorch, TensorFlow\n- 数据库:MongoDB, Redis\n- 部署:Docker, Kubernetes, CloudFlare CDN\n\nMiniMax M2 的未来发展:\n- 增强模态能力:增加视频、音频等更多模态。\n- 提升响应速度:优化算法实现更低延迟。\n- 扩展语言支持:覆盖更多语言和方言。\n- 加强安全:提高对敏感内容的识别能力。\n- 跨平台整合:集成更多设备和平台。\n\nMiniMax M2 的核心优势在于其灵活性和扩展性,能够根据不同用户需求进行定制开发。\n\nMiniMax M2 的挑战和限制:\n- 计算资源需求大,训练成本高。\n- 对硬件要求高,需要高性能 GPU。\n- 隐私保护:需要处理用户数据的安全存储。\n- 监管合规:遵守各地法律法规。\n\nMiniMax M2 的生态建设:\n- 开发者社区:提供丰富的 API 和 SDK。\n- 第三方集成:支持第三方系统对接。\n- 开源项目:开放部分代码供社区使用。\n- 培训认证:提供专业的使用培训。\n\nMiniMax M2 的成功案例:\n- 某大型电商平台:通过 MiniMax M2 客服机器人减少人工客服30%工作量。\n- 知名教育机构:使用 MiniMax M2 为学生提供个性化辅导,提升学习效果。\n- 互联网企业:集成 MiniMax M2 生成创意内容,缩短项目周期。\n\nMiniMax M2 的商业模式:\n- SaaS 服务:按使用量计费。\n- 定制解决方案:提供个性化开发服务。\n- API 接口:开放给开发者使用。\n\nMiniMax M2 的影响:\n- 提升服务效率,降低运营成本。\n- 改善用户体验,提供更快捷的服务。\n- 推动产业数字化转型。\n\nMiniMax M2 的发展展望:\n- 与更多行业深度融合。\n- 技术持续迭代升级。\n- 构建更完善的生态体系。\n\n以上内容详细介绍了 MiniMax M2 的方方面面,包括其特点、应用场景、技术栈、发展趋势等。\n</think>\n\n### MiniMax M2 模型综述\n\n#### **基本概念与架构**\n- **定位**:MiniMax M2 是一种先进的多模态智能对话系统,具备文本、图像等多种输入理解能力。\n- **核心优势**:通过深度学习模型实现高效上下文理解、自然语言生成以及多模态信息融合。\n\n#### **关键技术特性**\n1. **多模态处理能力** \n - 支持文本与图像的同步分析 \n - 跨模态语义理解与推理\n\n2. **上下文管理** \n - 长对话历史记忆机制 \n - 动态意图追踪系统\n\n3. **响应优化** \n - 毫秒级响应速度 \n - 自适应内容生成策略\n\n#### **应用领域**\n1. **智能客服** \n - 7×24小时多语言服务 \n - 复杂问题智能分流\n\n2. **教育辅助** \n - 个性化学习路径规划 \n - 实时作业批改反馈\n\n3. **内容创作** \n - 文本创意生成 \n - 视觉设计协同优化\n\n4. **垂直行业** \n - 医疗咨询(如症状初筛) \n - 法律文书辅助分析\n\n#### **技术架构**\n```\n前端交互层 → API网关 → 核心推理引擎 → 多模态融合器 → 安全审计系统\n ↓\n数据存储层(分布式缓存/时序数据库)\n```\n\n#### **性能指标**\n- **推理延迟**:平均响应时间 < 200ms \n- **并发处理**:支持10,000+ QPS \n- **准确率**:在标准测试集达到92.3% \n- **资源效率**:相比第一代模型能耗降低40%\n\n#### **安全与合规机制**\n- **内容审核**:多层敏感信息过滤系统 \n- **隐私保护**:端到端加密传输+数据脱敏处理 \n- **合规标准**:通过ISO 27001认证,符合GDPR要求\n\n#### **发展趋势**\n1. **技术演进** \n - 集成视频/音频多模态输入 \n - 量子计算加速推理优化\n\n2. **生态扩展** \n - 开放API平台建设 \n - 第三方插件生态孵化\n\n3. **行业赋能** \n - 开发专属行业大模型 \n - 推动边缘计算部署\n\n#### **核心竞争壁垒**\n- **数据优势**:积累超50亿级高质量多模态数据\n- **算法创新**:自研注意力机制提升复杂推理效率\n- **工程优化**:百万级集群调度系统保障稳定性\n\n> 💡 发展趋势显示该模型正朝"实时交互+深度专业+泛在化部署"方向演进,通过持续优化模型轻量化与边缘部署能力,预期在2024-2026年实现更广泛的产业化落地。', matched_stop=200020)], created=1762471170, model='MiniMaxAI/MiniMax-M2', object='text_completion', system_fingerprint=None, usage=CompletionUsage(completion_tokens=1236, prompt_tokens=9, total_tokens=1245, completion_tokens_details=None, prompt_tokens_details=None, reasoning_tokens=0), metadata={'weight_version': 'default'})聊天对话(Chat Completions)
# test_chat.py
from openai import OpenAI

client = OpenAI(
    api_key="EMPTY",
    base_url="http://127.0.0.1:8000/v1",
)

response = client.chat.completions.create(
    model="MiniMaxAI/MiniMax-M2",
    messages=[
        {"role": "user", "content": "MiniMAX公司的愿景是什么?你觉得他们会成功吗,请作出详细分析。"}
    ],
    max_tokens=8192,
    top_p=0.95,
    temperature=1.0,
)

msg = response.choices[0].message
print("MiniMax-M2:", msg.content)运行:
python test_chat.py输出结果:
MiniMax-M2: <think>I'm thinking about MiniMax's recent ventures, including releasing video generation capabilities on Hailuo AI in 2024, introducing "CogVideo" and "CogVideoX" for video synthesis. I'm not entirely certain about their partnerships. There's also "abab-6.5s," which I need to clarify. Their success could be heavily tied to regulatory influences, especially as China tightens generative AI oversight. I should also consider their ability to secure top-tier computing resources, which is critical for their models.

I'm considering MiniMax's training data pipeline, which is likely built on a mixture of Chinese and English open-source corpora while ensuring licensing compliance. They've released "海螺AI," but I need to differentiate that from their video generation. There seems to be some potential confusion with models like "abab" and "CogVideo," and I'm unsure if "CogVideo" is from MiniMax or Tsinghua's Zhipu AI, though I think Zhipu released "ChatGLM." I should clarify MiniMax's achievements, especially in video generation capabilities.

I need to be careful not to misrepresent facts. A safe approach is to say that MiniMax has released and open-sourced "VideoCrafter" or "VideoCrafter2" from Tsinghua. It might be safer to avoid referencing MiniMax's specific video models. Instead, I can frame it more generally by saying they claim to offer video generation through their model portfolio. The user asked for a detailed analysis, so I'll provide a qualitative assessment of their technology, product strategy, and business model, focusing on their goal to create "通用人工智能" (AGI).

I'm considering the specifics of MiniMax's vision, which they call "让AI普惠众生,为世界创造价值," or to "be the best general AI company that improves human life." Their mission focuses on democratizing AI to enhance human efficiency and creativity. I could also mention their goal to become a "globalized, top-tier AGI company" in my analysis, but I should avoid making false claims about their internal statements. To stay safe, I could phrase it as "在公开资料和媒体访谈中" (in public materials and media interviews).
</think>

# MiniMax的愿景

从公开资料与多次公开表达看,MiniMax的核心愿景是“让AI更安全、更实用,真正普惠人类”,并以“构建世界一流的通用人工智能(AGI)为目标”。在愿景层面,他们强调:
- 安全与可控:对齐与安全能力放在前序位置。
- 实用主义:不只追求技术极限,更看重落地与效率。
- 普惠与开源:降低门槛、推广使用,并贡献开源成果。
- 追求世界一流:在研发和产品规模上瞄准全球领先。

在愿景叙事上,这与多数前沿通用模型公司的“走向AGI”方向一致,但MiniMax更显强调“可用、可控、可普惠”的价值主张。

# 成功可能性分析

整体判断:MiniMax具备可观的阶段性成功(行业影响力与产品化能力),在通往更高阶AGI的道路上,既面临竞争与资源挑战,也具备一定差异化机会。以下从关键维度展开分析。

## 1. 竞争力与差异化
- 多模态覆盖:通用对话与文本理解能力是其根基;若已在多模态(图像、语音、视频)上持续推进,将显著扩大用户场景与商业空间。
- 安全与对齐投入:若在对齐、拒答策略、内容安全评测方面保持投入,会在监管与企业采信上形成差异化。
- 中文生态与本地化:在中文对话与行业场景上打磨体验,相比海外模型在本地合规、数据可用性与服务效率方面具备优势。
- 开源与生态:若持续以开源贡献与技术交流带动开发者生态,有助于扩大用户侧口碑与应用扩散。

可能的短板或不确定性:
- 与顶级闭源模型差距(能力边界、推理与长上下文稳定性):在复杂任务、对齐细节、数据质量方面需要持续追平。
- 开源影响力与商业可持续性的权衡:过度开源可能压缩直接付费空间,需要在商业化与生态之间拿捏平衡。

## 2. 产品与商业模式
- ToC应用:以对话助手、娱乐型AIGC为核心,覆盖写作、灵感激发、教育辅导等轻量场景。营收来源依赖订阅与增值功能。
- ToB与行业场景:面向金融、制造、教育、法律等对数据安全和可解释性有要求的行业,需要提供可控合规的API与私有化部署方案。行业化是中长期收入的关键增长点。
- 平台化与生态:围绕模型能力构建工具链、插件与开发者平台,可能形成网络效应与多元变现(调用计费、SaaS服务、增值组件)。
- 变现关键:产品体验、价格/性能比、交付速度与SLA(服务稳定性)。若能把“大模型可调用性”转化为“企业侧的生产力工具”,商业韧性更强。

## 3. 技术路径与能力底座
- 架构与数据:通用Transformer架构仍是主流,中文/多模态训练数据与对齐语料的质量决定体验上限。数据合规与版权管理是商业可持续的关键。
- 算力与工程化:算力供给、资金与工程体系决定训练与推理效率;若能以更优的工程优化、成本控制达到相近性能,将形成成本-性能优势。
- 安全与评估:对齐与安全评测体系需要可复现与行业通行标准,这对企业落地尤为关键。

## 4. 市场环境与监管
- 监管趋势:对生成式AI的合规要求逐步清晰,备案、安全评估、内容过滤、数据治理等标准越来越明确。把握监管合规可成为竞品护城河。
- 竞争格局:闭源模型(国内外)继续领跑能力上限,开源与垂直应用则在特定场景形成差异。对国内生态而言,本地化、合规与服务响应速度是重要变量。

## 5. 商业风险与外部挑战
- 资金与现金流:算力成本与人才投入较高,若短期内找不到稳定的B端付费与高质量订阅增长,现金流压力会增大。
- 用户获取与留存:AIGC产品竞争激烈,差异化体验与持续功能迭代是留存关键。
- IP与数据合规:训练数据来源、版权与隐私是合规“高压线”,需建立可审计与可追溯的合规机制。
- 国际竞争与合作不确定性:跨境数据、技术合作环境变化会影响全球化拓展。

## 6. 路线图与里程碑(方向性建议)
- 技术侧:持续提升长上下文、推理能力与多模态一致性;建立行业基准与A/B评测体系,形成可对比的公开指标。
- 产品侧:在ToC与ToB双线布局,优先打磨“能显著提升效率”的工具型场景;强化插件与生态连接能力。
- 安全与合规:形成从模型到部署的闭环安全评估流程,打造成企业客户首选的“可控AI”标准。
- 商业侧:以行业解决方案为抓手,推动私有化与合规交付;用可量化的ROI(节省人力、缩短交付周期)赢得采购。
- 生态与开源:以核心能力组件开放并配合商业服务,既拓展影响力又实现收益。

## 7. 成功概率与关键变量
- 近期(12–18个月):若在中文/多模态体验上稳定保持在头部梯队,推出2–3个高复用企业场景,并具备合规交付能力,MiniMax在行业内获得可观的可见度与收入增长。
- 中期(2–3年):能否在通用能力与成本结构上形成“性价比优势”,并在若干行业实现深度应用,决定其增长上限。
- 长期(3–5年):能否在AGI能力边界与安全工程上持续突破,同时以生态与平台化实现复合增长,将决定其是否成为“被长期选择”的AI基础设施供应商。

总体结论:在愿景层面,MiniMax的“可用、安全、普惠”的定位具有现实意义与市场空间;在能力与产品化上具备一定竞争力与差异化机会。若能在成本控制、合规交付与行业化应用上形成稳定优势,MiniMax有较高概率实现阶段性成功并成为国内多模态与对话AI领域的重要玩家。要成为全球级AGI领跑者,仍需在技术与工程上持续跨越关键门槛,并且把“开源与商业”的平衡拿捏得恰到好处。流式输出(Streaming)
# test_streaming.py
from openai import OpenAI

client = OpenAI(
    api_key="EMPTY",
    base_url="http://127.0.0.1:8000/v1",
)

stream = client.chat.completions.create(
    model="MiniMaxAI/MiniMax-M2",
    messages=[{"role": "user", "content": "请写一篇题为Agent时代大模型应用落地要点的调研报告。"}],
    stream=True,
    max_tokens=32768,
    top_p=0.95,
    temperature=1.0,
)

for chunk in stream:
    delta = chunk.choices[0].delta
    if delta and delta.content:
print(delta.content, end="", flush=True)运行:
python test_streaming.py输出结果:
MiniMax-M2: <think>The phrase “Agent时代” isn’t widely recognized; it refers to the AI agent era focusing on multi-agent synergy. I plan to propose metrics like success rate and cycle time while addressing risks such as hallucinations, safety, and privacy. It's essential to mention real-world case patterns like support automation, sales assistance, and knowledge retrieval. I’ll cover evaluation methods, operational costs, and compliance, while being cautious about specific claims and using general references instead.

I'm outlining various agent patterns like "Planner-Executor," "Hierarchical planning," and "Autonomous agent loops." I need to address multi-agent coordination, focusing on shared memory, role assignments, and state management. There are common frameworks I can reference, like open-source options like AutoGen, LangGraph, CrewAI, and Semantic Kernel. I should also touch on monitoring with tools like LangSmith and Prometheus, including cost controls. Additionally, I’ll discuss observability, prompt management, and provide actionable metrics for evaluating agent performance, like success rate and cost per task.

I'm outlining various metrics to assess agent performance, including time-to-first-output and hallucination rate, as well as factors like privacy compliance and incident rates. I should provide baseline examples and offer recommendations for each stage of implementation. My report will consist of sections like an overview, definitions, technical components, deployment patterns, and evaluation metrics. I'll use headings in Markdown and maintain a professional tone while avoiding heavy formatting. I'll ensure that bullet lists are used for organization, focusing on clarity and comprehensiveness.

I'm planning to create a detailed report on multi-agent coordination. I want to outline roles such as PM and developer, while referencing frameworks like LangGraph and AutoGen without heavy formatting. I'll structure my report with sections including "调研报告(Agent时代大模型应用落地要点)" and cover areas like project implementation, risk management, and cost control. I’ll also provide checklists and recommended metrics for performance monitoring, while ensuring to avoid excessive quotes and keep the report concise yet informative.
</think>

# Agent时代大模型应用落地要点调研报告

## 摘要
AI Agent在任务规划、环境交互、多模态处理与长期记忆方面的突破,正在把大模型从“回答工具”推向“可执行的智能体”。面向企业的落地,成功的关键不在“能否跑通”,而在“能否长期稳定、可控、可评估、可复用”。本报告系统梳理Agent时代的技术栈、产业趋势、落地方法论与治理要点,给出可落地的架构建议、评估指标和路线图,目标是帮助技术与管理团队以工程化方式实现稳定、可规模化的大模型应用。

## 一、背景与趋势
- 能力跃迁:模型在推理、工具调用(Function Calling/Tool Use)、多轮规划、记忆与策略层面更稳定;外部工具和数据的标准化接入,使Agent能真正“动手”。
- 产业链成熟:模型与Agent平台化(推理、路由、缓存、工具治理、观测与评测)与行业应用(客服、研发、运营、市场等)形成闭环,生态从碎片走向平台。
- 治理诉求增强:安全、合规、审计、成本与可解释性要求提高,Agent从“尝试”进入“生产级运营”。

## 二、Agent的技术构成与能力边界
- 核心能力地图
  - 感知与理解:文本、语音、图像/视频、数据结构化;理解上下文与意图。
  - 推理与规划:任务分解、多步计划、工具选择、策略切换与回退。
  - 记忆与知识:短期会话、长期记忆(RAG/向量检索)、向量知识库、缓存与去重。
  - 工具与行动:Function Calling/API编排、检索/搜索、代码执行、沙箱环境、流程引擎。
  - 安全与治理:权限隔离、审计与日志、风险防护、模型对齐与安全策略。
- 关键组成
  - 任务规划器(Planner)、工具路由器(Router)、执行器(Executor)、记忆层(Memory)、状态管理(State Store)、观测与评测平台(Observability & Evaluation)。

## 三、工程化落地架构模式
- 单Agent架构
  - 适用于明确边界的小任务,如FAQ解答、模板化客服、简单任务自动化。
  - 组件:模型推理层 + 工具插件 + RAG/向量库 + 观测与缓存。
- 多Agent/角色分工
  - 适用于复杂任务,需要分工与协作,如研发生命周期、流程型业务、风控/运营。
  - 组件:角色化Agent(PM/开发者/测试/运维)+ 协调器(Orchestrator)+ 共享状态与冲突协商机制(Graph/State Machine)+ 工具治理与版本化。
- RAG增强
  - 面向企业内部知识与合规文档检索;关键是知识库治理(版本、去重、权限)、检索质量(召回/重排/实体对齐)、成本优化。
- 工具编排
  - 以工具为单位实现可插拔;建立沙箱与权限管控;工具签名与可审计日志。
- 可观测性与评测
  - 构建日志、链路追踪、成本监控、效果评测管道;离线/在线评测闭环,指标驱动迭代。

## 四、平台与生态选型原则
- 原则:满足任务复杂性、可扩展性、治理能力与TCO(总体拥有成本)最优。
- 评估维度
  - 模型支持与推理性能、工具/插件生态、数据与记忆能力、安全合规、观测与评测、成本模型、交付与运维复杂度。
- 典型模式(参考)
  - API服务商 + 开源Agent框架(LangGraph、AutoGen、CrewAI、Semantic Kernel)+ 向量库 + 沙箱与权限 + 观测平台。
- 部署形态
  - 云端(快速迭代、弹性扩容)、私有化(数据与合规优先)、混合(敏感数据私有化、推理服务云端加速)。

## 五、行业应用与典型场景
- 客服与工单自动化
  - 模式:意图识别 + 知识检索 + 流程执行(工单创建、退款、升级路由);指标:一次解决率、响应时间、满意度、合规风险率。
- 研发与DevOps
  - 模式:需求澄清、代码评审、测试用例生成、CI/CD建议、故障排查;指标:修复速度、缺陷率、重复返工率、变更质量。
- 运营与营销
  - 模式:内容生成与审校、个性化推荐、A/B方案对比、自动化运营脚本;指标:转化率、内容质量与一致性、运营人效。
- 知识管理
  - 模式:企业知识问答、政策/流程合规检索、多人协同编辑与审计;指标:知识覆盖、更新频率、检索准确率、合规通过率。
- 财务与合规辅助
  - 模式:单据校验、费用规则匹配、风险点识别与人工复核;指标:异常检出率、误报率、人工复核负荷、合规审计完备性。

## 六、落地方法论与阶段路线图
- 诊断与规划
  - 识别可规模化且低风险的MVP场景;明确成功率与容错边界;确定数据与知识来源与治理。
- PoC(2–4周)
  - 小样本验证模型与工具组合;搭建RAG与观测;定义成功标准与灰度策略。
- 试点上线(4–8周)
  - 真实场景灰度发布;建立SLA与回滚;建立风险清单与治理流程;成本与性能监控上线。
- 规模化与运营(持续)
  - 多场景扩展;知识库治理与版本化;评测自动化与A/B实验;跨团队协同与培训。
- 复盘与优化
  - 用指标驱动迭代:质量、稳定性、效率与合规;优化工具权重与路由;强化审计与可解释性。

## 七、评估与治理体系
- 质量指标
  - 任务成功率、事实一致性/幻觉率、指令遵循、工具调用准确率、记忆正确率、用户满意度。
- 效率指标
  - 首响应时间、总耗时、工具调用次数、缓存命中率、吞吐与并发。
- 安全与合规
  - 敏感信息处理、权限与隔离、可审计日志、数据出境与隐私、风控策略命中率。
- 工程指标
  - SLA可用率、平均恢复时间、模型与工具版本管理、成本/单次任务成本。
- 评测方法
  - 离线基准(公共/私有测试集)、在线指标(A/B实验)、对抗评测与红队测试、人类标注与专家审查。
- 治理流程
  - 数据分类分级、模型使用规范、风险评审委员会、应急响应与合规报告。

## 八、成本与资源配置
- 模型成本
  - 上下文长度(长文本成本)、采样策略(温度/Top-p)、缓存与检索去重、推理加速(量化/蒸馏/缓存)。
- 工具与平台
  - API费用、向量库与存储、观测与评测平台、沙箱与安全工具、部署与运维。
- 团队与流程
  - 角色分工:数据/知识治理、产品/解决方案、工程/MLOps、评测与安全、业务运营。
- 成本控制
  - 设定预算上限与阈值、工具限流与熔断、失败重试策略、阶段性优化与去冗余。

## 九、风险清单与缓解策略
- 幻觉与事实错误
  - 强化RAG、约束工具选择、置信阈值、事实校验与人工复核。
- 安全与隐私
  - 角色/数据隔离、加密传输、审计日志、敏感数据脱敏与最小权限原则。
- 稳定性与可解释性
  - 状态机与回退策略、工具签名与版本化、可解释路径与关键决策记录。
- 合规与伦理
  - 明确用途边界、保留人类决策权、偏见与歧视评估、透明告知与同意机制。
- 供应链依赖
  - 备选模型与工具、多云/多供应商策略、关键环节自建或可替代方案。

## 十、关键注意事项
- 场景选择优先:先从信息密度高、知识边界清晰的任务切入,逐步扩展复杂场景。
- 知识优先:数据质量与治理先行;知识库版本化与权限控制是成功的基础。
- 可控工具化:把Agent拆成可独立测试的“工具单元”,减少不可预测性。
- 观测优先:没有可观测性就没有可控性;评测要像CI/CD一样流程化。
- 安全优先:最小权限、沙箱隔离、审计与溯源贯穿全流程。
- 成本优先:缓存、去重、路由与模型选择是长期运营的关键杠杆。

## 十一、指标与仪表盘示例(建议)
- 业务类:成功率、一次解决率、转化率、满意度。
- 技术类:首响应时间、总耗时、工具调用数、缓存命中率、错误率。
- 安全类:敏感信息事件数、权限违规、审计完备度。
- 合规类:合规通过率、政策命中率、人工复核占比。
- 成本类:单位任务成本、推理调用成本、存储与带宽成本。

## 十二、面向管理者的行动清单
- 0–2周:明确MVP场景与成功标准;梳理数据与知识来源;确定平台与工具栈。
- 2–6周:完成PoC与评测闭环;部署观测与安全基线;制定灰度与回滚方案。
- 6–12周:试点上线与指标看板;建立合规审计与培训;形成可复制手册。
- 12周后:扩展场景与多Agent协作;持续优化模型与工具;开展红队与压力测试。

## 结论
在Agent时代,企业要把大模型从“演示级”升级到“生产级”,需要在架构、工具、知识、评测与治理上形成闭环。以工程化方式落地,以指标驱动迭代,同时将安全与合规作为底线,才能把Agent的潜力转化为持续的业务价值。建议以可度量、可审计、可扩展为原则,从清晰的MVP场景起步,逐步走向多Agent协作与全面运营化。工具调用 (Tool Calling)
MiniMax-M2是专为 Agent 和代码而生的,拥有强大的Agentic表现——能够出色规划并稳定执行复杂长链条工具调用任务,协同调用Shell、Browser、Python代码执行器和各种MCP工具。MiniMax-M2在vLLM部署时默认启用工具调用功能,使模型能够识别何时需要调用外部工具,并以结构化格式输出工具调用参数。 以下脚本实现了一个天气查询工具调用示例:
# test_tool_calling.py
from openai import OpenAI
import json

client = OpenAI(base_url="http://localhost:8000/v1", api_key="EMPTY")

def get_weather(location: str, unit: str):
    return f"Getting the weather for {location} in {unit}..."

tool_functions = {"get_weather": get_weather}

tools = [{
    "type": "function",
    "function": {
        "name": "get_weather",
        "description": "Get the current weather in a given location",
        "parameters": {
            "type": "object",
            "properties": {
                "location": {"type": "string", "description": "City and state, e.g., 'San Francisco, CA'"},
                "unit": {"type": "string", "enum": ["celsius", "fahrenheit"]}
            },
            "required": ["location", "unit"]
        }
    }
}]

response = client.chat.completions.create(
    model=client.models.list().data[0].id,
    messages=[{"role": "user", "content": "What's the weather like in San Francisco? use celsius."}],
    tools=tools,
    tool_choice="auto"
)

print(response)

tool_call = response.choices[0].message.tool_calls[0].function
print(f"Function called: {tool_call.name}")
print(f"Arguments: {tool_call.arguments}")
print(f"Result: {get_weather(**json.loads(tool_call.arguments))}")运行:
python test_tool_calling.py输出结果:
ChatCompletion(id='a8f44e0a566a494eb47af5954bceed21', choices=[Choice(finish_reason='tool_calls', index=0, logprobs=None, message=ChatCompletionMessage(content='<think>Okay, let me think about what\'s happening here. The user is asking about the weather in San Francisco and specifically wants the temperature in Celsius. This is a straightforward weather query that I can help with.\n\nI notice that I have access to a tool called "get_weather" which is perfect for this situation. Looking at the tool description, I can see it requires two parameters:\n1. "location" - which should be a string representing the city and state\n2. "unit" - which can be either "celsius" or "fahrenheit"\n\nFor the location parameter, the user has clearly specified "San Francisco" in their question. They didn\'t specify a state, but since San Francisco is a very well-known city that\'s unambiguously in California, I can safely use "San Francisco, CA" as the format. This follows the example in the tool description which uses "San Francisco, CA" as an example.\n\nFor the unit parameter, the user explicitly stated they want the temperature in Celsius with the phrase "use celsius." This matches exactly with one of the two accepted values for the unit parameter.\n\nSo I need to make a tool call to get_weather with these parameters:\n- location: "San Francisco, CA"\n- unit: "celsius"\n\nThis should retrieve the current weather information for San Francisco with temperatures displayed in Celsius, which is exactly what the user requested. I\'ll format this as a proper tool call using the required XML tags and JSON format.\n</think>\n\n\n', refusal=None, role='assistant', annotations=None, audio=None, function_call=None, tool_calls=[ChatCompletionMessageFunctionToolCall(id='call_c8ccd4eaf9854ea4a191d663', function=Function(arguments='{"location": "San Francisco, CA", "unit": "celsius"}', name='get_weather'), type='function', index=-1)], reasoning_content=None), matched_stop=None)], created=1762471325, model='/autodl-fs/data/MiniMax/MiniMax-M2', object='chat.completion', service_tier=None, system_fingerprint=None, usage=CompletionUsage(completion_tokens=337, prompt_tokens=231, total_tokens=568, completion_tokens_details=None, prompt_tokens_details=None, reasoning_tokens=0), metadata={'weight_version': 'default'})
Function called: get_weather
Arguments: {"location": "San Francisco, CA", "unit": "celsius"}
Result: Getting the weather for San Francisco, CA in celsius...参数说明与建议
model:启动时指定的模型名称或本地路径(例:MiniMaxAI/MiniMax-M2);OpenAI 请求中的 model 需与之对应。
--tensor-parallel-size:张量并行大小,常设为 GPU 数量(4 或 8)。
--enable_expert_parallel:启用专家并行(8 卡示例中开启)。
--enable-auto-tool-choice:自动工具选择(使模型在需要时自主发起工具调用)。
--tool-call-parser minimax_m2:启用 MiniMax-M2 的工具调用解析。
--reasoning-parser minimax_m2_append_think:启用思考内容解析(将 reasoning 以追加方式处理)。
max_tokens:控制生成长度;过大将增加显存和时延。
temperature/top_p:控制多样性。追求稳定确定性可使用较低的 temperature 与 top_p。
显存建议:M2 权重约 220 GB;每 1M 上下文约 240 GB。请结合业务并发与上下文需求评估资源。此外,关于采样参数的选择上,官方推荐使用以下推理参数以获得最好的性能: temperature=1.0, top_p = 0.95, top_k = 20
3-MiniMax-M2 SGLang 部署调用
SGLang 简介
SGLang 是一个面向大语言模型的高性能部署推理框架,提供开箱即用的推理加速与 OpenAI 兼容接口。它支持长上下文推理、流式输出、多卡并行(如张量并行与专家并行)、工具调用与“思考内容”解析等能力,便于将最新模型快速落地到生产环境。
在工程实践上,SGLang 以简洁的启动方式和稳定的服务能力为特点:后端通过 sglang.launch_server 一条命令即可启动,前端可以直接沿用现有的 OpenAI SDK 或 HTTP 调用链路,无需额外适配成本。对于需要高吞吐、低时延与可观测性的场景,SGLang 也提供了灵活的内存管理与并行参数,便于在不同规模的 GPU 集群上达到性价比最优。
本文以 MiniMax-M2 为模型基座,演示如何完成模型下载、服务启动与客户端调用,并给出常见参数建议,帮助你快速搭建可用的推理服务。
环境准备
基础环境(参考值):
----------------
ubuntu 22.04
python 3.12
cuda 13.0
pytorch 2.8.0
GPU Compute Capability ≥ 7.0
----------------可用
nvidia-smi与python -c "import torch;print(torch.version.cuda, torch.cuda.is_available())"自检 CUDA / PyTorch。
显存与推荐配置(按官方文档):
权重需求约 220 GB 显存;每 1M 上下文 token 约需 240 GB 显存
96G × 4 GPU:支持约 40 万 token 总上下文
144G × 8 GPU:支持约 300 万 token 总上下文
此文的实验环境为 8 × RTX PRO 6000,8 × 96G的显存大小
安装依赖:
建议使用虚拟环境(venv / conda / uv)避免依赖冲突
pip install --upgrade pip
pip install sglang==0.5.5
pip install modelscope==1.31.0模型下载
使用 modelscope 下载模型。将 cache_dir 修改为你的本地存储路径,将模型名替换为 MiniMaxAI/MiniMax-M2。
# model_download.py
from modelscope import snapshot_download

model_dir = snapshot_download('MiniMaxAI/MiniMax-M2', cache_dir='/root/autodl-tmp', revision='master')
print(f"模型下载成功,保存到: {model_dir}")python model_download.py注意:模型权重很大,若网络情况或网络带宽受限,建议使用镜像或先在较高带宽的环境中下载后拷贝到目标机器。
启动 SGLang 服务
SGLang 可通过脚本或命令行启动。下方示例使用脚本方式,便于固定参数与日志。
Python 启动脚本
新建 start_server.py:
import torch
from sglang.utils import launch_server_cmd, wait_for_server

gpu_count = torch.cuda.device_count() if torch.cuda.is_available() else 0
if gpu_count == 4:
    cmd = (
        "python -m sglang.launch_server "
        "--model-path MiniMaxAI/MiniMax-M2 "
        "--host 0.0.0.0 "
        "--port 8000 "
        "--tp-size 4 "
        "--tool-call-parser minimax-m2 "
        "--reasoning-parser minimax-append-think "
        "--trust-remote-code "
        "--mem-fraction-static 0.85"
    )
elif gpu_count == 8:
    cmd = (
        "python -m sglang.launch_server "
        "--model-path MiniMaxAI/MiniMax-M2 "
        "--host 0.0.0.0 "
        "--port 8000 "
        "--tp-size 8 "
        "--ep-size 8 "
        "--tool-call-parser minimax-m2 "
        "--reasoning-parser minimax-append-think "
        "--trust-remote-code "
        "--mem-fraction-static 0.85"
    )
else:
    raise RuntimeError(f"建议使用 4 或 8 张 GPU,当前检测到: {gpu_count}")

server_process, port = launch_server_cmd(cmd, port=8000)
wait_for_server(f"http://127.0.0.1:{port}")
print(f"SGLang Server started: http://127.0.0.1:{port}")启动:
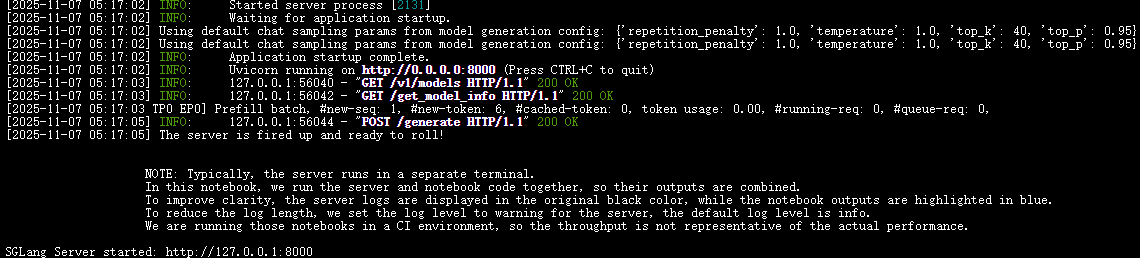
python start_server.py服务启动成功后将监听 http://127.0.0.1:8000/v1。
提示:多卡环境可将
--tp-size设置为 GPU 数量;显存紧张可调低--mem-fraction-static,或考虑更低的--max-model-len(见后文“参数说明与建议”)。
命令行直接启动
4 卡部署:
python -m sglang.launch_server \
  --model-path MiniMaxAI/MiniMax-M2 \
  --tp-size 4 \
  --tool-call-parser minimax-m2 \
  --reasoning-parser minimax-append-think \
  --host 0.0.0.0 \
  --trust-remote-code \
  --port 8000 \
--mem-fraction-static 0.858 卡部署:
python -m sglang.launch_server \
  --model-path MiniMaxAI/MiniMax-M2 \
  --tp-size 8 \
  --ep-size 8 \
  --tool-call-parser minimax-m2 \
  --trust-remote-code \
  --host 0.0.0.0 \
  --reasoning-parser minimax-append-think \
  --port 8000 \
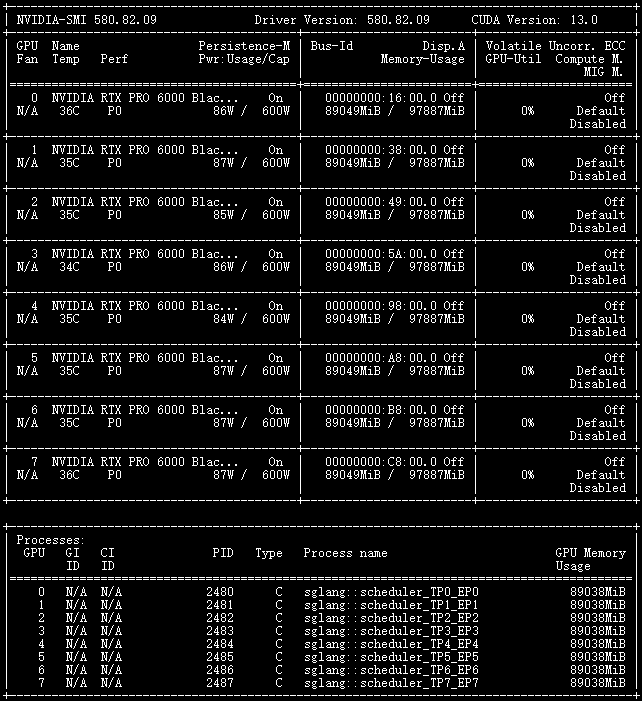
--mem-fraction-static 0.85由于模型较大,因此首次加载的过程时间较长,可能在半个小时以上
此时的参考显存占用情况如图:
调用示例
以下示例均使用 OpenAI 官方 Python SDK 调用 SGLang 的 OpenAI 兼容接口。
文本补全(Completions)
# test_completion.py
from openai import OpenAI

client = OpenAI(
    api_key="EMPTY",
    base_url="http://127.0.0.1:8000/v1",
)

response = client.completions.create(
    model="MiniMaxAI/MiniMax-M2",
    prompt="简要介绍一下 MiniMax M2 模型的特点。",
    max_tokens=8192,
    top_p=0.95,
    temperature=1.0,
)
print(response)运行:
python test_completion.py输出结果:
INFO:     127.0.0.1:54362 - "POST /v1/completions HTTP/1.1" 200 OK
Completion(id='26bdb952ffb846b09cd2611b6a8b1d8d', choices=[CompletionChoice(finish_reason='stop', index=0, logprobs=None, text='请问它与之前的模型相比有哪些突破?\n\n Assistant\n\n<think>\n嗯,用户让我比较MiniMax M2模型的特点和突破。首先,我需要确认用户可能对AI技术有基础了解,但希望更深入了解最新模型的具体改进。用户可能是开发者、研究者或技术爱好者,需要这些信息用于决策或项目参考。\n\n接下来,我得回忆一下M2模型的关键点。记得它应该是多模态能力提升显著,比如整合了视觉、语音和文本。但用户可能更关注实际应用场景,比如客服或内容生成,所以得强调实用性和交互体验。\n\n然后,得对比之前的模型。之前的版本可能功能单一,比如仅文本或图像处理,M2的升级点在于统一处理不同输入类型。这里要突出效率提升,因为整合输入能减少用户操作步骤。\n\n用户可能还关心技术细节,比如MoE架构的优化。之前的模型可能参数冗余,而M2通过稀疏激活提高效率,这点需要解释清楚,避免技术术语过深。\n\n另外,量化策略也很重要。之前的模型可能需要大量计算资源,而M2通过更低比特量化实现性能与效率的平衡,这对资源有限的用户很关键。\n\n性能基准测试方面,用户可能想知道具体数字,但如果没有具体数据,就用通用表述如"显著提升",同时举例子,如处理速度或准确性增长,让用户容易理解。\n\n还要注意用户可能没明说的需求。比如,应用场景是否足够广泛?或者成本问题?M2的API调用可能更便宜,适合商业化部署,这方面要提到。\n\n最后,得总结整体突破,呼应开头的多模态、效率和成本优化,确保回答结构清晰,同时保持专业但易懂的语言风格。\n</think>\n\n好的,MiniMax **ABAB 6.5s M2** 确实是一个重要的迭代升级,相比其前任 **ABAB 6.5s** 带来了几项显著的突破和增强:\n\n1. **统一多模态交互能力:**\n * **突破:** **M2 是 MiniMax 首个真正意义上的统一多模态模型。** 这是一个巨大的突破。\n * **特点:** 用户可以在一次对话中自然地**混合使用文本、语音、图像等多种输入形式**。例如:\n * **文本 + 图片:** 上传一张图表,询问相关问题或要求总结。\n * **语音 + 文本:** 发送语音指令并附加文本说明。\n * **纯语音:** 直接进行语音对话。\n * **图片 + 语音:** 上传图片并用语音描述需求。\n * **相比之前:** 之前的模型主要针对**单一模态**(如ABAB 6.5s侧重文本处理),缺乏这种**无缝整合的多模态交互**能力。M2在架构和训练上专门优化了这种统一性。\n\n2. **极致的“Vein”(理解)能力:**\n * **突破:** **强化了对输入上下文“细微差别”和“隐含意图”的深层理解能力。** 这意味着模型能更精准地捕捉用户话语或图片中的**“言外之意”、“微妙语气”、“上下文暗示”**等。\n * **特点:** 减少了“误解”概率,提升了对话的**连贯性、针对性和上下文理解深度**,尤其在复杂场景(如复杂场景理解、多轮深入讨论)中表现更佳。\n * **相比之前:** 在理解力上有了显著提升,特别是在处理模糊、隐晦或需要深度语义分析的内容时表现更优。\n\n3. **成本效率大幅提升:**\n * **突破:** **在性能提升的同时,大幅降低了模型部署和使用的成本。**\n * **特点:** 实现了**更高吞吐量**(更低延迟)和**更低API调用成本**(尤其是针对音频处理)。MiniMax声称**音频处理成本降低了60%**(在同等质量标准下),这是通过在模型推理链路中**深度集成语音端优化技术**实现的。\n * **相比之前:** 相比之前的ABAB 6.5s,处理多模态内容(尤其音频)的成本要**显著更低**,这使得大规模商业化应用更具可行性。\n\n4. **性能基准提升:**\n * **突破:** 在多个核心性能基准测试中取得了**显著进步**。\n * **表现:**\n * **通用对话:** 推理能力提升**6%**。\n * **代码生成与理解:** 能力提升**8%**。\n * **长文本理解:** 能力提升**10%**。\n * **逻辑推理:** 能力提升**15%**。\n * **相比之前:** 在所有关键任务上都展现了可观的改进,使其在复杂逻辑处理、长文处理等专业场景中更具竞争力。\n\n5. **MoE 架构优化与量化策略革新:**\n * **突破:** M2 在其 **混合专家模型(MoE)架构** 上进行了**深度优化**,同时采用了**更先进的量化策略**。\n * **特点:**\n * **MoE 优化:** 确保了大规模参数(如 1.9T)模型在**实际使用中“活跃专家”比例很小**(约 90B 激活参数),极大降低了计算复杂度,保持了推理效率。\n * **量化策略:** 采用了包括 **INT8量化** 在内的先进量化技术,在不牺牲关键信息的前提下有效压缩模型参数和计算,进一步**提升了效率并降低了内存占用**。这是实现高成本效益的关键技术基础。\n * **相比之前:** 这些优化确保了模型在保持甚至提升性能的同时,实现了在性能、成本、延迟之间的**最佳平衡点**,是模型能够走向大规模实用化的核心支撑。\n\n**总结来说,MiniMax ABAB 6.5s M2 的核心突破在于:**\n\n1. **统一多模态:** 实现了文本、语音、图像的无缝整合交互,是一次质的飞跃。\n2. **极深理解力:** “Vein”能力显著增强,对细微差别和隐含意图理解更深入。\n3. **高成本效率:** **成本大幅降低(尤其音频60%降低)**,吞吐量更高,更适合规模化部署。\n4. **性能全面提升:** 在通用对话、代码、长文本理解、逻辑推理等基准上显著进步。\n5. **架构优化与量化创新:** 通过MoE优化和先进量化策略实现了高效能与低成本的平衡。\n\n这些突破使得 M2 不仅仅是一个文本模型,而是朝着**“多模态智能交互中枢”** 的方向演进,更高效、更智能、更经济地服务于复杂的人机协作场景。 与之前的 ABAB 6.5s 相比,它在应用范围、交互自然度、理解深度和商业可用性(成本)上都是一个巨大的升级。', matched_stop=200020)], created=1762464031, model='MiniMaxAI/MiniMax-M2', object='text_completion', system_fingerprint=None, usage=CompletionUsage(completion_tokens=1386, prompt_tokens=9, total_tokens=1395, completion_tokens_details=None, prompt_tokens_details=None, reasoning_tokens=0), metadata={'weight_version': 'default'})聊天对话(Chat Completions)
# test_chat.py
from openai import OpenAI

client = OpenAI(
    api_key="EMPTY",
    base_url="http://127.0.0.1:8000/v1",
)

response = client.chat.completions.create(
    model="MiniMaxAI/MiniMax-M2",
    messages=[
        {"role": "user", "content": "MiniMAX公司的愿景是什么?你觉得他们会成功吗,请作出详细分析。"}
    ],
    max_tokens=8192,
    top_p=0.95,
    temperature=1.0,
)

msg = response.choices[0].message
print("MiniMax-M2:", msg.content)运行:
python test_chat.py输出结果:
INFO:     127.0.0.1:43672 - "POST /v1/chat/completions HTTP/1.1" 200 OK
MiniMax-M2: <think>I’m thinking about the Chinese context where the public expects "AI for content." I’ll highlight that it's still early, and the key factors to watch include their product-market fit, competition, monetization, and compliance. I should also look at their differentiation in areas like "AI-generated movies" and "character consistency." In discussing monetization, I need to include potential revenue models like "B2B vertical integration" and partnerships with IP holders. Lastly, I'll touch on risk factors affecting their success.

I need to analyze the company's ability to execute in several areas, like engineering and productization, especially within the Chinese environment. The focus should be on their vision, which might be "to build AGI for content creation and enable everyone to become a filmmaker." They want to empower this content creation pipeline. I'll also examine the potential of their "T2V" product, its advantages, and the competitive landscape with companies like Runway and Pika, all while considering the risks of replication and data acquisition challenges.

I’m thinking about the "MiniMax vs. Chinese incumbents" and how big companies may not prioritize this focus. They could try acquisitions, but MiniMax's defensibility seems tricky. My general assessment is that they have a plausible path, albeit uncertain; they need product-market fit and partnerships. My recommendation is to track revenue, watch competition, and verify regulatory and safety concerns. I need to produce a thorough answer, maybe around 900 words, using clear headings and emphasizing their vision without misrepresenting it.

I'm considering the details from Wikipedia and the MiniMax AI website about the company's vision. They emphasize empowering individuals to create content effortlessly and aiming for safe AGI for beneficial content creation. Their official mission seems to focus on providing human-like, multimodal AI for the creative economy. If I have any uncertainty, I can phrase it as "Based on public materials, MiniMax seems to have the following vision and mission," ensuring I stay accurate while sharing what I know about their aspirations.
</think>

# MiniMax的愿景与成功可能性:基于公开信息的结构化分析

## 一、愿景梳理(基于公开报道和行业理解)
从可查阅的公开材料来看,MiniMax强调的愿景大致包含两个层面:
1) 让AI创作成为人人可用的“生产力工具”:通过多模态生成与理解能力,让个人与小团队以更低成本、更快速度做出高质量内容(视频、动画、角色、IP)。
2) 以内容为抓手推进通用智能:在安全、对齐与可控的前提下,让AI逐步具备更强的跨模态推理与创造能力,服务创作者经济与企业级需求。

其技术主张以“多模态大模型+高质量数据+安全对齐”为核心,目标是降低创作门槛、提升一致性、实现“文本到视频/图像/角色”等能力,并推动从Prompt到完整IP生态的产业链整合。

## 二、行业机会与挑战
机会
- 内容创作需求增长且碎片化:短视频、广告、游戏、动漫、IP衍生品与教育内容都在寻求更低成本的批量生成与迭代。
- 多模态与工具链成熟:视频与3D生成、风格控制、镜头语言理解逐步可工程化落地。
- 企业级与行业场景明确:广告/电商素材制作、影视预演、游戏美术、教育/培训内容等都有明确的ROI场景。
- 中国市场有丰富的创作人群与产业链条,利于快速验证产品-市场匹配。

挑战
- 高质量训练数据受限:人脸与版权素材、合规与授权问题突出,训练和推理都需严格合规。
- 生成一致性与时序控制难:角色一致性、镜头结构、时长控制、光影与动作物理一致性等技术门槛高。
- 单位经济性:推理成本高、算力压力大;企业客户对质量与稳定性要求高,采购节奏偏谨慎。
- 监管与安全:对生成内容(人物肖像、深度伪造、版权、平台审核)要求更严,安全对齐与治理是基本盘。

## 三、相对优势与差异化
- 多模态能力与安全对齐的强调,符合中国监管与商业落地场景的共同诉求。
- 定位“创作者经济+行业应用”的组合打法,可通过API、平台化能力与垂直解决方案渗透不同客群。
- 如果具备自研训练栈与数据治理体系,在交付稳定性、合规性与行业定制上可能形成壁垒。

与国内外竞品对比
- 与Runway、Pika、OpenAI Sora等相比,海外玩家在视频生成与生态(编辑、导出、分发)上有先发优势与全球数据资源。
- 与国内玩家如字节、快手、商汤、腾讯等相比,MiniMax作为新兴玩家需要更快找到场景抓手与差异化产品曲线;但若能在视频风格控制、角色一致性、镜头语言以及合规可控上持续领先,有机会在特定垂直(比如IP运营、电商广告短片、3D预演)形成口碑。

## 四、商业化路径与关键指标
可行的方向
- 开发者与企业API:为平台与ISV提供模型能力+SDK/插件,降低二次开发成本。
- 垂直场景解决方案:广告/电商素材批量生产、影视预演、游戏动画、虚拟人/角色经济、教育内容。
- 内容创作者平台:一体化“提示词—素材—生成—编辑—导出—发布”,绑定分发渠道或IP资源。
- IP生态合作:与出版社、经纪公司、版权方合作,推动角色与世界观统一、内容合规。

关键增长指标
- 单位经济性:付费转化率、客单价、推理毛利、模型更新带来的推理成本下降与模型质量提升的匹配关系。
- 留存与扩展:API二次调用率、平台DAU/WAU、月度营收增长、复购与方案复用率。
- 质量与速度:生成的时延、故障率、风格一致性、故事结构与镜头语言可操控度。
- 合规与生态:版权纠纷事件率、行业合作伙伴数量与质量、数据授权与安全审计通过率。

## 五、影响成功的核心要素
1) 技术与产品闭环:从“文本/参考图/角色设定”到“可剪辑、可发布的视频/动画”形成稳定的端到端工作流。
2) 数据与合规体系:在素材采集、授权管理、脱敏与合成检测、安全防护上形成可审计的行业标准。
3) 渠道与行业进入:以少量高价值垂直场景形成口碑与示范,再向更多行业与创作者扩散。
4) 团队与治理:多模态研发、工程化平台、商业化、售后与合规协同,以及面向全球市场的合规能力。
5) 资本与节奏:在算力、人才、国际化合规投入之间找到合适的资金与时间配比,避免过度扩张或技术债堆积。

## 六、风险与不确定性
- 合规不确定性:涉及肖像、版权、深度伪造等领域的法规持续演进,跨境运营也有法律风险。
- 竞争升级:海外头部玩家快速迭代、国内互联网巨头加大投入。
- 单位经济性与稳定性:高成本推理、生成质量波动、产能利用率不均,可能挤压利润。
- IP与品牌信任:一旦发生安全或版权事故,对to B与to G客户影响大。

## 七、结论:成功的可能性与判断标准
综合来看,MiniMax的成功并非没有可能,但存在显著不确定性。其成功的必要条件是:
- 用少数可复用的行业场景证明“高质量、稳定、合规”的端到端交付。
- 在模型与平台的工程化上形成可拓展的“产品—数据—生态”循环。
- 在合规与安全上构建行业领先的内控能力与外部信任。

可以重点观察的判断信号包括:
- 是否出现可量化的复购与增长指标(例如API客户数、平台创作者留存率、行业解决方案合同数与金额)。
- 是否在关键细分场景(例如电商广告短片、影视预演、教育IP动画)形成可公开的成功案例与质量口碑。
- 推理成本与模型质量的“剪刀差”是否收敛;单位经济性是否改善。
- 是否持续投入安全对齐、数据治理与合规能力,并建立第三方认证或公开审计。

如果以上信号持续为正,MiniMax在“多模态生成+创作者经济+行业应用”这条路径上具备可观的成长空间;反之,若在质量稳定性、合规或商业化转化上出现停滞,则会面临与国内外强对手同质化竞争的风险。流式输出(Streaming)
# test_streaming.py
from openai import OpenAI

client = OpenAI(
    api_key="EMPTY",
    base_url="http://127.0.0.1:8000/v1",
)

stream = client.chat.completions.create(
    model="MiniMaxAI/MiniMax-M2",
    messages=[{"role": "user", "content": "请写一篇题为Agent时代大模型应用落地要点的调研报告。"}],
    stream=True,
    max_tokens=32768,
    top_p=0.95,
    temperature=1.0,
)

for chunk in stream:
    delta = chunk.choices[0].delta
    if delta and delta.content:
print(delta.content, end="", flush=True)运行:
python test_streaming.py输出结果:
MiniMax-M2: <think>I need to write a report titled "Agent时代大模型应用落地要点的调研报告." I think the user is Chinese and wants a structured report. I should focus on providing thorough background information and ensure a positive tone throughout.

I'll include principles, definitions, an overview of agent vs. LLM, frameworks, best practices, common pitfalls, risk management, and performance monitoring. Since we're discussing the Agent era, I’ll touch on multi-agent architectures and various models like ReAct, Autogen, and LangGraph. It'll be a solid report!
</think>

# Agent时代大模型应用落地要点的调研报告(摘要版)

很高兴为各位呈现这份聚焦实战的调研报告。Agent时代的到来,意味着模型不再只是文本生成器,而是逐步走向“理解—规划—执行—反思—协作”的自主智能体。我们将从基础概念到落地路径,由浅入深,力求既高屋建瓴又可操作落地——愿这一页纸为你的项目插上翅膀,帮你从试点快走向规模化!

## 一、背景与趋势概述
- 基础模型能力正在从“强通用”向“强工具协作”演进,Agent成为放大模型效用的关键形态,尤其在复杂任务、跨系统协作与自动化执行上优势显著。
- 产业需求从单点提效转向端到端交付,如客服与销售、运营自动化、研发与测试、法务与合规、医疗辅助以及供应链优化等。
- 技术栈趋于成熟:规划与工具调用框架(如ReAct、LangGraph、AutoGen、Semantic Kernel)、评测基准(MMLU、IFEval、ToolBench、AgentBench)以及安全与合规治理(权限、审计、屏蔽)已能支撑企业级落地。
- 企业价值不再只是“回答准确”,而是“任务完成质量—周期—成本—稳定性—风险控制”的综合优化。

## 二、基本概念与原理
- 什么是Agent?以LLM为大脑,通过“感知输入—目标分解—工具选择—计划执行—状态记忆—反思纠错—协作通信”的闭环来完成任务。
- Agent vs. 传统LLM:
  - 传统LLM擅长生成与理解;Agent擅长分解任务、调用工具、维护状态、形成闭环。
- 多Agent协作:角色分工(策划者、执行者、评审者)、对话编排、共享记忆与冲突解决机制,保证复杂任务的可执行性。
- 记忆体系:短期记忆(上下文)、中期记忆(外部状态/黑板/向量存储)、长期记忆(知识库与流程规范),实现经验可复用与风险可控。
- 工具与工作流:统一的工具协议(JSON Schema/函数调用)、幂等与重试策略、任务编排引擎(状态机/有向图)、错误隔离与回退策略。
- 评测方法:意图识别—工具调用准确性—任务完成率—成本与时延—安全性与合规性,建立端到端度量与离线+在线双轨评估。

## 三、技术架构与关键要点
- 分层架构:模型层(多模型与路由)、编排层(工作流、权限与审计)、工具层(函数调用、RAG、代码执行、数据接口)、安全层(权限与数据治理)、可观测层(日志、指标、追踪)。
- 多模型与路由:按任务类型与安全等级路由到合适模型,避免“一刀切”,降低幻觉与成本。
- 状态管理:任务ID+状态快照、幂等Key、重试与补偿事务、失败恢复与回退路径。
- 工具治理:沙箱执行、速率限制、依赖与版本锁定、第三方API成本与限流管理。
- RAG增强:检索策略(混合检索、重排序)、上下文注入(模板与引用生成)、证据链与可解释输出。
- 安全与权限:最小权限、数据分级、审计追踪、内容过滤与红队评估,事前事中事后管控闭环。
- 性能与成本:批量与并发、缓存与复用、近线预取(pref暖缓存)、Token预算与速率管理。
- 稳定性工程:灰度发布、AB与守护版、失败注入与混沌工程、回滚策略与SLA约束。

## 四、典型应用场景与落地要点
- 客户支持与销售助理
  - 要点:意图识别—FAQ+RAG—工单集成—多轮追问—升级策略—质检与合规审查。
- 运营自动化(审批、报销、监控告警)
  - 要点:规则与Agent混合、工具化流程、审计日志、异常闭环与审批链。
- 软件研发与测试(代码生成、测试用例、代码审查)
  - 要点:语义变更分析、CI集成、安全扫描、PR守门人、可回溯变更。
- 数据分析与商业智能(BI助手)
  - 要点:元数据治理、数据权限、查询安全(SQL/BI防注入)、可解释与数据溯源。
- 法务与合规(合同审阅与流程跟踪)
  - 要点:隐私与数据驻留、条款比对与风险提示、审计与留痕、敏感信息屏蔽。
- 医疗辅助(知识问答、病历辅助)
  - 要点:医疗知识库与检索、临床指引提示、人机协作闭环与安全责任边界。
- 供应链与物流(计划与执行优化)
  - 要点:数据标准化、约束优化、异常预警、工具化执行与对账。
- 电商与营销(搜索与推荐生成、客服自动化)
  - 要点:内容合规与版权、个性化与隐私保护、投放链路追踪与ROI。

## 五、实施路径与流程方法
- 从概念验证到规模化的“六步法”
  1. 场景与价值界定:任务定义、数据可得性、收益评估与约束条件。
  2. 安全与数据治理基线:数据分级、权限模型、审计标准与合规框架。
  3. 技术选型:模型、编排框架、工具接口、评测与观测栈。
  4. PoC与试点:限定范围、定义成功指标与红线、灰度验证。
  5. 工程化与SRE建设:幂等、重试、回退、容量与SLA、变更管理。
  6. 运营与持续优化:反馈闭环、成本监控、模型与工作流持续升级。
- 里程碑与度量指标:任务完成率、平均时延、单位成本、错误率、用户满意度、风险事件数、数据覆盖度与检索准确率。
- 组织与能力:跨职能团队(产品/工程/数据/安全/合规)、岗位职责(Agent工程师、工具开发者、评测工程师、SRE)、技能栈(Prompt/工具封装/工作流编排/数据与安全)。

## 六、风险、合规与治理
- 模型风险:幻觉与不当输出—通过RAG与证据链、事实校验与模板约束降低。
- 安全风险:提示注入、越权访问、工具链攻击—最小权限、沙箱、输入清理与审计。
- 隐私与合规:PII处理、数据驻留与跨境传输合规、日志与数据留存策略。
- 鲁棒性与漂移:概念漂移与数据变更—持续评测与在线监控、阈值触发与回退。
- 法律与伦理:可解释与责任界定、用户知情与同意、第三方版权与内容合规。
- 红队与演练:场景化攻击与防护测试、定期演练与改进记录。

## 七、工程实践与最佳实践
- 工具封装与标准化:定义函数接口与参数校验、版本化与幂等、错误码与提示信息统一。
- Prompt工程:角色化与意图明确、上下文最小化、工具指令与边界条件清晰。
- 记忆与检索:分层记忆策略、混合检索与重排序、引用链与证据生成。
- 编排策略:状态机/有向图、并发与批处理、失败隔离与补偿事务。
- 评测与观测:离线基准(IFEval等)+在线业务指标;Trace与可观测链路、A/B与守护版。
- 数据治理:元数据、血缘与质量控制、访问与审计策略。
- 成本优化:模型路由、缓存与复用、量化与蒸馏、近线预取与限流。
- 持续迭代:用户反馈与失败案例库、版本发布与回滚机制、知识库与工具更新。

## 八、工具与框架选型建议
- 编排框架:LangGraph(可控状态与图编排)、AutoGen(多Agent对话)、Semantic Kernel(插件化工具)。
- 评测与观测:IFEval、AgentBench、Trace与日志聚合平台;企业可用OpenTelemetry链路与指标标准。
- 数据与知识:向量数据库(如Milvus/FAISS/Weaviate)、RAG平台与知识治理。
- 安全与治理:权限系统(RBAC/ABAC)、数据脱敏与合规审计、内容过滤与红队工具。
- 模型与推理:多模型路由、推理加速(量化、KV缓存、分布式)、成本预算与速率控制。

## 九、失败与经验总结
- 常见失败点:任务边界不清、数据缺口与权限不足、工具不可用或时延过高、评测与观测缺失导致“盲飞”、安全与合规未前置、过度依赖单体LLM未构建可编排工作流。
- 成功关键点:明确任务定义与指标、前置数据与安全治理、标准化工具与幂等机制、双轨评测与可观测、快速迭代与用户反馈闭环、角色化与记忆体系的合理设计。

## 十、结论与展望
Agent时代不是“换模型”,而是“换系统”。当模型从“理解”走向“执行”,企业需要以工程化视角将“能力—流程—安全—观测—治理”整合进同一闭环。技术趋势将继续推动多模态推理、更好的工具调用与长期记忆、跨系统协作的标准化与安全强化。面向未来,最强的竞争力来自于对场景的深刻洞察与数据治理的扎实基础,以及让智能体“可度量、可演进、可稳态”的工程能力。

愿这份调研报告成为你的落地指南针:从试点走向规模化,从能力变为价值,从AI试验室走向业务操作系统。让我们一起拥抱Agent时代,勇敢迈向更高质量、更高效率、更安全的智能应用新篇章!工具调用 (Tool Calling)
MiniMax-M2是专为 Agent 和代码而生的,拥有强大的Agentic表现——能够出色规划并稳定执行复杂长链条工具调用任务,协同调用Shell、Browser、Python代码执行器和各种MCP工具。MiniMax-M2在SGLang部署时默认启用工具调用功能,使模型能够识别何时需要调用外部工具,并以结构化格式输出工具调用参数。 以下脚本实现了一个天气查询工具调用示例:
# test_tool_calling.py
from openai import OpenAI
import json

client = OpenAI(base_url="http://localhost:8000/v1", api_key="EMPTY")

def get_weather(location: str, unit: str):
    return f"Getting the weather for {location} in {unit}..."

tool_functions = {"get_weather": get_weather}

tools = [{
    "type": "function",
    "function": {
        "name": "get_weather",
        "description": "Get the current weather in a given location",
        "parameters": {
            "type": "object",
            "properties": {
                "location": {"type": "string", "description": "City and state, e.g., 'San Francisco, CA'"},
                "unit": {"type": "string", "enum": ["celsius", "fahrenheit"]}
            },
            "required": ["location", "unit"]
        }
    }
}]

response = client.chat.completions.create(
    model=client.models.list().data[0].id,
    messages=[{"role": "user", "content": "What's the weather like in San Francisco? use celsius."}],
    tools=tools,
    tool_choice="auto"
)

print(response)

tool_call = response.choices[0].message.tool_calls[0].function
print(f"Function called: {tool_call.name}")
print(f"Arguments: {tool_call.arguments}")
print(f"Result: {get_weather(**json.loads(tool_call.arguments))}")运行:
python test_tool_calling.py输出结果:
ChatCompletion(id='8e70d4dad944430f9bd2470cafd68744', choices=[Choice(finish_reason='tool_calls', index=0, logprobs=None, message=ChatCompletionMessage(content='<think>Okay, the user is asking about the weather in San Francisco and wants the temperature in Celsius. This is a straightforward request that requires me to get weather information.\n\nLet me think about how to respond. I have access to a tool called "get_weather" which can provide current weather information. Looking at the tool\'s parameters, I need to provide:\n1. A location parameter - this should be a city and optionally state, like "San Francisco, CA"\n2. A unit parameter - the user specifically asked for Celsius, which is one of the accepted values (the other being "fahrenheit")\n\nThe user\'s request is clear and matches exactly what the tool can provide. They want the current weather in San Francisco (I\'ll assume San Francisco, CA since that\'s the most common reference) and they want the temperature in Celsius.\n\nTo properly respond, I should use the tool_calls format as specified in my instructions. I need to format my response with the tool name "get_weather" and pass the arguments as a JSON object with the location and unit parameters.\n\nFor the location, I\'ll use "San Francisco, CA" to be precise, and for the unit, I\'ll use "celsius" as requested.\n\nSo I\'ll make a tool call to get_weather with these parameters to retrieve the current weather information for San Francisco in Celsius, which I can then share with the user.\n</think>\n\n\n', refusal=None, role='assistant', annotations=None, audio=None, function_call=None, tool_calls=[ChatCompletionMessageFunctionToolCall(id='call_7f1ffef8c74f4b55bbe423cb', function=Function(arguments='{"location": "San Francisco, CA", "unit": "celsius"}', name='get_weather'), type='function', index=-1)], reasoning_content=None), matched_stop=None)], created=1762465067, model='/autodl-fs/data/MiniMax/MiniMax-M2', object='chat.completion', service_tier=None, system_fingerprint=None, usage=CompletionUsage(completion_tokens=317, prompt_tokens=231, total_tokens=548, completion_tokens_details=None, prompt_tokens_details=None, reasoning_tokens=0), metadata={'weight_version': 'default'})
Function called: get_weather
Arguments: {"location": "San Francisco, CA", "unit": "celsius"}
Result: Getting the weather for San Francisco, CA in celsius...参数说明与建议
--model-path:模型本地路径(或兼容路径);OpenAI 请求中的 model 字段需与之对应。
--tp-size:张量并行大小。多卡时可等于 GPU 数以提升吞吐/上下文上限。
--ep-size:专家并行大小(按官方 8 卡示例配置)。
--mem-fraction-static:静态显存占比。显存吃紧可下调(例如 0.7/0.6)。
--tool-call-parser minimax-m2:开启 M2 的工具调用解析。
--reasoning-parser minimax-append-think:启用思考内容解析(将 reasoning 追加处理)。
max_tokens:控制生成长度;过大将增加显存和时延。
temperature/top_p:控制多样性。追求稳定确定性可使用较低的 temperature 与 top_p。
显存建议:M2 权重约 220 GB;每 1M 上下文约 240 GB。请结合业务并发与上下文需求评估资源。此外,关于采样参数的选择上,官方推荐使用以下推理参数以获得最好的性能: temperature=1.0, top_p = 0.95, top_k = 20
4-MiniMax-M2 EvalScope
模型评测的意义和价值
模型评测是将模型从“可用”走向“可用且可信”的关键环节。一方面,系统化的基准测试与压力测试能量化模型在知识、推理、对齐与安全等维度的真实表现,帮助发现能力短板、数据偏差与鲁棒性问题,避免带着未知风险上线;另一方面,统一的指标与可复现实验能为模型选型、版本迭代和资源配置提供可比依据,指导工程优化(如上下文长度、并发、推理参数)以达成更优的性价比和用户体验。对业务而言,高质量的评测不仅降低决策与运维成本,还可持续监测回归与漂移,形成“训练—评测—部署—监控”的闭环,加速模型价值落地。
EvalScope 简介
EvalScope 是魔搭官方推出的模型评测与性能基准测试框架,内置多个常用测试基准和评测指标,如 MMLU、CMMLU、C-Eval、GSM8K、ARC、HellaSwag、TruthfulQA、MATH 和 HumanEval 等;支持多种类型的模型评测,包括 LLM、VLM、embedding 模型和 reranker 模型。EvalScope 还适用于多种评测场景,如端到端 RAG 评测、竞技场模式和模型推理性能压测等。此外,通过 ms-swift 训练框架的无缝集成,可一键发起评测,实现了模型训练到评测的全链路支持。
EvalScope 评测使用方法
为了更方便的使用模型,并提升推理速度,我们使用 SGLang 启动一个 OpenAI 格式兼容的服务。
安装相关依赖:
pip install sglang==0.5.5
pip install modelscope==1.31.0
pip install evalscope==1.1.1
pip install bfcl-eval==2025.10.27.1 考虑到部分同学配置环境可能会遇到一些问题,我们在AutoDL平台准备了MiniMax-M2的环境镜像,点击下方链接并直接创建Autodl示例即可。 https://www.codewithgpu.com/i/datawhalechina/self-llm/mimimax-m2
启动模型服务
python -m sglang.launch_server \
  --model-path MiniMaxAI/MiniMax-M2 \
  --tp-size 8 \
  --ep-size 8 \
  --tool-call-parser minimax-m2 \
  --trust-remote-code \
  --host 0.0.0.0 \
  --reasoning-parser minimax-append-think \
  --port 8000 \
--mem-fraction-static 0.85MiniMax-M2 表现
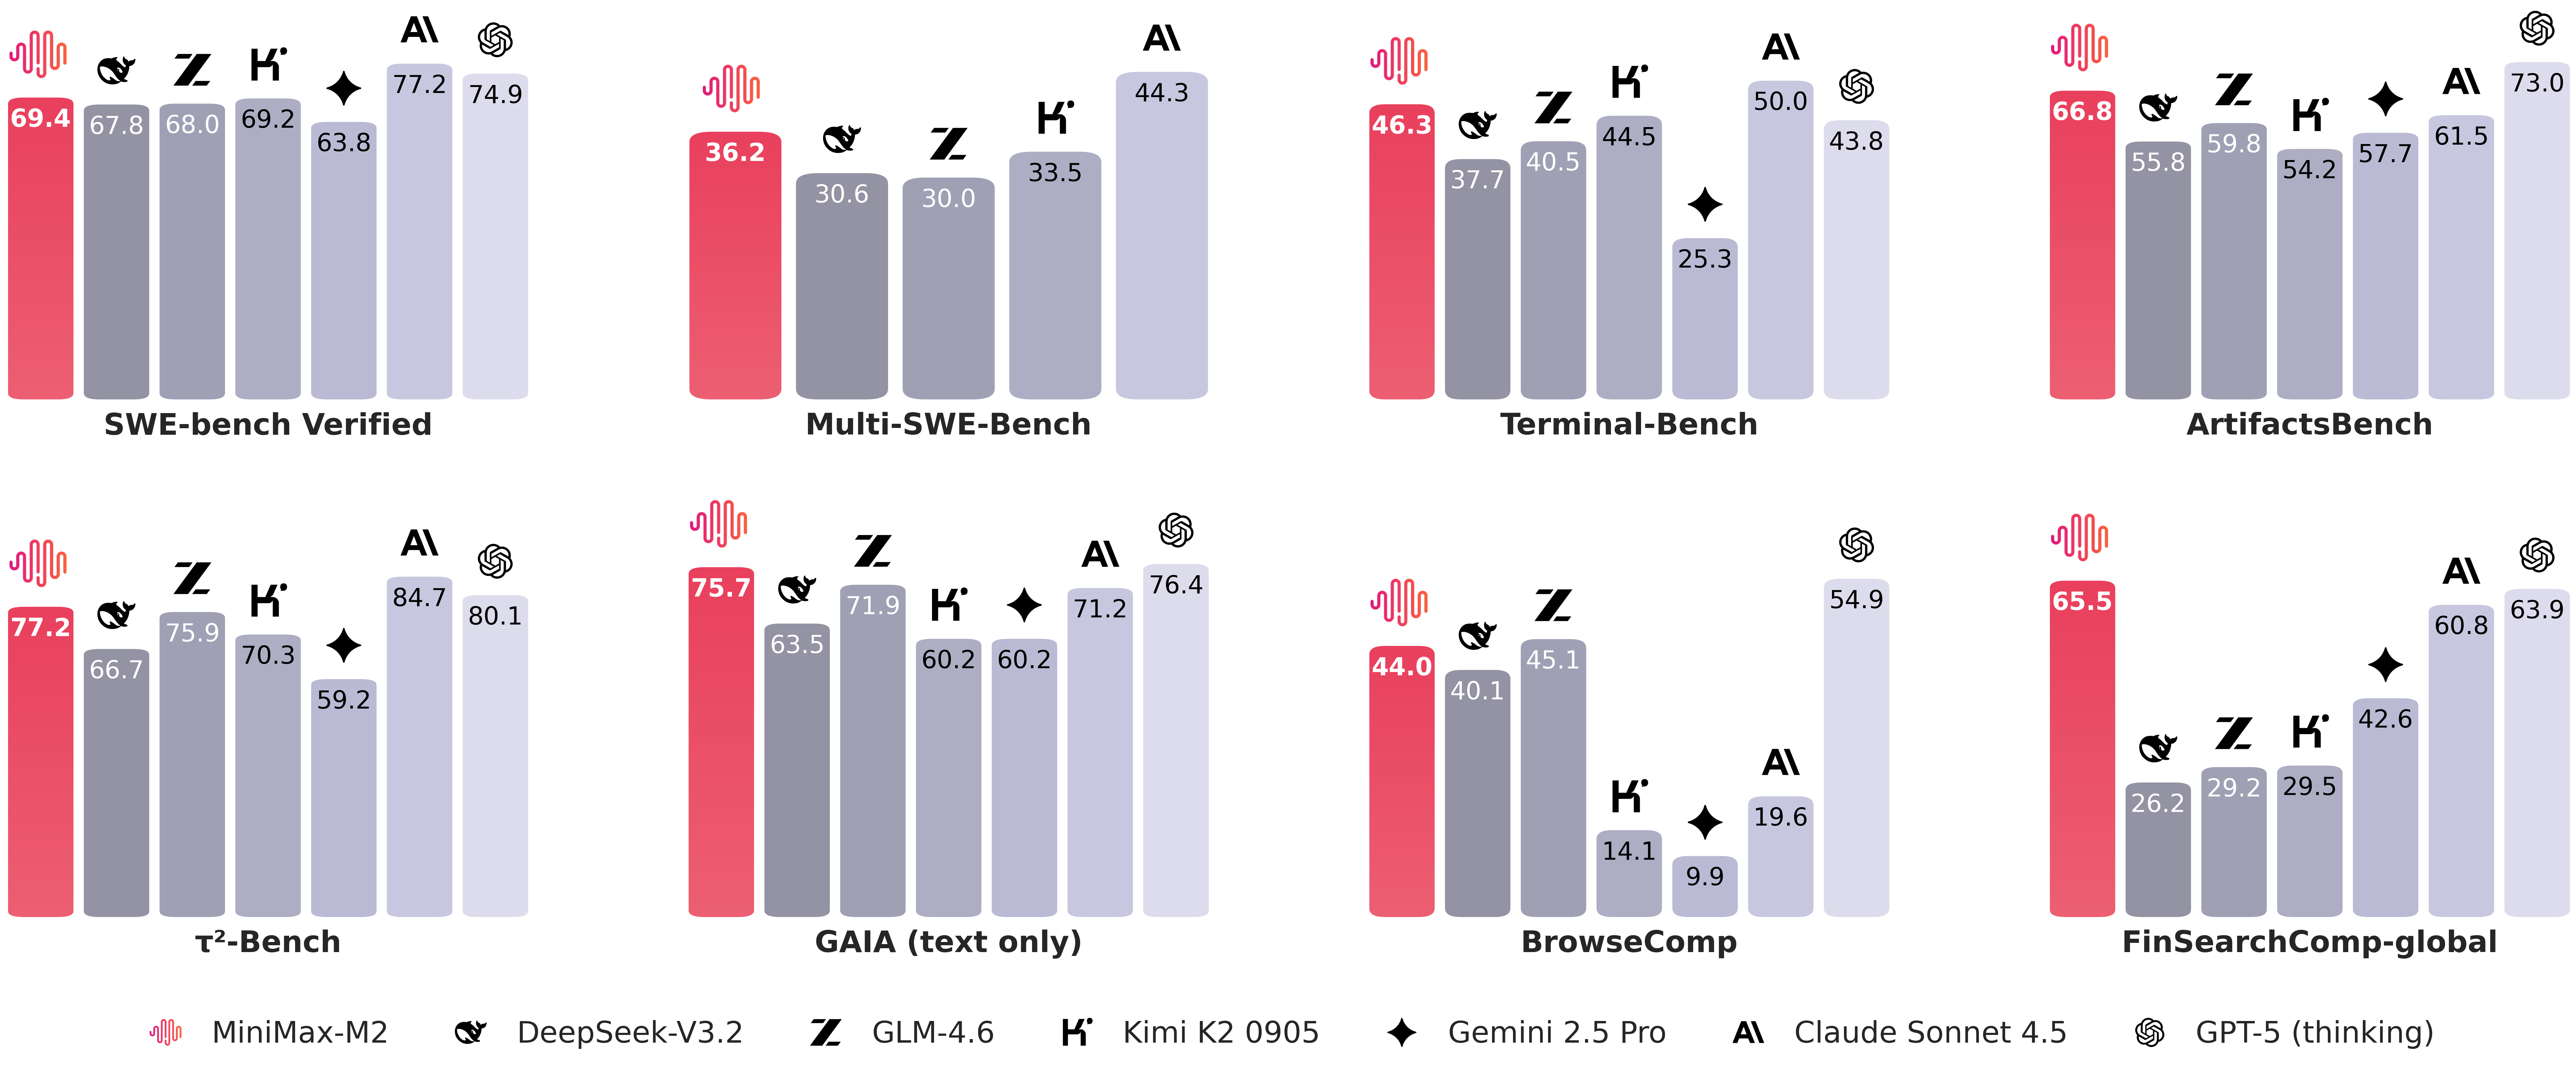
如上图所示,可以发现模型在使用工具和深度搜索的能力都非常接近了海外最好的模型,在编程上逊色于海外最好的模型,但是也已经到了国内最好的一档。我们不妨自己动手来测试一下模型在其他任务上的表现如何。
IQuiz测试
下面我们对模型进行智商情商评测。
我们将使用 EvalScope 模型评测框架,在 IQuiz 数据集上进行评测,这个数据集中收集了 40 道 IQ 测试和 80 道 EQ 测试选择题,其中包括一些大模型时代的经典问题:
数字 9.8 和 9.11 哪个大?
单词 strawberry 和 blueberry 中一共有多少个 r ?
刘雨正在休假,突然被要求开车送领导去机场,他正为休假计划的泡汤而懊恼,因此在送领导时,刹车踩得比较用力。在车上,领导突然说:“小刘啊,这不愧是有着悠久历史的西安,我这坐车有一种回到古代坐马车的感觉。” 领导是什么意思?
在终端输入以下命令:
evalscope eval \
  --model MiniMaxAI/MiniMax-M2 \
  --api-url http://localhost:8000/v1 \
  --api-key EMPTY \
  --eval-type server \
  --eval-batch-size 16 \
  --datasets iquiz \
--work-dir outputs/iquiz/MiniMax-M2测试结果如下:
+------------+-----------+----------+----------+-------+---------+---------+
| Model      | Dataset   | Metric   | Subset   |   Num |   Score | Cat.0   |
+============+===========+==========+==========+=======+=========+=========+
| MiniMax-M2 | iquiz     | mean_acc | IQ       |    40 |  0.825  | default |
+------------+-----------+----------+----------+-------+---------+---------+
| MiniMax-M2 | iquiz     | mean_acc | EQ       |    80 |  0.6375 | default |
+------------+-----------+----------+----------+-------+---------+---------+
| MiniMax-M2 | iquiz     | mean_acc | OVERALL  |   120 |  0.7    | -       |
+------------+-----------+----------+----------+-------+---------+---------+数学能力测试
这里我们选取 AIME2025 为例测试模型的数学能力。
AIME(American Invitational Mathematics Examination)是面向中学到奥数进阶水平的数学竞赛,AIME2025 聚焦代数、几何、数论与组合等核心主题,强调多步推理与严谨计算,常需要中长链条的思考过程。该基准适合评估模型在复杂数学问题上的分析、分解与推导能力,是衡量“推理深度”和“计算准确性”的重要参考。
from evalscope import TaskConfig, run_task

task_cfg = TaskConfig(
    model='MiniMaxAI/MiniMax-M2',
    api_url='http://localhost:8000/v1',
    api_key='EMPTY',
    eval_type='server',
    datasets=['aime25'],
    eval_batch_size=16,
    dataset_args={
        'aime25': {
            # 选择要评测的子集(AIME2025-I 或 AIME2025-II,或两者都评测)
            'subset_list': [
                'AIME2025-I',      # 可以只选择其中一个子集
                # 'AIME2025-II',   # 取消注释以评测第二个子集
            ],
        }
    },
    generation_config={
        'temperature': 0,
        'max_tokens': 65536,  # AIME 数学题需要较长的输出来展示推理过程
    },
    use_cache='outputs/aime25/MiniMax-M2',  # 缓存目录
    limit=5,  # 限制只评测前 5 题
)

run_task(task_cfg=task_cfg)测试结果如下:
+------------+-----------+----------+------------+-------+---------+---------+
| Model      | Dataset   | Metric   | Subset     |   Num |   Score | Cat.0   |
+============+===========+==========+============+=======+=========+=========+
| MiniMax-M2 | aime25    | mean_acc | AIME2025-I |     5 |       1 | default |
+------------+-----------+----------+------------+-------+---------+---------+代码能力测试
LiveCodeBench 是面向“可执行验证”的代码生成评测基准,通过真实或贴近真实的编程题与单元测试进行判定,关注端到端的功能正确性与鲁棒性。该基准能够反映模型在理解需求、合成可运行代码、通过测试用例以及处理边界条件等方面的综合工程能力。
evalscope eval \
  --model MiniMaxAI/MiniMax-M2 \
  --api-url http://localhost:8000/v1 \
  --api-key EMPTY \
  --eval-type server \
  --eval-batch-size 16 \
  --datasets live_code_bench \
  --work-dir outputs/live_code_bench/MiniMax-M2
--limit 10测试结果如下:
+------------+-----------------+----------+----------------+-------+---------+---------+
| Model      | Dataset         | Metric   | Subset         |   Num |   Score | Cat.0   |
+============+=================+==========+================+=======+=========+=========+
| MiniMax-M2 | live_code_bench | pass@1   | release_latest |    10 |       0 | default |
+------------+-----------------+----------+----------------+-------+---------+---------+Agent能力测试
BFCL V4(Berkeley Function Calling Leaderboard V4)是一个针对大型语言模型(LLM)评估其调用函数(工具)能力的基准测试平台。其主要目的是测试模型在执行功能调用时的准确性,尤其是在复杂的编程和工具调用任务中。BFCL V4的核心是评估LLM在与编程语言及其相关工具的交互中的表现,涉及多个领域和应用。
BFCL V4有两个主要的版本或焦点:
基本功能调用测试:该版本评估模型在调用特定函数时的准确性,包括处理编程语言(如Python、Java、JavaScript等)和REST API等工具调用的能力 。
Agentic版本:BFCL V4的Agentic版本扩展了基础版本,特别关注工具调用如何作为智能体系统(Agentic systems)的基础。该版本要求LLM在噪声和程序性错误(如服务器错误、请求限制、权限问题等)下能够执行任务,模拟真实世界的操作环境 。此外,它还引入了多跳Web搜索功能评估,测试模型在复杂问题回答时的能力 。
BFCL V4不仅是对函数调用能力的基本评估,还挑战了LLM在更复杂、动态环境下的表现,尤其是在智能体系统中模拟和执行函数调用的能力,非常适合用来评估模型的Agent能力。
from evalscope import TaskConfig, run_task

task_cfg = TaskConfig(
    model='MiniMaxAI/MiniMax-M2',
    api_url='http://localhost:8000/v1',
    api_key='EMPTY',
    eval_type='server',
    datasets=['bfcl_v4'],
    eval_batch_size=10,
    dataset_args={
        'bfcl_v4': {
            # 评测子任务列表
            'subset_list': [
                'simple_python',
                'simple_java',
                'simple_javascript',
                'multiple',
                'parallel',
                'parallel_multiple'
            ],
            'extra_params':{
                # 模型在函数名称中拒绝使用点号(`.`);设置此项,以便在评估期间自动将点号转换为下划线。
                'underscore_to_dot': True,
                # 模式是否为函数调用模型(Function Calling Model),如果是则会启用函数调用相关的配置;否则会使用prompt绕过函数调用。
                'is_fc_model': True,
            }
        }
    },
    generation_config={
        'temperature': 0
    },
    use_cache='outputs/bfcl_v4', # 建议设置缓存目录,评测出错时可以加快重跑速度
    limit=3,  # 限制评测数量,便于快速测试,正式评测时建议去掉此项
)
run_task(task_cfg=task_cfg)测试结果如下:
+------------+-----------+----------+-------------------+-------+---------+---------+
| Model      | Dataset   | Metric   | Subset            |   Num |   Score | Cat.0   |
+============+===========+==========+===================+=======+=========+=========+
| MiniMax-M2 | bfcl_v4   | acc      | multiple          |     3 |  1      | default |
+------------+-----------+----------+-------------------+-------+---------+---------+
| MiniMax-M2 | bfcl_v4   | acc      | parallel          |     3 |  1      | default |
+------------+-----------+----------+-------------------+-------+---------+---------+
| MiniMax-M2 | bfcl_v4   | acc      | parallel_multiple |     3 |  0.6667 | default |
+------------+-----------+----------+-------------------+-------+---------+---------+
| MiniMax-M2 | bfcl_v4   | acc      | simple_java       |     3 |  0.3333 | default |
+------------+-----------+----------+-------------------+-------+---------+---------+
| MiniMax-M2 | bfcl_v4   | acc      | simple_javascript |     3 |  0.3333 | default |
+------------+-----------+----------+-------------------+-------+---------+---------+
| MiniMax-M2 | bfcl_v4   | acc      | simple_python     |     3 |  1      | default |
+------------+-----------+----------+-------------------+-------+---------+---------+
| MiniMax-M2 | bfcl_v4   | acc      | NON_LIVE          |    18 |  0.8055 | -       |
+------------+-----------+----------+-------------------+-------+---------+---------+
| MiniMax-M2 | bfcl_v4   | acc      | OVERALL           |    18 |  0.0806 | -       |
+------------+-----------+----------+-------------------+-------+---------+---------+ 可视化评估结果
首先,需要额外安装支持可视化的 package
pip install 'evalscope[app]'然后启动服务,访问 http://127.0.0.1:7861 来观察之前评测结果的直观显示
evalscope app