Kimi-VL-多模态推理对话助手
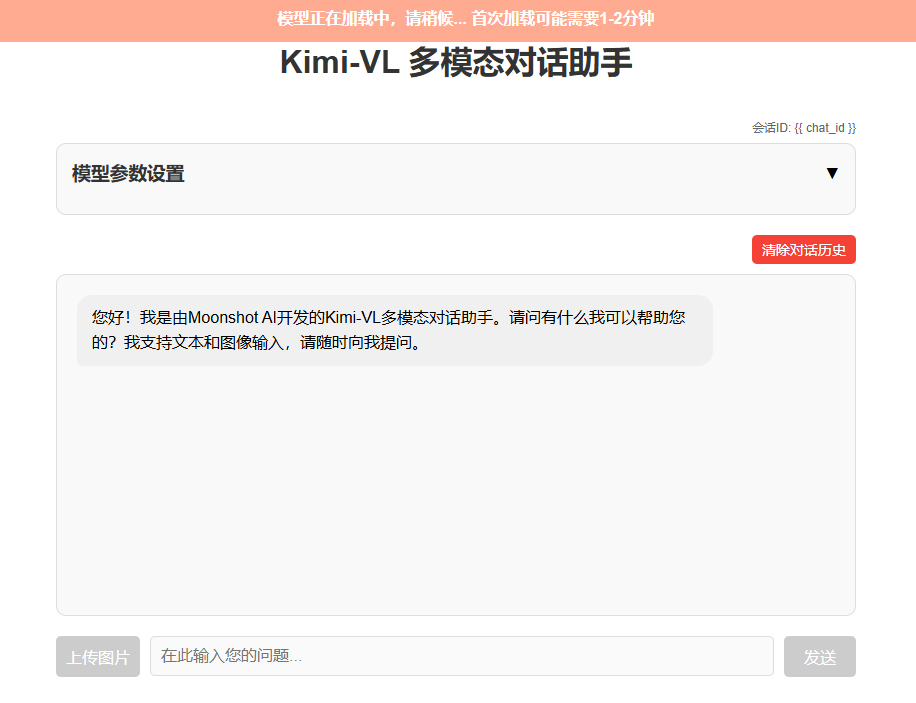
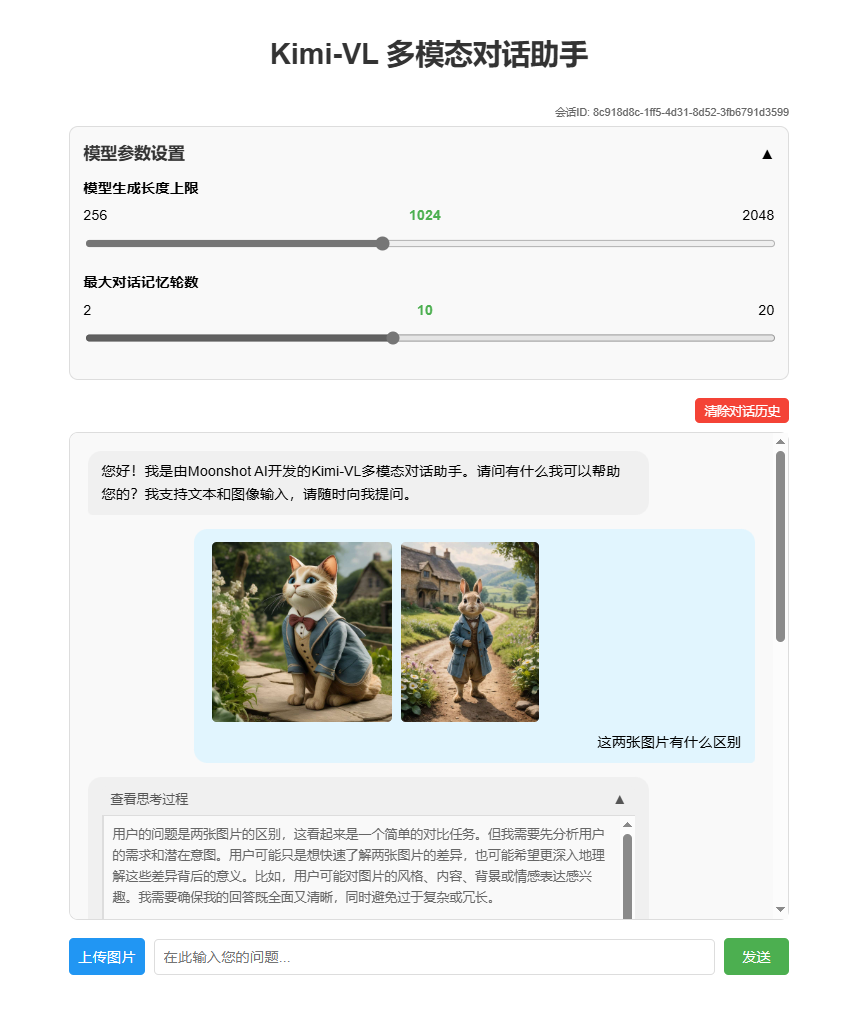
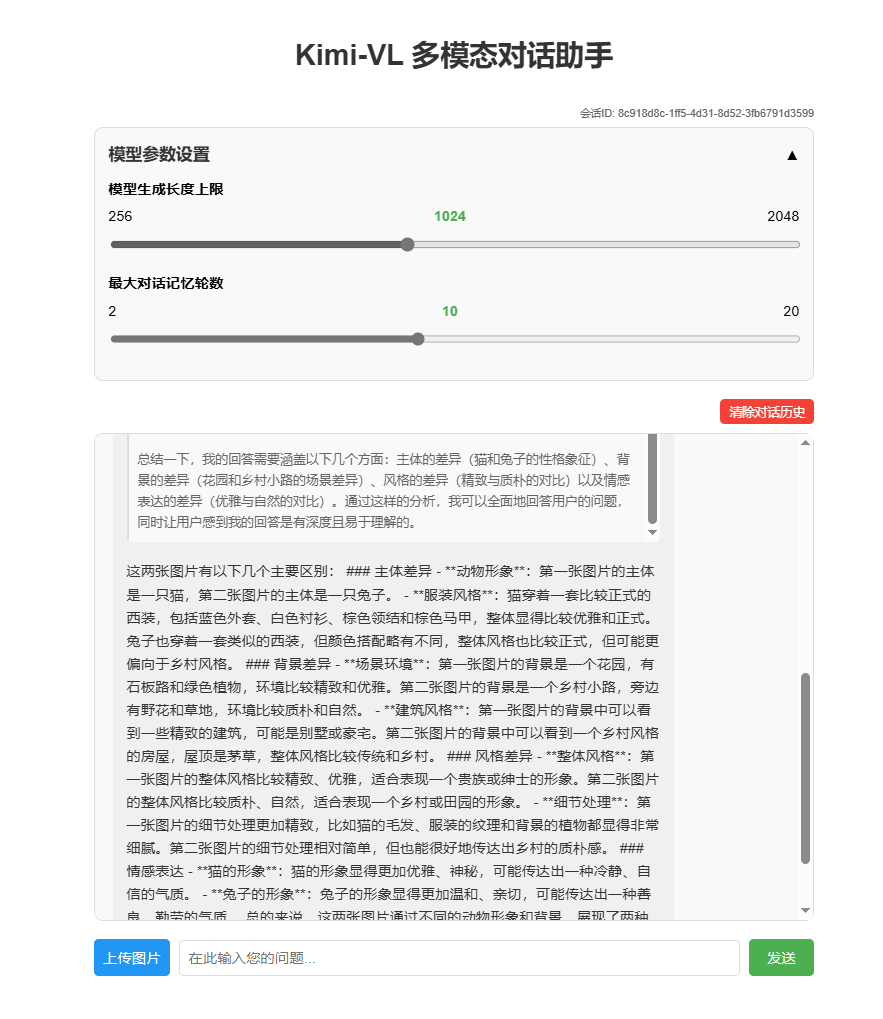
效果展示
环境准备
基础环境:
----------------
ubuntu 22.04
python 3.12
cuda 12.4
pytorch 2.6.0
----------------
另外:保证有足够的GPU显存,bfloat16精度下加载参考显存占用大小40GB(即最低要求为双卡4090或单卡A6000)首先 pip 换源加速下载并安装依赖包
pip config set global.index-url https://pypi.tuna.tsinghua.edu.cn/simple

pip install transformers==4.48.2
pip install accelerate==1.6.0
pip install flask==3.1.0
pip install blobfile==3.0.0
pip install pillow==10.4.0
pip install modelscope==1.22.3模型下载
使用 modelscope 中的 snapshot_download 函数下载模型,第一个参数为模型名称,参数 cache_dir 为模型的下载路径。
新建 model_download.py 文件输入以下代码,并运行 python model_download.py 执行下载。
此处使用 modelscope 提供的 snapshot_download 函数进行下载,该方法对国内的用户十分友好。
# model_download.py
from modelscope import snapshot_download

model_dir = snapshot_download('moonshotai/Kimi-VL-A3B-Thinking', cache_dir='请修改我!', revision='master')
print(f"模型下载完成,保存路径为:{model_dir}")注意:请记得修改
cache_dir为你自己的模型下载路径 ~
应用搭建
后端代码
# app.py

from flask import Flask, request, jsonify, render_template, session
import torch
from transformers import AutoTokenizer, AutoModelForCausalLM, AutoProcessor
import gc
import re
import uuid
import json
import base64
import logging
from io import BytesIO
from PIL import Image

# 配置日志
# logging.basicConfig(level=logging.INFO, format='%(asctime)s - %(name)s - %(levelname)s - %(message)s')
# logger = logging.getLogger(__name__)

app = Flask(__name__)
app.secret_key = "kimi-chatbot-secret-key"  # 用于session加密
# 修改为合理的值:最大100MB
app.config['MAX_CONTENT_LENGTH'] = 100 * 1024 * 1024  # 限制上传文件大小
app.config['MAX_CONTENT_PATH'] = None

# 全局变量存储预加载的模型和tokenizer
MODEL_ID = "请修改我!!!"
tokenizer = None
model = None
processor = None
# 用于存储对话历史的字典
chat_histories = {}
# 默认值设置
DEFAULT_MAX_NEW_TOKENS = 1024
DEFAULT_MAX_HISTORY_LENGTH = 10

# 在应用启动前预加载模型
def load_model():
    global tokenizer, model, processor
    print("正在加载模型和tokenizer,请稍候...")

    # 加载processor (用于处理图像和文本)
    processor = AutoProcessor.from_pretrained(MODEL_ID, trust_remote_code=True)

    # 加载tokenizer
    tokenizer = AutoTokenizer.from_pretrained(MODEL_ID, trust_remote_code=True)

    # 加载模型
    model = AutoModelForCausalLM.from_pretrained(
        MODEL_ID,
        device_map="auto",
        torch_dtype=torch.bfloat16,
        trust_remote_code=True
    )
    print("模型加载完成!")

def clean_response(text):
    """清理模型响应中的特殊token"""
    # 先清理常见的结束标记,包括<|im_end|>和[EOS]
    text = re.sub(r'<\|im_end\|>(\s*\[EOS\])?', '', text)
    text = re.sub(r'\[EOS\]', '', text)

    # 保留思考标签
    # 如果存在思考标签,只清理标签内外的结束标记,保留标签本身
    thinking_pattern = r'◁think▷([\s\S]*?)◁/think▷'
    if re.search(thinking_pattern, text):
        # 思考部分的内容
        def clean_thinking_content(match):
            thinking_content = match.group(1)
            # 清理思考内容中的特殊标记
            thinking_content = re.sub(r'<[\|/]?eot[\|]?>', '', thinking_content)
            thinking_content = thinking_content.replace('<|eot|>', '')
            # 清理额外的结束标记
            thinking_content = re.sub(r'<\|im_end\|>(\s*\[EOS\])?', '', thinking_content)
            thinking_content = re.sub(r'\[EOS\]', '', thinking_content)
            return f'◁think▷{thinking_content}◁/think▷'

        # 先处理思考标签内的内容
        text = re.sub(thinking_pattern, clean_thinking_content, text)

        # 再处理剩余文本中的特殊标记
        remaining_text = re.sub(thinking_pattern, '', text)
        cleaned_remaining = re.sub(r'<[\|/]?eot[\|]?>', '', remaining_text)
        cleaned_remaining = cleaned_remaining.replace('<|eot|>', '')
        # 清理额外的结束标记
        cleaned_remaining = re.sub(r'<\|im_end\|>(\s*\[EOS\])?', '', cleaned_remaining)
        cleaned_remaining = re.sub(r'\[EOS\]', '', cleaned_remaining)

        # 替换原文中的思考标签后的部分
        text = re.sub(r'◁/think▷[\s\S]*', f'◁/think▷{cleaned_remaining}', text)

        return text.strip()
    else:
        # 根据截图中看到的标记,定义可能的标记形式
        patterns = [
            # 直接匹配具体的标记
            '<|eot|>',
            '<|im_end|>',
            '[EOS]'
        ]

        # 应用所有模式
        for pattern in patterns:
            text = text.replace(pattern, '')

        # 使用正则表达式处理可能的其他token
        text = re.sub(r'<[\|/]?eot[\|]?>', '', text)  # 匹配形如 <eot>, </eot>, <|eot|> 等

        return text.strip()

# 从base64字符串转换为PIL图像,并进行压缩处理
def base64_to_image(base64_str):
    if "base64," in base64_str:
        base64_str = base64_str.split("base64,")[1]

    try:
        # logger.info(f"开始处理base64图像,大小约 {len(base64_str) // 1024} KB")
        image_bytes = base64.b64decode(base64_str)
        # logger.info(f"解码后的图像大小: {len(image_bytes) // 1024} KB")

        image = Image.open(BytesIO(image_bytes))

        # 获取原始尺寸
        original_width, original_height = image.size
        # logger.info(f"原始图像尺寸: {original_width}x{original_height}")

        # 压缩大图片,如果宽度或高度超过1500像素,则按比例缩小
        max_size = 1500
        if original_width > max_size or original_height > max_size:
            # 按比例缩放
            if original_width > original_height:
                new_width = max_size
                new_height = int(original_height * (max_size / original_width))
            else:
                new_height = max_size
                new_width = int(original_width * (max_size / original_height))

            # 缩放图像
            image = image.resize((new_width, new_height), Image.LANCZOS)

            # logger.info(f"图像已压缩: {original_width}x{original_height} -> {new_width}x{new_height}")

        # 如果是RGBA模式(带透明通道),转换为RGB
        if image.mode == 'RGBA':
            background = Image.new('RGB', image.size, (255, 255, 255))
            background.paste(image, mask=image.split()[3])  # 使用透明通道作为蒙版
            image = background
            # logger.info("RGBA图像已转换为RGB")

        return image
    except Exception as e:
        # logger.error(f"图像处理错误: {str(e)}", exc_info=True)
        # 返回错误,但不中断处理,而是返回一个默认图像
        return Image.new('RGB', (100, 100), color=(200, 200, 200))

@app.route('/')
def home():
    # 创建会话ID
    if 'chat_id' not in session:
        session['chat_id'] = str(uuid.uuid4())

    # 如果是新会话,初始化聊天历史
    chat_id = session['chat_id']
    if chat_id not in chat_histories:
        chat_histories[chat_id] = []

    # 这里会自动加载前端index.html
    return render_template('index.html', chat_id=chat_id)

@app.route('/api/generate', methods=['POST'])
def generate():
    try:
        # 确保模型已加载
        if tokenizer is None or model is None or processor is None:
            return jsonify({"error": "模型正在加载中,请稍后再试"}), 503

        # 获取请求数据,支持JSON和表单数据
        chat_id = request.form.get('chat_id') or request.json.get('chat_id', session.get('chat_id', str(uuid.uuid4())))
        user_input = request.form.get('user_input') or request.json.get('user_input', '')

        # logger.info(f"收到请求 chat_id: {chat_id}, 请求方法: {request.method}, 内容类型: {request.content_type}")
        # logger.info(f"请求大小: {request.content_length // 1024 if request.content_length else 0} KB")

        # 获取前端传递的参数,如果没有则使用默认值
        max_new_tokens = int(request.form.get('max_new_tokens') or request.json.get('max_new_tokens', DEFAULT_MAX_NEW_TOKENS))
        max_history_length = int(request.form.get('max_history_length') or request.json.get('max_history_length', DEFAULT_MAX_HISTORY_LENGTH))

        # 参数限制,确保在合理范围内
        max_new_tokens = max(256, min(max_new_tokens, 2048))
        max_history_length = max(2, min(max_history_length, 20))

        # 检查是否有消息输入(可以是纯文本或者包含图像)
        has_input = False

        # 如果前端通过JSON传递了完整的历史记录(包含图像)
        chat_history_json = request.form.get('chat_history')
        if chat_history_json:
            try:
                received_history = json.loads(chat_history_json)
                # logger.info(f"收到历史记录,消息数量: {len(received_history)}")

                # 初始化或使用已有聊天历史
                if chat_id not in chat_histories:
                    chat_histories[chat_id] = []

                # 如果收到的历史不为空,且最后一条是用户消息
                if received_history and len(received_history) > 0 and received_history[-1]['role'] == 'user':
                    has_input = True

                    # 获取用户消息内容
                    user_message = received_history[-1]
                    user_message_content = user_message.get('content', [])

                    # 检查content是否是列表类型
                    if not isinstance(user_message_content, list):
                        # 如果不是列表,可能是旧格式的纯文本,直接进入纯文本处理模式
                        # logger.warning("用户消息内容不是列表格式,转为纯文本处理")
                        has_input = False
                    else:
                        # 处理用户消息中的图像
                        images = []
                        processed_content = []
                        has_images = False

                        # logger.info(f"处理用户消息内容,项目数: {len(user_message_content)}")

                        for i, item in enumerate(user_message_content):
                            # logger.info(f"处理消息项 {i}: {item.get('type') if isinstance(item, dict) else '非字典项'}")

                            if isinstance(item, dict) and item.get('type') == 'image' and 'image' in item:
                                has_images = True
                                # 将base64图像转换为PIL图像对象
                                # logger.info(f"开始处理第 {i+1} 张图像")
                                image = base64_to_image(item['image'])
                                images.append(image)
                                processed_content.append({'type': 'image', 'image': f'image_{len(images)-1}'})
                            elif isinstance(item, dict) and item.get('type') == 'text' and 'text' in item:
                                processed_content.append({'type': 'text', 'text': item['text']})
                                # logger.info(f"添加文本内容: {item['text'][:20]}...")

                        # 如果没有图像,使用标准文本处理
                        if not has_images:
                            # logger.warning("未找到图像内容,转为纯文本处理")
                            has_input = False
                        else:
                            # logger.info(f"成功处理 {len(images)} 张图像")
                            # 更新聊天历史中用户消息的图像
                            user_message['content'] = processed_content
                            chat_histories[chat_id].append(user_message)

                            try:
                                # 使用processor处理多模态输入
                                # 构建符合processor要求的消息格式
                                messages = [
                                    {
                                        "role": "user",
                                        "content": processed_content
                                    }
                                ]

                                # 应用聊天模板
                                # logger.info("应用聊天模板...")
                                text = processor.apply_chat_template(messages, add_generation_prompt=True, return_tensors="pt")

                                # 处理输入
                                # logger.info("处理图像输入...")
                                inputs = processor(images=images, text=text, return_tensors="pt", padding=True, truncation=True).to(model.device)

                                # 生成响应
                                # logger.info(f"开始生成响应,max_new_tokens={max_new_tokens}...")
                                with torch.no_grad():
                                    generated_ids = model.generate(**inputs, max_new_tokens=max_new_tokens)

                                # 处理输出
                                generated_ids_trimmed = [
                                    out_ids[len(in_ids):] for in_ids, out_ids in zip(inputs.input_ids, generated_ids)
                                ]

                                response = processor.batch_decode(
                                    generated_ids_trimmed, skip_special_tokens=True, clean_up_tokenization_spaces=False
                                )[0]

                                # 清理响应,移除结束标记
                                cleaned_response = clean_response(response)
                                # logger.info(f"生成的响应: {cleaned_response[:50]}...")

                                # 添加模型回复到历史记录
                                chat_histories[chat_id].append({"role": "assistant", "content": cleaned_response})

                                # 如果历史记录太长,保留最新的max_history_length条
                                if len(chat_histories[chat_id]) > max_history_length * 2:  # 用户和助手消息各占一半
                                    chat_histories[chat_id] = chat_histories[chat_id][-max_history_length*2:]

                                # 清理缓存
                                torch.cuda.empty_cache()
                                gc.collect()

                                return jsonify({
                                    "response": cleaned_response,
                                    "chat_id": chat_id,
                                    "max_new_tokens": max_new_tokens,
                                    "max_history_length": max_history_length
                                })
                            except Exception as e:
                                # logger.error(f"多模态生成过程中出错: {str(e)}", exc_info=True)
                                return jsonify({"error": f"多模态生成过程中出错: {str(e)}"}), 500
            except Exception as e:
                # logger.error(f"处理多模态输入时出错: {str(e)}", exc_info=True)
                return jsonify({"error": f"处理多模态输入时出错: {str(e)}"}), 500

        # 传统文本输入处理(向后兼容)
        if not has_input:
            # logger.info("使用传统文本输入处理")

            # 判断是否有文本输入
            if not user_input and not request.form:
                return jsonify({"error": "请输入问题或上传图片"}), 400

            # 获取或初始化聊天历史
            if chat_id not in chat_histories:
                chat_histories[chat_id] = []

            # 添加用户消息到历史记录
            chat_histories[chat_id].append({"role": "user", "content": user_input})

            # 从历史记录构建消息列表,使用前端传递的历史长度
            messages = chat_histories[chat_id][-max_history_length*2:]  # 用户和助手消息各算一条

            # 应用chat模板
            inputs = tokenizer.apply_chat_template(messages, add_generation_prompt=True, return_tensors="pt", return_dict=True)

            # 生成响应
            with torch.no_grad():
                outputs = model.generate(**inputs.to(model.device), max_new_tokens=max_new_tokens)
            response = tokenizer.batch_decode(outputs[:, inputs["input_ids"].shape[-1]:])

            # 清理缓存
            torch.cuda.empty_cache()
            gc.collect()

            # 清理响应,移除结束标记
            cleaned_response = clean_response(response[0])

            # 添加模型回复到历史记录
            chat_histories[chat_id].append({"role": "assistant", "content": cleaned_response})

            # 如果历史记录太长,保留最新的max_history_length条
            if len(chat_histories[chat_id]) > max_history_length * 2:  # 用户和助手消息各占一半
                chat_histories[chat_id] = chat_histories[chat_id][-max_history_length*2:]

            return jsonify({
                "response": cleaned_response,
                "chat_id": chat_id,
                "max_new_tokens": max_new_tokens,
                "max_history_length": max_history_length
            })

    except Exception as e:
        import traceback
        error_details = traceback.format_exc()
        # logger.error(f"处理请求时发生错误: {str(e)}\n{error_details}")
        return jsonify({"error": str(e)}), 500

@app.route('/api/clear_history', methods=['POST'])
def clear_history():
    try:
        data = request.json
        chat_id = data.get('chat_id', session.get('chat_id'))

        if chat_id and chat_id in chat_histories:
            chat_histories[chat_id] = []
            return jsonify({"success": True, "message": "聊天历史已清除"})
        else:
            return jsonify({"success": False, "error": "无效的会话ID"}), 400
    except Exception as e:
        return jsonify({"success": False, "error": str(e)}), 500

if __name__ == '__main__':
    # 在另一个线程中预加载模型
    import threading
    threading.Thread(target=load_model).start()

app.run(debug=True, host='0.0.0.0', port=5000, use_reloader=False) 注意:同样记得修改
MODEL_ID为你自己的模型下载路径 ~
运行应用
python app.py应用将在 http://localhost:5000 上运行。
注意:启动后模型会在后台自动加载,这可能需要1-2分钟。在此期间,界面会显示"模型正在加载中"的提示,加载完成后才能开始对话。
使用方法
在浏览器中打开 http://localhost:5000
等待模型加载完成(顶部的橙色通知条消失)
根据需要调整参数滑动条:
生成长度上限:控制每次回复生成的最大token数(范围:256-2048)
历史记录长度:控制对话中保留的最大轮数(范围:2-20)
在输入框中输入您的问题
点击"发送"按钮或按Enter键发送问题
等待模型生成回复
继续进行多轮对话,模型会记住之前的对话内容
如需清除对话历史,点击"清除对话历史"按钮
参考代码及其使用
本次教程搭建了一个基于 Kimi-VL-A3B-Thinking 的前后端分离的对话助手,额外提供了参考代码供学习者参考
Kimi-VL技术报告解读
模型介绍
Kimi-VL是由月之暗面开发的开源多模态大模型,采用混合专家(Mixture-of-Experts, MoE)架构,具备视觉感知、长上下文理解和强大的智能体能力,总参数量为16B激活参数量仅为2.8B。较低的推理成本使其能够在参数高性能的基础上实现强大的多模态交互与推理能力
效果评估
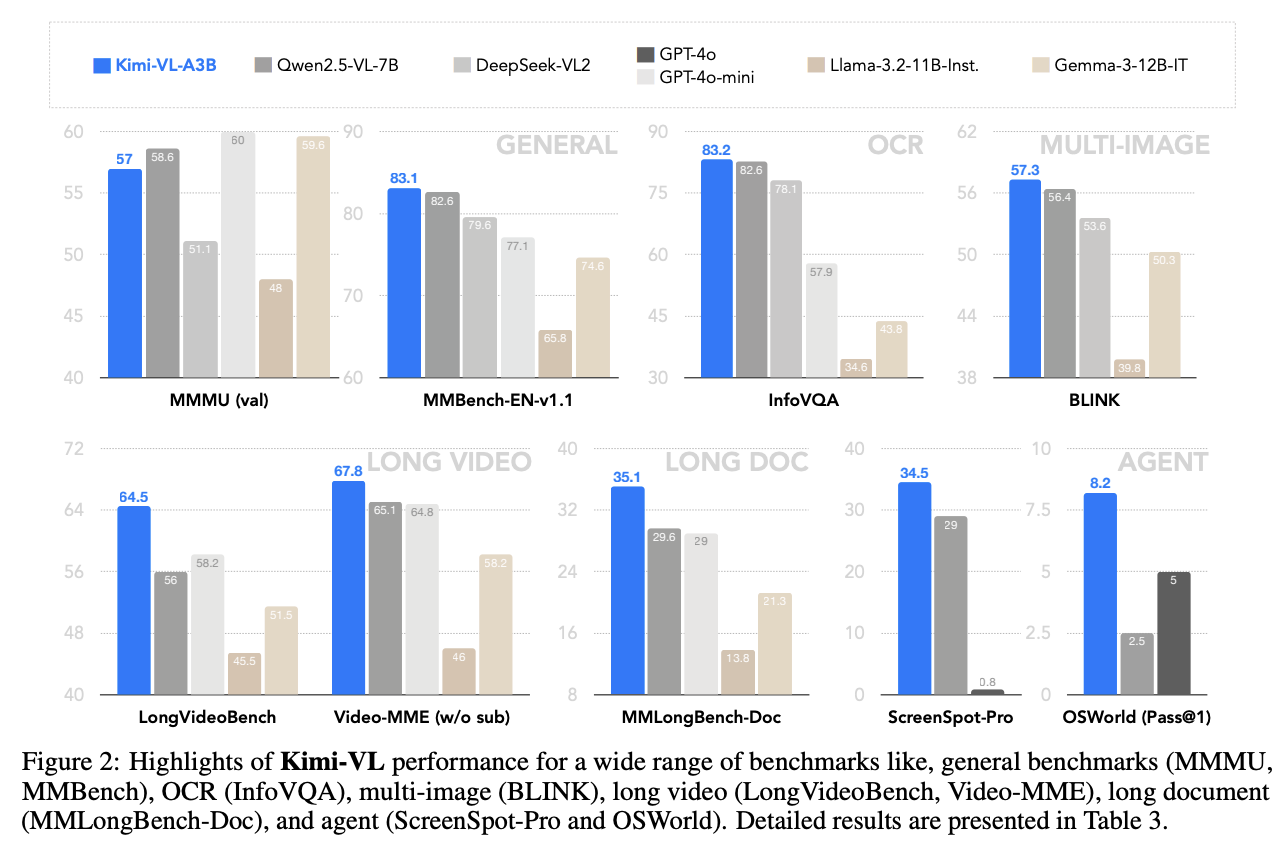
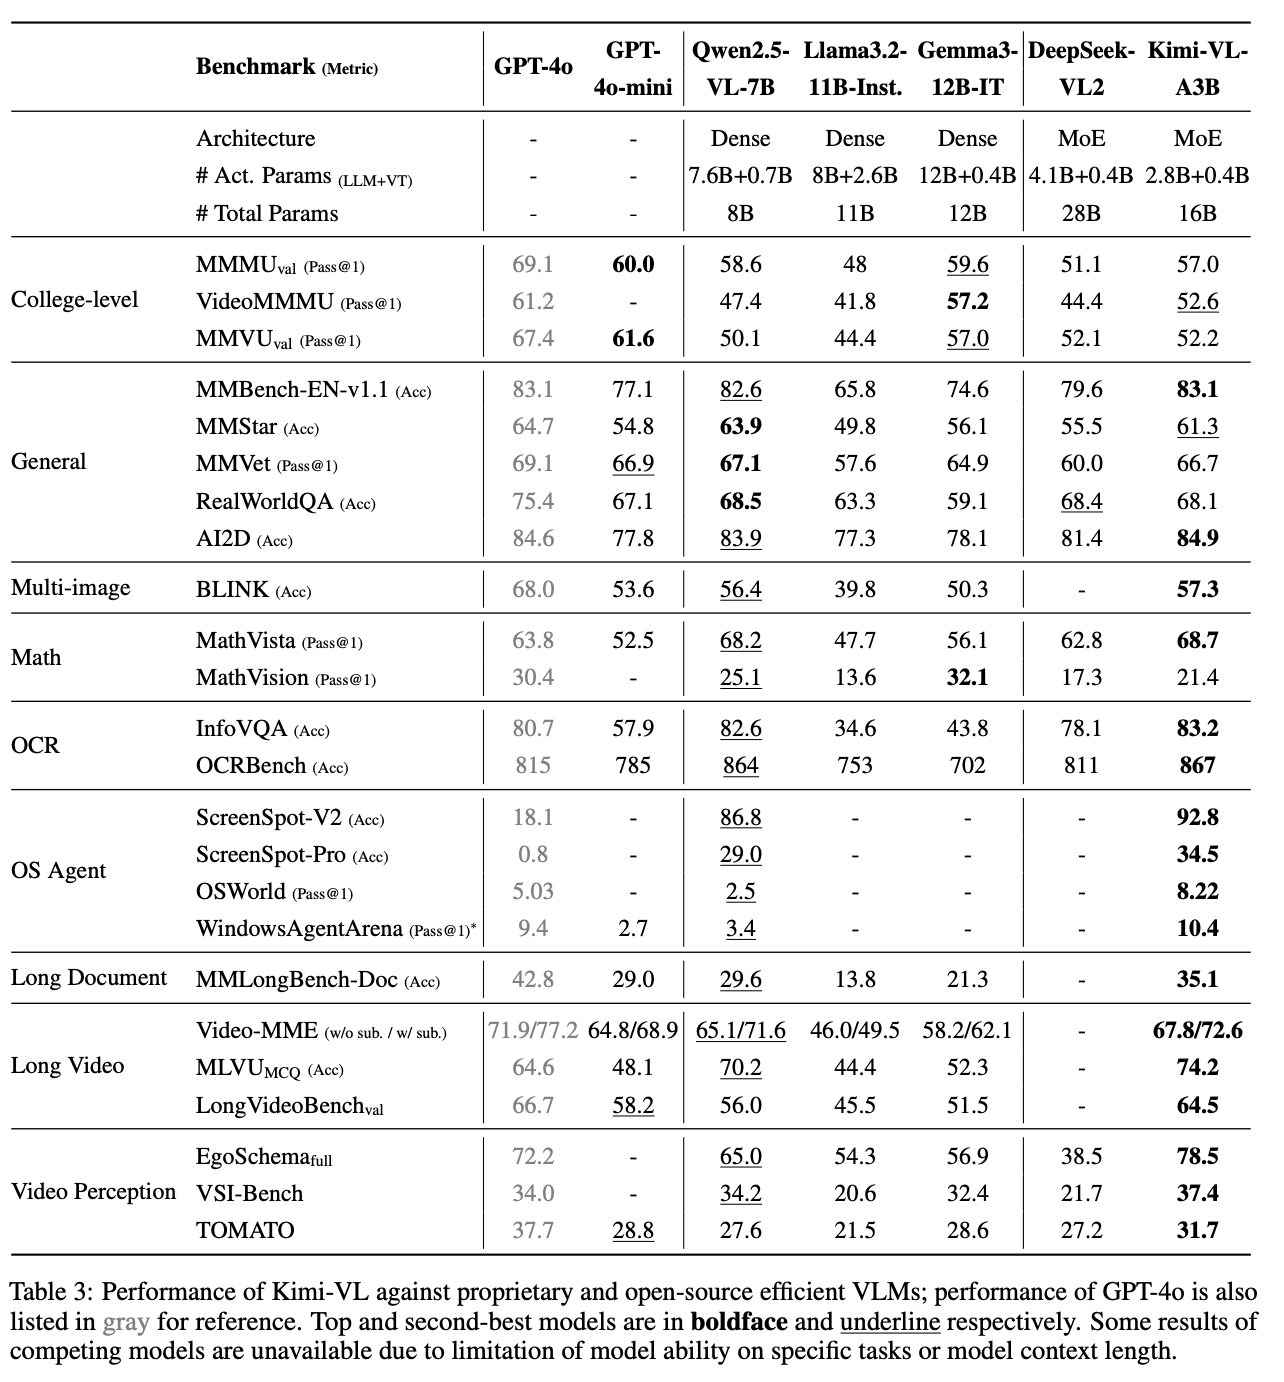
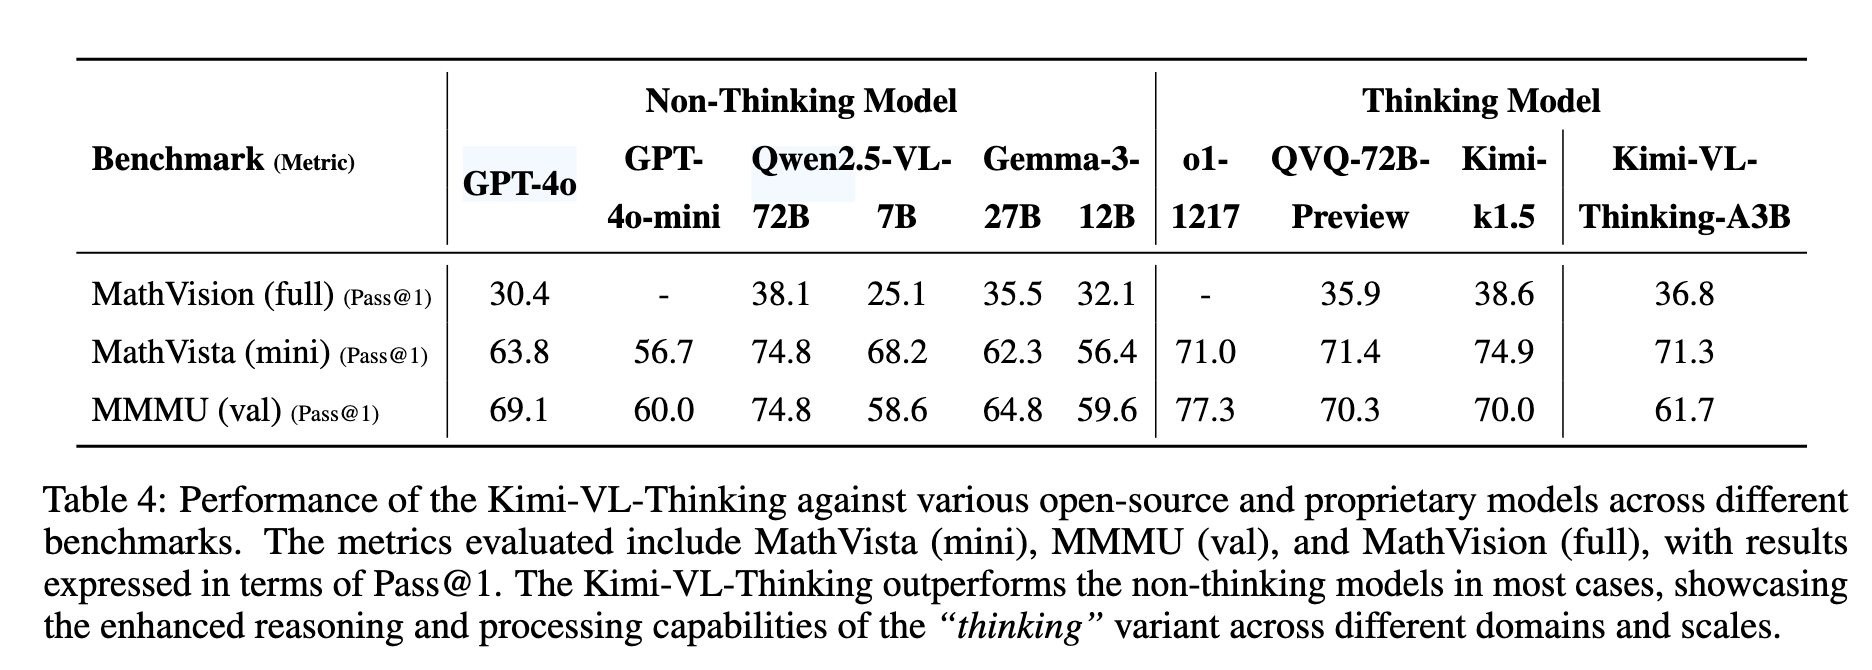
Kimi-VL在InfoVQA、MathVista、LongVideoBench、OSWord、ScreenSpot、WindowsAgentArena、MMLongBench、Video-MME 、EgoSchema、 VSI-Bench等权威基准测试中表现出色,以超越了GPT-4o、Qwen2.5-VL、DeepSeek-VL2等模型。
技术解读
模型架构解读
Kimi-VL的结构主要包含视觉编码器、MLP投影层、MoE解码器三个部分。
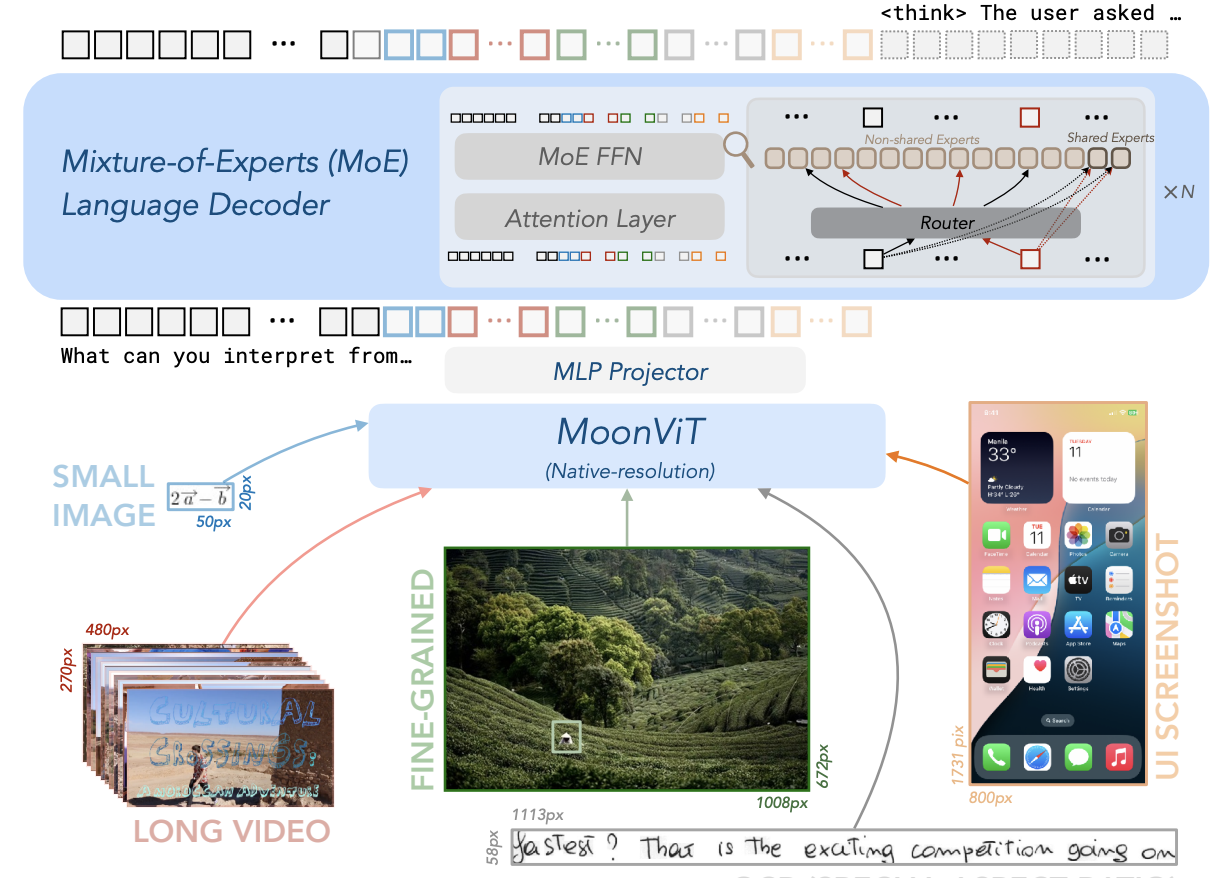
视觉编码器(MoonViT): Kimi-VL的视觉编码器MoonViT允许原生分辨率处理,无需复杂的切割拼接操作,直接处理不同分辨率的视觉输入。MoonViT采用插值绝对位置嵌入和二维旋转位置嵌入(RoPE),增强了对高分辨率图像的细节感知能力。
MLP投影层(Projector): 采用双层MLP结构,将视觉编码器的连续输出特征通过pixel shuffle操作,以空间维度2×2降采样,同时通道维度相应扩展,再经过MLP投影到语言模型空间。投影后的用于表达视觉特征的tokens长度不固定,而是随输入图像的尺寸和处理方式而变化,实现了视觉与语言模态间灵活、高效的融合。
MoE语言解码器(Moonlight): 基于月之暗面自主研发的Moonlight模型,使用Mixture-of-Experts架构,实现仅2.8B激活参数即可达到较大模型的性能水平。
模型训练解读
预训练阶段
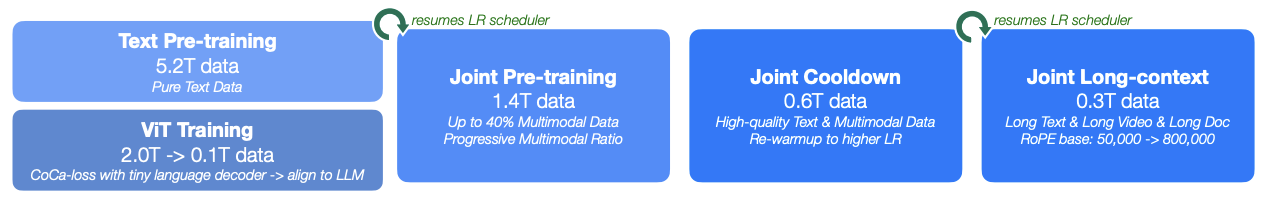
视觉预训练: 该阶段训练MoonViT视觉编码器,使用大规模图文对数据,包括图片alt文本、OCR文字、生成的描述、边界框标注等数据,通过SigLIP风格的对比损失(SigLIP loss)和图像引导下的文本生成(caption loss)两个loss进行训练,提升视觉表征能力。在此过程,MoonViT的输出被训练成能生成连续、高质量的图像语义特征,为后续与语言模型的融合做准备。
联合预训练阶段: 在此阶段,加载了已完成纯文本预训练的MoE语言模型(Moonlight),并与视觉编码器MoonViT进行联合训练,使用1.4T tokens的混合数据(文本+图文),采用逐步增加图文比例的方式,确保语言能力不被弱化。
联合冷却阶段: 为进一步提升模型在高难度任务中的综合能力,Kimi-VL 在预训练完成后进入了“联合冷却阶段”(Joint Cooldown Stage)。该阶段的核心目标是利用更高质量的语言与多模态数据,在不干扰模型已有能力的前提下,有针对性地强化其在数学推理、代码生成、知识问答等领域的表现。无论是纯文本数据还是多模态数据都是用了多重方案对数据进行了清洗和增强。不仅提升了模型的图文对齐能力,也强化了其对复杂视觉语境的理解与处理能力。这种精细化的数据调度策略,保证了模型在保持泛化能力的同时,能够精准提升目标任务上的表现。
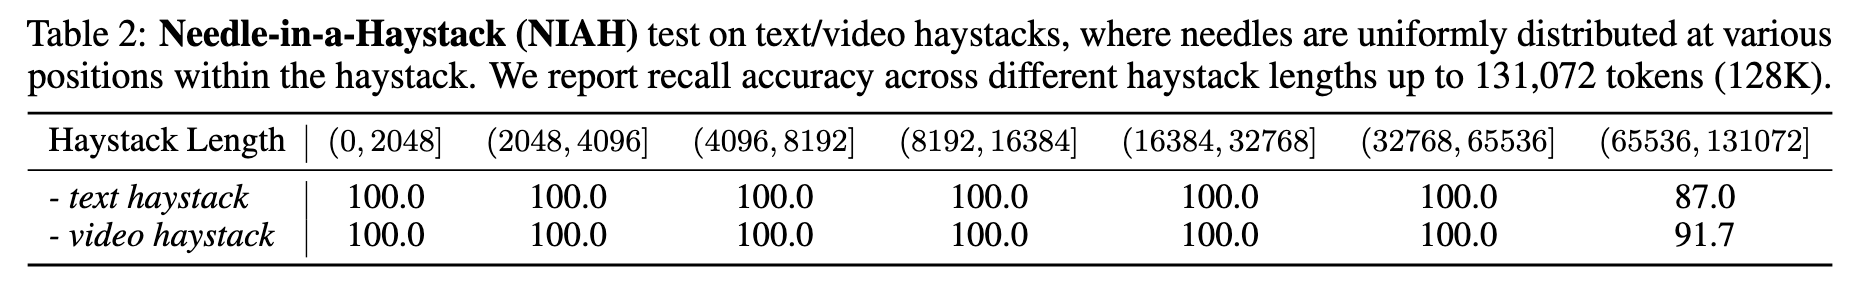
多模态联合长上下文激活阶段: 该阶段通过两轮训练将上下文长度由8K扩展至128K tokens,每个子阶段都将上下文长度扩大四倍。并将RoPE旋转位置编码的频率下限从50,000提升至800,000。每个子阶段中将长文本数据的占比为 25%,其余 75% 的 token 重放前一阶段的短文本数据。为使模型在纯文本和多模态输入场景中均能激活长上下文能力,该阶段所使用的长数据不仅包括长文本,还涵盖了多种类型的长多模态数据。经过长上下文激活训练后,模型能够在Needle-in-a-Haystack(NIAH)任务中成功定位关键信息,无论是在长文本还是长视频场景下,均展现出卓越的检索与理解能力。
后训练阶段
多模态联合SFT: 该阶段通过指令微调对 Kimi-VL 的基座模型进行训练,增强其指令跟随能力与对话互动能力,最终形成可交互的VLLM 模型。在微调过程中,对MoonViT、MLP投影层、MoE LLM进行联合优化,训练数据包含纯文本与图文混合形式的监督微调数据。训练数据使用了精心构建的多模态QA数据,首先在 32K token 的序列长度下进行 1 个epoch的训练,再在 128K token 的序列长度下再进行 1 个epoch的训练。训练采用了学习率衰减策略,在第一个阶段(32K)中,学习率从 2 × 10⁻⁵ 衰减至 2 × 10⁻⁶;在第二阶段(128K)中,先将学习率重新升温(warmup)至 1 × 10⁻⁵,最终再衰减至 1 × 10⁻⁶。
长思维链SFT: 在强化学习前,使用经过筛选的 RL prompt数据和prompt工程构建了一个规模小但质量极高的长链式思维(Long-CoT)数据集。该数据集包括针对文本和图像输入生成的、经过严格验证的推理路径。与传统拒绝采样(Rejection Sampling)方法类似,通过精心设计的提示引导模型生成具备“规划、评估、反思、探索”等人类类推理过程的推理链条:规划->评估->反思->探索。通过使用该数据集的轻量级SFT,模型可以内化这些多模态推理策略,从而提升其在复杂任务中的思考深度与逻辑连贯性。微调后的 Kimi-VL 在生成多模态回答时表现出更为细致、条理清晰的推理能力。
强化学习: 为了进一步提升模型的推理能力,对其进行了大规模的强化学习训练,使其能自主构建结构化的链式思维(CoT)推理过程。与 Kimi k1.5相似,采用了一种变体的在线 Policy Mirror Descent 算法,旨在迭代优化策略模型 π,以提升其问题求解的准确率。优化以下目标函数:$$\max_{\theta} \mathbb{E}{(x, y^) \sim \mathcal{D}} \left[ \mathbb{E}{(y, z) \sim \pi{\theta}} \left[ r(x, y, y^) \right] - \tau \, \mathrm{KL} \left( \pi{\theta}(x) \, | \, \pi_{\theta_i}(x) \right) \right]$$其中,$$r(x, y, y^*) \in {0,1}$$ 是用于评估模型输出答案是否正确的奖励模型,τ 是正则化参数,用于控制策略更新的幅度。此外还引入了长度惩罚机制,用于避免模型在推理中“过度思考”而生成冗余的推理步骤。训练中采用了两种智能采样策略以优化训练路径:1. 课程学习采样(Curriculum Sampling):基于问题难度标签引导模型由浅入深地学习;2. 优先级采样(Prioritized Sampling):根据每个样本的成功率对其训练价值进行动态排序。通过这些策略,模型能够更加集中精力学习具有教学意义的样本,从而加快能力提升的速度。最终,模型逐步发展出关键的元推理能力(Metareasoning),包括错误检测、路径回溯、解法重构等。通过完整历史推理轨迹的上下文利用,实现了“有意识地搜索与修正”的能力,并将这一策略内化至模型中。
训练数据解读
在每个训练阶段所使用的数据如下表:
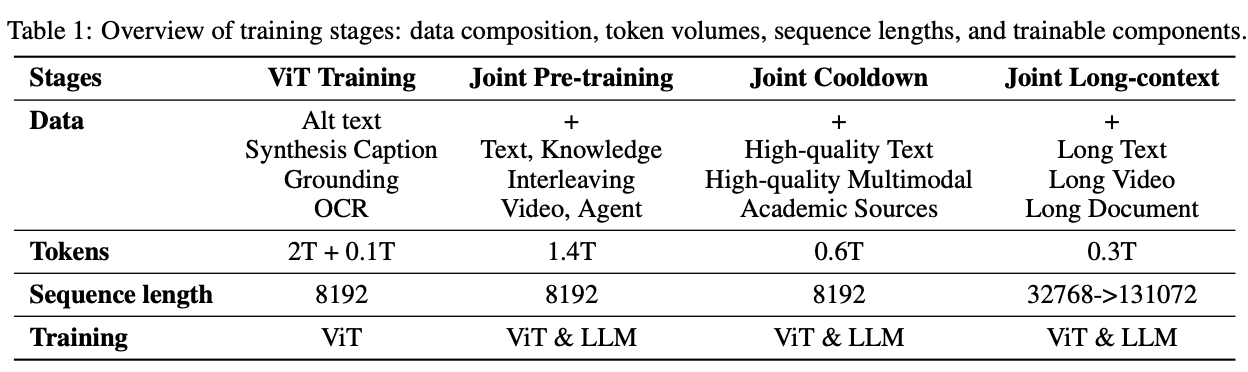
各种数据的处理方式与详细说明如下:
| 数据类型 | 数据来源与处理方式 | 大小 | 作用与用途 |
| 文本数据 | 来源于Moonlight语言模型的预训练语料,涵盖中英文本、代码、数学、推理、百科等领域。数据经过清洗、质量筛选与分布调控,以提升语言建模质量。 | 5.2T tokens | 提供语言建模基础,强化语言理解与生成能力 |
| 图文配对数据(Caption) | 包含LAION、CC等开源中英文图文对,结合月之暗面自建的图文描述数据。合成数据比例受到严格控制以避免幻觉,处理过程包含去重、相关性校验与图像分辨率多样化。 | 约2T tokens | 建立图文对齐能力,学习通用视觉表示与基础图像理解 |
| 图文交织数据(Interleaved) | 来自教材、网页、教程等多来源图文内容,采用结构化提取与重排序策略,保证图文顺序一致性;部分内容为合成,部分来源于开源语料结构化转换。 | - | 支持长图文内容的理解与跨模态上下文建模,特别有助于多图文档类任务 |
| OCR数据 | 包含公开OCR数据集与大规模内部采集数据,涵盖手写、自然图景、扫描文档等;应用图像增强技术(旋转、加噪、变形)以增强鲁棒性,并通过OCR 2.0策略扩展图表、表格识别能力。 | 数百万样本 | 提升模型识别多样化视觉文本(文字、排版、结构等)的能力 |
| 知识类视觉数据 | 从课本、百科、论文等知识性资料中提取图示与图文段落,配合OCR与版面解析组件,生成结构化知识输入。强调图解知识的推理性与专业性。 | - | 加强模型对图解知识、图形推理、空间结构等知识的理解能力 |
| 智能体数据(Agent) | 利用自动化脚本与人类标注器在虚拟桌面/网页中生成截图、动作记录与任务轨迹,并对图标语义与交互行为进行标注。任务轨迹经过整理为结构化多步交互路径。 | 数十万条交互 | 支持模型完成多步操作任务,具备软件GUI理解与智能体执行能力 |
| 视频数据 | 采集自开源视频数据集与网络长短视频,统一为视频帧+描述对格式。长视频采用滑窗方式生成稠密描述,部分为人工标注,部分为合成。 | 数百万帧 | 构建模型时序理解、视频问答、多模态联动的能力 |