InternLM2-7B-chat FastAPI 部署
InternLM2 ,即书生·浦语大模型第二代,开源了面向实用场景的70亿参数基础模型与对话模型 (InternLM2-Chat-7B)。模型具有以下特点:
有效支持20万字超长上下文:模型在20万字长输入中几乎完美地实现长文“大海捞针”,而且在 LongBench 和 L-Eval 等长文任务中的表现也达到开源模型中的领先水平。 可以通过 LMDeploy 尝试20万字超长上下文推理。
综合性能全面提升:各能力维度相比上一代模型全面进步,在推理、数学、代码、对话体验、指令遵循和创意写作等方面的能力提升尤为显著,综合性能达到同量级开源模型的领先水平,在重点能力评测上 InternLM2-Chat-20B 能比肩甚至超越 ChatGPT (GPT-3.5)。
代码解释器与数据分析:在配合代码解释器(code-interpreter)的条件下,InternLM2-Chat-20B 在 GSM8K 和 MATH 上可以达到和 GPT-4 相仿的水平。基于在数理和工具方面强大的基础能力,InternLM2-Chat 提供了实用的数据分析能力。
工具调用能力整体升级:基于更强和更具有泛化性的指令理解、工具筛选与结果反思等能力,新版模型可以更可靠地支持复杂智能体的搭建,支持对工具进行有效的多轮调用,完成较复杂的任务。
环境准备
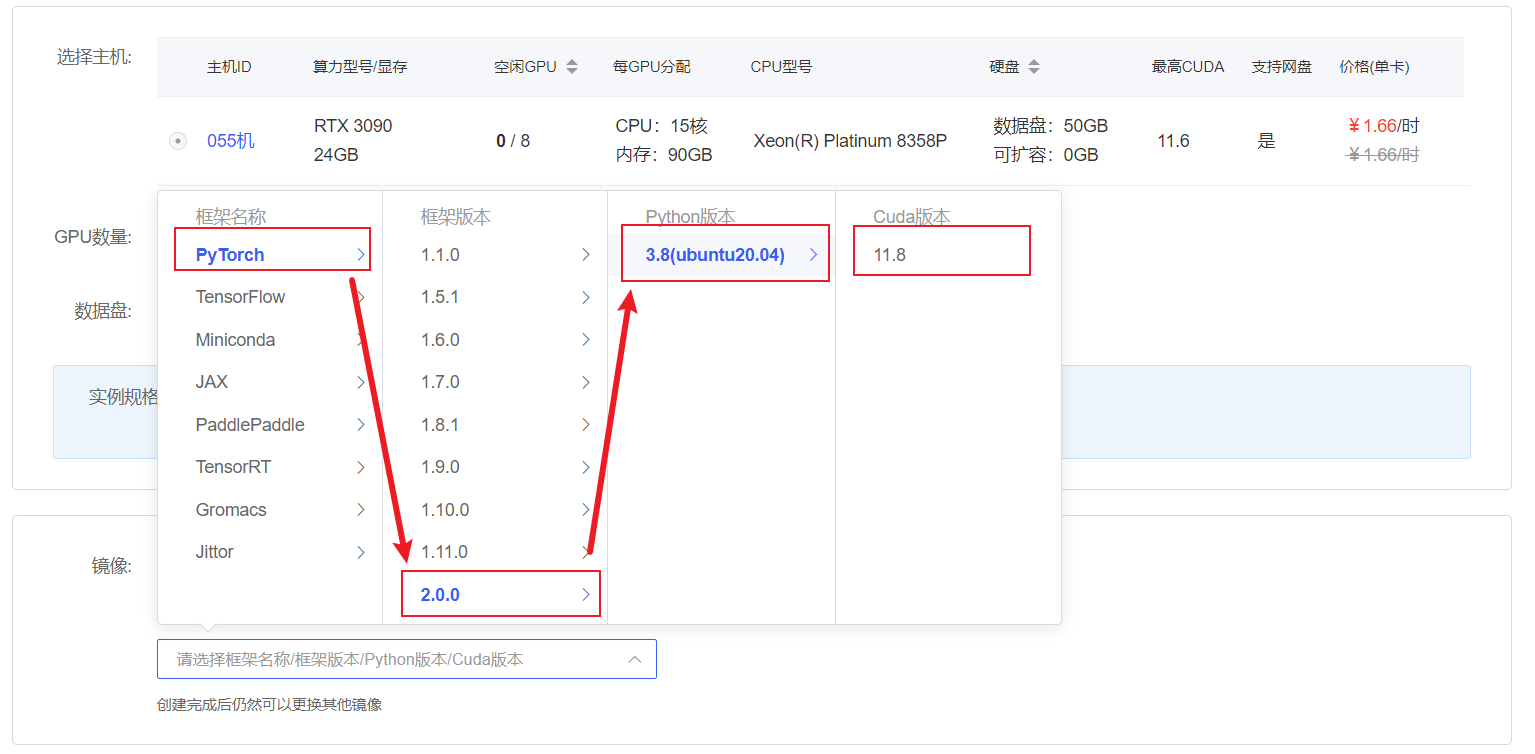
在 Autodl 平台中租赁一个 3090 等 24G 显存的显卡机器,如下图所示镜像选择 PyTorch-->2.0.0-->3.8(ubuntu20.04)-->11.8(11.3 版本以上的都可以)。 接下来打开刚刚租用服务器的 JupyterLab,并且打开其中的终端开始环境配置、模型下载和运行演示。
pip 换源加速下载并安装依赖包
# 升级pip
python -m pip install --upgrade pip
# 更换 pypi 源加速库的安装
pip config set global.index-url https://pypi.tuna.tsinghua.edu.cn/simple

pip install fastapi==0.104.1
pip install uvicorn==0.24.0.post1
pip install requests==2.25.1
pip install modelscope==1.11.0
pip install transformers==4.37.0
pip install streamlit==1.24.0
pip install sentencepiece==0.1.99
pip install accelerate==0.24.1
pip install transformers_stream_generator==0.0.4
pip install protobuf模型下载
使用 modelscope 中的 snapshot_download 函数下载模型,第一个参数为模型名称,参数 cache_dir 为模型的下载路径。
在 /root/autodl-tmp 路径下新建 model_download.py 文件并在其中输入以下内容,粘贴代码后请及时保存文件,如下图所示。并运行 python /root/autodl-tmp/model_download.py 执行下载,模型大小为 14GB,下载模型大概需要 2 分钟。
import torch
from modelscope import snapshot_download, AutoModel, AutoTokenizer
import os
model_dir = snapshot_download('Shanghai_AI_Laboratory/internlm2-chat-7b', cache_dir='/root/autodl-tmp', revision='master')代码准备
在 /root/autodl-tmp 路径下新建 api.py 文件并在其中输入以下内容,粘贴代码后请及时保存文件。下面的代码有很详细的注释,大家如有不理解的地方,欢迎提出 issue。
from fastapi import FastAPI, Request
from transformers import AutoTokenizer, AutoModelForCausalLM, GenerationConfig
import uvicorn
import json
import datetime
import torch

# 设置设备参数
DEVICE = "cuda"  # 使用CUDA
DEVICE_ID = "0"  # CUDA设备ID,如果未设置则为空
CUDA_DEVICE = f"{DEVICE}:{DEVICE_ID}" if DEVICE_ID else DEVICE  # 组合CUDA设备信息

# 清理GPU内存函数
def torch_gc():
    if torch.cuda.is_available():  # 检查是否可用CUDA
        with torch.cuda.device(CUDA_DEVICE):  # 指定CUDA设备
            torch.cuda.empty_cache()  # 清空CUDA缓存
            torch.cuda.ipc_collect()  # 收集CUDA内存碎片

# 创建FastAPI应用
app = FastAPI()

# 处理POST请求的端点
@app.post("/")
async def create_item(request: Request):
    global model, tokenizer  # 声明全局变量以便在函数内部使用模型和分词器
    json_post_raw = await request.json()  # 获取POST请求的JSON数据
    json_post = json.dumps(json_post_raw)  # 将JSON数据转换为字符串
    json_post_list = json.loads(json_post)  # 将字符串转换为Python对象
    prompt = json_post_list.get('prompt')  # 获取请求中的提示

    response, history = model.chat(tokenizer, prompt, history=[])

    now = datetime.datetime.now()  # 获取当前时间
    time = now.strftime("%Y-%m-%d %H:%M:%S")  # 格式化时间为字符串
    # 构建响应JSON
    answer = {
        "response": response,
        "status": 200,
        "time": time
    }
    # 构建日志信息
    log = "[" + time + "] " + '", prompt:"' + prompt + '", response:"' + repr(response) + '"'
    print(log)  # 打印日志
    torch_gc()  # 执行GPU内存清理
    return answer  # 返回响应

# 主函数入口
if __name__ == '__main__':
    # 加载预训练的分词器和模型
    tokenizer = AutoTokenizer.from_pretrained("Shanghai_AI_Laboratory/internlm2-chat-7b", trust_remote_code=True)
    model = AutoModelForCausalLM.from_pretrained("Shanghai_AI_Laboratory/internlm2-chat-7b", torch_dtype=torch.float16, trust_remote_code=True).cuda()
    model = model.eval()

    # 启动FastAPI应用
    # 用6006端口可以将autodl的端口映射到本地,从而在本地使用api
uvicorn.run(app, host='0.0.0.0', port=6006, workers=1) # 在指定端口和主机上启动应用Api 部署
在终端输入以下命令启动api服务:
cd /root/autodl-tmp
python api.py加载完毕后出现如下信息说明成功。
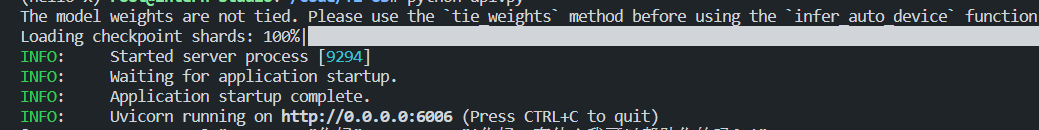
默认部署在 6006 端口,通过 POST 方法进行调用,可以使用 curl 调用,如下所示:
curl -X POST "http://127.0.0.1:6006" \
     -H 'Content-Type: application/json' \
-d '{"prompt": "你好"}'也可以使用 python 中的 requests 库进行调用,如下所示:
import requests
import json

def get_completion(prompt):
    headers = {'Content-Type': 'application/json'}
    data = {"prompt": prompt}
    response = requests.post(url='http://127.0.0.1:6006', headers=headers, data=json.dumps(data))
    return response.json()['response']

if __name__ == '__main__':
print(get_completion('你好'))得到的返回值如下所示:
{"response":"你好!有什么我可以帮助你的吗?","status":200,"time":"2024-02-05 18:08:19"}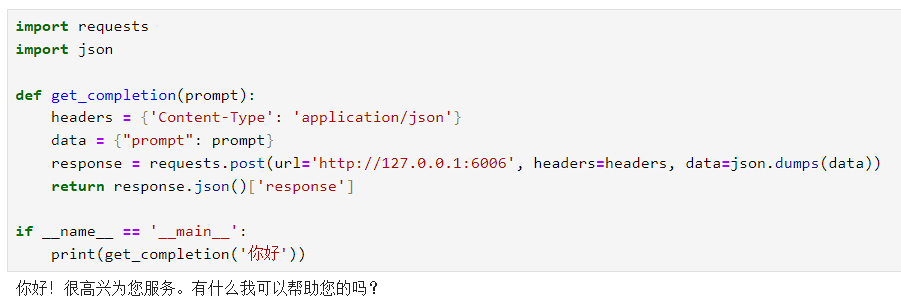
InternLM2-7B-chat langchain 接入
InternLM2 ,即书生·浦语大模型第二代,开源了面向实用场景的70亿参数基础模型与对话模型 (InternLM2-Chat-7B)。模型具有以下特点:
有效支持20万字超长上下文:模型在20万字长输入中几乎完美地实现长文“大海捞针”,而且在 LongBench 和 L-Eval 等长文任务中的表现也达到开源模型中的领先水平。 可以通过 LMDeploy 尝试20万字超长上下文推理。
综合性能全面提升:各能力维度相比上一代模型全面进步,在推理、数学、代码、对话体验、指令遵循和创意写作等方面的能力提升尤为显著,综合性能达到同量级开源模型的领先水平,在重点能力评测上 InternLM2-Chat-20B 能比肩甚至超越 ChatGPT (GPT-3.5)。
代码解释器与数据分析:在配合代码解释器(code-interpreter)的条件下,InternLM2-Chat-20B 在 GSM8K 和 MATH 上可以达到和 GPT-4 相仿的水平。基于在数理和工具方面强大的基础能力,InternLM2-Chat 提供了实用的数据分析能力。
工具调用能力整体升级:基于更强和更具有泛化性的指令理解、工具筛选与结果反思等能力,新版模型可以更可靠地支持复杂智能体的搭建,支持对工具进行有效的多轮调用,完成较复杂的任务。
环境准备
在 autodl 平台中租赁一个 3090 等 24G 显存的显卡机器,如下图所示镜像选择 PyTorch-->2.0.0-->3.8(ubuntu20.04)-->11.8
接下来打开刚刚租用服务器的 JupyterLab,并且打开其中的终端开始环境配置、模型下载和运行 demo。
pip 换源加速下载并安装依赖包
# 升级pip
python -m pip install --upgrade pip
# 更换 pypi 源加速库的安装
pip config set global.index-url https://pypi.tuna.tsinghua.edu.cn/simple

pip install modelscope==1.11.0
pip install transformers==4.37.0
pip install sentencepiece==0.1.99
pip install accelerate==0.24.1
pip install transformers_stream_generator==0.0.4
pip install langchain
pip install protobuf模型下载
使用 modelscope 中的 snapshot_download 函数下载模型,第一个参数为模型名称,参数 cache_dir 为模型的下载路径。
在 /root/autodl-tmp 路径下新建 model_download.py 文件并在其中输入以下内容,粘贴代码后请及时保存文件,如下图所示。并运行 python /root/autodl-tmp/model_download.py 执行下载,模型大小为 14GB,下载模型大概需要 2 分钟。
import torch
from modelscope import snapshot_download, AutoModel, AutoTokenizer
import os
model_dir = snapshot_download('Shanghai_AI_Laboratory/internlm2-chat-7b', cache_dir='/root/autodl-tmp', revision='master')代码准备
为便捷构建 LLM 应用,我们需要基于本地部署的 InternLM2-LM,自定义一个 LLM 类,将 InternLM2 接入到 LangChain 框架中。完成自定义 LLM 类之后,可以以完全一致的方式调用 LangChain 的接口,而无需考虑底层模型调用的不一致。
基于本地部署的 InternLM2 自定义 LLM 类并不复杂,我们只需从 LangChain.llms.base.LLM 类继承一个子类,并重写构造函数与 _call 函数即可:
from langchain.llms.base import LLM
from typing import Any, List, Optional
from langchain.callbacks.manager import CallbackManagerForLLMRun
from transformers import AutoTokenizer, AutoModelForCausalLM, GenerationConfig, LlamaTokenizerFast
import torch

class InternLM2_LLM(LLM):
    # 基于本地 Qwen2 自定义 LLM 类
    tokenizer: AutoTokenizer = None
    model: AutoModelForCausalLM = None

    def __init__(self, mode_name_or_path :str):

        super().__init__()
        print("正在从本地加载模型...")
        self.tokenizer = AutoTokenizer.from_pretrained(mode_name_or_path, trust_remote_code=True)
        self.model = AutoModelForCausalLM.from_pretrained(mode_name_or_path, torch_dtype=torch.float16, trust_remote_code=True).cuda()
        self.model = self.model.eval()
        print("完成本地模型的加载")

    def _call(self, prompt : str, stop: Optional[List[str]] = None,
                run_manager: Optional[CallbackManagerForLLMRun] = None,
                **kwargs: Any):

        response, history = self.model.chat(self.tokenizer, prompt, history=[])

        return response
    @property
    def _llm_type(self) -> str:
return "InternLM2_LLM"在上述类定义中,我们分别重写了构造函数和 _call 函数:对于构造函数,我们在对象实例化的一开始加载本地部署的 InternLM2 模型,从而避免每一次调用都需要重新加载模型带来的时间过长;_call 函数是 LLM 类的核心函数,LangChain 会调用该函数来调用 LLM,在该函数中,我们调用已实例化模型的 chat 方法,从而实现对模型的调用并返回调用结果。
在整体项目中,我们将上述代码封装为 LLM.py,后续将直接从该文件中引入自定义的 LLM 类。
代码运行
然后就可以像使用任何其他的langchain大模型功能一样使用了。
from LLM import InternLM2_LLM

llm = InternLM2_LLM(mode_name_or_path = "/root/autodl-tmp/Shanghai_AI_Laboratory/internlm2-chat-7b")
llm("你是谁")InternLM2-7B-chat WebDemo 部署
InternLM2 ,即书生·浦语大模型第二代,开源了面向实用场景的70亿参数基础模型与对话模型 (InternLM2-Chat-7B)。模型具有以下特点:
有效支持20万字超长上下文:模型在20万字长输入中几乎完美地实现长文“大海捞针”,而且在 LongBench 和 L-Eval 等长文任务中的表现也达到开源模型中的领先水平。 可以通过 LMDeploy 尝试20万字超长上下文推理。
综合性能全面提升:各能力维度相比上一代模型全面进步,在推理、数学、代码、对话体验、指令遵循和创意写作等方面的能力提升尤为显著,综合性能达到同量级开源模型的领先水平,在重点能力评测上 InternLM2-Chat-20B 能比肩甚至超越 ChatGPT (GPT-3.5)。
代码解释器与数据分析:在配合代码解释器(code-interpreter)的条件下,InternLM2-Chat-20B 在 GSM8K 和 MATH 上可以达到和 GPT-4 相仿的水平。基于在数理和工具方面强大的基础能力,InternLM2-Chat 提供了实用的数据分析能力。
工具调用能力整体升级:基于更强和更具有泛化性的指令理解、工具筛选与结果反思等能力,新版模型可以更可靠地支持复杂智能体的搭建,支持对工具进行有效的多轮调用,完成较复杂的任务。
环境准备
在 Autodl 平台中租赁一个 3090 等 24G 显存的显卡机器,如下图所示镜像选择 PyTorch-->2.0.0-->3.8(ubuntu20.04)-->11.8。
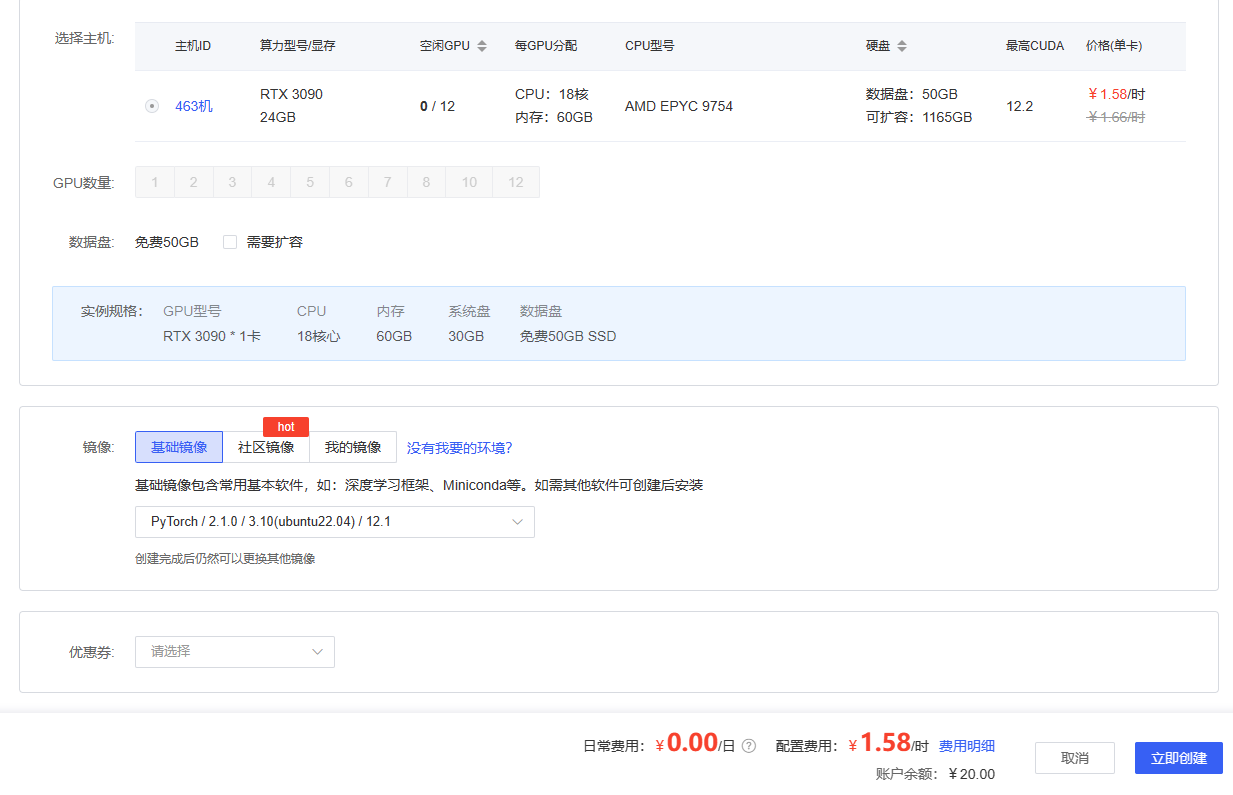
接下来打开刚刚租用服务器的 JupyterLab,新建一个Internlm2-7b-chat-web.ipynb文件
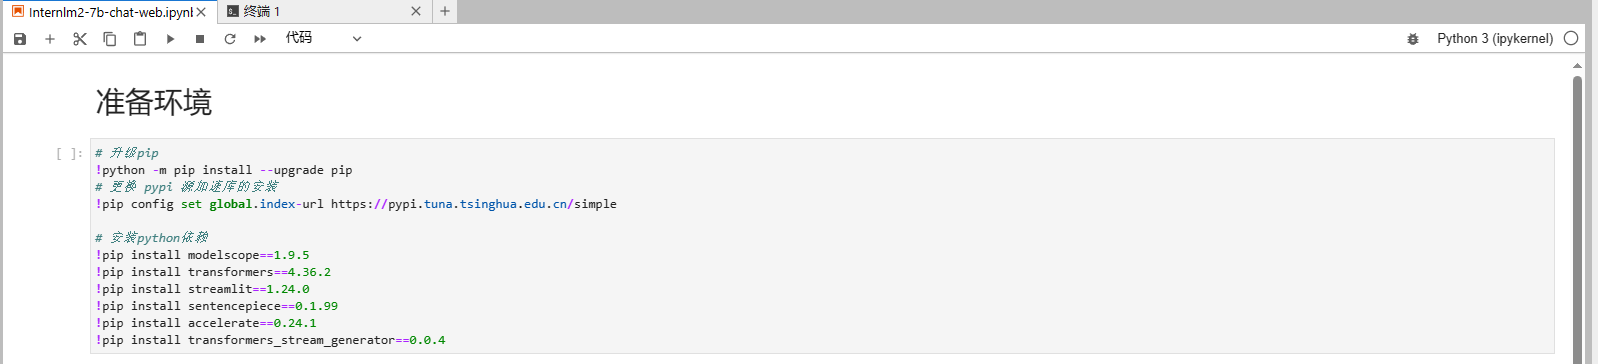
pip换源和安装依赖包,在ipynb文件里写入下面代码,点击运行
# 升级pip
!python -m pip install --upgrade pip
# 更换 pypi 源加速库的安装
!pip config set global.index-url https://pypi.tuna.tsinghua.edu.cn/simple

# 安装python依赖
!pip install modelscope==1.9.5
!pip install transformers==4.36.2
!pip install streamlit==1.24.0
!pip install sentencepiece==0.1.99
!pip install accelerate==0.24.1
!pip install transformers_stream_generator==0.0.4
pip install protobuf如果你是在终端命令运行直接就按下面的命令运行
# 升级pip
python -m pip install --upgrade pip
# 更换 pypi 源加速库的安装
pip config set global.index-url https://pypi.tuna.tsinghua.edu.cn/simple

# 安装python依赖
pip install modelscope==1.9.5
pip install transformers==4.36.2
pip install streamlit==1.24.0
pip install sentencepiece==0.1.99
pip install accelerate==0.24.1
pip install transformers_stream_generator==0.0.4模型下载
InternLM2-chat-7b 模型:
使用modelscope下载
使用 modelscope 中的 snapshot_download 函数下载模型,第一个参数为模型名称,参数 cache_dir 为模型的下载路径。
from modelscope import snapshot_download

model_dir = snapshot_download('Shanghai_AI_Laboratory/internlm2-chat-7b', cache_dir='/root/autodl-tmp', revision='master')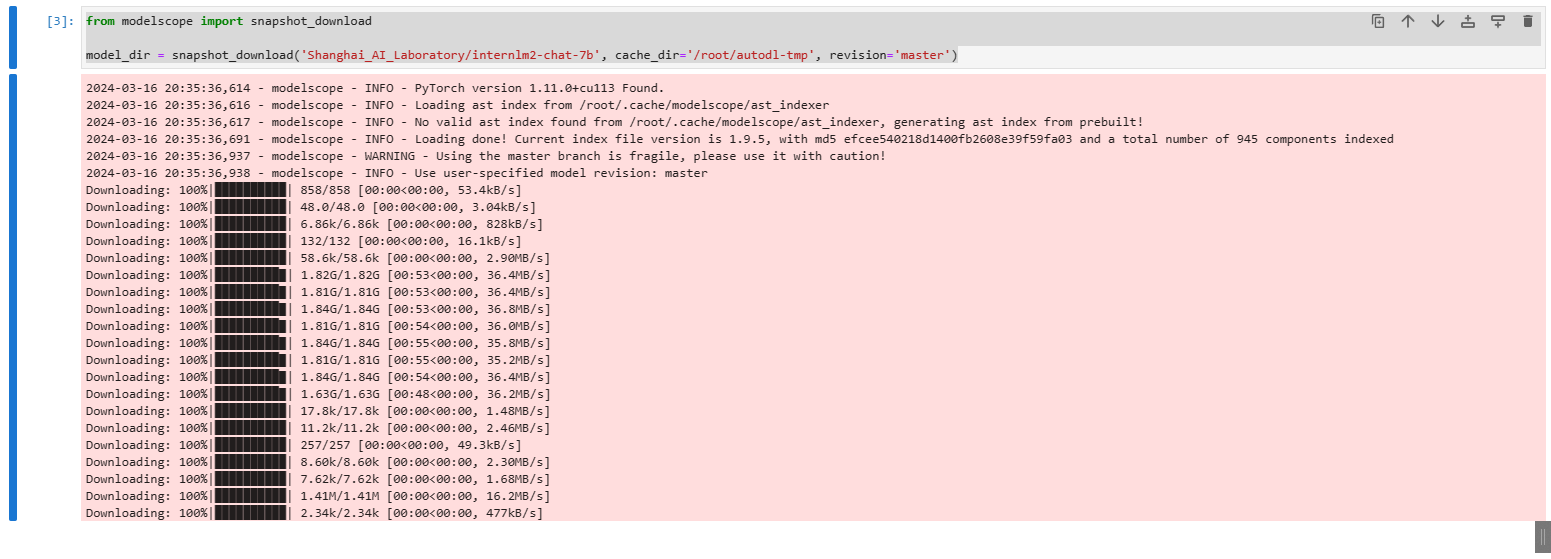
代码准备
源码拉取
以下操作,可以在jupyter运行下载模型的过程中,你新开一个命令行终端进行操作
# 启动镜像加速
source /etc/network_turbo

cd /root/autodl-tmp
# 下载 Internlm 代码
git clone https://github.com/InternLM/InternLM.git
# 取消代理
unset http_proxy && unset https_proxy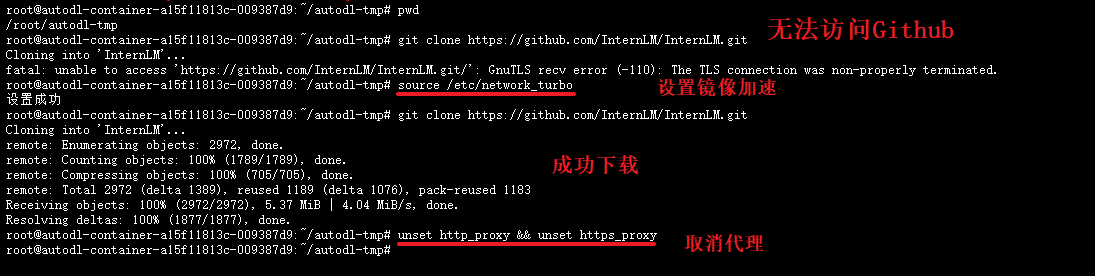
安装依赖
# 进入源码目录
cd /root/autodl-tmp/InternLM/
# 安装internlm依赖
pip install -r requirements.txt使用InternLM的web_demo运行
将 /root/autodl-tmp/InternLM/chat/web_demo.py中 183 行和 186 行的模型更换为本地的/root/autodl-tmp/Shanghai_AI_Laboratory/internlm2-chat-7b。
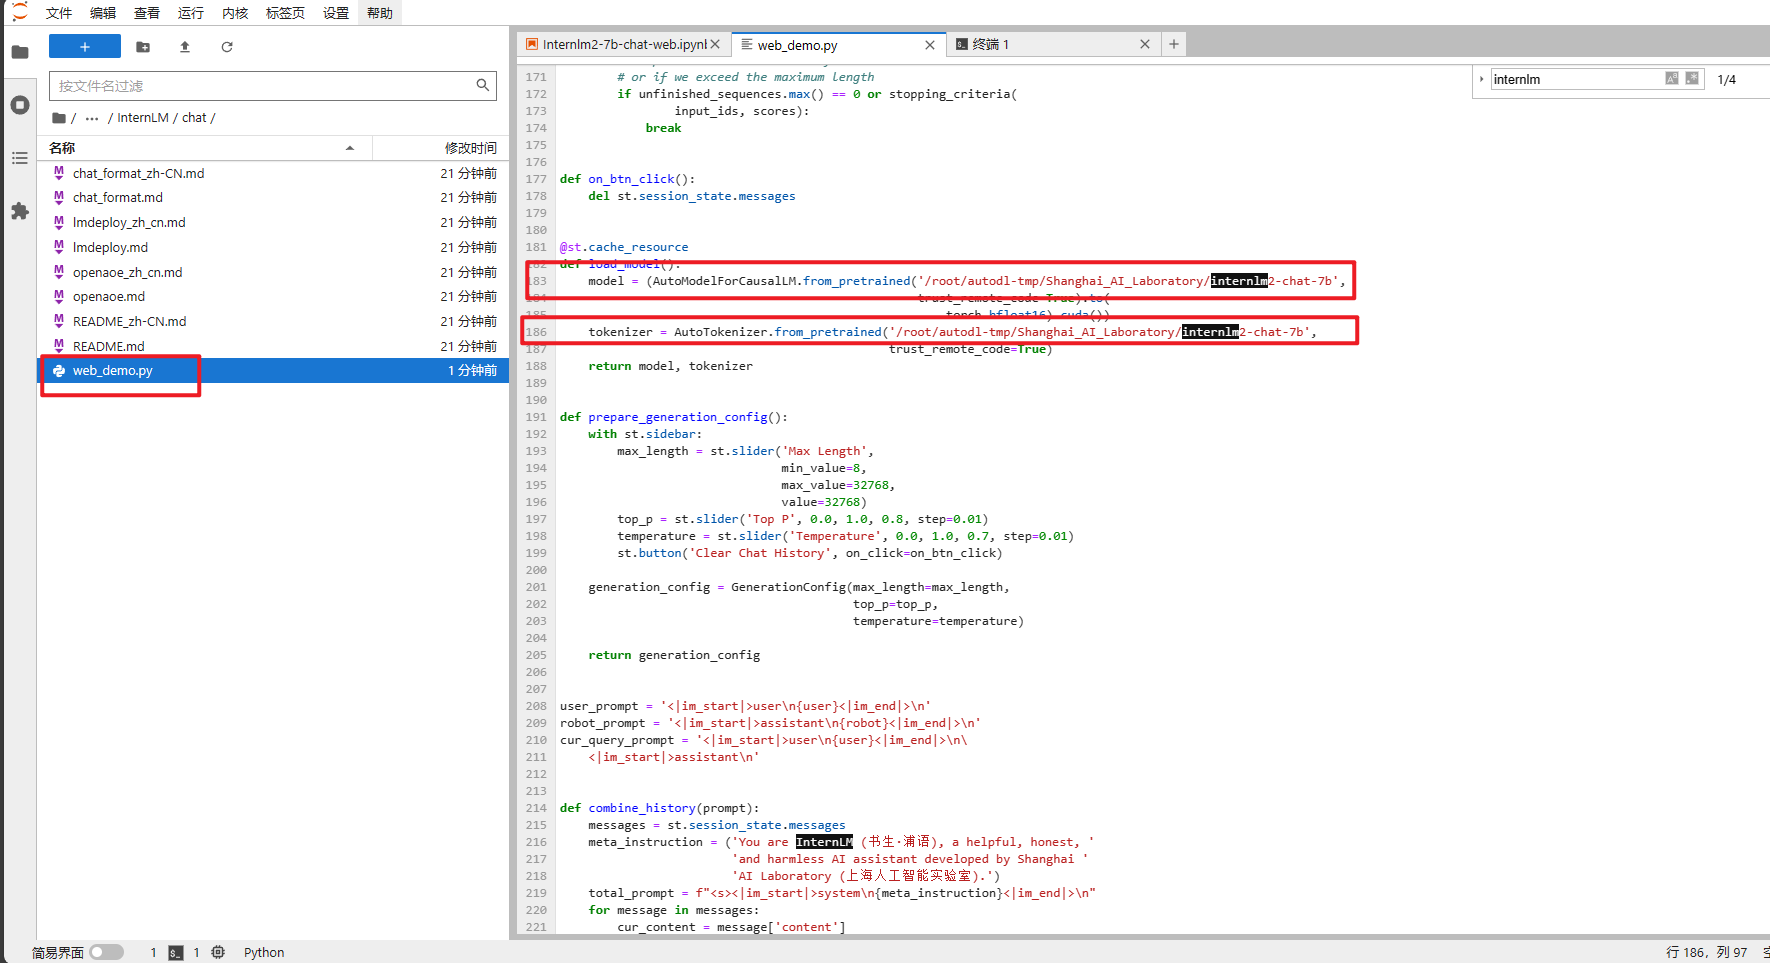
修改完成之后,启动web_demo.py文件
# 进入源码目录
cd /root/autodl-tmp/InternLM/
streamlit run ./chat/web_demo.py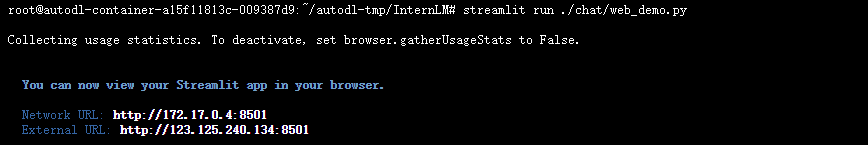
此时,我们通过ssh端口转发,把autodl上启动的服务映射到本地端口上来,使用下面的命令。在本地打开powershell
ssh -CNg -L 8501:127.0.0.1:8501 -p 【你的autodl机器的ssh端口】 root@[你的autodl机器地址]
ssh -CNg -L 8501:127.0.0.1:8501 -p 36494 root@region-45.autodl.pro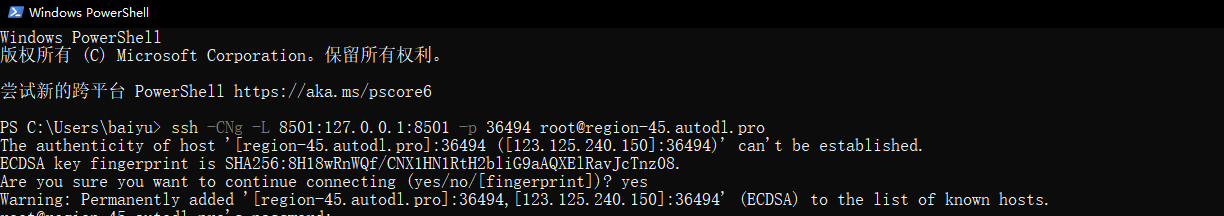
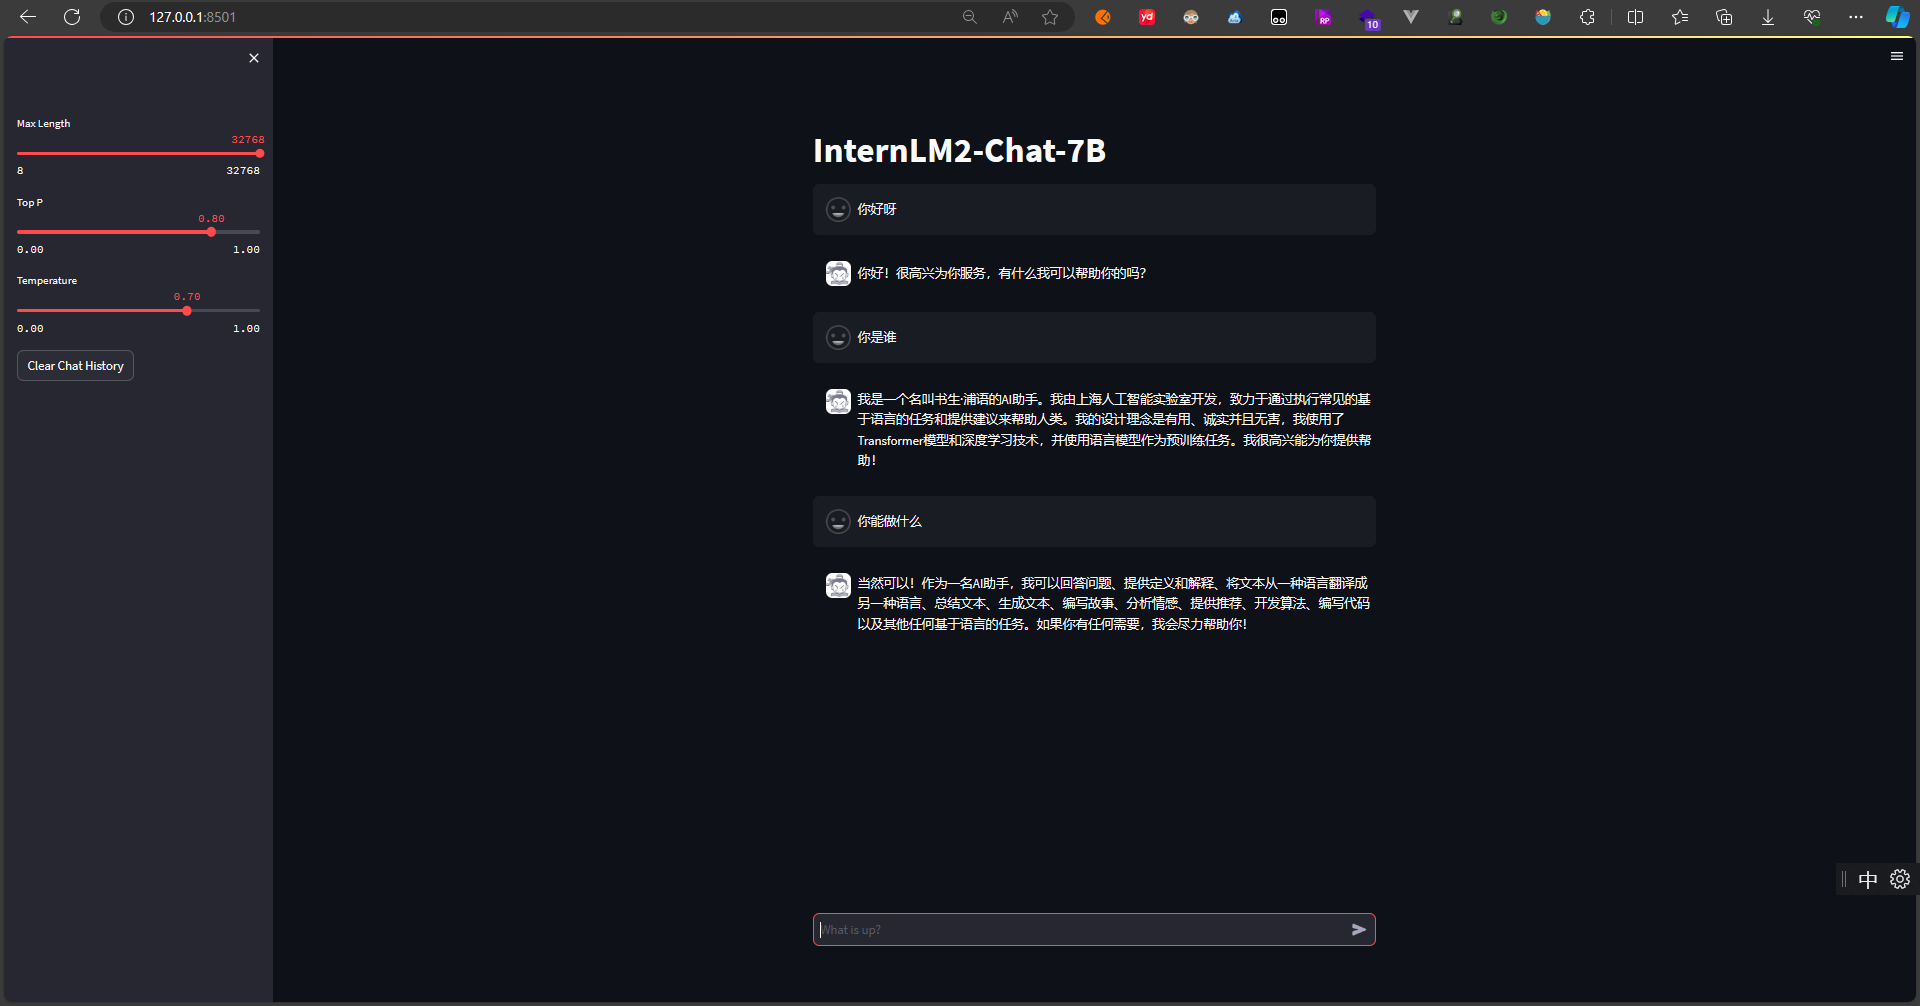
在加载完模型之后,就可以既可与InternLM2-Chat-7B进行对话了,如下图所示:
InternLM2-7B-chat Xtuner Qlora 微调
Xtuner介绍
XTuner是上海人工智能实验室开发的低成本大模型训练工具箱,XTuner 是一个高效、灵活、全能的轻量化大模型微调工具库。只要8G。最低只需 8GB 显存,就可以微调InternLM2-7B模型,打造专属于你的 AI 助手。
仓库地址:https://github.com/InternLM/xtuner
Xtuner特点
高效
支持大语言模型 LLM、多模态图文模型 VLM 的预训练及轻量级微调。XTuner 支持在 8GB 显存下微调 7B 模型,同时也支持多节点跨设备微调更大尺度模型(70B+)。
自动分发高性能算子(如 FlashAttention、Triton kernels 等)以加速训练吞吐。
兼容 DeepSpeed 🚀,轻松应用各种 ZeRO 训练优化策略。
灵活
支持多种大语言模型,包括但不限于 InternLM、Mixtral-8x7B、Llama2、ChatGLM、Qwen、Baichuan。
支持多模态图文模型 LLaVA 的预训练与微调。利用 XTuner 训得模型 LLaVA-InternLM2-20B 表现优异。
精心设计的数据管道,兼容任意数据格式,开源数据或自定义数据皆可快速上手。
支持 QLoRA、LoRA、全量参数微调等多种微调算法,支撑用户根据具体需求作出最优选择。
全能
支持增量预训练、指令微调与 Agent 微调。
预定义众多开源对话模版,支持与开源或训练所得模型进行对话。
训练所得模型可无缝接入部署工具库 LMDeploy、大规模评测工具库 OpenCompass 及 VLMEvalKit。
环境准备
在 autodl 平台中租赁一个 3090 等 24G 显存的显卡机器,如下图所示镜像选择 PyTorch-->2.0.0-->3.8(ubuntu20.04)-->11.8 。
接下来打开刚刚租用服务器的 JupyterLab,并且打开其中的终端开始环境配置、模型下载和运行演示。
创建工作目录
创建本次微调实践的工作目录/root/autodl-tmp/ft-learn
# 创建微调工作目录
mkdir -p /root/autodl-tmp/ft-learn

# 创建微调数据集存放目录
mkdir -p /root/autodl-tmp/ft-learn/dataset

# 创建微调配置文件存放目录
mkdir -p /root/autodl-tmp/ft-learn/config安装依赖
# 升级pip
python -m pip install --upgrade pip
# 安装python依赖
pip install modelscope==1.9.5
pip install transformers==4.36.2
pip install streamlit==1.24.0
pip install sentencepiece==0.1.99
pip install accelerate==0.24.1
pip install transformers_stream_generator==0.0.4
pip install einops ujson
pip install protobuf使用modelscope下载模型
使用 modelscope 中的 snapshot_download 函数下载模型,第一个参数为模型名称,参数 cache_dir 为模型的下载路径。
在Internlm2-7b-chat-web.ipynb文件中新建一个代码块,运行下载internlm2-chat-7b模型。模型下载需要时间,我们直接往下看
from modelscope import snapshot_download

model_dir = snapshot_download('Shanghai_AI_Laboratory/internlm2-chat-7b', cache_dir='/root/autodl-tmp', revision='master')安装Xtuner
git clone -b v0.1.14 https://github.com/InternLM/xtuner
cd xtuner
# 从源码安装 XTuner
pip install -e '.[all]'
# 安装完成之后就可以在命令行使用xtuner了
# 查看xtuner使用帮助
xtuner help
# 查看xtuner版本
xtuner version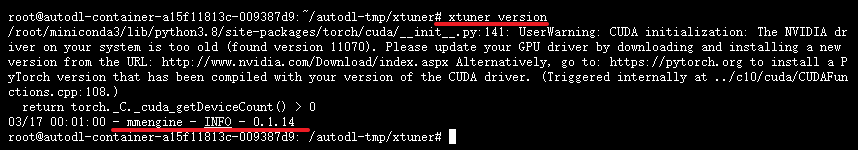
数据集处理
我自己整理的心理大模型-职场焦虑语料.xlsx,通过gen_qa_json.py文件生成一个career_coach.jsonl文件
运行python /root/autodl-tmp/ft-learn/dataset/gen_qa_json.py生成文件,你们也可以按照我的数据语料格式,自定义你们自己的数据集。gen_qa_json.py文件代码如下:
import pandas as pd
import json

# 读取Excel文件
excel_file = './心理大模型-职场焦虑语料.xlsx'  # 替换成实际的Excel文件路径
df = pd.read_excel(excel_file)

# 设置system的值
system_value = "你是一个专业的,经验丰富的有心理学背景的职场教练。你总是根据有职场焦虑的病人的问题提供准确、全面和详细的答案。"

# 将数据整理成jsonL格式
json_data = []
for index, row in df.iterrows():
    conversation = [
        {
            "system": system_value,
            "input": str(row['q']),
            "output": str(row['a'])
        }
    ]
    json_data.append({"conversation": conversation})

# 将json数据写入文件
output_json_file = 'career_coach.jsonl'  # 替换成实际的输出文件路径
with open(output_json_file, 'w', encoding='utf-8') as f:
    json.dump(json_data, f, ensure_ascii=False)

print("JSONL文件生成成功!")配置文件准备
Xtuner已经内置了许多的配置文件。可以通过Xtuner查看可配置文件
xtuner list-cfg由于我们本次的基座微调模型为internLM2-chat-7b,所以我们可以查看Xtuner现在在InternLM2下已经支持了哪些配置文件
xtuner list-cfg |grep internlm2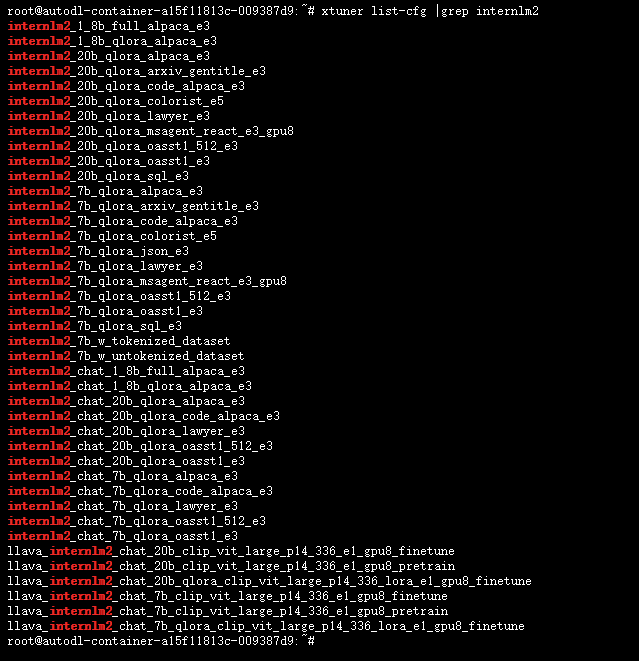
# 复制配置文件
xtuner copy-cfg internlm2_chat_7b_qlora_oasst1_e3 /root/autodl-tmp/ft-learn/config
# 修改配置文件名
mv /root/autodl-tmp/ft-learn/config/internlm2_chat_7b_qlora_oasst1_e3_copy.py /root/autodl-tmp/ft-learn/config/internlm2_chat_7b_qlora_oasst1_e3_career_coach.py复制完成之后要修改配置文件的几处参数
# PART 1 中
# 预训练模型存放的位置
pretrained_model_name_or_path = '/root/autodl-tmp/Shanghai_AI_Laboratory/internlm2-chat-7b'

# 微调数据存放的位置
data_path = '/root/autodl-tmp/ft-learn/dataset/career_coach.jsonl'

# 训练中最大的文本长度
max_length = 512

# 每一批训练样本的大小
batch_size = 2

# 最大训练轮数
max_epochs = 3

# 验证的频率
evaluation_freq = 500

# 用于评估输出内容的问题(用于评估的问题尽量与数据集的question保持一致)
evaluation_inputs = [
'我感到在职场中压力很大,总是焦虑不安,怎么办?',
'我在工作中总是害怕失败,怎样克服这种恐惧?',
'我感觉同事对我的期望很高,让我感到压力很大,怎么处理?'
]


# PART 3 中
# 如果这里的如果没有修改的话,无法直接读取json文件
dataset=dict(type=load_dataset, path='json', data_files=dict(train=data_path))
# 这里也得改成None,否则会报错KeyError
dataset_map_fn=None模型微调
微调启动
xtuner train /root/autodl-tmp/ft-learn/config/internlm2_chat_7b_qlora_oasst1_e3_career_coach.py --deepspeed deepspeed_zero2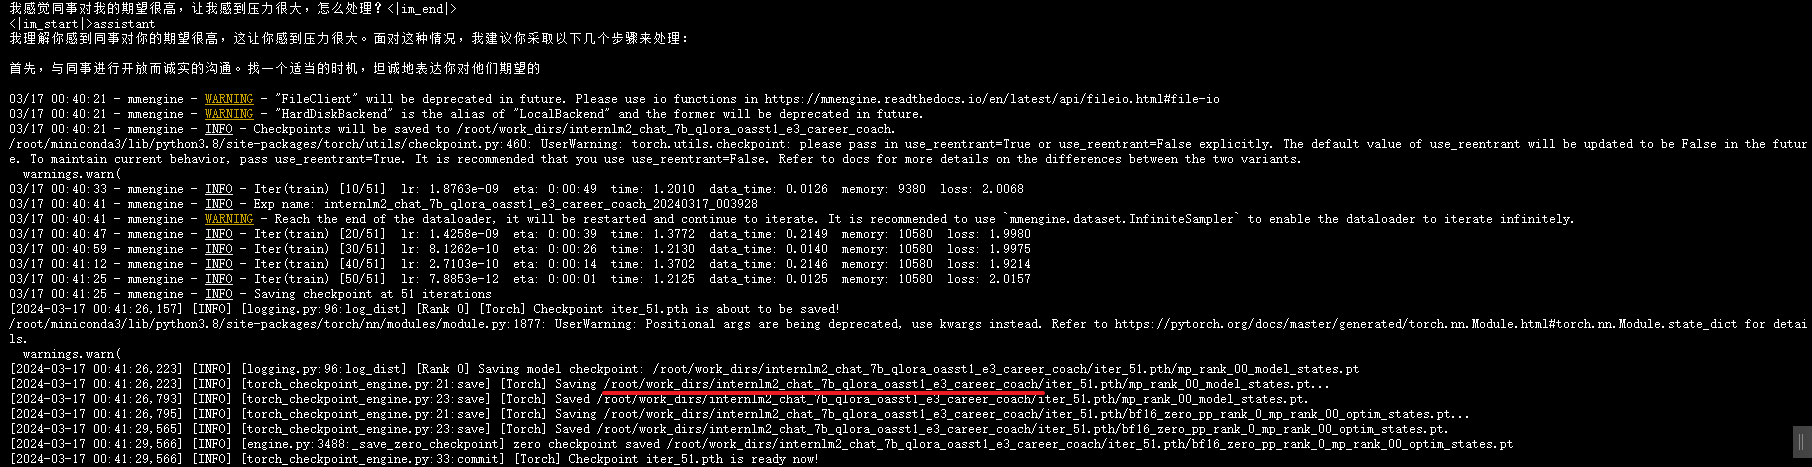
训练完成之后,参数模型存放在/root/work_dirs/internlm2_chat_7b_qlora_oasst1_e3_career_coach/目录下
模型转换成HF
# 新建模型存放的文件夹
mkdir -p /root/work_dirs/internlm2_chat_7b_qlora_oasst1_e3_career_coach/hf
# 添加环境变量
export MKL_SERVICE_FORCE_INTEL=1
# 模型转换
xtuner convert pth_to_hf /root/autodl-tmp/ft-learn/config/internlm2_chat_7b_qlora_oasst1_e3_career_coach.py /root/work_dirs/internlm2_chat_7b_qlora_oasst1_e3_career_coach/iter_51.pth/ /root/work_dirs/internlm2_chat_7b_qlora_oasst1_e3_career_coach/hf合并HF adapter 到LLM
mkdir -p /root/autodl-tmp/ft-learn/merged

export MKL_SERVICE_FORCE_INTEL=1
export MKL_THREADING_LAYER='GNU'

# 原始模型参数存放的位置
export NAME_OR_PATH_TO_LLM=/root/autodl-tmp/Shanghai_AI_Laboratory/internlm2-chat-7b

# Hugging Face格式参数存放的位置
export NAME_OR_PATH_TO_ADAPTER=/root/work_dirs/internlm2_chat_7b_qlora_oasst1_e3_career_coach/hf

# 最终Merge后的参数存放的位置
mkdir -p /root/autodl-tmp/ft-learn/merged/internlm2_cc_hf_merge
export SAVE_PATH=/root/autodl-tmp/ft-learn/merged/internlm2_cc_hf_merge


# 执行参数Merge
xtuner convert merge \
    $NAME_OR_PATH_TO_LLM \
    $NAME_OR_PATH_TO_ADAPTER \
    $SAVE_PATH \
    --max-shard-size 2GB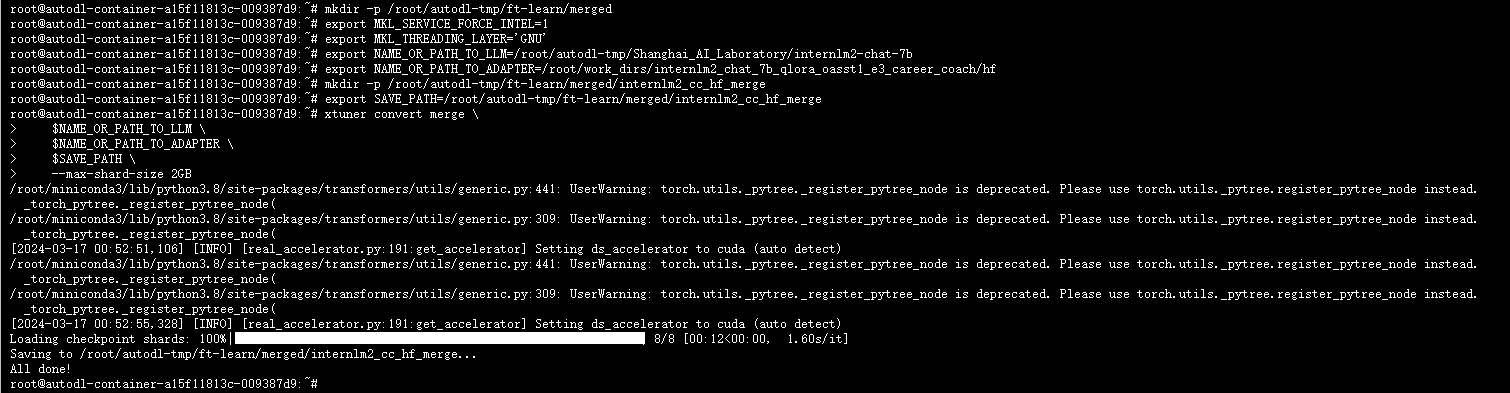
Xtuner多轮对话介绍
XTuner 训练多轮对话模型时,采取了一种更加充分高效的方法,如下图所示。
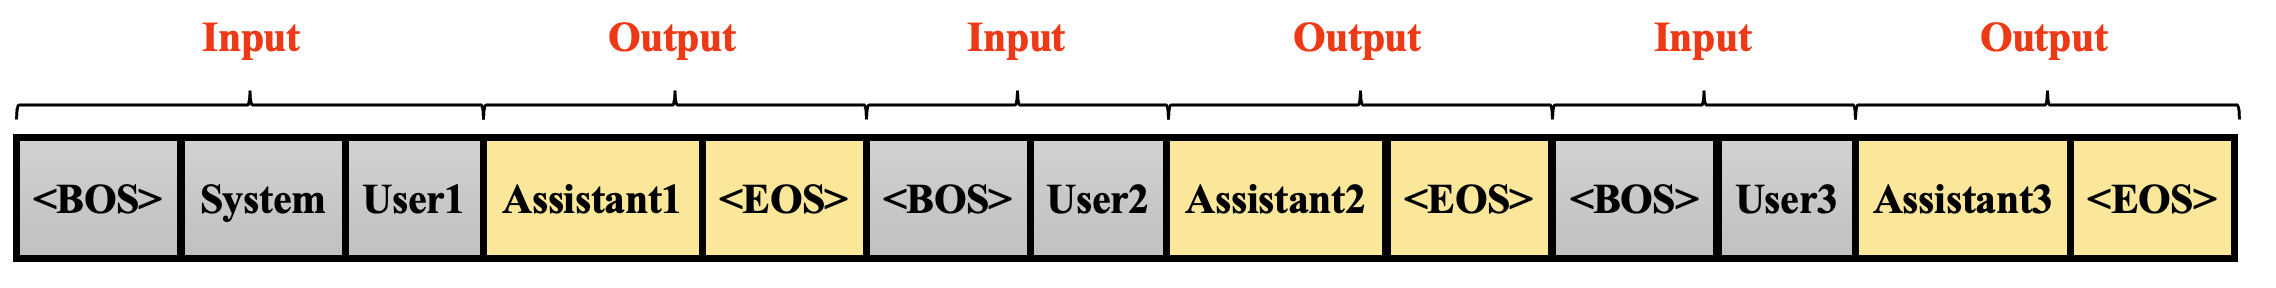
我们将多轮对话进行拼接,之后输入模型,并行计算每个位置的 loss,而只有 Output 部分的 loss 参与回传。
XTuner 中多轮对话数据集格式如下所示:
[{
    "conversation":[
        {
            "system": "You are an AI asssistant."
            "input": "Hello?",
            "output": "Hello! How can I help you?"
        },
        {
            "input": "What's the date today?",
            "output": "Today is Monday, August 14, 2023."
        },
        {
            "input": "Thank you!",
            "output": "You are welcome."
        }
    ]
},
{
    "conversation":[
        {
            "system": "You are an AI asssistant."
            "input": "Hello?",
            "output": "Hello! How can I help you?"
        },
        {
            "input": "How's the weather today in Rosso?",
            "output": "The weather in Rosso on Wednesday, August 16th, is going to be cloudy for most of the day, together with moderate rain around noon."
        },
        {
            "input": "Thank you!",
            "output": "You are welcome."
        }
    ]
}]数据集中的 "conversation" 键对应的值是一个列表,用于保存每一轮对话的指令和实际回答(GroundTruth)。为了保持格式统一,增量预训练数据集和单轮对话数据集中的 "conversation" 键也对应一个列表,只不过该列表的长度为 1。而在多轮对话数据集中,"conversation" 列表的长度为 n,以容纳 n 轮的对话内容。
对多轮对话微调感兴趣的同学,也可以按照上面的数据格式进行数据微调。
写在最后
本节关于Xtuner的微调步骤中提到的职场焦虑数据语料,是我用于开源项目职场教练大模型微调时所使用的语料,感兴趣的同学也可看一看我的这个开源项目career_coach,欢迎点个star。项目的data部分有介绍到多轮对话数据的整理与生成,其实与本教程是一样的。