DeepSeek-R1-Distill-Qwen-7B FastApi 部署调用
环境准备
本文基础环境如下:
----------------
ubuntu 22.04
python 3.12
cuda 12.1
pytorch 2.3.0
----------------本文默认学习者已安装好以上 Pytorch(cuda) 环境,如未安装请自行安装。
首先 pip 换源加速下载并安装依赖包
# 升级pip
python -m pip install --upgrade pip
# 更换 pypi 源加速库的安装
pip config set global.index-url https://pypi.tuna.tsinghua.edu.cn/simple

pip install requests==2.32.3
pip install fastapi==0.115.8
pip install uvicorn==0.34.0
pip install transformers==4.48.2
pip install huggingface-hub==0.28.1
pip install accelerate==1.3.0
pip install modelscope==1.22.3考虑到部分同学配置环境可能会遇到一些问题,我们在 AutoDL 平台准备了 DeepSeek-R1-Distill-Qwen 的环境镜像,点击下方链接并直接创建 Autodl 示例即可。 https://www.codewithgpu.com/i/datawhalechina/self-llm/DeepSeek-R1-Distill-Qwen
模型下载
使用 modelscope 中的 snapshot_download 函数下载模型,第一个参数为模型名称,参数 cache_dir 为模型的下载路径。
新建 model_download.py 文件并在其中输入以下内容,粘贴代码后请及时保存文件,如下图所示。并运行 python model_download.py 执行下载。
from modelscope import snapshot_download

model_dir = snapshot_download('deepseek-ai/DeepSeek-R1-Distill-Qwen-7B', cache_dir='/root/autodl-tmp', revision='master')注意:记得修改
cache_dir为你的模型下载路径哦~
代码准备
新建 api.py 文件并在其中输入以下内容,粘贴代码后请及时保存文件。以下代码有很详细的注释,大家如有不理解的地方,欢迎提出 issue 。
from fastapi import FastAPI, Request
from transformers import AutoTokenizer, AutoModelForCausalLM
import uvicorn
import json
import datetime
import torch
import re

# 设置设备参数
DEVICE = "cuda"  # 使用CUDA
DEVICE_ID = "0"  # CUDA设备ID,如果未设置则为空
CUDA_DEVICE = f"{DEVICE}:{DEVICE_ID}" if DEVICE_ID else DEVICE  # 组合CUDA设备信息

# 清理GPU内存函数
def torch_gc():
    if torch.cuda.is_available():  # 检查是否可用CUDA
        with torch.cuda.device(CUDA_DEVICE):  # 指定CUDA设备
            torch.cuda.empty_cache()  # 清空CUDA缓存
            torch.cuda.ipc_collect()  # 收集CUDA内存碎片
# 文本分割函数
def split_text(text):
    pattern = re.compile(r'<think>(.*?)</think>(.*)', re.DOTALL) # 定义正则表达式模式
    match = pattern.search(text) # 匹配 <think>思考过程</think>回答

    if match: # 如果匹配到思考过程
        think_content = match.group(1).strip() # 获取思考过程
        answer_content = match.group(2).strip() # 获取回答
    else:
        think_content = "" # 如果没有匹配到思考过程,则设置为空字符串
        answer_content = text.strip() # 直接返回回答

    return think_content, answer_content

# 创建FastAPI应用
app = FastAPI()

# 处理POST请求的端点
@app.post("/")
async def create_item(request: Request):
    global model, tokenizer  # 声明全局变量以便在函数内部使用模型和分词器
    json_post_raw = await request.json()  # 获取POST请求的JSON数据
    json_post = json.dumps(json_post_raw)  # 将JSON数据转换为字符串
    json_post_list = json.loads(json_post)  # 将字符串转换为Python对象
    prompt = json_post_list.get('prompt')  # 获取请求中的提示

    messages = [
            {"role": "user", "content": prompt}
    ]

    # 调用模型进行对话生成
    input_ids = tokenizer.apply_chat_template(messages,tokenize=False,add_generation_prompt=True)
    model_inputs = tokenizer([input_ids], return_tensors="pt").to(model.device)
    generated_ids = model.generate(model_inputs.input_ids,max_new_tokens=8192) # 思考需要输出更多的Token数,设为8K
    generated_ids = [
        output_ids[len(input_ids):] for input_ids, output_ids in zip(model_inputs.input_ids, generated_ids)
    ]
    response = tokenizer.batch_decode(generated_ids, skip_special_tokens=True)[0]
    think_content, answer_content = split_text(response) # 调用split_text函数,分割思考过程和回答
    now = datetime.datetime.now()  # 获取当前时间
    time = now.strftime("%Y-%m-%d %H:%M:%S")  # 格式化时间为字符串
    # 构建响应JSON
    answer = {
        "response": response,
        "think": think_content,
        "answer": answer_content,
        "status": 200,
        "time": time
    }
    # 构建日志信息
    log = f"[{time}], prompt:\"{prompt}\", response:\"{repr(response)}\", think:\"{think_content}\", answer:\"{answer_content}\""
    print(log)  # 打印日志
    torch_gc()  # 执行GPU内存清理
    return answer  # 返回响应

# 主函数入口
if __name__ == '__main__':
    # 加载预训练的分词器和模型
    model_name_or_path = '/root/autodl-tmp/deepseek-ai/DeepSeek-R1-Distill-Qwen-7B'
    tokenizer = AutoTokenizer.from_pretrained(model_name_or_path, use_fast=False)
    model = AutoModelForCausalLM.from_pretrained(model_name_or_path, device_map=CUDA_DEVICE, torch_dtype=torch.bfloat16)

    # 启动FastAPI应用
    # 用6006端口可以将autodl的端口映射到本地,从而在本地使用api
uvicorn.run(app, host='0.0.0.0', port=6006, workers=1) # 在指定端口和主机上启动应用注意:记得修改
model_name_or_path为你的模型下载路径哦~
Api 部署
在终端输入以下命令启动api服务:
python api.py加载完毕后出现如下信息说明成功。
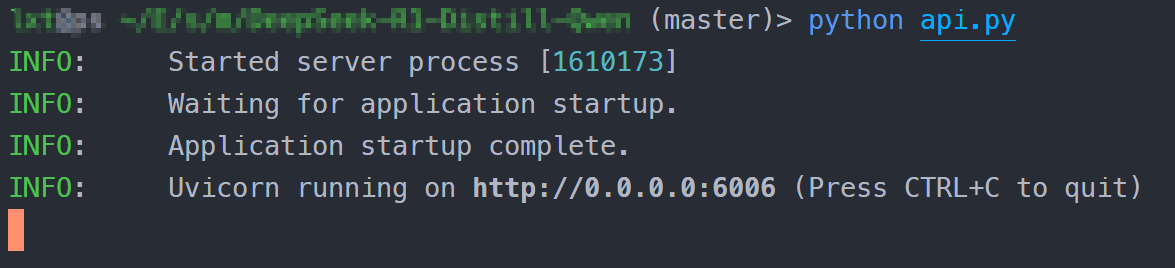
默认部署在 6006 端口,通过 POST 方法进行调用,可以使用 curl 调用,如下所示:
curl -X POST "http://127.0.0.1:6006" \
     -H 'Content-Type: application/json' \
     -d '{"prompt": "请简要说明,把大象放进冰箱分为几步?"}'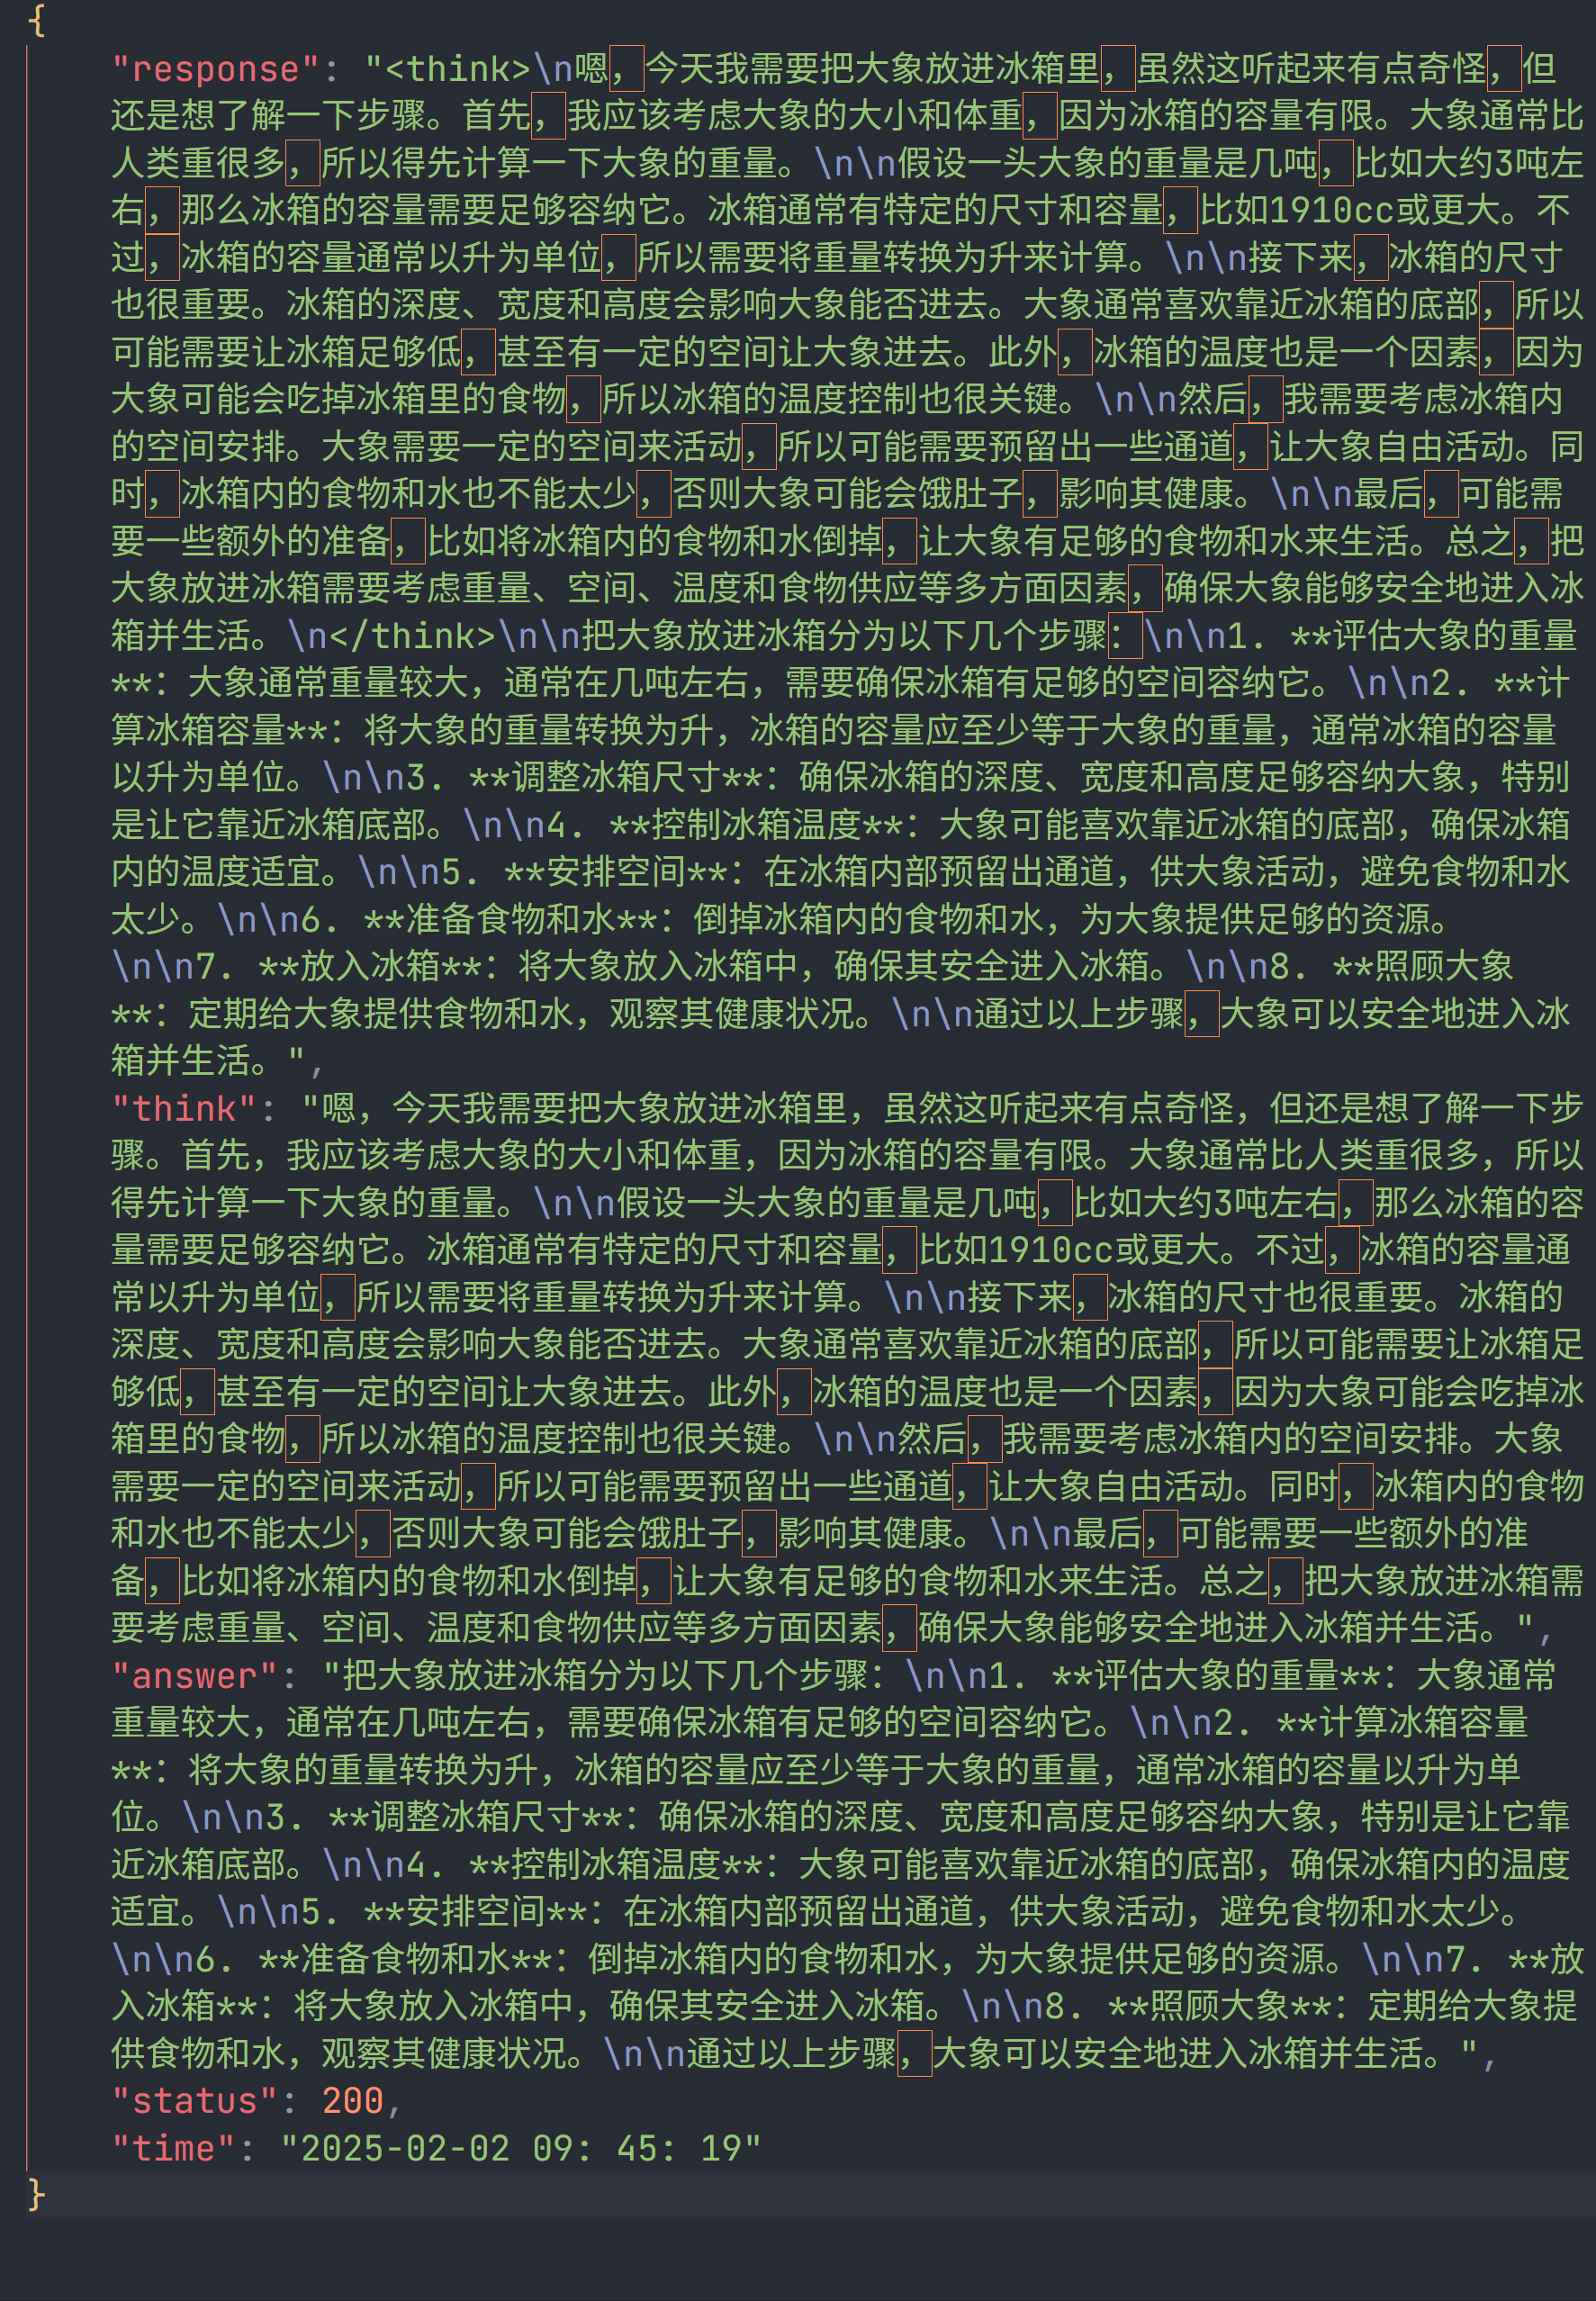
也可以使用 python 中的 requests 库进行调用,如下所示:
import requests
import json

def get_completion(prompt):
    headers = {'Content-Type': 'application/json'}
    data = {"prompt": prompt}
    response = requests.post(url='http://127.0.0.1:6006', headers=headers, data=json.dumps(data))
    return response.json()['response']

if __name__ == '__main__':
print(get_completion('请简要说明,把大象放进冰箱分为几步?'))得到的返回值如下所示:
{'response': '<think>\n好,用户想要了解如何将大象放进冰箱。首先,大象非常重,通常超过几吨,这远远超过了冰箱的容量。冰箱通常只有几立方英尺,所以直接放进冰箱里是不可能的。首先需要考虑大象的体重和形状,然后拆分大象,比如分成几只小象,再分装进冰箱。另外,还需要考虑冰箱的容量是否足够,是否有其他工具可以辅助装箱。最后,确保大象安全,安全措施很重要。这样一步步来,就能解决大象放进冰箱的问题了。\n</think>\n\n将大象放进冰箱需要分步骤进行,具体如下:\n\n1. **评估大象的重量和形状**:大象通常非常重,超过几吨,而冰箱的容量通常只有几立方英尺,因此直接将大象放进冰箱是不可能的。\n\n2. **拆分大象**:将大象拆分为多个较小的部分,比如分成几只小象或分多个箱子里装大象。这种分拆方法可以逐步将大象放进冰箱。\n\n3. **分装大象**:将拆分后的大象部分逐一放入冰箱中,逐步将大象装入冰箱,确保大象安全。\n\n4. **检查冰箱容量**:确保冰箱的容量足够容纳大象,如果有其他工具可以辅助装箱,可以考虑使用。\n\n5. **安全措施**:确保大象在装箱过程中安全,避免意外情况发生。\n\n通过以上步骤,可以逐步将大象放进冰箱。', 'think': '好,用户想要了解如何将大象放进冰箱。首先,大象非常重,通常超过几吨,这远远超过了冰箱的容量。冰箱通常只有几立方英尺,所以直接放进冰箱里是不可能的。首先需要考虑大象的体重和形状,然后拆分大象,比如分成几只小象,再分装进冰箱。另外,还需要考虑冰箱的容量是否足够,是否有其他工具可以辅助装箱。最后,确保大象安全,安全措施很重要。这样一步步来,就能解决大象放进冰箱的问题了。', 'answer': '将大象放进冰箱需要分步骤进行,具体如下:\n\n1. **评估大象的重量和形状**:大象通常非常重,超过几吨,而冰箱的容量通常只有几立方英尺,因此直接将大象放进冰箱是不可能的。\n\n2. **拆分大象**:将大象拆分为多个较小的部分,比如分成几只小象或分多个箱子里装大象。这种分拆方法可以逐步将大象放进冰箱。\n\n3. **分装大象**:将拆分后的大象部分逐一放入冰箱中,逐步将大象装入冰箱,确保大象安全。\n\n4. **检查冰箱容量**:确保冰箱的容量足够容纳大象,如果有其他工具可以辅助装箱,可以考虑使用。\n\n5. **安全措施**:确保大象在装箱过程中安全,避免意外情况发生。\n\n通过以上步骤,可以逐步将大象放进冰箱。', 'status': 200, 'time': '2025-02-02 09:53:01'}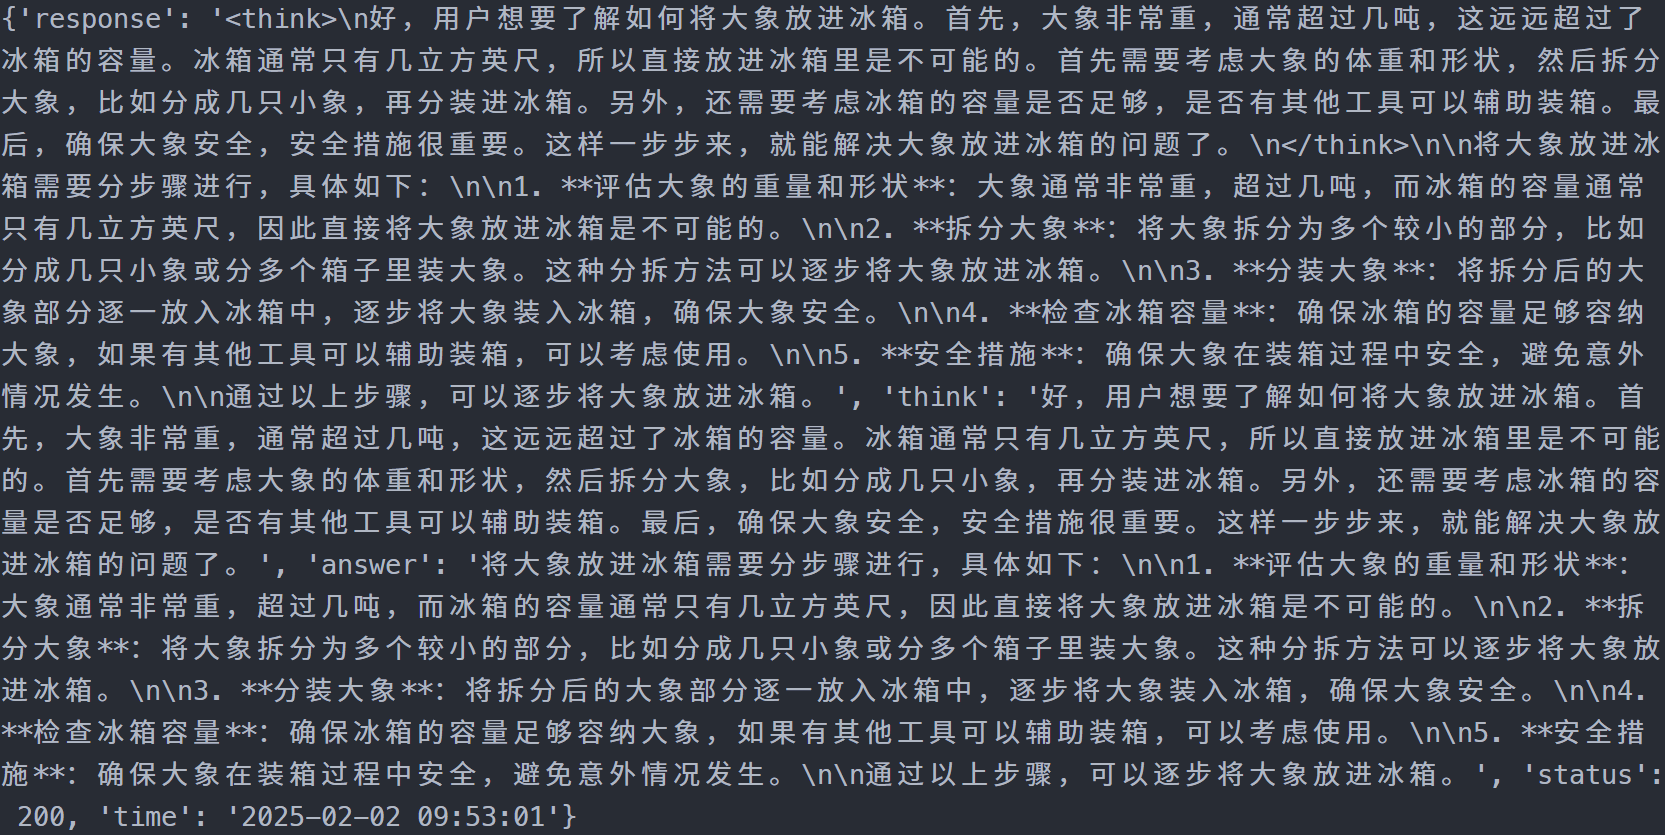
DeepSeek-R1-Distill-Qwen-7B Langchain 接入
环境准备
本文基础环境如下:
----------------
ubuntu 22.04
python 3.12
cuda 12.1
pytorch 2.3.0
----------------本文默认学习者已安装好以上 Pytorch(cuda) 环境,如未安装请自行安装。
pip 换源加速下载并安装依赖包
# 升级pip
python -m pip install --upgrade pip
# 更换 pypi 源加速库的安装
pip config set global.index-url https://pypi.tuna.tsinghua.edu.cn/simple

pip install transformers==4.48.2
pip install huggingface-hub==0.28.1
pip install accelerate==1.3.0
pip install modelscope==1.22.3
pip install langchain==0.3.17考虑到部分同学配置环境可能会遇到一些问题,我们在 AutoDL 平台准备了 DeepSeek-R1-Distill-Qwen 的环境镜像,点击下方链接并直接创建 Autodl 示例即可。 https://www.codewithgpu.com/i/datawhalechina/self-llm/DeepSeek-R1-Distill-Qwen
模型下载
使用 modelscope 中的 snapshot_download 函数下载模型,第一个参数为模型名称,参数 cache_dir 为模型的下载路径。
新建 model_download.py 文件并在其中输入以下内容,粘贴代码后记得保存文件,如下图所示。并运行 python model_download.py 执行下载。
from modelscope import snapshot_download

model_dir = snapshot_download('deepseek-ai/DeepSeek-R1-Distill-Qwen-7B', cache_dir='/root/autodl-tmp', revision='master')注意:记得修改
cache_dir为你的模型下载路径哦~
代码准备
为便捷构建 LLM 应用,我们需要基于本地部署的 DeepSeek_R1_Distill_Qwen_LLM,自定义一个 LLM 类,将 DeepSeek R1 Distill 接入到 LangChain 框架中。完成自定义 LLM 类之后,可以以完全一致的方式调用 LangChain 的接口,而无需考虑底层模型调用的不一致。
基于本地部署的 DeepSeek R1 Distill 自定义 LLM 类并不复杂,我们只需从 LangChain.llms.base.LLM 类继承一个子类,并重写构造函数与 _call 函数即可:
在当前路径新建一个 LLM.py 文件,并输入以下内容,粘贴代码后记得保存文件。
from langchain.llms.base import LLM
from typing import Any, List, Optional
from langchain.callbacks.manager import CallbackManagerForLLMRun
from transformers import AutoTokenizer, AutoModelForCausalLM, GenerationConfig
import torch

class DeepSeek_R1_Distill_Qwen_LLM(LLM):
    # 基于本地 DeepSeek_R1_Distill_Qwen 自定义 LLM 类
    tokenizer: AutoTokenizer = None
    model: AutoModelForCausalLM = None

    def __init__(self, mode_name_or_path :str):

        super().__init__()
        print("正在从本地加载模型...")
        self.tokenizer = AutoTokenizer.from_pretrained(mode_name_or_path, use_fast=False)
        self.model = AutoModelForCausalLM.from_pretrained(mode_name_or_path, torch_dtype=torch.bfloat16, device_map="auto")
        self.model.generation_config = GenerationConfig.from_pretrained(mode_name_or_path)
        print("完成本地模型的加载")

    def _call(self, prompt : str, stop: Optional[List[str]] = None,
                run_manager: Optional[CallbackManagerForLLMRun] = None,
                **kwargs: Any):

        messages = [{"role": "user", "content": prompt }]
        input_ids = self.tokenizer.apply_chat_template(messages, tokenize=False, add_generation_prompt=True)
        model_inputs = self.tokenizer([input_ids], return_tensors="pt").to('cuda')
        generated_ids = self.model.generate(model_inputs.input_ids, attention_mask=model_inputs['attention_mask'], max_new_tokens=8192) # 思考需要输出更多的Token数,设为8K
        generated_ids = [
            output_ids[len(input_ids):] for input_ids, output_ids in zip(model_inputs.input_ids, generated_ids)
        ]
        response = self.tokenizer.batch_decode(generated_ids, skip_special_tokens=True)[0]

        return response
    @property
    def _llm_type(self) -> str:
return "DeepSeek_R1_Distill_Qwen_LLM"在上述类定义中,我们分别重写了构造函数和 _call 函数:对于构造函数,我们在对象实例化的一开始加载本地部署的 DeepSeek R1 Distill 模型,从而避免每一次调用都需要重新加载模型带来的时间过长;_call 函数是 LLM 类的核心函数,LangChain 会调用该函数来调用 LLM,在该函数中,我们调用已实例化模型的 generate 方法,从而实现对模型的调用并返回调用结果。
在整体项目中,我们将上述代码封装为 LLM.py,后续将直接从该文件中引入自定义的 LLM 类。
调用
然后就可以像使用任何其他的langchain大模型功能一样使用了。
注意:记得修改模型路径为你的路径哦~
from LLM import DeepSeek_R1_Distill_Qwen_LLM
import re

# 文本分割函数
def split_text(text):
    pattern = re.compile(r'<think>(.*?)</think>(.*)', re.DOTALL) # 定义正则表达式模式
    match = pattern.search(text) # 匹配 <think>思考过程</think>回答

    if match: # 如果匹配到思考过程
        think_content = match.group(1).strip() # 获取思考过程
        answer_content = match.group(2).strip() # 获取回答
    else:
        think_content = "" # 如果没有匹配到思考过程,则设置为空字符串
        answer_content = text.strip() # 直接返回回答

    return think_content, answer_content

llm = DeepSeek_R1_Distill_Qwen_LLM(mode_name_or_path = "/root/autodl-tmp/deepseek-ai/DeepSeek-R1-Distill-Qwen-7B")

response = llm("我如何为我学习Python制定目标?")
think, answer = split_text(response) # 调用split_text函数,分割思考过程和回答
print(f"{"-"*20}思考{"-"*20}")
print(think) # 输出思考
print(f"{"-"*20}回答{"-"*20}")
print(answer) # 输出回答
DeepSeek-R1-Distill-Qwen-7B WebDemo 部署
环境准备
----------------
ubuntu 22.04
python 3.12
cuda 12.1
pytorch 2.3.0
----------------本文默认学习者已安装好以上 Pytorch(cuda) 环境,如未安装请自行安装。
pip 换源加速下载并安装依赖包
# 升级 pip
python -m pip install --upgrade pip
# 更换 pypi 源加速库的安装
pip config set global.index-url https://pypi.tuna.tsinghua.edu.cn/simple

pip install transformers==4.48.2
pip install accelerate==1.3.0
pip install modelscope==1.22.3
pip install streamlit==1.41.1考虑到部分同学配置环境可能会遇到一些问题,我们在 AutoDL 平台准备了 DeepSeek-R1-Distill-Qwen 的环境镜像,点击下方链接并直接创建 Autodl 示例即可。 https://www.codewithgpu.com/i/datawhalechina/self-llm/DeepSeek-R1-Distill-Qwen
模型下载
使用 modelscope 中的 snapshot_download 函数下载模型,第一个参数为模型名称,参数 cache_dir 为模型的下载路径。
新建 model_download.py 文件并在其中输入以下内容,粘贴代码后记得保存文件。并运行 python model_download.py 执行下载。
from modelscope import snapshot_download

model_dir = snapshot_download('deepseek-ai/DeepSeek-R1-Distill-Qwen-7B', cache_dir='/root/autodl-tmp', revision='master')注意:记得修改
cache_dir为你的模型下载路径哦~
代码准备
新建 chatBot.py 文件并在其中输入以下内容,粘贴代码后记得保存文件。下面的代码有很详细的注释,大家如有不理解的地方,欢迎提出 issue。
from transformers import AutoTokenizer, AutoModelForCausalLM
import torch
import streamlit as st
import re

# 在侧边栏中创建一个标题和一个链接
with st.sidebar:
    st.markdown("## DeepSeek-R1-Distill-Qwen-7B LLM")
    "[开源大模型食用指南 self-llm](https://github.com/datawhalechina/self-llm.git)"
    # 创建一个滑块,用于选择最大长度,范围在 0 到 8192 之间,默认值为 8192(DeepSeek-R1-Distill-Qwen-7B 支持 128K 上下文,并能生成最多 8K tokens,我们推荐设为 8192,因为思考需要输出更多的Token数)
    max_length = st.slider("max_length", 0, 8192, 8192, step=1)

# 创建一个标题和一个副标题
st.title("💬 DeepSeek R1 Distill Chatbot")
st.caption("🚀 A streamlit chatbot powered by Self-LLM")

# 定义模型路径
mode_name_or_path = '/root/autodl-tmp/deepseek-ai/DeepSeek-R1-Distill-Qwen-7B'

# 文本分割函数
def split_text(text):
    pattern = re.compile(r'<think>(.*?)</think>(.*)', re.DOTALL) # 定义正则表达式模式
    match = pattern.search(text) # 匹配 <think>思考过程</think>回答

    if match: # 如果匹配到思考过程
        think_content = match.group(1).strip() # 获取思考过程
        answer_content = match.group(2).strip() # 获取回答
    else:
        think_content = "" # 如果没有匹配到思考过程,则设置为空字符串
        answer_content = text.strip() # 直接返回回答

    return think_content, answer_content

# 定义一个函数,用于获取模型和 tokenizer
@st.cache_resource
def get_model():
    # 从预训练的模型中获取 tokenizer
    tokenizer = AutoTokenizer.from_pretrained(mode_name_or_path, trust_remote_code=True)
    tokenizer.pad_token = tokenizer.eos_token
    # 从预训练的模型中获取模型,并设置模型参数
    model = AutoModelForCausalLM.from_pretrained(mode_name_or_path, torch_dtype=torch.bfloat16,  device_map="auto")

    return tokenizer, model

# 加载 Qwen2.5 的 model 和 tokenizer
tokenizer, model = get_model()

# 如果 session_state 中没有 "messages",则创建一个包含默认消息的列表
if "messages" not in st.session_state:
    st.session_state["messages"] = [{"role": "assistant", "content": "有什么可以帮您的?"}]

# 遍历 session_state 中的所有消息,并显示在聊天界面上
for msg in st.session_state.messages:
    st.chat_message(msg["role"]).write(msg["content"])

# 如果用户在聊天输入框中输入了内容,则执行以下操作
if prompt := st.chat_input():

    # 在聊天界面上显示用户的输入
    st.chat_message("user").write(prompt)

    # 将用户输入添加到 session_state 中的 messages 列表中
    st.session_state.messages.append({"role": "user", "content": prompt})

    # 将对话输入模型,获得返回
    input_ids = tokenizer.apply_chat_template(st.session_state.messages,tokenize=False,add_generation_prompt=True)
    model_inputs = tokenizer([input_ids], return_tensors="pt").to('cuda')
    generated_ids = model.generate(model_inputs.input_ids,max_new_tokens=max_length)
    generated_ids = [
        output_ids[len(input_ids):] for input_ids, output_ids in zip(model_inputs.input_ids, generated_ids)
    ]
    response = tokenizer.batch_decode(generated_ids, skip_special_tokens=True)[0]
    think_content, answer_content = split_text(response) # 调用split_text函数,分割思考过程和回答
    # 将模型的输出添加到 session_state 中的 messages 列表中
    st.session_state.messages.append({"role": "assistant", "content": response})
    # 在聊天界面上显示模型的输出
    with st.expander("模型思考过程"):
        st.write(think_content) # 展示模型思考过程
    st.chat_message("assistant").write(answer_content) # 输出模型回答
# print(st.session_state) # 打印 session_state 调试 运行 demo
在终端中运行以下命令,启动 streamlit 服务,server.port 可以更换端口
streamlit run chatBot.py --server.address 127.0.0.1 --server.port 6006在本地浏览器中打开链接 http://localhost:6006/ ,即可查看部署的 WebDemo 聊天界面。运行效果如下:

04-DeepSeek-R1-Distill-Qwen-7B vLLM 部署调用
vLLM 简介
vLLM 框架是一个高效的大语言模型推理和部署服务系统,具备以下特性:
高效的内存管理:通过 PagedAttention 算法,vLLM 实现了对 KV 缓存的高效管理,减少了内存浪费,优化了模型的运行效率。
高吞吐量:vLLM 支持异步处理和连续批处理请求,显著提高了模型推理的吞吐量,加速了文本生成和处理速度。
易用性:vLLM 与 HuggingFace 模型无缝集成,支持多种流行的大型语言模型,简化了模型部署和推理的过程。兼容 OpenAI 的 API 服务器。
分布式推理:框架支持在多 GPU 环境中进行分布式推理,通过模型并行策略和高效的数据通信,提升了处理大型模型的能力。
开源共享:vLLM 由于其开源的属性,拥有活跃的社区支持,这也便于开发者贡献和改进,共同推动技术发展。
环境准备
本文基础环境如下:
----------------
ubuntu 22.04
python 3.12
cuda 12.1
pytorch 2.3.0
----------------本文默认学习者已配置好以上
Pytorch (cuda)环境,如未配置请先自行安装。
首先 pip 换源加速下载并安装依赖包
python -m pip install --upgrade pip
pip config set global.index-url https://pypi.tuna.tsinghua.edu.cn/simple

pip install modelscope==1.22.3
pip install openai==1.61.0
pip install tqdm==4.67.1
pip install transformers==4.48.2
pip install vllm==0.7.1考虑到部分同学配置环境可能会遇到一些问题,我们在 AutoDL 平台准备了 DeepSeek-R1-Distill 的环境镜像,点击下方链接并直接创建 Autodl 示例即可。 https://www.codewithgpu.com/i/datawhalechina/self-llm/DeepSeek-R1-Distill-self-llm
模型下载
使用 modelscope 中的 snapshot_download 函数下载模型,第一个参数为模型名称,参数 cache_dir 为模型的下载路径。
新建 model_download.py 文件并在其中输入以下内容,粘贴代码后记得保存文件。
from modelscope import snapshot_download

model_dir = snapshot_download('deepseek-ai/DeepSeek-R1-Distill-Qwen-7B', cache_dir='/root/autodl-tmp', revision='master')然后在终端中输入 python model_download.py 执行下载,这里需要耐心等待一段时间直到模型下载完成。
注意:记得修改
cache_dir为你的模型下载路径哦~
代码准备
Python脚本
新建 vllm_model.py 文件并在其中输入以下内容,粘贴代码后请及时保存文件。下面的代码有很详细的注释,如有不理解的地方,欢迎大家提 issue。
首先从 vLLM 库中导入 LLM 和 SamplingParams 类。LLM 类是使用 vLLM 引擎运行离线推理的主要类。SamplingParams 类指定采样过程的参数,用于控制和调整生成文本的随机性和多样性。
vLLM 提供了非常方便的封装,我们直接传入模型名称或模型路径即可,不必手动初始化模型和分词器。
我们可以通过这个代码示例熟悉下 vLLM 引擎的使用方式。被注释的部分内容可以丰富模型的能力,但不是必要的,大家可以按需选择,自己多多动手尝试 ~
# vllm_model.py
from vllm import LLM, SamplingParams
from transformers import AutoTokenizer
import os
import json

# 自动下载模型时,指定使用modelscope; 否则,会从HuggingFace下载
os.environ['VLLM_USE_MODELSCOPE']='True'

def get_completion(prompts, model, tokenizer=None, max_tokens=8192, temperature=0.6, top_p=0.95, max_model_len=2048):
    stop_token_ids = [151329, 151336, 151338]
    # 创建采样参数。temperature 控制生成文本的多样性,top_p 控制核心采样的概率
    sampling_params = SamplingParams(temperature=temperature, top_p=top_p, max_tokens=max_tokens, stop_token_ids=stop_token_ids)
    # 初始化 vLLM 推理引擎
    llm = LLM(model=model, tokenizer=tokenizer, max_model_len=max_model_len,trust_remote_code=True)
    outputs = llm.generate(prompts, sampling_params)
    return outputs


if __name__ == "__main__":
    # 初始化 vLLM 推理引擎
    model='/root/autodl-temp/deepseek-ai/DeepSeek-R1-Distill-Qwen-7B' # 指定模型路径
    # model="deepseek-ai/DeepSeek-R1-Distill-Qwen-7B" # 指定模型名称,自动下载模型
    tokenizer = None
    # 加载分词器后传入vLLM 模型,但不是必要的。
    # tokenizer = AutoTokenizer.from_pretrained(model, use_fast=False)

    text = ["请帮我制定个简短的初学者Python学习计划<think>\n", ] # 可用 List 同时传入多个 prompt,根据 DeepSeek 官方的建议,每个 prompt 都需要以 <think>\n 结尾,如果是数学推理内容,建议包含(中英文皆可):Please reason step by step, and put your final answer within \boxed{}.

    # messages = [
    #     {"role": "user", "content": prompt+"<think>\n"}
    # ]
    # 作为聊天模板的消息,不是必要的。
    # text = tokenizer.apply_chat_template(
    #     messages,
    #     tokenize=False,
    #     add_generation_prompt=True
    # )

    outputs = get_completion(text, model, tokenizer=tokenizer, max_tokens=8192, temperature=0.6, top_p=0.95, max_model_len=2048) # 思考需要输出更多的 Token 数,max_tokens 设为 8K,根据 DeepSeek 官方的建议,temperature应在 0.5-0.7,推荐 0.6

    # 输出是一个包含 prompt、生成文本和其他信息的 RequestOutput 对象列表。
    # 打印输出。
    for output in outputs:
        prompt = output.prompt
        generated_text = output.outputs[0].text
        if r"</think>" in generated_text:
            think_content, answer_content = generated_text.split(r"</think>")
        else:
            think_content = ""
            answer_content = generated_text
print(f"Prompt: {prompt!r}, Think: {think_content!r}, Answer: {answer_content!r}")运行代码
python vllm_model.py结果如下:
Prompt: '请帮我制定个简短的初学者Python学习计划<think>\n', Think: '好的,我现在要帮用户制定一个简短的初学者Python学习计划。首先,我得考虑用户的使用场景和需求。用户可能是刚接触Python的新手,可能不太熟悉编程的基本概念,所以计划需要既全面又简短。\n\n用户的需求很明确,就是制定一个学习计划,但可能还需要一些指导。所以,我应该提供结构化的建议,分阶段学习,逐步深入,同时加入一些实用的建议,比如练习和资源推荐。\n\n接下来,我得分析用户的可能使用场景。用户可能在赶时间,或者希望有一个系统的学习路径。所以,计划需要高效,每个阶段的时间不宜过长,避免用户感到压力。\n\n然后,我需要考虑用户可能的背景。用户可能没有太多编程经验,所以计划中的内容要从基础开始,逐步引入高级概念。同时,要提醒用户不要急于求成,保持耐心和持续学习。\n\n用户可能的深层需求是希望在有限的时间内快速提升,或者希望通过系统的学习来逐步掌握编程。因此,计划需要涵盖基本概念、编程结构、函数、模块和框架,以及高级内容,确保用户能够全面掌握。\n\n现在,我得把这些思考整合成一个结构化的计划。首先,明确学习目标,然后分阶段安排,包括基础、编程结构、函数、模块和框架,最后是高级内容。每个阶段的建议要具体,比如使用在线资源、练习、阅读书籍等。\n\n另外,我需要提醒用户注意不要急于求成,保持学习的热情和耐心。这样,用户在学习过程中不会感到压力,反而会感到成就感和满足感。\n\n最后,我得确保整个计划简洁明了,每个阶段的时间安排合理,不会让用户感到累重。同时,加入一些实用的建议,如使用在线资源、练习、阅读书籍等,帮助用户更有效地学习。\n\n总结一下,我的计划应该包括以下几个阶段:基础入门、编程结构、函数与模块、框架与高级内容,每个阶段都有具体的学习建议,同时提醒用户保持学习的热情和耐心。\n', Answer: '\n\n以下是一个简短的初学者Python学习计划,分为几个阶段,建议合理安排时间:\n\n---\n\n### **阶段一:Python入门(10天)**\n**目标:** 掌握基本的Python语法和基本编程概念。\n- **学习内容:**\n - 基本语法:变量、类型、运算符、条件语句、循环(for, while)\n - 函数:定义、调用、返回值\n - 列表、元组、集合:基本操作\n - 字典:基本操作\n - 代码结构:if语句、try-except块\n- **建议:**\n - 使用在线资源(Codecademy, LeetCode等)练习\n - 每天学习1-2小时,完成两到三个练习题\n - 完成每章课程后进行测试\n\n---\n\n### **阶段二:Python编程(15天)**\n**目标:** 掌握基本编程技巧,学习一些常见的编程问题。\n- **学习内容:**\n - 逻辑思维:解决简单的问题\n - 代码结构:函数的嵌套、多线程\n - 数据结构:数组、字典、集合的高级使用\n - 交互界面:使用input()和print()函数\n - 代码优化:使用注释、调试工具\n- **建议:**\n - 使用在线资源(Codecademy, LeetCode等)解决实际问题\n - 每天学习1-2小时,完成两到三个练习题\n - 完成每章课程后进行测试\n\n---\n\n### **阶段三:Python高级内容(10天)**\n**目标:** 掌握Python的高级功能和常用库。\n- **学习内容:**\n - 梯度下降法、机器学习基础(假设你对机器学习感兴趣)\n - 解决常见问题:文件处理、图像处理、数据分析\n - 日期和时间处理:datetime模块\n - 异常处理:try-except块\n - 应用编程:解决实际项目\n- **建议:**\n - 使用在线资源(Codecademy, LeetCode等)解决实际问题\n - 每天学习1-2小时,完成两到三个练习题\n - 完成每章课程后进行测试\n\n---\n\n### **阶段四:Python社区与实践(10天)**\n**目标:** 学习Python的社区和实践,提升代码质量和团队协作。\n- **学习内容:**\n - 代码社区:GitHub、GitHub Pages、Stack Overflow等\n - 代码风格:使用PEP 8规范\n - 团队协作:使用GitHub和Git\n - 项目实践:完成一个完整的项目\n- **建议:**\n - 使用在线资源(Codecademy, LeetCode等)解决实际问题\n - 每天学习1-2小时,完成两到三个练习题\n - 完成每章课程后进行测试\n\n---\n\n### **结束建议:**\n- **保持耐心:** Python学习需要时间和积累,不要急于求成\n- **持续学习:** 每天花1-2小时学习,保持学习的热情\n- **记录学习进展:** 定期记录学习内容和成果,逐步完善计划\n\n希望这个计划能帮助你快速掌握Python!如果还有其他问题,随时提问!'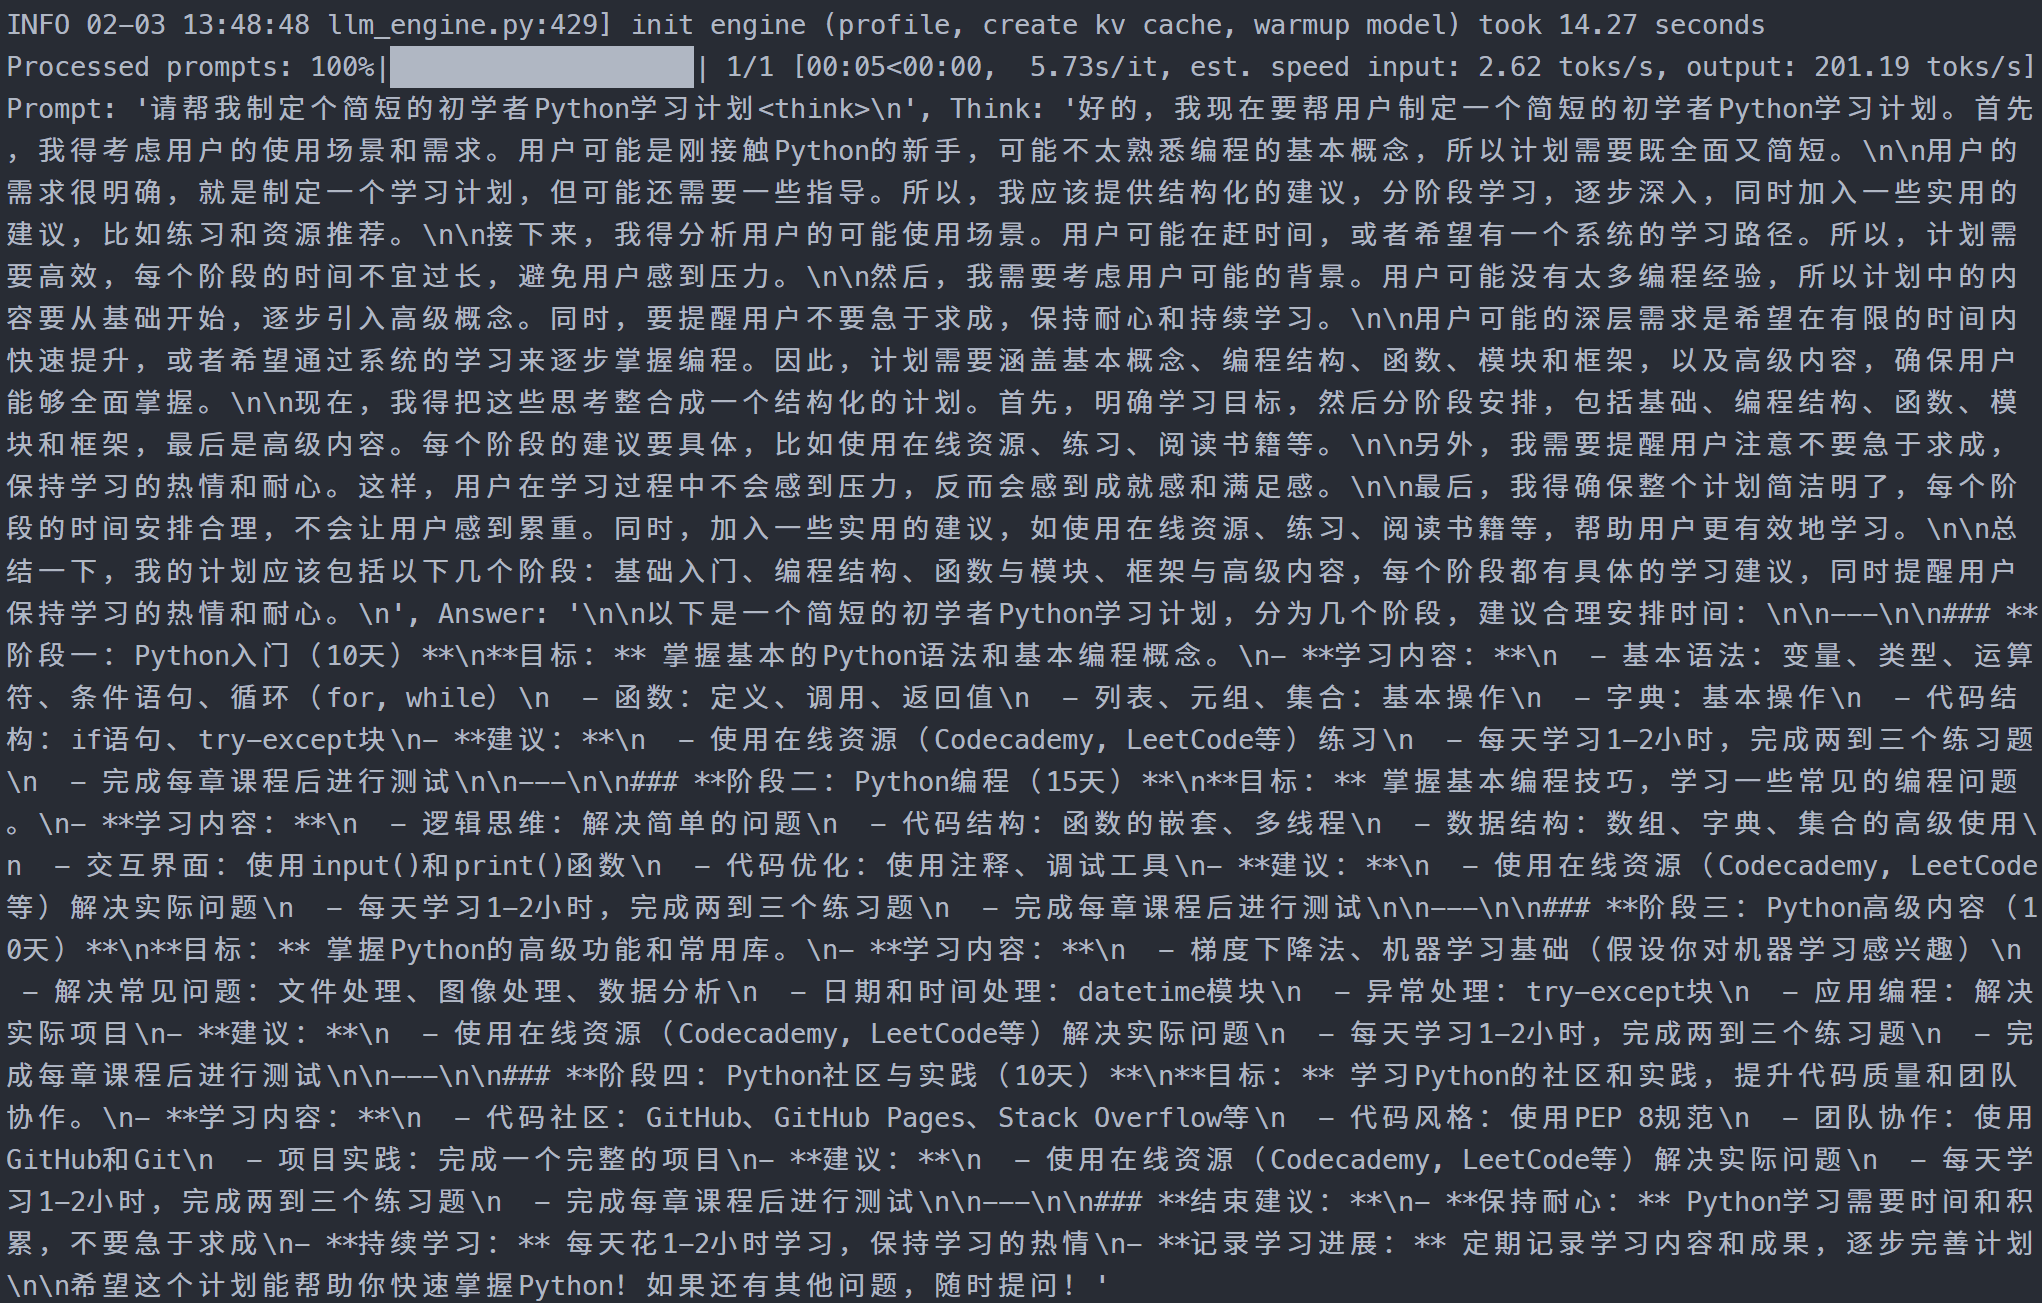
创建兼容 OpenAI API 接口的服务器
DeepSeek-R1-Distill-Qwen 兼容 OpenAI API 协议,所以我们可以直接使用 vLLM 创建 OpenAI API 服务器。vLLM 部署实现 OpenAI API 协议的服务器非常方便。默认会在 http://localhost:8000 启动服务器。服务器当前一次托管一个模型,并实现列表模型、completions 和 chat completions 端口。
completions:是基本的文本生成任务,模型会在给定的提示后生成一段文本。这种类型的任务通常用于生成文章、故事、邮件等。
chat completions:是面向对话的任务,模型需要理解和生成对话。这种类型的任务通常用于构建聊天机器人或者对话系统。
在创建服务器时,我们可以指定模型名称、模型路径、聊天模板等参数。
--host 和 --port 参数指定地址。
--model 参数指定模型名称。
--chat-template 参数指定聊天模板。
--served-model-name 指定服务模型的名称。
--max-model-len 指定模型的最大长度。
python -m vllm.entrypoints.openai.api_server \
  --model /root/autodl-tmp/deepseek-ai/DeepSeek-R1-Distill-Qwen-7B \
  --served-model-name DeepSeek-R1-Distill-Qwen-7B \
--max-model-len=2048加载完毕后出现如下信息说明服务成功启动
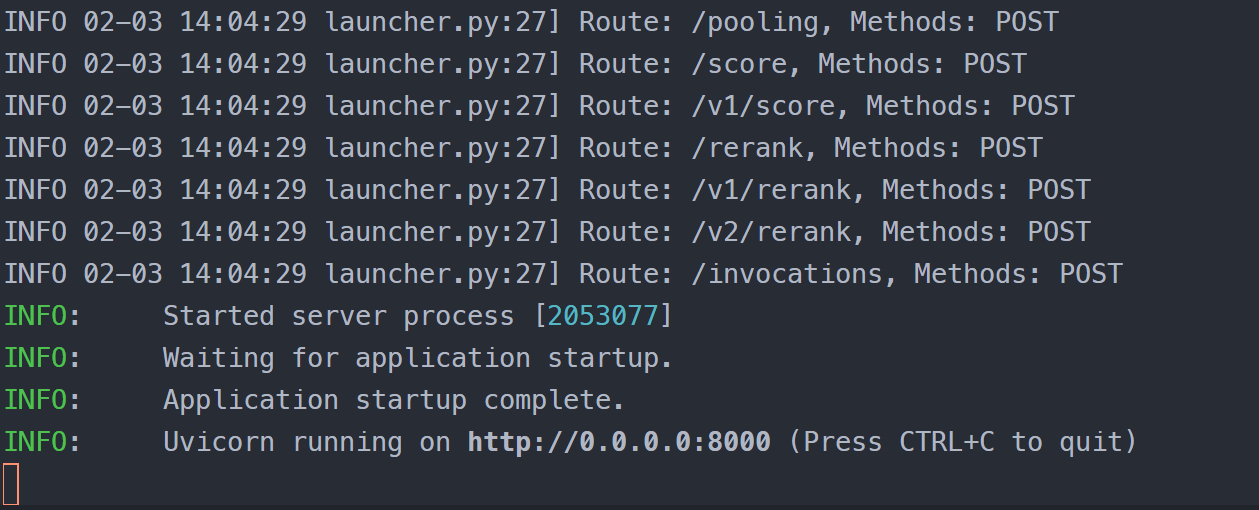
通过 curl 命令查看当前的模型列表
curl http://localhost:8000/v1/models 得到的返回值如下所示
{
    "object": "list",
    "data": [
        {
            "id": "DeepSeek-R1-Distill-Qwen-7B",
            "object": "model",
            "created": 1738591538,
            "owned_by": "vllm",
            "root": "/root/autodl-tmp/deepseek-ai/DeepSeek-R1-Distill-Qwen-7B",
            "parent": null,
            "max_model_len": 2048,
            "permission": [
                {
                    "id": "modelperm-05ee4d8c73c44ca890ab982f3b43de88",
                    "object": "model_permission",
                    "created": 1738591538,
                    "allow_create_engine": false,
                    "allow_sampling": true,
                    "allow_logprobs": true,
                    "allow_search_indices": false,
                    "allow_view": true,
                    "allow_fine_tuning": false,
                    "organization": "*",
                    "group": null,
                    "is_blocking": false
                }
            ]
        }
    ]
}使用 curl 命令测试 OpenAI Completions API
curl http://localhost:8000/v1/completions \
    -H "Content-Type: application/json" \
    -d '{
        "model": "DeepSeek-R1-Distill-Qwen-7B",
        "prompt": "我想问你,5的阶乘是多少?<think>\n",
        "max_tokens": 1024,
        "temperature": 0
}' 得到的返回值如下所示
{
    "id": "cmpl-aaa8af926770477ab42c2ab865cdc5da",
    "object": "text_completion",
    "created": 1738592033,
    "model": "DeepSeek-R1-Distill-Qwen-7B",
    "choices": [
        {
            "index": 0,
            "text": "首先,5的阶乘是指从1乘到5的乘积。\n\n计算步骤如下:\n\n1. 5 × 4 = 20\n2. 20 × 3 = 60\n3. 60 × 2 = 120\n4. 120 × 1 = 120\n\n因此,5的阶乘等于120。\n</think>\n\n**解答:**\n\n5的阶乘(写作 \\(5!\\)) 表示从1乘到5的乘积。计算如下:\n\n\\[\n5! = 5 \\times 4 \\times 3 \\times 2 \\times 1 = 120\n\\]\n\n**最终答案:**\n\n\\[\n\\boxed{120}\n\\]",
            "logprobs": null,
            "finish_reason": "stop",
            "stop_reason": null,
            "prompt_logprobs": null
        }
    ],
    "usage": {
        "prompt_tokens": 13,
        "total_tokens": 177,
        "completion_tokens": 164,
        "prompt_tokens_details": null
    }
}用 Python 脚本请求 OpenAI Completions API
# vllm_openai_completions.py
from openai import OpenAI
client = OpenAI(
    base_url="http://localhost:8000/v1",
    api_key="sk-xxx", # 随便填写,只是为了通过接口参数校验
)

completion = client.chat.completions.create(
  model="DeepSeek-R1-Distill-Qwen-7B",
  messages=[
    {"role": "user", "content": "我想问你,5的阶乘是多少?<think>\n"}
  ]
)

print(completion.choices[0].message)python vllm_openai_completions.py 得到的返回值如下所示
ChatCompletionMessage(content='首先,5的阶乘是指从1乘到5的乘积。\n\n计算步骤如下:\n\n1. 5 × 4 = 20\n2. 20 × 3 = 60\n3. 60 × 2 = 120\n4. 120 × 1 = 120\n\n因此,5的阶乘等于120。\n</think>\n\n**解答:**\n\n5的阶乘(写作 \\(5!\\)) 表示从1乘到5的乘积。计算如下:\n\n\\[\n5! = 5 \\times 4 \\times 3 \\times 2 \\times 1 = 120\n\\]\n\n**最终答案:**\n\n\\[\n\\boxed{120}\n\\]', refusal=None, role='assistant', function_call=None, tool_calls=[])用 curl 命令测试 OpenAI Chat Completions API
curl http://localhost:8000/v1/chat/completions \
    -H "Content-Type: application/json" \
    -d '{
        "model": "DeepSeek-R1-Distill-Qwen-7B",
        "messages": [
            {"role": "user", "content": "我想问你,5的阶乘是多少?<think>\n"}
        ]
}'得到的返回值如下所示
{
    "id": "chatcmpl-2942afba07544b5dbaad4e245671770d",
    "object": "chat.completion",
    "created": 1738592210,
    "model": "DeepSeek-R1-Distill-Qwen-7B",
    "choices": [
        {
            "index": 0,
            "message": {
                "role": "assistant",
                "reasoning_content": null,
                "content": "\n\n5的阶乘(factorial)是计算在5的前面接数的连乘积。具体计算如下:\n\n5! = 5 × 4 × 3 × 2 × 1 = 120",
                "tool_calls": []
            },
            "logprobs": null,
            "finish_reason": "stop",
            "stop_reason": null
        }
    ],
    "usage": {
        "prompt_tokens": 15,
        "total_tokens": 64,
        "completion_tokens": 49,
        "prompt_tokens_details": null
    },
    "prompt_logprobs": null
}用 Python 脚本请求 OpenAI Chat Completions API
# vllm_openai_chat_completions.py
from openai import OpenAI
openai_api_key = "sk-xxx" # 随便填写,只是为了通过接口参数校验
openai_api_base = "http://localhost:8000/v1"

client = OpenAI(
    api_key=openai_api_key,
    base_url=openai_api_base,
)

chat_outputs = client.chat.completions.create(
    model="DeepSeek-R1-Distill-Qwen-7B",
    messages=[
        {"role": "user", "content": "什么是深度学习?"},
    ]
)
print(chat_outputs)python vllm_openai_chat_completions.py得到的返回值如下所示
ChatCompletion(id='chatcmpl-34386ff2bc8145d0af8f8245fa792197', choices=[Choice(finish_reason='stop', index=0, logprobs=None, message=ChatCompletionMessage(content='<think>\n深度学习是一种通过多层神经网络来解决复杂问题的技术。它不仅利用传统机器学习的方法,还引入了大量计算机科学和神经科学的知识。深度学习算法利用大量数据来进行学习,能够自动提取复杂的特征或解决非线性问题。在图像识别、语音识别、情感分析等任务中,深度学习算法的表现尤为突出。虽然深度学习算法的准确性来源于大量训练数据,但这也意味着训练数据的质量和规模是一个关键的技术挑战。在相反的情况下,过拟合和过学习可能会影响模型的表现。\n\n深度学习经历了从基层到高层的 Architectual evolution。从基本的单层感知机到复杂的高级模型,如卷积神经网络(CNN)、循环神经网络(RNN)、长短期记忆网络(LSTM)、这些结构如何帮助模型更好地理解和处理数据,是深度学习中非常重要的环节。\n\n最后,在实际应用中,需要考虑各种策略,比如数据和算法的兼容性,模型的可解释性等,以确保深度学习模型在实际应用中的有效性。此外,持续优化和改进模型即使在面临挑战的情况下,也是深度学习领域的重要工作。\n</think>\n\n深度学习是基于神经网络通过多层的递归结构来解决复杂问题的技术。它通过修改神经网络的结构和并结合多种优化算法来学习和抽取多种特征信息,使其能够在任何工业和科学研究中表现优异,尤其是在 attach图像识别、语音识别、情感分析等千年难破的难题上表现出色。\n\n深度学习能够自动学习和发现数据中的特征,不需要人工干预。通过海量的数据进行训练,深度学习模型能够自动提取复杂的特征,并利用这些特征解决难以用传统方法直接解决的问题。\n\n深度学习的核心在于算法的复杂性,这些算法能够识别和理解细节中的潜在关系,同时考虑到数据中的非线性交互作用。这种非线性性让深度学习能够处理复杂接近真实的数据分布,并在面对记忆不清晰或者复杂数据时表现出突出的表现。\n\n例如,在语音识别中,深度学习模型能够识别 nuanced的语音特征,而不仅仅是简单的转过的语音或大老景的nr frhotmail。同样,在图像识别中,深度学习能够捕捉到复杂的纹理和颜色变化,使其识别更精细的细节。\n\n总结而言,深度学习通过构建复杂的神经网络结构,结合先进的训练方法,可以自动提取数据中的有效特征,从而解决非线性问题,同时在低真实通用性能成本下展现出目前最好的水平。', refusal=None, role='assistant', audio=None, function_call=None, tool_calls=[], reasoning_content=None), stop_reason=None)], created=1738592410, model='DeepSeek-R1-Distill-Qwen-7B', object='chat.completion', service_tier=None, system_fingerprint=None, usage=CompletionUsage(completion_tokens=511, prompt_tokens=7, total_tokens=518, completion_tokens_details=None, prompt_tokens_details=None), prompt_logprobs=None)另外,在以上所有的在请求处理过程中, API 后端都会打印相对应的日志和统计信息😊
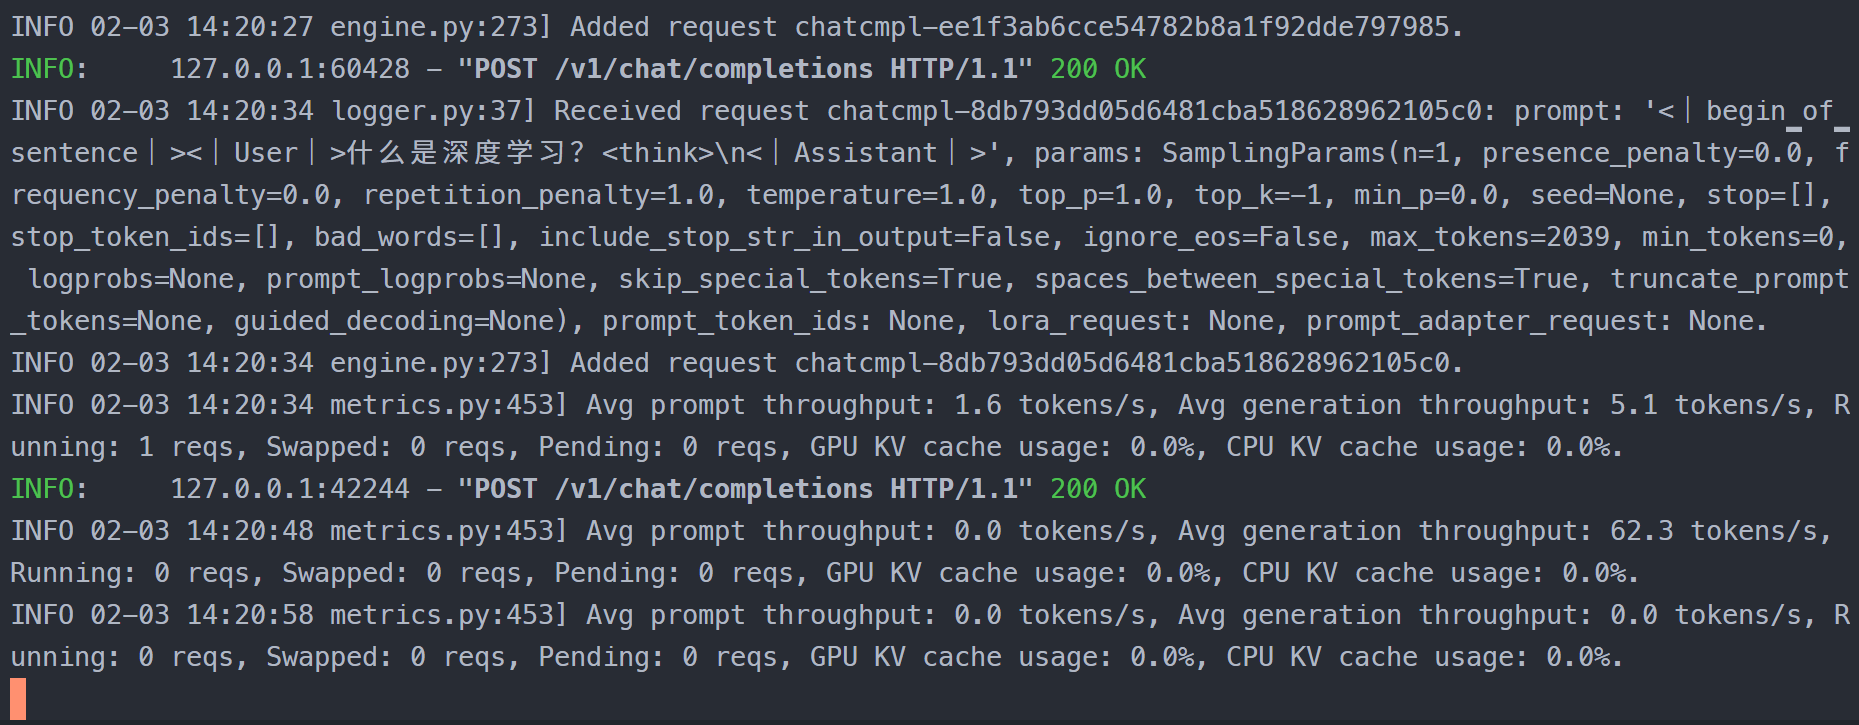
推理速度测试
既然 vLLM 是一个高效的大型语言模型推理和部署服务系统,那么我们不妨就测试一下模型的回复生成速度。看看和原始的速度相比有多大的提升。这里直接使用 vLLM 自带的 benchmark_throughput.py 脚本进行测试。可以将当前文件夹 benchmark_throughput.py 脚本放在 /root/autodl-tmp/ 目录下;或者也可以自行下载最新版脚本
下面是一些 benchmark_throughput.py 脚本的参数说明:
--model 参数指定模型路径或名称。
--backend 推理后端,可以是 vllm、hf 和 mii。分布对应 vLLM、HuggingFace 和 Mii 推理后端。
--input-len 输入长度
--output-len 输出长度
--num-prompts 生成的 prompt 数量
--seed 随机种子
--dtype 数据类型
--max-model-len 模型最大长度
--hf_max_batch_size transformers 库的最大批处理大小(仅仅对于 hf 推理后端有效且为必填字段)
--dataset 数据集路径。(如未设置会自动生成数据)
测试 vLLM 推理速度的命令和参数设置
python benchmark_throughput.py \
	--model /root/autodl-tmp/qwen/DeepSeek-R1-Distill-Qwen-7B \
	--backend vllm \
	--input-len 64 \
	--output-len 128 \
	--num-prompts 25 \
	--seed 2025 \
  --dtype float16 \
--max-model-len 512得到的结果如下所示
Throughput: 29.34 requests/s, 5632.68 total tokens/s, 3755.12 output tokens/sDeepSeek-R1-Distill-Qwen3-8B GRPO微调教程
话不多说,直接开始!
本文使用的测试环境为单张 A100,显存 80GB,可根据需求切换不同参数量的模型,实测4B 24G显存 is enough! 使用的框架为 Unsloth
Unsloth 是一个极其强调资源节省的框架,把所有的资源节省做到了极致,具体来讲Unsloth能够将 Llama-3、Mistral、Phi-4 和 Gemma 等大型语言模型的微调速度提升 2 倍,内存占用减少 70%,并且准确率没有任何下降! 官方文档非常全面,详细指导了如何训练自己的定制模型。其中涵盖了安装和更新 Unsloth、创建数据集、运行和部署模型等基本要素。 Unsloth 让大家在本地或在 Google Colab 和 Kaggle 等平台上训练像 Llama 3 这样的模型变得极其简单。Unsloth简化了整个训练工作流程,包括模型加载、量化、训练、评估、运行、保存、导出,以及与 Ollama、llama.cpp 和 vLLM 等推理引擎的集成。 Unsloth定期与 Hugging Face、Google 和 Meta 的团队合作,以修复 LLM 训练和模型中的错误。因此,当使用 Unsloth 进行训练或使用模型时,可以期待获得最准确的结果。 Unsloth 具有高度可定制性,允许更改聊天模板或数据集格式等内容。Unsloth还为视觉、文本转语音 (TTS)、BERT、强化学习 (RL) 等提供了预构建的脚本!此外,Unsloth支持所有训练方法和所有基于 Transformer 的模型。
教程概览
本教程将指导您完成 DeepSeek-R1-Distill-Qwen3-8B 模型的 GRPO(Group Relative Policy Optimization)微调,这是一种先进的强化学习技术,专门用于提升大语言模型在特定任务上的表现。
什么是GRPO?
GRPO(Group Relative Policy Optimization)是一种强化学习优化技术,通过设计多个奖励函数来评估模型输出的不同方面,从而指导模型学习期望的行为模式。在数学推理任务中,GRPO可以帮助模型:
学会按照特定格式输出答案
提高推理过程的逻辑性
增强答案的准确性
改善输出的结构化程度
本教程的学习内容
环境设置: 安装Unsloth和相关依赖
模型加载: 加载DeepSeek-R1-Distill-Qwen3-8B预训练模型
LoRA配置: 设置高效的参数微调
数据处理: 处理GSM8K数学推理数据集
格式设计: 定义结构化的输出格式
奖励函数: 设计多维度评估体系
GRPO训练: 执行强化学习微调
效果验证: 测试微调后的模型
模型保存: 保存训练结果
可视化监控: 使用SwanLab跟踪训练过程
# 安装依赖包
# pip install unsloth vllm==0.8.5.post1# 安装语言检测库
# pip install langid -qqfrom unsloth import FastLanguageModel
import torch
max_seq_length = 1024
lora_rank = 32
model, tokenizer = FastLanguageModel.from_pretrained(
model_name = "/opt/tiger/test0/DeepSeek-R1-0528-Qwen3-8B",
max_seq_length = max_seq_length,
load_in_4bit = True, # 对于LoRA 16位设置为False
fast_inference = True, # 启用vLLM快速推理
max_lora_rank = lora_rank,
gpu_memory_utilization = 0.7, # 如果内存不足请减少此值
)
model = FastLanguageModel.get_peft_model(
model,
r = lora_rank, # 选择任何大于0的数字!建议8, 16, 32, 64, 128
target_modules = [
"q_proj", "k_proj", "v_proj", "o_proj",
"gate_proj", "up_proj", "down_proj",
],
lora_alpha = lora_rank*2, # *2可以加速训练
use_gradient_checkpointing = "unsloth", # 减少内存使用
random_state = 3407,
)GRPO对话模板
reasoning_start = None
reasoning_end = None
user_token = None
assistant_token = None

for token in tokenizer.get_added_vocab().keys():
    if "think" in token and "/" in token:
        reasoning_end = token
    elif "think" in token:
        reasoning_start = token
    elif "user" in token:
        user_token = token
    elif "assistant" in token:
        assistant_token = token

system_prompt = \
f"""你接到一个问题。
请思考这个问题并提供你的解题过程。
你必须用印尼语思考。"""
system_promptprint(tokenizer.apply_chat_template([
{"role" : "user", "content" : "What is 1+1?"},
{"role" : "assistant", "content" : f"<think>I think it's 2.2</think>2"},
{"role" : "user", "content" : "What is 1+1?"},
{"role" : "assistant", "content" : f"<think>I think it's 2.2</think>2"},
], tokenize = False, add_generation_prompt = True))数据准备
from datasets import load_dataset
dataset = load_dataset("open-r1/DAPO-Math-17k-Processed", "en", split = "train")
dataset让我们看看第一行数据:
dataset[0]["prompt"]dataset[0]["solution"]在GSM8K中,我们注意到所有答案都有####标记,所以我们需要提取它。但对于Open R1数据集,我们可以跳过下面的处理。
def extract_hash_answer(text):
    # if "####" not in text: return None
    # return text.split("####")[1].strip()
    return text
extract_hash_answer(dataset[0]["solution"])让我们映射数据集!并查看第一行:
dataset = dataset.map(lambda x: {
    "prompt" : [
        {"role": "system", "content": system_prompt},
        {"role": "user",   "content": x["prompt"]},
    ],
    "answer": extract_hash_answer(x["solution"]),
})
dataset[0]我们创建一个正则表达式格式来匹配推理部分和答案:
import re

# 添加可选的EOS标记匹配
solution_end_regex = rf"{reasoning_end}(.*)"

match_format = re.compile(solution_end_regex, re.DOTALL)
match_format我们验证它能正常工作:
match_format.findall(
    "Let me think!</think>"\
    f"Hence, the solution is 2.",
)match_format.findall(
"<think>Let me think!</think>"\
f"\n\nHence, the solution is 2",
)我们现在要创建一个奖励函数来完全匹配格式 - 如果成功匹配我们给3分:
def match_format_exactly(completions, **kwargs):
    scores = []
    for completion in completions:
        score = 0
        response = completion[0]["content"]
        # 匹配是否完全符合格式!
        if match_format.search(response) is not None: score += 3.0
        scores.append(score)
return scores如果失败,我们希望在至少部分遵循格式时奖励模型,通过计算每个符号:
def match_format_approximately(completions, **kwargs):
    scores = []
    for completion in completions:
        score = 0
        response = completion[0]["content"]
        # 计算看到多少个关键词 - 如果太多我们会惩罚!
        # 如果我们看到1个,那么加一些分!

        # 不需要奖励<think>因为我们总是预置它!
        score += 0.5 if response.count(reasoning_start) == 1 else -1.0
        score += 0.5 if response.count(reasoning_end)   == 1 else -1.0
        scores.append(score)
return scores我们想要提取生成的答案,并奖励或惩罚它!我们还根据答案与真实答案的比率来奖励:
def check_answer(prompts, completions, answer, **kwargs):
    question = prompts[0][-1]["content"]
    responses = [completion[0]["content"] for completion in completions]

    extracted_responses = [
        guess.group(1)
        if (guess := match_format.search(r)) is not None else None \
        for r in responses
    ]

    scores = []
    for guess, true_answer in zip(extracted_responses, answer):
        score = 0
        if guess is None:
            scores.append(-2.0)
            continue
        # 正确答案得5分!
        if guess == true_answer:
            score += 5.0
        # 如果看到空格但奖励较少
        elif guess.strip() == true_answer.strip():
            score += 3.5
        else:
            # 我们也通过比率奖励接近的答案!
            # 即如果答案在某个范围内,奖励它!
            try:
                ratio = float(guess) / float(true_answer)
                if   ratio >= 0.9 and ratio <= 1.1: score += 2.0
                elif ratio >= 0.8 and ratio <= 1.2: score += 1.5
                else: score -= 2.5 # 惩罚错误答案
            except:
                score -= 4.5 # 惩罚
        scores.append(score)
return scores有时答案可能不是1个数字,而是像句子一样,例如"解决方案是$20" -> 我们提取20。
我们还移除可能的逗号,例如123,456
match_numbers = re.compile(
    r".*?[\s]{0,}([-]?[\d\.\,]{1,})",
    flags = re.MULTILINE | re.DOTALL
)
print(match_numbers.findall("  0.34  "))
print(match_numbers.findall("  123,456  "))
print(match_numbers.findall("  -0.234  "))
print(match_numbers.findall("17"))最后,我们将尝试强制思考过程使用印尼语。这是DeepSeek R1论文中使用的语言一致性奖励的简单版本
import langid

def get_lang(text: str) -> str:
    if not text:
        return "und"
    lang, _ = langid.classify(text)
    return lang


print(get_lang("Hello, How are you")) # 这应该返回en
print(get_lang("Aku berpikir kalau aku adalah kamu")) # 这应该返回id
print(get_lang("我在这里")) # 这应该返回zhimport re
def format_and_language_reward_func(completions, **kwargs):
scores = []
for completion_item in completions:
if not completion_item or not isinstance(completion_item[0], dict) or "content" not in completion_item[0]:
scores.append(-5.0)
print(f"警告:格式错误的完成项,分配默认低分: {completion_item}")
continue
content = completion_item[0]["content"]
lang = get_lang(content)
if lang == 'id':
score = 5.0
elif lang == 'en':
score = -3.0
elif lang == 'zh':
score = -3.0
else:
score = -5.0
scores.append(score)
return scoresprompts = [
[{"role": "assistant", "content": "What is the result of (1 + 2) * 4?"}],
[{"role": "assistant", "content": "What is the result of (3 + 1) * 2?"}],
]
completions = [
[{"role": "assistant", "content": "<think>The sum of 1 and 2 is 3, which we multiply by 4 to get 12.</think><answer>(1 + 2) * 4 = 12</answer>"}],
[{"role": "assistant", "content": "The sum of 3 and 1 is 4, which we multiply by 2 to get 8. So (3 + 1) * 2 = 8."}],
]
format_and_language_reward_func(prompts=prompts, completions=completions)我们现在准备主函数,它将打印生成的响应和真实答案,以及另一个奖励函数,通过float将文本转换为浮点数并查看是否相同。
global PRINTED_TIMES
PRINTED_TIMES = 0
global PRINT_EVERY_STEPS
PRINT_EVERY_STEPS = 5

def check_numbers(prompts, completions, answer, **kwargs):
    question = prompts[0][-1]["content"]
    responses = [completion[0]["content"] for completion in completions]

    extracted_responses = [
        guess.group(1)
        if (guess := match_numbers.search(r)) is not None else None \
        for r in responses
    ]

    scores = []
    # 只在每几步打印一次
    global PRINTED_TIMES
    global PRINT_EVERY_STEPS
    if PRINTED_TIMES % PRINT_EVERY_STEPS == 0:
        print(
            '*'*20 + f"问题:\n{question}", f"\n答案:\n{answer[0]}", f"\n响应:\n{responses[0]}", f"\n提取的:\n{extracted_responses[0]}"
        )
    PRINTED_TIMES += 1

    for guess, true_answer in zip(extracted_responses, answer):
        if guess is None:
            scores.append(-2.5)
            continue
        # 转换为数字
        try:
            true_answer = float(true_answer.strip())
            # 移除逗号,如123,456
            guess       = float(guess.strip().replace(",", ""))
            scores.append(3.5 if guess == true_answer else -1.5)
        except:
            scores.append(0)
            continue
return scores获取前90%的提示长度,这样我们就不会意外截断它们!
即我们将移除前10%的长提示。
tokenized = dataset.map(
    lambda x: {"tokens" : tokenizer.apply_chat_template(x["prompt"], add_generation_prompt = True, tokenize = True)},
    batched = True,
)
print(tokenizer.decode(tokenized[0]["tokens"]))
tokenized = tokenized.map(lambda x: {"L" : len(x["tokens"])})

import numpy as np
maximum_length = int(np.quantile(tokenized["L"], 0.9))
print("最大长度 = ", maximum_length)

# 只过滤小于90%最大长度的样本
dataset = dataset.select(np.where(np.array(tokenized["L"]) <= maximum_length)[0])
del tokenized训练模型
现在设置GRPO训练器和所有配置!
max_prompt_length = maximum_length + 1 # +1以防万一!
max_completion_length = max_seq_length - max_prompt_length

from vllm import SamplingParams
vllm_sampling_params = SamplingParams(
    min_p = 0.1,
    top_p = 1.0,
    top_k = -1,
    seed = 3407,
    stop = [tokenizer.eos_token],
    include_stop_str_in_output = True,
)

from trl import GRPOConfig, GRPOTrainer
training_args = GRPOConfig(
    vllm_sampling_params = vllm_sampling_params,
    temperature = 1.0,
    learning_rate = 5e-6,
    weight_decay = 0.01,
    warmup_ratio = 0.1,
    lr_scheduler_type = "linear",
    optim = "adamw_8bit",
    logging_steps = 1,
    per_device_train_batch_size = 1,
    gradient_accumulation_steps = 1, # 增加到4以获得更平滑的训练
    num_generations = 4, # 如果内存不足请减少
    max_prompt_length = max_prompt_length,
    max_completion_length = max_completion_length,
    # num_train_epochs = 1, # 对于完整训练运行设置为1
    max_steps = 100,
    save_steps = 100,
    report_to = "swanlab", # 可以使用Weights & Biases
    output_dir = "outputs",

    # 用于可选的训练+评估
    # fp16_full_eval = True,
    # per_device_eval_batch_size = 4,
    # eval_accumulation_steps = 1,
    # eval_strategy = "steps",
    # eval_steps = 1,
)让我们运行训练器!如果你向上滚动,你会看到一个奖励表格。目标是看到reward列增加!
你可能需要等待150到200步才能看到任何效果。前100步你可能会得到0奖励。请耐心等待!
| 步骤 | 训练损失 | 奖励 | 奖励标准差 | 完成长度 | kl |
| 1 | 0.000000 | 0.125000 | 0.000000 | 200.000000 | 0.000000 |
| 2 | 0.000000 | 0.072375 | 0.248112 | 200.000000 | 0.000000 |
| 3 | 0.000000 | -0.079000 | 0.163776 | 182.500000 | 0.000005 |
# 用于可选的训练+评估
# new_dataset = dataset.train_test_split(test_size = 0.01)

trainer = GRPOTrainer(
    model = model,
    processing_class = tokenizer,
    reward_funcs = [
        match_format_exactly,
        match_format_approximately,
        check_answer,
        check_numbers,
        format_and_language_reward_func,
    ],
    args = training_args,
    train_dataset = dataset,

    # 用于可选的训练+评估
    # train_dataset = new_dataset["train"],
    # eval_dataset = new_dataset["test"],
)
trainer.train()推理
现在让我们试试刚刚训练的模型!首先,让我们先试试没有经过GRPO训练的模型:
text = "What is the sqrt of 101?"

from vllm import SamplingParams
sampling_params = SamplingParams(
    temperature = 1.0,
    top_k = 50,
    max_tokens = 1024,
)
output = model.fast_generate(
    [text],
    sampling_params = sampling_params,
    lora_request = None,
)[0].outputs[0].text

output现在使用我们刚刚用GRPO训练的LoRA - 我们首先保存LoRA!
model.save_lora("grpo_lora")验证LoRA确实被训练了!
from safetensors import safe_open

tensors = {}
with safe_open("grpo_lora/adapter_model.safetensors", framework = "pt") as f:
    # 验证A和B都非零
    for key in f.keys():
        tensor = f.get_tensor(key)
        n_zeros = (tensor == 0).sum() / tensor.numel()
assert(n_zeros.item() != tensor.numel())现在我们加载LoRA并测试。我们在不使用自定义系统提示的情况下进行测试,这应该不会(或很少)影响模型的原始推理能力:
messages = [
    {"role": "user",   "content": "Solve (x + 2)^2 = 0"},
]

text = tokenizer.apply_chat_template(
    messages,
    add_generation_prompt = True, # 生成时必须添加
    tokenize = False,
)
from vllm import SamplingParams
sampling_params = SamplingParams(
    temperature = 1.0,
    top_k = 50,
    max_tokens = 2048,
)
output = model.fast_generate(
    text,
    sampling_params = sampling_params,
    lora_request = model.load_lora("grpo_lora"),
)[0].outputs[0].text

output接下来,让我们使用系统提示进行测试,这应该使用新语言:
messages = [
    {"role": "system", "content": system_prompt},
    {"role": "user",   "content": "Solve (x + 2)^2 = 0"},
]

text = tokenizer.apply_chat_template(
    messages,
    add_generation_prompt = True, # 生成时必须添加
    tokenize = False,
)
from vllm import SamplingParams
sampling_params = SamplingParams(
    temperature = 1.0,
    top_k = 50,
    max_tokens = 2048,
)
output = model.fast_generate(
    text,
    sampling_params = sampling_params,
    lora_request = model.load_lora("grpo_lora"),
)[0].outputs[0].text

output让我们比较使用系统提示但不使用LoRA的结果
messages = [
    {"role": "system", "content": system_prompt},
    {"role": "user",   "content": "Solve (x + 2)^2 = 0"},
]

text = tokenizer.apply_chat_template(
    messages,
    add_generation_prompt = True, # 生成时必须添加
    tokenize = False,
)
from vllm import SamplingParams
sampling_params = SamplingParams(
    temperature = 1.0,
    top_k = 50,
    max_tokens = 2048,
)
output = model.fast_generate(
    text,
    sampling_params = sampling_params,
    lora_request = None,
)[0].outputs[0].text

output让我们取20个样本,比较使用LoRA和不使用LoRA的情况,看看哪一个有更好的正确语言使用量
sample_dataset = dataset.shuffle(seed = 3407).select(range(20))
sample_datasetwith_lora_id_count = 0
without_lora_id_count = 0
print("在20个样本上比较使用和不使用LoRA的语言使用情况:")
print("=" * 60)
for i, sample in enumerate(sample_dataset):
messages = [
{"role": "system", "content": system_prompt},
{"role": "user", "content": sample["prompt"][1]["content"]},
]
text = tokenizer.apply_chat_template(
messages,
add_generation_prompt=True,
tokenize=False,
)
output_with_lora = model.fast_generate(
text,
sampling_params=sampling_params,
lora_request=model.load_lora("grpo_lora"),
)[0].outputs[0].text
output_without_lora = model.fast_generate(
text,
sampling_params=sampling_params,
lora_request=None,
)[0].outputs[0].text
lang_with_lora = get_lang(output_with_lora)
lang_without_lora = get_lang(output_without_lora)
if lang_with_lora == 'id':
with_lora_id_count += 1
if lang_without_lora == 'id':
without_lora_id_count += 1
# 每5个样本打印进度
if (i + 1) % 5 == 0:
print(f"已处理 {i + 1}/20 个样本...")
print("\n" + "=" * 60)
print("结果:")
print(f"使用LoRA - 印尼语响应: {with_lora_id_count}/20 ({with_lora_id_count/20*100:.1f}%)")
print(f"不使用LoRA - 印尼语响应: {without_lora_id_count}/20 ({without_lora_id_count/20*100:.1f}%)")
print(f"改进: 使用LoRA增加了{with_lora_id_count - without_lora_id_count}个印尼语响应")我们的推理模型要好得多 - 它不总是正确的,因为我们只训练了大约一个小时 - 如果我们延长序列长度并训练更长时间会更好!
保存为float16格式用于VLLM
我们还支持直接保存为float16。选择merged_16bit用于float16或merged_4bit用于int4。我们还允许lora适配器作为备选方案。使用push_to_hub_merged上传到你的Hugging Face账户!你可以去https://huggingface.co/settings/tokens获取你的个人令牌。
# 合并为16位
if False: model.save_pretrained_merged("model", tokenizer, save_method = "merged_16bit",)
if False: model.push_to_hub_merged("hf/model", tokenizer, save_method = "merged_16bit", token = "")

# 合并为4位
if False: model.save_pretrained_merged("model", tokenizer, save_method = "merged_4bit",)
if False: model.push_to_hub_merged("hf/model", tokenizer, save_method = "merged_4bit", token = "")

# 仅LoRA适配器
if False:
    model.save_pretrained("model")
    tokenizer.save_pretrained("model")
if False:
    model.push_to_hub("hf/model", token = "")
tokenizer.push_to_hub("hf/model", token = "")GGUF / llama.cpp 转换
要保存为GGUF / llama.cpp,我们现在原生支持它!我们克隆llama.cpp并默认保存为q8_0。我们允许所有方法,如q4_k_m。使用save_pretrained_gguf进行本地保存,使用push_to_hub_gguf上传到HF。
q8_0 - 快速转换。高资源使用,但通常可接受。
q4_k_m - 推荐。对一半的attention.wv和feed_forward.w2张量使用Q6_K,其他使用Q4_K。
q5_k_m - 推荐。对一半的attention.wv和feed_forward.w2张量使用Q6_K,其他使用Q5_K。
# 保存为8位Q8_0
if False: model.save_pretrained_gguf("model", tokenizer,)
# 记住去https://huggingface.co/settings/tokens获取令牌!
# 并将hf改为你的用户名!
if False: model.push_to_hub_gguf("hf/model", tokenizer, token = "")

# 保存为16位GGUF
if False: model.save_pretrained_gguf("model", tokenizer, quantization_method = "f16")
if False: model.push_to_hub_gguf("hf/model", tokenizer, quantization_method = "f16", token = "")

# 保存为q4_k_m GGUF
if False: model.save_pretrained_gguf("model", tokenizer, quantization_method = "q4_k_m")
if False: model.push_to_hub_gguf("hf/model", tokenizer, quantization_method = "q4_k_m", token = "")

# 保存为多个GGUF选项 - 如果你想要多个选项会快很多!
if False:
    model.push_to_hub_gguf(
        "hf/model", # 将hf改为你的用户名!
        tokenizer,
        quantization_method = ["q4_k_m", "q8_0", "q5_k_m",],
        token = "",
)本试验的试验记录
GRPO阶段
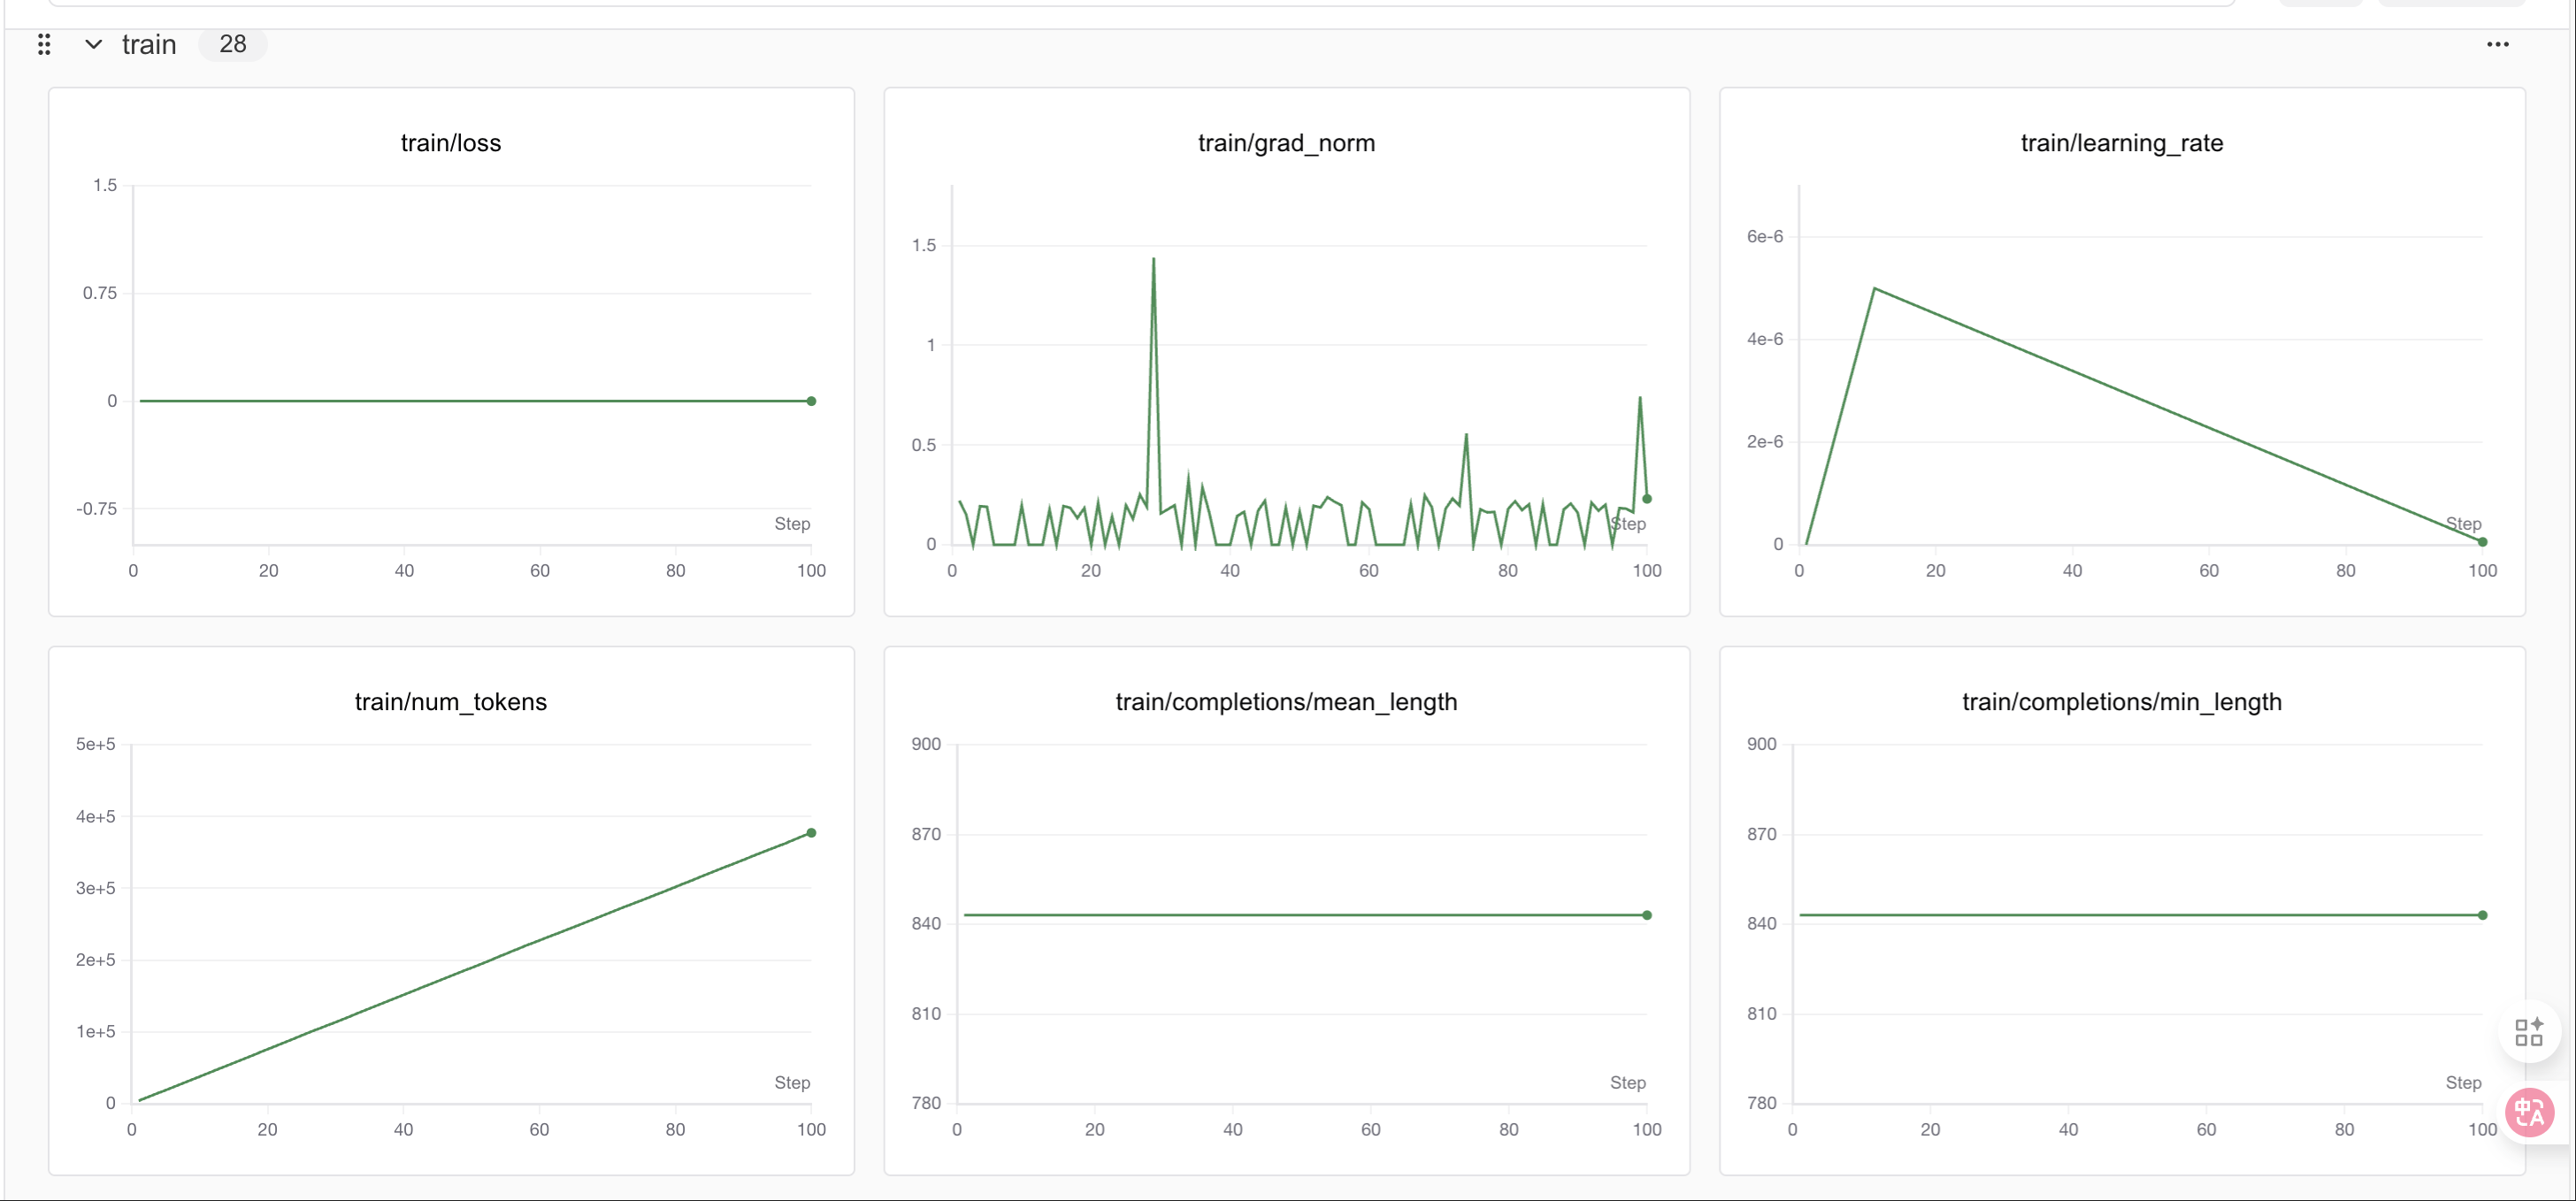
400个step之后loss会有明显变化
教程总结
🎉 恭喜!你已经成功完成了DeepSeek-R1-Distill-Qwen3-8B的GRPO微调教程。
本教程涵盖的核心概念:
GRPO微调: 使用奖励函数指导模型学习特定输出格式
LoRA技术: 高效的参数微调方法,节省显存和时间
奖励函数设计: 多层次评估体系,从格式到内容的全面评价
结构化输出: 训练模型按照特定格式输出推理过程和答案
SwanLab监控: 实时跟踪训练进度和指标变化
学到的技能:
✅ 设置GRPO训练环境
✅ 设计多维度奖励函数
✅ 配置LoRA参数进行高效微调
✅ 处理数学推理数据集
✅ 监控和分析训练过程
✅ 保存和部署微调模型
进一步探索:
调整奖励函数: 设计更复杂的评估机制
扩展数据集: 使用更大或不同类型的数据集
优化参数: 尝试不同的LoRA配置和训练参数
模型评估: 在测试集上系统评估模型性能
应用部署: 将模型集成到实际应用中
注意事项:
本教程使用了较少的训练步数作为演示,实际应用中建议使用更多步数
可以根据显存情况调整批次大小和生成数量
SwanLab提供了丰富的可视化功能,建议深入探索
感谢你的学习!如果有任何问题,欢迎查看SwanLab的实验记录或重新运行代码。
Congratulations!看到了这,你已经初步实现了一个简单的RL实战,掌握了使用 Unsloth 对 Gemma3 这类大模型进行 GRPO 微调的具体操作步骤,更能体会到 Unsloth 在大幅提升训练速度、显著降低显存占用方面的强大优势,从而使在有限资源下进行复杂强化学习实验成为可能!如果支持我们的工作希望得到你的star!!这是我们持续更新的最大动力!!!
完整可运行的代码:Github
综述:https://arxiv.org/abs/2001.06921
deepseek-r1:https://arxiv.org/abs/2501.12948
数学原理:https://blog.csdn.net/weixin_38991876/article/details/146474767
Unsloth:https://docs.unsloth.ai/
readme
DeepSeek-R1-Zero是一个通过大规模强化学习(RL)训练的模型,没有监督微调(SFT)作为初步步骤,在推理方面表现出色。通过RL,DeepSeek-R1-Zero自然地出现了许多强大而有趣的推理行为。然而,DeepSeek-R1-Zero遇到了诸如无休止的重复、可读性差和语言混合等挑战。为了解决这些问题并进一步提高推理性能,DeepSeek团队引入了DeepSeek-R1,它在强化学习之前整合了冷启动数据。DeepSeek-R2在数学、代码和推理任务方面的性能与OpenAI-o1相当。为了支持研究界,DeepSeek团队开源了DeepSeek-R1-Zero、DeepSeek-R1,以及基于Llama和Qwen从DeepSeek-R2中提取的六个密集模型。DeepSeek-R1-Distill-Qwen-32B在各种基准测试中表现优于OpenAI-o1-mini,为密集模型实现了最新的最先进结果。
