3.1 向量及向量知识库
3.1.1 词向量与向量
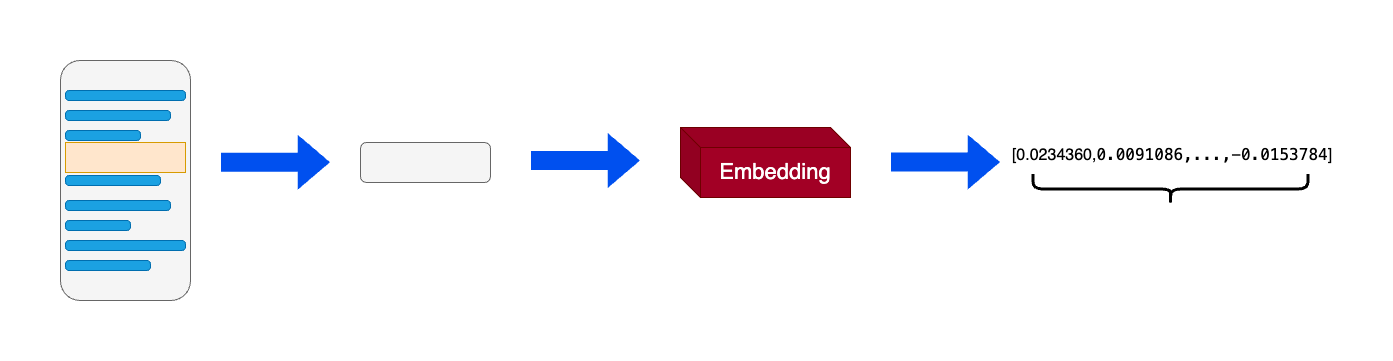
在机器学习和自然语言处理(NLP)中,词向量(word embedding)是一种以单词为单位将每个单词转化为实数向量的技术。这些实数向量可以被计算机更好地理解和处理。词向量背后的主要想理念是相似或相关的对象在向量空间中的距离应该很近。
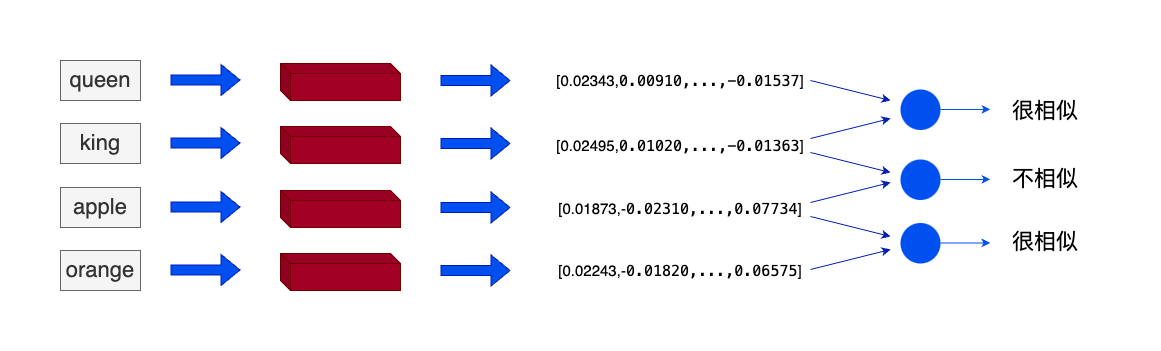
举个例子,我们可以使用词向量来表示文本数据。在词向量中,每个单词被转换为一个向量,这个向量捕获了这个单词的语义信息。例如,"king" 和 "queen" 这两个单词在向量空间中的位置将会非常接近,因为它们的含义相似。而 "apple" 和 "orange" 也会很接近,因为它们都是水果。而 "king" 和 "apple" 这两个单词在向量空间中的距离就会比较远,因为它们的含义不同。
词向量实际上是将单词转化为固定的静态的向量,虽然可以在一定程度上捕捉并表达文本中的语义信息,但忽略了单词在不同语境中的意思会受到影响这一现实。因此在RAG应用中使用的向量技术一般为通用文本向量(Universal text embedding),该技术可以对一定范围内任意长度的文本进行向量化,与词向量不同的是向量化的单位不再是单词而是输入的文本,输出的向量会捕捉更多的语义信息。
在RAG(Retrieval Augmented Generation,检索增强生成)方面向量的优势主要有两点:
向量比文字更适合检索。当我们在数据库检索时,如果数据库存储的是文字,主要通过检索关键词(词法搜索)等方法找到相对匹配的数据,匹配的程度取决于数据库中的文档中是否含有查询句中的关键词;而向量中包含了原文本的语义信息,可以通过计算问题与数据库中数据的点积、余弦距离、欧几里得距离等指标,直接获取问题与数据在语义层面上的相似度;
向量比其它媒介的综合信息能力更强,当传统数据库存储文字、声音、图像、视频等多种媒介时,很难去将上述多种媒介构建起关联与跨模态的查询方法;但是向量却可以通过多种向量模型将多种数据映射成统一的向量形式。
在搭建 RAG 系统时,我们往往可以通过使用向量模型来构建向量,我们可以选择:
使用各个公司的 Embedding API;
在本地使用向量模型将数据构建为向量。
3.1.2 向量数据库
向量数据库是用于高效计算和管理大量向量数据的解决方案。向量数据库是一种专门用于存储和检索向量数据(embedding)的数据库系统。它与传统的基于关系模型的数据库不同,它主要关注的是向量数据的特性和相似性。
在向量数据库中,数据被表示为向量形式,每个向量代表一个数据项。这些向量可以是数字、文本、图像或其他类型的数据。向量数据库使用高效的索引和查询算法来加速向量数据的存储和检索过程。
向量数据库中的数据以向量作为基本单位,对向量进行存储、处理及检索。向量数据库通过计算与目标向量的余弦距离、点积等获取与目标向量的相似度。当处理大量甚至海量的向量数据时,向量数据库索引和查询算法的效率明显高于传统数据库。
Chroma:是一个轻量级向量数据库,拥有丰富的功能和简单的 API,具有简单、易用、轻量的优点,但功能相对简单且不支持GPU加速,适合初学者使用。
Weaviate:是一个开源向量数据库。除了支持相似度搜索和最大边际相关性(MMR,Maximal Marginal Relevance)搜索外还可以支持结合多种搜索算法(基于词法搜索、向量搜索)的混合搜索,从而提高搜索结果的相关性和准确性。
Qdrant:Qdrant使用 Rust 语言开发,有极高的检索效率和RPS(Requests Per Second),支持本地运行、部署在本地服务器及Qdrant云三种部署模式。且可以通过为页面内容和元数据制定不同的键来复用数据。
3.2 使用Embedding API
注:为了方便embedding api调用,应将密钥填入llm_universe下的.env文件,代码将自动读取并加载环境变量。
3.2.1 使用OpenAI API
GPT有封装好的接口,我们简单封装即可。目前GPT embedding mode有三种,性能如下所示:
| 模型 | 每美元页数 | MTEB得分 | MIRACL得分 |
| text-embedding-3-large | 9,615 | 64.6 | 54.9 |
| text-embedding-3-small | 62,500 | 62.3 | 44.0 |
| text-embedding-ada-002 | 12,500 | 61.0 | 31.4 |
MTEB得分为embedding model分类、聚类、配对等八个任务的平均得分。
MIRACL得分为embedding model在检索任务上的平均得分。
从以上三个embedding model我们可以看出text-embedding-3-large有最好的性能和最贵的价格,当我们搭建的应用需要更好的表现且成本充足的情况下可以使用;text-embedding-3-small有着较好的性能跟价格,当我们预算有限时可以选择该模型;而text-embedding-ada-002是OpenAI上一代的模型,无论在性能还是价格都不如及前两者,因此不推荐使用。
import os
from openai import OpenAI
from dotenv import load_dotenv, find_dotenv


# 读取本地/项目的环境变量。
# find_dotenv()寻找并定位.env文件的路径
# load_dotenv()读取该.env文件,并将其中的环境变量加载到当前的运行环境中
# 如果你设置的是全局的环境变量,这行代码则没有任何作用。
_ = load_dotenv(find_dotenv())

# 如果你需要通过代理端口访问,你需要如下配置
# os.environ['HTTPS_PROXY'] = 'http://127.0.0.1:7890'
# os.environ["HTTP_PROXY"] = 'http://127.0.0.1:7890'

def openai_embedding(text: str, model: str=None):
    # 获取环境变量 OPENAI_API_KEY
    api_key=os.environ['OPENAI_API_KEY']
    client = OpenAI(api_key=api_key)

    # embedding model:'text-embedding-3-small', 'text-embedding-3-large', 'text-embedding-ada-002'
    if model == None:
        model="text-embedding-3-small"

    response = client.embeddings.create(
        input=text,
        model=model
    )
    return response

response = openai_embedding(text='要生成 embedding 的输入文本,字符串形式。')API返回的数据为json格式,除object向量类型外还有存放数据的data、embedding model 型号model以及本次 token 使用情况usage等数据,具体如下所示:
{
  "object": "list",
  "data": [
    {
      "object": "embedding",
      "index": 0,
      "embedding": [
        -0.006929283495992422,
        ... (省略)
        -4.547132266452536e-05,
      ],
    }
  ],
  "model": "text-embedding-3-small",
  "usage": {
    "prompt_tokens": 5,
    "total_tokens": 5
  }
}我们可以调用response的object来获取embedding的类型。
print(f'返回的embedding类型为:{response.object}')返回的embedding类型为:list
embedding存放在data中,我们可以查看embedding的长度及生成的embedding。
print(f'embedding长度为:{len(response.data[0].embedding)}')
print(f'embedding(前10)为:{response.data[0].embedding[:10]}')embedding长度为:1536 embedding(前10)为:[0.038827355951070786, 0.013531949371099472, -0.0025024667847901583, -0.016542360186576843, 0.02412303350865841, -0.017386866733431816, 0.042086150497198105, 0.011515072546899319, -0.0282362699508667, -0.006800748407840729]
我们也可以查看此次embedding的模型及token使用情况。
print(f'本次embedding model为:{response.model}')
print(f'本次token使用情况为:{response.usage}')本次embedding model为:text-embedding-3-small 本次token使用情况为:Usage(prompt_tokens=12, total_tokens=12)
3.2.2 使用文心千帆API
Embedding-V1是基于百度文心大模型技术的文本表示模型,Access token为调用接口的凭证,使用Embedding-V1时应先凭API Key、Secret Key获取Access token,再通过Access token调用接口来embedding text。同时千帆大模型平台还支持bge-large-zh等embedding model。
import requests
import json

def wenxin_embedding(text: str):
    # 获取环境变量 wenxin_api_key、wenxin_secret_key
    api_key = os.environ['QIANFAN_AK']
    secret_key = os.environ['QIANFAN_SK']

    # 使用API Key、Secret Key向https://aip.baidubce.com/oauth/2.0/token 获取Access token
    url = "https://aip.baidubce.com/oauth/2.0/token?grant_type=client_credentials&client_id={0}&client_secret={1}".format(api_key, secret_key)
    payload = json.dumps("")
    headers = {
        'Content-Type': 'application/json',
        'Accept': 'application/json'
    }
    response = requests.request("POST", url, headers=headers, data=payload)

    # 通过获取的Access token 来embedding text
    url = "https://aip.baidubce.com/rpc/2.0/ai_custom/v1/wenxinworkshop/embeddings/embedding-v1?access_token=" + str(response.json().get("access_token"))
    input = []
    input.append(text)
    payload = json.dumps({
        "input": input
    })
    headers = {
        'Content-Type': 'application/json'
    }

    response = requests.request("POST", url, headers=headers, data=payload)

    return json.loads(response.text)
# text应为List(string)
text = "要生成 embedding 的输入文本,字符串形式。"
response = wenxin_embedding(text=text)Embedding-V1每次embedding除了有单独的id外,还有时间戳记录embedding的时间。
print('本次embedding id为:{}'.format(response['id']))
print('本次embedding产生时间戳为:{}'.format(response['created']))本次embedding id为:as-h7u5sde3ga 本次embedding产生时间戳为:1741091715
同样的我们也可以从response中获取embedding的类型和embedding。
print('返回的embedding类型为:{}'.format(response['object']))
print('embedding长度为:{}'.format(len(response['data'][0]['embedding'])))
print('embedding(前10)为:{}'.format(response['data'][0]['embedding'][:10]))返回的embedding类型为:embedding_list embedding长度为:384 embedding(前10)为:[0.060567744076251984, 0.020958080887794495, 0.053234219551086426, 0.02243831567466259, -0.024505289271473885, -0.09820500761270523, 0.04375714063644409, -0.009092536754906178, -0.020122773945331573, 0.015808865427970886]
3.2.3 使用讯飞星火API
使用讯飞 embedding 时需要注意spark_embedding_domain参数,该参数在向量化问题时为 "query" 在向量化知识库时为 "para"。
from sparkai.embedding.spark_embedding import Embeddingmodel
import os
xunfei_embedding = Embeddingmodel(
    spark_embedding_app_id=os.environ["IFLYTEK_SPARK_APP_ID"],
    spark_embedding_api_key=os.environ["IFLYTEK_SPARK_API_KEY"],
    spark_embedding_api_secret=os.environ["IFLYTEK_SPARK_API_SECRET"],
    spark_embedding_domain="para"
    )

text = {"content":'要生成 embedding 的输入文本。',"role":"user"}
response = xunfei_embedding.embedding(text=text)print(f'生成的embedding长度为:{len(response)}')
print(f'embedding(前10)为: {response[:10]}')生成的embedding长度为:2560 embedding(前10)为: [-0.448486328125, 0.84130859375, 0.67919921875, 0.214599609375, 0.374267578125, 0.384033203125, -0.488525390625, -0.6103515625, 0.1571044921875, 0.81494140625]
3.2.4 使用智谱API
智谱有封装好的SDK,我们调用即可。
from zhipuai import ZhipuAI
def zhipu_embedding(text: str):

    api_key = os.environ['ZHIPUAI_API_KEY']
    client = ZhipuAI(api_key=api_key)
    response = client.embeddings.create(
        model="embedding-3",
        input=text,
    )
    return response

text = '要生成 embedding 的输入文本,字符串形式。'
response = zhipu_embedding(text=text)response为zhipuai.types.embeddings.EmbeddingsResponded类型,我们可以调用object、data、model、usage来查看response的embedding类型、embedding、embedding model及使用情况。
print(f'response类型为:{type(response)}')
print(f'embedding类型为:{response.object}')
print(f'生成embedding的model为:{response.model}')
print(f'生成的embedding长度为:{len(response.data[0].embedding)}')
print(f'embedding(前10)为: {response.data[0].embedding[:10]}')response类型为: embedding类型为:list 生成embedding的model为:embedding-3 生成的embedding长度为:2048 embedding(前10)为: [-0.0042974288, 0.040918995, -0.0036798029, 0.034753118, -0.047749206, -0.015196704, -0.023666998, -0.002935019, 0.0015090306, -0.011958062]
3.3 数据处理
为构建我们的本地知识库,我们需要对以多种类型存储的本地文档进行处理,读取本地文档并通过前文描述的 Embedding 方法将本地文档的内容转化为词向量来构建向量数据库。在本节中,我们以一些实际示例入手,来讲解如何对本地文档进行处理。
3.3.1 源文档选取
我们选用 Datawhale 一些经典开源课程作为示例,具体包括:
我们将知识库源数据放置在../data_base/knowledge_db 目录下。
3.3.2 数据读取
对于PDF 文档,我们可以使用 LangChain 的 PyMuPDFLoader 来读取知识库的 PDF 文件。PyMuPDFLoader 是 PDF 解析器中速度最快的一种,结果会包含 PDF 及其页面的详细元数据,并且每页返回一个文档。
from langchain_community.document_loaders import PyMuPDFLoader

# 创建一个 PyMuPDFLoader Class 实例,输入为待加载的 pdf 文档路径
loader = PyMuPDFLoader("../data_base/knowledge_db/pumkin_book/pumpkin_book.pdf")

# 调用 PyMuPDFLoader Class 的函数 load 对 pdf 文件进行加载
pdf_pages = loader.load()文档加载后储存在 pages 变量中:
page 的变量类型为 List
打印 pages 的长度可以看到 pdf 一共包含多少页
print(f"载入后的变量类型为:{type(pdf_pages)},", f"该 PDF 一共包含 {len(pdf_pages)} 页")载入后的变量类型为:, 该 PDF 一共包含 196 页
page 中的每一元素为一个文档,变量类型为 langchain_core.documents.base.Document, 文档变量类型包含两个属性
page_content 包含该文档的内容。
meta_data 为文档相关的描述性数据。
pdf_page = pdf_pages[1]
print(f"每一个元素的类型:{type(pdf_page)}.",
    f"该文档的描述性数据:{pdf_page.metadata}",
    f"查看该文档的内容:\n{pdf_page.page_content}",
sep="\n------\n")每一个元素的类型:.
该文档的描述性数据:{'source': '../../data_base/knowledge_db/pumkin_book/pumpkin_book.pdf', 'file_path': '../../data_base/knowledge_db/pumkin_book/pumpkin_book.pdf', 'page': 1, 'total_pages': 196, 'format': 'PDF 1.5', 'title': '', 'author': '', 'subject': '', 'keywords': '', 'creator': 'LaTeX with hyperref', 'producer': 'xdvipdfmx (20200315)', 'creationDate': "D:20230303170709-00'00'", 'modDate': '', 'trapped': ''}
查看该文档的内容: 前言 “周志华老师的《机器学习》(西瓜书)是机器学习领域的经典入门教材之一,周老师为了使尽可能多的读 者通过西瓜书对机器学习有所了解, 所以在书中对部分公式的推导细节没有详述,但是这对那些想深究公式推 导细节的读者来说可能“不太友好”,本书旨在对西瓜书里比较难理解的公式加以解析,以及对部分公式补充 具体的推导细节。” 读到这里,大家可能会疑问为啥前面这段话加了引号,因为这只是我们最初的遐想,后来我们了解到,周 老师之所以省去这些推导细节的真实原因是,他本尊认为“理工科数学基础扎实点的大二下学生应该对西瓜书 中的推导细节无困难吧,要点在书里都有了,略去的细节应能脑补或做练习”。所以...... 本南瓜书只能算是我 等数学渣渣在自学的时候记下来的笔记,希望能够帮助大家都成为一名合格的“理工科数学基础扎实点的大二 下学生”。 使用说明 • 南瓜书的所有内容都是以西瓜书的内容为前置知识进行表述的,所以南瓜书的最佳使用方法是以西瓜书 为主线,遇到自己推导不出来或者看不懂的公式时再来查阅南瓜书; • 对于初学机器学习的小白,西瓜书第1 章和第2 章的公式强烈不建议深究,简单过一下即可,等你学得 有点飘的时候再回来啃都来得及; • 每个公式的解析和推导我们都力(zhi) 争(neng) 以本科数学基础的视角进行讲解,所以超纲的数学知识 我们通常都会以附录和参考文献的形式给出,感兴趣的同学可以继续沿着我们给的资料进行深入学习; • 若南瓜书里没有你想要查阅的公式,或者你发现南瓜书哪个地方有错误,请毫不犹豫地去我们GitHub 的 Issues(地址:https://github.com/datawhalechina/pumpkin-book/issues)进行反馈,在对应版块 提交你希望补充的公式编号或者勘误信息,我们通常会在24 小时以内给您回复,超过24 小时未回复的 话可以微信联系我们(微信号:at-Sm1les); 配套视频教程:https://www.bilibili.com/video/BV1Mh411e7VU 在线阅读地址:https://datawhalechina.github.io/pumpkin-book(仅供第1 版) 最新版PDF 获取地址:https://github.com/datawhalechina/pumpkin-book/releases 编委会 主编:Sm1les、archwalker、jbb0523 编委:juxiao、Majingmin、MrBigFan、shanry、Ye980226 封面设计:构思-Sm1les、创作-林王茂盛 致谢 特别感谢awyd234、feijuan、Ggmatch、Heitao5200、huaqing89、LongJH、LilRachel、LeoLRH、Nono17、 spareribs、sunchaothu、StevenLzq 在最早期的时候对南瓜书所做的贡献。 扫描下方二维码,然后回复关键词“南瓜书”,即可加入“南瓜书读者交流群” 版权声明 本作品采用知识共享署名-非商业性使用-相同方式共享4.0 国际许可协议进行许可。
对于 markdown 文档我们可以以几乎完全一致的方式读入。
from langchain_community.document_loaders.markdown import UnstructuredMarkdownLoader

loader = UnstructuredMarkdownLoader("../data_base/knowledge_db/prompt_engineering/1. 简介 Introduction.md")
md_pages = loader.load()读取的对象和 PDF 文档读取出来是完全一致的:
print(f"载入后的变量类型为:{type(md_pages)},", f"该 Markdown 一共包含 {len(md_pages)} 页")载入后的变量类型为:, 该 Markdown 一共包含 1 页
md_page = md_pages[0]
print(f"每一个元素的类型:{type(md_page)}.",
    f"该文档的描述性数据:{md_page.metadata}",
    f"查看该文档的内容:\n{md_page.page_content[0:][:200]}",
sep="\n------\n")每一个元素的类型:.
该文档的描述性数据:{'source': '../../data_base/knowledge_db/prompt_engineering/1. 简介 Introduction.md'}
查看该文档的内容: 第一章 简介
欢迎来到面向开发者的提示工程部分,本部分内容基于吴恩达老师的《Prompt Engineering for Developer》课程进行编写。《Prompt Engineering for Developer》课程是由吴恩达老师与 OpenAI 技术团队成员 Isa Fulford 老师合作授课,Isa 老师曾开发过受欢迎的 ChatGPT 检索插件,并且在教授 LLM (Larg
3.3.3 数据清洗
我们期望知识库的数据尽量是有序的、优质的、精简的,因此我们要删除低质量的、甚至影响理解的文本数据。 可以看到上文中读取的pdf文件不仅将一句话按照原文的分行添加了换行符\n,也在原本两个符号中间插入了\n,我们可以使用正则表达式匹配并删除掉\n。
import re
pattern = re.compile(r'[^\u4e00-\u9fff](\n)[^\u4e00-\u9fff]', re.DOTALL)
pdf_page.page_content = re.sub(pattern, lambda match: match.group(0).replace('\n', ''), pdf_page.page_content)
print(pdf_page.page_content)前言 “周志华老师的《机器学习》(西瓜书)是机器学习领域的经典入门教材之一,周老师为了使尽可能多的读 者通过西瓜书对机器学习有所了解, 所以在书中对部分公式的推导细节没有详述,但是这对那些想深究公式推 导细节的读者来说可能“不太友好”,本书旨在对西瓜书里比较难理解的公式加以解析,以及对部分公式补充 具体的推导细节。” 读到这里,大家可能会疑问为啥前面这段话加了引号,因为这只是我们最初的遐想,后来我们了解到,周 老师之所以省去这些推导细节的真实原因是,他本尊认为“理工科数学基础扎实点的大二下学生应该对西瓜书 中的推导细节无困难吧,要点在书里都有了,略去的细节应能脑补或做练习”。所以...... 本南瓜书只能算是我 等数学渣渣在自学的时候记下来的笔记,希望能够帮助大家都成为一名合格的“理工科数学基础扎实点的大二 下学生”。 使用说明 • 南瓜书的所有内容都是以西瓜书的内容为前置知识进行表述的,所以南瓜书的最佳使用方法是以西瓜书 为主线,遇到自己推导不出来或者看不懂的公式时再来查阅南瓜书;• 对于初学机器学习的小白,西瓜书第1 章和第2 章的公式强烈不建议深究,简单过一下即可,等你学得 有点飘的时候再回来啃都来得及;• 每个公式的解析和推导我们都力(zhi) 争(neng) 以本科数学基础的视角进行讲解,所以超纲的数学知识 我们通常都会以附录和参考文献的形式给出,感兴趣的同学可以继续沿着我们给的资料进行深入学习;• 若南瓜书里没有你想要查阅的公式,或者你发现南瓜书哪个地方有错误,请毫不犹豫地去我们GitHub 的 Issues(地址:https://github.com/datawhalechina/pumpkin-book/issues)进行反馈,在对应版块 提交你希望补充的公式编号或者勘误信息,我们通常会在24 小时以内给您回复,超过24 小时未回复的 话可以微信联系我们(微信号:at-Sm1les); 配套视频教程:https://www.bilibili.com/video/BV1Mh411e7VU 在线阅读地址:https://datawhalechina.github.io/pumpkin-book(仅供第1 版) 最新版PDF 获取地址:https://github.com/datawhalechina/pumpkin-book/releases 编委会 主编:Sm1les、archwalker、jbb0523 编委:juxiao、Majingmin、MrBigFan、shanry、Ye980226 封面设计:构思-Sm1les、创作-林王茂盛 致谢 特别感谢awyd234、feijuan、Ggmatch、Heitao5200、huaqing89、LongJH、LilRachel、LeoLRH、Nono17、spareribs、sunchaothu、StevenLzq 在最早期的时候对南瓜书所做的贡献。 扫描下方二维码,然后回复关键词“南瓜书”,即可加入“南瓜书读者交流群” 版权声明 本作品采用知识共享署名-非商业性使用-相同方式共享4.0 国际许可协议进行许可。
进一步分析数据,我们发现数据中还有不少的•和空格,我们使用replace方法去掉即可。
pdf_page.page_content = pdf_page.page_content.replace('•', '')
pdf_page.page_content = pdf_page.page_content.replace(' ', '')
print(pdf_page.page_content)前言 “周志华老师的《机器学习》(西瓜书)是机器学习领域的经典入门教材之一,周老师为了使尽可能多的读 者通过西瓜书对机器学习有所了解,所以在书中对部分公式的推导细节没有详述,但是这对那些想深究公式推 导细节的读者来说可能“不太友好”,本书旨在对西瓜书里比较难理解的公式加以解析,以及对部分公式补充 具体的推导细节。” 读到这里,大家可能会疑问为啥前面这段话加了引号,因为这只是我们最初的遐想,后来我们了解到,周 老师之所以省去这些推导细节的真实原因是,他本尊认为“理工科数学基础扎实点的大二下学生应该对西瓜书 中的推导细节无困难吧,要点在书里都有了,略去的细节应能脑补或做练习”。所以......本南瓜书只能算是我 等数学渣渣在自学的时候记下来的笔记,希望能够帮助大家都成为一名合格的“理工科数学基础扎实点的大二 下学生”。 使用说明 南瓜书的所有内容都是以西瓜书的内容为前置知识进行表述的,所以南瓜书的最佳使用方法是以西瓜书 为主线,遇到自己推导不出来或者看不懂的公式时再来查阅南瓜书;对于初学机器学习的小白,西瓜书第1章和第2章的公式强烈不建议深究,简单过一下即可,等你学得 有点飘的时候再回来啃都来得及;每个公式的解析和推导我们都力(zhi)争(neng)以本科数学基础的视角进行讲解,所以超纲的数学知识 我们通常都会以附录和参考文献的形式给出,感兴趣的同学可以继续沿着我们给的资料进行深入学习;若南瓜书里没有你想要查阅的公式,或者你发现南瓜书哪个地方有错误,请毫不犹豫地去我们GitHub的 Issues(地址:https://github.com/datawhalechina/pumpkin-book/issues)进行反馈,在对应版块 提交你希望补充的公式编号或者勘误信息,我们通常会在24小时以内给您回复,超过24小时未回复的 话可以微信联系我们(微信号:at-Sm1les); 配套视频教程:https://www.bilibili.com/video/BV1Mh411e7VU 在线阅读地址:https://datawhalechina.github.io/pumpkin-book(仅供第1版) 最新版PDF获取地址:https://github.com/datawhalechina/pumpkin-book/releases 编委会 主编:Sm1les、archwalker、jbb0523 编委:juxiao、Majingmin、MrBigFan、shanry、Ye980226 封面设计:构思-Sm1les、创作-林王茂盛 致谢 特别感谢awyd234、feijuan、Ggmatch、Heitao5200、huaqing89、LongJH、LilRachel、LeoLRH、Nono17、spareribs、sunchaothu、StevenLzq在最早期的时候对南瓜书所做的贡献。 扫描下方二维码,然后回复关键词“南瓜书”,即可加入“南瓜书读者交流群” 版权声明 本作品采用知识共享署名-非商业性使用-相同方式共享4.0国际许可协议进行许可。
上文中读取的md文件每一段中间隔了一个换行符,我们同样可以使用replace方法去除。
md_page.page_content = md_page.page_content.replace('\n\n', '\n')
print(md_page.page_content)第一章 简介 欢迎来到面向开发者的提示工程部分,本部分内容基于吴恩达老师的《Prompt Engineering for Developer》课程进行编写。《Prompt Engineering for Developer》课程是由吴恩达老师与 OpenAI 技术团队成员 Isa Fulford 老师合作授课,Isa 老师曾开发过受欢迎的 ChatGPT 检索插件,并且在教授 LLM (Large Language Model, 大语言模型)技术在产品中的应用方面做出了很大贡献。她还参与编写了教授人们使用 Prompt 的 OpenAI cookbook。我们希望通过本模块的学习,与大家分享使用提示词开发 LLM 应用的最佳实践和技巧。 网络上有许多关于提示词(Prompt, 本教程中将保留该术语)设计的材料,例如《30 prompts everyone has to know》之类的文章,这些文章主要集中在 ChatGPT 的 Web 界面上,许多人在使用它执行特定的、通常是一次性的任务。但我们认为,对于开发人员,大语言模型(LLM) 的更强大功能是能通过 API 接口调用,从而快速构建软件应用程序。实际上,我们了解到 DeepLearning.AI 的姊妹公司 AI Fund 的团队一直在与许多初创公司合作,将这些技术应用于诸多应用程序上。很兴奋能看到 LLM API 能够让开发人员非常快速地构建应用程序。 在本模块,我们将与读者分享提升大语言模型应用效果的各种技巧和最佳实践。书中内容涵盖广泛,包括软件开发提示词设计、文本总结、推理、转换、扩展以及构建聊天机器人等语言模型典型应用场景。我们衷心希望该课程能激发读者的想象力,开发出更出色的语言模型应用。 随着 LLM 的发展,其大致可以分为两种类型,后续称为基础 LLM 和指令微调(Instruction Tuned)LLM。基础LLM是基于文本训练数据,训练出预测下一个单词能力的模型。其通常通过在互联网和其他来源的大量数据上训练,来确定紧接着出现的最可能的词。例如,如果你以“从前,有一只独角兽”作为 Prompt ,基础 LLM 可能会继续预测“她与独角兽朋友共同生活在一片神奇森林中”。但是,如果你以“法国的首都是什么”为 Prompt ,则基础 LLM 可能会根据互联网上的文章,将回答预测为“法国最大的城市是什么?法国的人口是多少?”,因为互联网上的文章很可能是有关法国国家的问答题目列表。 与基础语言模型不同,指令微调 LLM 通过专门的训练,可以更好地理解并遵循指令。举个例子,当询问“法国的首都是什么?”时,这类模型很可能直接回答“法国的首都是巴黎”。指令微调 LLM 的训练通常基于预训练语言模型,先在大规模文本数据上进行预训练,掌握语言的基本规律。在此基础上进行进一步的训练与微调(finetune),输入是指令,输出是对这些指令的正确回复。有时还会采用RLHF(reinforcement learning from human feedback,人类反馈强化学习)技术,根据人类对模型输出的反馈进一步增强模型遵循指令的能力。通过这种受控的训练过程。指令微调 LLM 可以生成对指令高度敏感、更安全可靠的输出,较少无关和损害性内容。因此。许多实际应用已经转向使用这类大语言模型。 因此,本课程将重点介绍针对指令微调 LLM 的最佳实践,我们也建议您将其用于大多数使用场景。当您使用指令微调 LLM 时,您可以类比为向另一个人提供指令(假设他很聪明但不知道您任务的具体细节)。因此,当 LLM 无法正常工作时,有时是因为指令不够清晰。例如,如果您想问“请为我写一些关于阿兰·图灵( Alan Turing )的东西”,在此基础上清楚表明您希望文本专注于他的科学工作、个人生活、历史角色或其他方面可能会更有帮助。另外您还可以指定回答的语调, 来更加满足您的需求,可选项包括专业记者写作,或者向朋友写的随笔等。 如果你将 LLM 视为一名新毕业的大学生,要求他完成这个任务,你甚至可以提前指定他们应该阅读哪些文本片段来写关于阿兰·图灵的文本,这样能够帮助这位新毕业的大学生更好地完成这项任务。本书的下一章将详细阐释提示词设计的两个关键原则:清晰明确和给予充足思考时间。
3.3.4 文档分割
由于单个文档的长度往往会超过模型支持的上下文,导致检索得到的知识太长超出模型的处理能力,因此,在构建向量知识库的过程中,我们往往需要对文档进行分割,将单个文档按长度或者按固定的规则分割成若干个 chunk,然后将每个 chunk 转化为词向量,存储到向量数据库中。
在检索时,我们会以 chunk 作为检索的元单位,也就是每一次检索到 k 个 chunk 作为模型可以参考来回答用户问题的知识,这个 k 是我们可以自由设定的。
Langchain 中文本分割器都根据 chunk_size (块大小)和 chunk_overlap (块与块之间的重叠大小)进行分割。
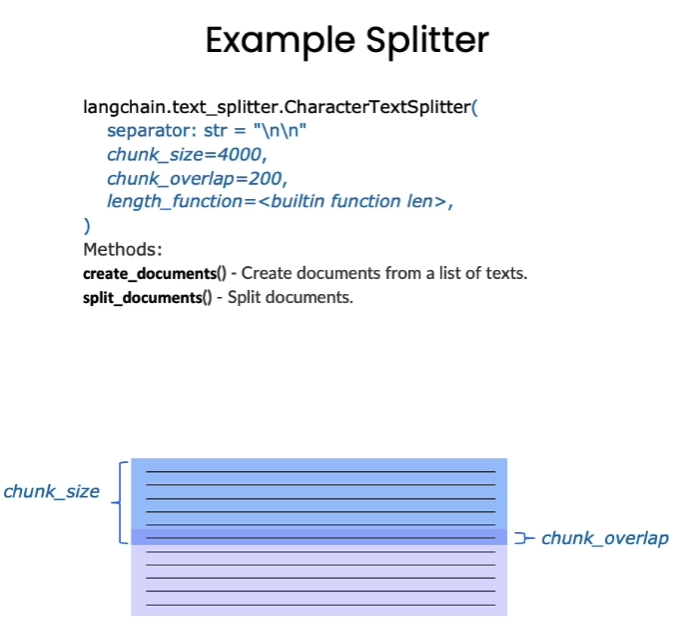
chunk_size 指每个块包含的字符或 Token (如单词、句子等)的数量
chunk_overlap 指两个块之间共享的字符数量,用于保持上下文的连贯性,避免分割丢失上下文信息
Langchain 提供多种文档分割方式,区别在怎么确定块与块之间的边界、块由哪些字符/token组成、以及如何测量块大小
RecursiveCharacterTextSplitter(): 按字符串分割文本,递归地尝试按不同的分隔符进行分割文本。
CharacterTextSplitter(): 按字符来分割文本。
MarkdownHeaderTextSplitter(): 基于指定的标题来分割markdown 文件。
TokenTextSplitter(): 按token来分割文本。
SentenceTransformersTokenTextSplitter(): 按token来分割文本
Language(): 用于 CPP、Python、Ruby、Markdown 等。
NLTKTextSplitter(): 使用 NLTK(自然语言工具包)按句子分割文本。
SpacyTextSplitter(): 使用 Spacy按句子的切割文本。
'''
* RecursiveCharacterTextSplitter 递归字符文本分割
RecursiveCharacterTextSplitter 将按不同的字符递归地分割(按照这个优先级["\n\n", "\n", " ", ""]),
    这样就能尽量把所有和语义相关的内容尽可能长时间地保留在同一位置
RecursiveCharacterTextSplitter需要关注的是4个参数:

* separators - 分隔符字符串数组
* chunk_size - 每个文档的字符数量限制
* chunk_overlap - 两份文档重叠区域的长度
* length_function - 长度计算函数
'''
#导入文本分割器
from langchain_text_splitters import RecursiveCharacterTextSplitter# 知识库中单段文本长度
CHUNK_SIZE = 500
# 知识库中相邻文本重合长度
OVERLAP_SIZE = 50# 使用递归字符文本分割器
text_splitter = RecursiveCharacterTextSplitter(
chunk_size=CHUNK_SIZE,
chunk_overlap=OVERLAP_SIZE
)
text_splitter.split_text(pdf_page.page_content[0:1000])['前言\n“周志华老师的《机器学习》(西瓜书)是机器学习领域的经典入门教材之一,周老师为了使尽可能多的读\n者通过西瓜书对机器学习有所了解,所以在书中对部分公式的推导细节没有详述,但是这对那些想深究公式推\n导细节的读者来说可能“不太友好”,本书旨在对西瓜书里比较难理解的公式加以解析,以及对部分公式补充\n具体的推导细节。”\n读到这里,大家可能会疑问为啥前面这段话加了引号,因为这只是我们最初的遐想,后来我们了解到,周\n老师之所以省去这些推导细节的真实原因是,他本尊认为“理工科数学基础扎实点的大二下学生应该对西瓜书\n中的推导细节无困难吧,要点在书里都有了,略去的细节应能脑补或做练习”。所以......本南瓜书只能算是我\n等数学渣渣在自学的时候记下来的笔记,希望能够帮助大家都成为一名合格的“理工科数学基础扎实点的大二\n下学生”。\n使用说明\n南瓜书的所有内容都是以西瓜书的内容为前置知识进行表述的,所以南瓜书的最佳使用方法是以西瓜书\n为主线,遇到自己推导不出来或者看不懂的公式时再来查阅南瓜书;对于初学机器学习的小白,西瓜书第1章和第2章的公式强烈不建议深究,简单过一下即可,等你学得', '有点飘的时候再回来啃都来得及;每个公式的解析和推导我们都力(zhi)争(neng)以本科数学基础的视角进行讲解,所以超纲的数学知识\n我们通常都会以附录和参考文献的形式给出,感兴趣的同学可以继续沿着我们给的资料进行深入学习;若南瓜书里没有你想要查阅的公式,或者你发现南瓜书哪个地方有错误,请毫不犹豫地去我们GitHub的\nIssues(地址:https://github.com/datawhalechina/pumpkin-book/issues)进行反馈,在对应版块\n提交你希望补充的公式编号或者勘误信息,我们通常会在24小时以内给您回复,超过24小时未回复的\n话可以微信联系我们(微信号:at-Sm1les);\n配套视频教程:https://www.bilibili.com/video/BV1Mh411e7VU\n在线阅读地址:https://datawhalechina.github.io/pumpkin-book(仅供第1版)\n最新版PDF获取地址:https://github.com/datawhalechina/pumpkin-book/releases\n编委会', '编委会\n主编:Sm1les、archwalker']
split_docs = text_splitter.split_documents(pdf_pages)
print(f"切分后的文件数量:{len(split_docs)}")切分后的文件数量:711
print(f"切分后的字符数(可以用来大致评估 token 数):{sum([len(doc.page_content) for doc in split_docs])}")切分后的字符数(可以用来大致评估 token 数):305816
注:如何对文档进行分割,其实是数据处理中最核心的一步,其往往决定了检索系统的下限。但是,如何选择分割方式,往往具有很强的业务相关性——针对不同的业务、不同的源数据,往往需要设定个性化的文档分割方式。因此,在本章,我们仅简单根据 chunk_size 对文档进行分割。对于有兴趣进一步探索的读者,欢迎阅读我们第三部分的项目示例来参考已有的项目是如何进行文档分割的。
3.4 搭建并使用向量数据库
3.4.1 前序配置
本节重点为搭建并使用向量数据库,因此读取数据后我们省去数据处理的环节直入主题,数据清洗等步骤可以参考第三节
import os
from dotenv import load_dotenv, find_dotenv

# 读取本地/项目的环境变量。
# find_dotenv()寻找并定位.env文件的路径
# load_dotenv()读取该.env文件,并将其中的环境变量加载到当前的运行环境中
# 如果你设置的是全局的环境变量,这行代码则没有任何作用。
_ = load_dotenv(find_dotenv())

# 如果你需要通过代理端口访问,你需要如下配置
# os.environ['HTTPS_PROXY'] = 'http://127.0.0.1:7890'
# os.environ["HTTP_PROXY"] = 'http://127.0.0.1:7890'

# 获取folder_path下所有文件路径,储存在file_paths里
file_paths = []
folder_path = '../../data_base/knowledge_db'
for root, dirs, files in os.walk(folder_path):
    for file in files:
        file_path = os.path.join(root, file)
        file_paths.append(file_path)
print(file_paths[:3])['../../data_base/knowledge_db/prompt_engineering/6. 文本转换 Transforming.md', '../../data_base/knowledge_db/prompt_engineering/4. 文本概括 Summarizing.md', '../../data_base/knowledge_db/prompt_engineering/5. 推断 Inferring.md']
from langchain_community.document_loaders import PyMuPDFLoader
from langchain_community.document_loaders import UnstructuredMarkdownLoader

# 遍历文件路径并把实例化的loader存放在loaders里
loaders = []

for file_path in file_paths:
    file_type = file_path.split('.')[-1]
    if file_type == 'pdf':
        loaders.append(PyMuPDFLoader(file_path))
    elif file_type == 'md':
loaders.append(UnstructuredMarkdownLoader(file_path))# 下载文件并存储到text
texts = []
for loader in loaders: texts.extend(loader.load())载入后的变量类型为langchain_core.documents.base.Document, 文档变量类型同样包含两个属性
page_content 包含该文档的内容。
meta_data 为文档相关的描述性数据。
text = texts[1]
print(f"每一个元素的类型:{type(text)}.",
    f"该文档的描述性数据:{text.metadata}",
    f"查看该文档的内容:\n{text.page_content[0:]}",
sep="\n------\n")每一个元素的类型:.
该文档的描述性数据:{'source': '../../data_base/knowledge_db/prompt_engineering/4. 文本概括 Summarizing.md'}
查看该文档的内容: 第四章 文本概括
在繁忙的信息时代,小明是一名热心的开发者,面临着海量的文本信息处理的挑战。他需要通过研究无数的文献资料来为他的项目找到关键的信息,但是时间却远远不够。在他焦头烂额之际,他发现了大型语言模型(LLM)的文本摘要功能。
这个功能对小明来说如同灯塔一样,照亮了他处理信息海洋的道路。LLM 的强大能力在于它可以将复杂的文本信息简化,提炼出关键的观点,这对于他来说无疑是巨大的帮助。他不再需要花费大量的时间去阅读所有的文档,只需要用 LLM 将它们概括,就可以快速获取到他所需要的信息。
通过编程调用 AP I接口,小明成功实现了这个文本摘要的功能。他感叹道:“这简直就像一道魔法,将无尽的信息海洋变成了清晰的信息源泉。”小明的经历,展现了LLM文本摘要功能的巨大优势:节省时间,提高效率,以及精准获取信息。这就是我们本章要介绍的内容,让我们一起来探索如何利用编程和调用API接口,掌握这个强大的工具。
一、单一文本概括
以商品评论的总结任务为例:对于电商平台来说,网站上往往存在着海量的商品评论,这些评论反映了所有客户的想法。如果我们拥有一个工具去概括这些海量、冗长的评论,便能够快速地浏览更多评论,洞悉客户的偏好,从而指导平台与商家提供更优质的服务。
接下来我们提供一段在线商品评价作为示例,可能来自于一个在线购物平台,例如亚马逊、淘宝、京东等。评价者为一款熊猫公仔进行了点评,评价内容包括商品的质量、大小、价格和物流速度等因素,以及他的女儿对该商品的喜爱程度。
python prod_review = """ 这个熊猫公仔是我给女儿的生日礼物,她很喜欢,去哪都带着。 公仔很软,超级可爱,面部表情也很和善。但是相比于价钱来说, 它有点小,我感觉在别的地方用同样的价钱能买到更大的。 快递比预期提前了一天到货,所以在送给女儿之前,我自己玩了会。 """
1.1 限制输出文本长度
我们首先尝试将文本的长度限制在30个字以内。
    prompt = f""" 您的任务是从电子商务网站上生成一个产品评论的简短摘要。

    请对三个反引号之间的评论文本进行概括,最多30个字。

    评论: {prod_review} """

    response = get_completion(prompt) print(response) ```

    熊猫公仔软可爱,女儿喜欢,但有点小。快递提前一天到货。

    我们可以看到语言模型给了我们一个符合要求的结果。

    注意:在上一节中我们提到了语言模型在计算和判断文本长度时依赖于分词器,而分词器在字符统计方面不具备完美精度。

    1.2 设置关键角度侧重

    在某些情况下,我们会针对不同的业务场景对文本的侧重会有所不同。例如,在商品评论文本中,物流部门可能更专注于运输的时效性,商家则更关注价格和商品质量,而平台则更看重整体的用户体验。

    我们可以通过增强输入提示(Prompt),来强调我们对某一特定视角的重视。

    1.2.1 侧重于快递服务
请对三个反引号之间的评论文本进行概括,最多30个字,并且侧重在快递服务上。
评论: {prod_review} """
response = get_completion(prompt) print(response) ```
快递提前到货,公仔可爱但有点小。
通过输出结果,我们可以看到,文本以“快递提前到货”开头,体现了对于快递效率的侧重。
1.2.2 侧重于价格与质量
    请对三个反引号之间的评论文本进行概括,最多30个词汇,并且侧重在产品价格和质量上。

    评论: {prod_review} """

    response = get_completion(prompt) print(response) ```

    可爱的熊猫公仔,质量好但有点小,价格稍高。快递提前到货。

    通过输出的结果,我们可以看到,文本以“可爱的熊猫公仔,质量好但有点小,价格稍高”开头,体现了对于产品价格与质量的侧重。

    1.3 关键信息提取

    在1.2节中,虽然我们通过添加关键角度侧重的 Prompt ,确实让文本摘要更侧重于某一特定方面,然而,我们可以发现,在结果中也会保留一些其他信息,比如偏重价格与质量角度的概括中仍保留了“快递提前到货”的信息。如果我们只想要提取某一角度的信息,并过滤掉其他所有信息,则可以要求 LLM 进行 文本提取(Extract) 而非概括( Summarize )。

    下面让我们来一起来对文本进行提取信息吧!
请从以下三个反引号之间的评论文本中提取产品运输相关的信息,最多30个词汇。
评论: {prod_review} """
response = get_completion(prompt) print(response) ```
产品运输相关的信息:快递提前一天到货。
二、同时概括多条文本
在实际的工作流中,我们往往要处理大量的评论文本,下面的示例将多条用户评价集合在一个列表中,并利用 for 循环和文本概括(Summarize)提示词,将评价概括至小于 20 个词以下,并按顺序打印。当然,在实际生产中,对于不同规模的评论文本,除了使用 for 循环以外,还可能需要考虑整合评论、分布式等方法提升运算效率。您可以搭建主控面板,来总结大量用户评论,以及方便您或他人快速浏览,还可以点击查看原评论。这样,您就能高效掌握顾客的所有想法。
    一盏落地灯的评论

    review_2 = """ 我需要一盏漂亮的卧室灯,这款灯不仅具备额外的储物功能,价格也并不算太高。 收货速度非常快,仅用了两天的时间就送到了。 不过,在运输过程中,灯的拉线出了问题,幸好,公司很乐意寄送了一根全新的灯线。 新的灯线也很快就送到手了,只用了几天的时间。 装配非常容易。然而,之后我发现有一个零件丢失了,于是我联系了客服,他们迅速地给我寄来了缺失的零件! 对我来说,这是一家非常关心客户和产品的优秀公司。 """

    一把电动牙刷的评论

    review_3 = """ 我的牙科卫生员推荐了电动牙刷,所以我就买了这款。 到目前为止,电池续航表现相当不错。 初次充电后,我在第一周一直将充电器插着,为的是对电池进行条件养护。 过去的3周里,我每天早晚都使用它刷牙,但电池依然维持着原来的充电状态。 不过,牙刷头太小了。我见过比这个牙刷头还大的婴儿牙刷。 我希望牙刷头更大一些,带有不同长度的刷毛, 这样可以更好地清洁牙齿间的空隙,但这款牙刷做不到。 总的来说,如果你能以50美元左右的价格购买到这款牙刷,那是一个不错的交易。 制造商的替换刷头相当昂贵,但你可以购买价格更为合理的通用刷头。 这款牙刷让我感觉就像每天都去了一次牙医,我的牙齿感觉非常干净! """

    一台搅拌机的评论

    review_4 = """ 在11月份期间,这个17件套装还在季节性促销中,售价约为49美元,打了五折左右。 可是由于某种原因(我们可以称之为价格上涨),到了12月的第二周,所有的价格都上涨了, 同样的套装价格涨到了70-89美元不等。而11件套装的价格也从之前的29美元上涨了约10美元。 看起来还算不错,但是如果你仔细看底座,刀片锁定的部分看起来没有前几年版本的那么漂亮。 然而,我打算非常小心地使用它 (例如,我会先在搅拌机中研磨豆类、冰块、大米等坚硬的食物,然后再将它们研磨成所需的粒度, 接着切换到打蛋器刀片以获得更细的面粉,如果我需要制作更细腻/少果肉的食物)。 在制作冰沙时,我会将要使用的水果和蔬菜切成细小块并冷冻 (如果使用菠菜,我会先轻微煮熟菠菜,然后冷冻,直到使用时准备食用。 如果要制作冰糕,我会使用一个小到中号的食物加工器),这样你就可以避免添加过多的冰块。 大约一年后,电机开始发出奇怪的声音。我打电话给客户服务,但保修期已经过期了, 所以我只好购买了另一台。值得注意的是,这类产品的整体质量在过去几年里有所下降 ,所以他们在一定程度上依靠品牌认知和消费者忠诚来维持销售。在大约两天内,我收到了新的搅拌机。 """

    reviews = [review_1, review_2, review_3, review_4]
    请对三个反引号之间的评论文本进行概括,最多20个词汇。

    评论文本: ```{reviews[i]}```
    """
    response = get_completion(prompt)
    print(f"评论{i+1}: ", response, "\n")
评论1: 熊猫公仔是生日礼物,女儿喜欢,软可爱,面部表情和善。价钱有点小,快递提前一天到货。
评论2: 漂亮卧室灯,储物功能,快速送达,灯线问题,快速解决,容易装配,关心客户和产品。
评论3: 这款电动牙刷电池续航好,但牙刷头太小,价格合理,清洁效果好。
评论4: 该评论提到了一个17件套装的产品,在11月份有折扣销售,但在12月份价格上涨。评论者提到了产品的外观和使用方法,并提到了产品质量下降的问题。最后,评论者提到他们购买了另一台搅拌机。
三、英文版
1.1 单一文本概括
python prod_review = """ Got this panda plush toy for my daughter's birthday, \ who loves it and takes it everywhere. It's soft and \ super cute, and its face has a friendly look. It's \ a bit small for what I paid though. I think there \ might be other options that are bigger for the \ same price. It arrived a day earlier than expected, \ so I got to play with it myself before I gave it \ to her. """
    Summarize the review below, delimited by triple backticks, in at most 30 words.

    Review: {prod_review} """

    response = get_completion(prompt) print(response) ```

    This panda plush toy is loved by the reviewer's daughter, but they feel it is a bit small for the price.

    1.2 设置关键角度侧重

    1.2.1 侧重于快递服务
Summarize the review below, delimited by triple backticks, in at most 30 words, and focusing on any aspects \ that mention shipping and delivery of the product.
Review: {prod_review} """
response = get_completion(prompt) print(response) ```
The customer is happy with the product but suggests offering larger options for the same price. They were pleased with the early delivery.
1.2.2 侧重于价格和质量
    Summarize the review below, delimited by triple backticks, in at most 30 words, and focusing on any aspects \ that are relevant to the price and perceived value.

    Review: {prod_review} """

    response = get_completion(prompt) print(response) ```

    The customer loves the panda plush toy for its softness and cuteness, but feels it is overpriced compared to other options available.

    1.3 关键信息提取
From the review below, delimited by triple quotes \ extract the information relevant to shipping and \ delivery. Limit to 30 words.
Review: {prod_review} """
response = get_completion(prompt) print(response) ```
The shipping department should take note that the product arrived a day earlier than expected.
2.1 同时概括多条文本
    review for a standing lamp

    review_2 = """ Needed a nice lamp for my bedroom, and this one \ had additional storage and not too high of a price \ point. Got it fast - arrived in 2 days. The string \ to the lamp broke during the transit and the company \ happily sent over a new one. Came within a few days \ as well. It was easy to put together. Then I had a \ missing part, so I contacted their support and they \ very quickly got me the missing piece! Seems to me \ to be a great company that cares about their customers \ and products. """

    review for an electric toothbrush

    review_3 = """ My dental hygienist recommended an electric toothbrush, \ which is why I got this. The battery life seems to be \ pretty impressive so far. After initial charging and \ leaving the charger plugged in for the first week to \ condition the battery, I've unplugged the charger and \ been using it for twice daily brushing for the last \ 3 weeks all on the same charge. But the toothbrush head \ is too small. I’ve seen baby toothbrushes bigger than \ this one. I wish the head was bigger with different \ length bristles to get between teeth better because \ this one doesn’t. Overall if you can get this one \ around the $50 mark, it's a good deal. The manufactuer's \ replacements heads are pretty expensive, but you can \ get generic ones that're more reasonably priced. This \ toothbrush makes me feel like I've been to the dentist \ every day. My teeth feel sparkly clean! """

    review for a blender

    review_4 = """ So, they still had the 17 piece system on seasonal \ sale for around $49 in the month of November, about \ half off, but for some reason (call it price gouging) \ around the second week of December the prices all went \ up to about anywhere from between $70-$89 for the same \ system. And the 11 piece system went up around $10 or \ so in price also from the earlier sale price of $29. \ So it looks okay, but if you look at the base, the part \ where the blade locks into place doesn’t look as good \ as in previous editions from a few years ago, but I \ plan to be very gentle with it (example, I crush \ very hard items like beans, ice, rice, etc. in the \ blender first then pulverize them in the serving size \ I want in the blender then switch to the whipping \ blade for a finer flour, and use the cross cutting blade \ first when making smoothies, then use the flat blade \ if I need them finer/less pulpy). Special tip when making \ smoothies, finely cut and freeze the fruits and \ vegetables (if using spinach-lightly stew soften the \ spinach then freeze until ready for use-and if making \ sorbet, use a small to medium sized food processor) \ that you plan to use that way you can avoid adding so \ much ice if at all-when making your smoothie. \ After about a year, the motor was making a funny noise. \ I called customer service but the warranty expired \ already, so I had to buy another one. FYI: The overall \ quality has gone done in these types of products, so \ they are kind of counting on brand recognition and \ consumer loyalty to maintain sales. Got it in about \ two days. """

    reviews = [review_1, review_2, review_3, review_4] ```
Summarize the review below, delimited by triple \ backticks in at most 20 words.
Review: {reviews[i]} """ response = get_completion(prompt) print(i, response, "\n")
    0 Soft and cute panda plush toy loved by daughter, but small for the price. Arrived early.

    1 Great lamp with storage, fast delivery, excellent customer service, and easy assembly. Highly recommended.

    2 Impressive battery life, but toothbrush head is too small. Good deal if bought around $50.

3 The reviewer found the price increase after the sale disappointing and noticed a decrease in quality over time.from langchain_text_splitters import RecursiveCharacterTextSplitter
text_splitter = RecursiveCharacterTextSplitter( chunk_size=500, chunk_overlap=50)
split_docs = text_splitter.split_documents(texts)
### 3.4.2 构建Chroma向量库

Langchain 集成了超过 30 个不同的向量存储库。我们选择 Chroma 是因为它轻量级且数据存储在内存中,这使得它非常容易启动和开始使用。

LangChain 可以直接使用 OpenAI 和百度千帆的 Embedding,同时,我们也可以针对其不支持的 Embedding API 进行自定义,例如,我们可以基于 LangChain 提供的接口,封装一个 zhipuai_embedding,来将智谱的 Embedding API 接入到 LangChain 中。在本章的[附LangChain自定义Embedding封装讲解](./附LangChain自定义Embedding封装讲解.md)中,我们以智谱 Embedding API 为例,介绍了如何将其他 Embedding API 封装到 LangChain
中,欢迎感兴趣的读者阅读。

**注:如果你使用智谱 API,你可以参考讲解内容实现封装代码,也可以直接使用我们已经封装好的代码[zhipuai_embedding.py](https://github.com/datawhalechina/llm-universe/blob/main/notebook/C3%20%E6%90%AD%E5%BB%BA%E7%9F%A5%E8%AF%86%E5%BA%93/zhipuai_embedding.py),将该代码同样下载到本 Notebook 的同级目录,就可以直接导入我们封装的函数。在下面的代码 Cell 中,我们默认使用了智谱的 Embedding,将其他两种 Embedding 使用代码以注释的方法呈现,如果你使用的是百度 API 或者 OpenAI API,可以根据情况来使用下方 Cell 中的代码。**from zhipuai_embedding import ZhipuAIEmbeddings
embedding = ZhipuAIEmbeddings()
persist_directory = '../../data_base/vector_db/chroma'
!rm -rf '../../data_base/vector_db/chroma' # 删除旧的数据库文件(如果文件夹中有文件的话),windows电脑请手动删除
from langchain_community.vectorstores import Chroma
vectordb = Chroma.from_documents( documents=split_docs, embedding=embedding, persist_directory=persist_directory # 允许我们将persist_directory目录保存到磁盘上 )
print(f"向量库中存储的数量:{vectordb._collection.count()}")
    向量库中存储的数量:1004


### 3.4.3 向量检索

Chroma的相似度搜索使用的是余弦距离,即:
$$
similarity = cos(A, B) = \frac{A \cdot B}{\parallel A \parallel \parallel B \parallel} = \frac{\sum_1^n a_i b_i}{\sqrt{\sum_1^n a_i^2}\sqrt{\sum_1^n b_i^2}}
$$
其中$a_i$、$b_i$分别是向量$A$、$B$的分量。

当你需要数据库返回严谨的按余弦相似度排序的结果时可以使用`similarity_search`函数。question="什么是大语言模型"
sim_docs = vectordb.similarity_search(question,k=3) print(f"检索到的内容数:{len(sim_docs)}")
检索到的内容数:3for i, sim_doc in enumerate(sim_docs): print(f"检索到的第{i}个内容: \n{sim_doc.page_content[:200]}", end="\n--------------\n")
    检索到的第0个内容:
    网络上有许多关于提示词(Prompt, 本教程中将保留该术语)设计的材料,例如《30 prompts everyone has to know》之类的文章,这些文章主要集中在 ChatGPT 的 Web 界面上,许多人在使用它执行特定的、通常是一次性的任务。但我们认为,对于开发人员,大语言模型(LLM) 的更强大功能是能通过 API 接口调用,从而快速构建软件应用程序。实际上,我们了解到 Deep
    --------------
    检索到的第1个内容:
    第六章 文本转换

    大语言模型具有强大的文本转换能力,可以实现多语言翻译、拼写纠正、语法调整、格式转换等不同类型的文本转换任务。利用语言模型进行各类转换是它的典型应用之一。

    在本章中,我们将介绍如何通过编程调用API接口,使用语言模型实现文本转换功能。通过代码示例,读者可以学习将输入文本转换成所需输出格式的具体方法。

    掌握调用大语言模型接口进行文本转换的技能,是开发各种语言类应用的重要一步。文
    --------------
    检索到的第2个内容:
    学生计算的总费用:450x+10万美元
    实际计算的总费用:360x+10万美元
    学生计算的费用和实际计算的费用是否相同:否
    学生的解决方案和实际解决方案是否相同:否
    学生的成绩:不正确

    三、局限性

    开发大模型相关应用时请务必铭记:

    虚假知识:模型偶尔会生成一些看似真实实则编造的知识

    在开发与应用语言模型时,需要注意它们可能生成虚假信息的风险。尽管模型经过大规模预训练,掌握了丰富知识,但它实
    --------------


如果只考虑检索出内容的相关性会导致内容过于单一,可能丢失重要信息。

最大边际相关性 (`MMR, Maximum marginal relevance`) 可以帮助我们在保持相关性的同时,增加内容的丰富度。

核心思想是在已经选择了一个相关性高的文档之后,再选择一个与已选文档相关性较低但是信息丰富的文档。这样可以在保持相关性的同时,增加内容的多样性,避免过于单一的结果。mmr_docs = vectordb.max_marginal_relevance_search(question,k=3)
for i, sim_doc in enumerate(mmr_docs): print(f"MMR 检索到的第{i}个内容: \n{sim_doc.page_content[:200]}", end="\n--------------\n")
    MMR 检索到的第0个内容:
    网络上有许多关于提示词(Prompt, 本教程中将保留该术语)设计的材料,例如《30 prompts everyone has to know》之类的文章,这些文章主要集中在 ChatGPT 的 Web 界面上,许多人在使用它执行特定的、通常是一次性的任务。但我们认为,对于开发人员,大语言模型(LLM) 的更强大功能是能通过 API 接口调用,从而快速构建软件应用程序。实际上,我们了解到 Deep
    --------------
    MMR 检索到的第1个内容:
    学生计算的总费用:450x+10万美元
    实际计算的总费用:360x+10万美元
    学生计算的费用和实际计算的费用是否相同:否
    学生的解决方案和实际解决方案是否相同:否
    学生的成绩:不正确

    三、局限性

    开发大模型相关应用时请务必铭记:

    虚假知识:模型偶尔会生成一些看似真实实则编造的知识

    在开发与应用语言模型时,需要注意它们可能生成虚假信息的风险。尽管模型经过大规模预训练,掌握了丰富知识,但它实
    --------------
    MMR 检索到的第2个内容:
    行推导。
    对于任意样本, 在不考虑样本本身之前(即先验), 若瞎猜一下它由第i 个高斯混合成分生成的概率
    P (zj = i), 那么肯定按先验概率α1, α2, . . . , αk 进行猜测, 即P (zj = i) = αi 。若考虑样本本身带来的信
    息(即后验), 此时再猜一下它由第i 个高斯混合成分生成的概率pM (zj = i | xj), 根据贝叶斯公式, 后验概
    率pM (zj =
--------------Embedding封装讲解
LangChain 为基于 LLM 开发自定义应用提供了高效的开发框架,便于开发者迅速地激发 LLM 的强大能力,搭建 LLM 应用。LangChain 也同样支持多种大模型的 Embeddings,内置了 OpenAI、LLAMA 等大模型 Embeddings 的调用接口。但是,LangChain 并没有内置所有大模型,它通过允许用户自定义 Embeddings 类型,来提供强大的可扩展性。
在本部分,我们以智谱 AI 为例,讲述如何基于 LangChain 自定义 Embeddings。
本部分涉及相对更多 LangChain、大模型调用的技术细节,有精力同学可以学习部署,如无精力可以直接使用后续代码来支持调用。
要实现自定义 Embeddings,需要定义一个自定义类继承自 LangChain 的 Embeddings 基类,然后定义两个函数:① embed_query 方法,用于对单个字符串(query)进行 embedding;②embed_documents 方法,用于对字符串列表(documents)进行 embedding。
首先我们导入所需的第三方库:
from typing import List
from langchain_core.embeddings import Embeddings这里我们定义一个继承自 Embeddings 类的自定义 Embeddings 类:
class ZhipuAIEmbeddings(Embeddings):
    """`Zhipuai Embeddings` embedding models."""
    def __init__(self):
        """
        实例化ZhipuAI为values["client"]

        Args:

            values (Dict): 包含配置信息的字典,必须包含 client 的字段.
        Returns:

            values (Dict): 包含配置信息的字典。如果环境中有zhipuai库,则将返回实例化的ZhipuAI类;否则将报错 'ModuleNotFoundError: No module named 'zhipuai''.
        """
        from zhipuai import ZhipuAI
self.client = ZhipuAI()embed_documents 是对字符串列表(List[str])计算embedding 的方法,这里我们重写该方法,调用验证环境时实例化的ZhipuAI来 调用远程 API 并返回 embedding 结果。
    def embed_documents(self, texts: List[str]) -> List[List[float]]:
        """
        生成输入文本列表的 embedding.
        Args:
            texts (List[str]): 要生成 embedding 的文本列表.

        Returns:
            List[List[float]]: 输入列表中每个文档的 embedding 列表。每个 embedding 都表示为一个浮点值列表。
        """
        embeddings = self.client.embeddings.create(
            model="embedding-3",
            input=texts
        )
return [embeddings.embedding for embeddings in embeddings.data]embed_query 是对单个文本(str)计算 embedding 的方法,这里我们调用刚才定义好的embed_documents方法,并返回第一个子列表即可。
    def embed_query(self, text: str) -> List[float]:
        """
        生成输入文本的 embedding.

        Args:
            texts (str): 要生成 embedding 的文本.

        Return:
            embeddings (List[float]): 输入文本的 embedding,一个浮点数值列表.
        """

return self.embed_documents([text])[0]对于以上方法可以加入一些内容处理后再请求 embedding,比如文本特别长,我们可以考虑对文本分段,防止超过最大 token 限制,这些都是可以的,靠大家发挥自己的主观能动性完善啦,这里只是给出一个简单的 demo。
通过上述步骤,我们就可以基于 LangChain 与 智谱 AI 定义 embedding 的调用方式了。我们将此代码封装在 zhipuai_embedding.py 文件中。